

Pozn. prekl.: V tomto článku spoločnosť Banzai Cloud zdieľa príklad použitia svojich špeciálnych nástrojov na zjednodušenie prevádzky Kafka v rámci Kubernetes. Poskytnuté pokyny ilustrujú, ako určiť optimálnu veľkosť infraštruktúry a nakonfigurovať samotnú Kafka pre dosiahnutie požadovanej priepustnosti.
Apache Kafka je distribuovaná streamovacia platforma na vytváranie spoľahlivých, škálovateľných a vysokovýkonných systémov spracovania údajov v reálnom čase. Jej pôsobivé možnosti môžeme rozšíriť pomocou Kubernetes. Na tento účel sme vyvinuli a nástroj s názvom . Tieto nástroje umožňujú spustiť Kafka v Kubernetes a využiť jej rôzne funkcie, ako je jemné ladenie konfigurácie brokerov, škálovanie na základe metrík s rebalance, rack awareness, „jemné“ (graceful) uvádzanie aktualizácií atď.
Vyskúšajte Supertubes vo svojom klastri:
curl https://getsupertubes.sh | sh a supertubes install -a --no-democluster --kubeconfigAlebo sa obráťte na . Môžete si tiež prečítať o niektorých funkciách Kafka, ktorých správa je automatizovaná pomocou Supertubes a Kafka operátora. O nich sme už písali na blogu:
- ;
- ;
- ;
- ;
- ;
- ;
- .
Keď sa rozhodnete nasadiť klaster Kafka v Kubernetes, určite narazíte na problém určenia optimálnej veľkosti základnej infraštruktúry a nutnosti jemného doladenia konfigurácie Kafka, aby splnila požiadavky na priepustnosť. Maximálny výkon každého brokera je ovplyvnený výkonom komponentov infraštruktúry pod ním, ako sú pamäť, procesor, rýchlosť disku, priepustnosť siete atď.
Ideálne by mala byť konfigurácia brokerov taká, aby všetky prvky infraštruktúry boli využité na maximum svojich možností. V reálnom živote je však takáto nastavenie veľmi zložitá. Je pravdepodobnejšie, že používatelia nastavia konfiguráciu brokerov tak, aby maximalizovali využitie jedného alebo dvoch komponentov (disku, pamäti alebo procesora). Všeobecne platí, že broker dosahuje maximálny výkon, keď jeho konfigurácia umožňuje plne využiť najpomalší komponent. Takto môžeme získať orientačný prehľad o záťaži, s ktorou si dokáže jeden broker poradiť.
Teoreticky môžeme tiež odhadnúť počet brokerov potrebných na spracovanie určitej záťaže. V praxi však existuje toľko variantov nastavenia na rôznych úrovniach, že nie je ľahké odhadnúť potenciálny výkon určitej konfigurácie (ak nie je to nemožné). Inými slovami, ťažko sa plánuje konfigurácia na základe určitej zadanej výkonnosti.
Pre používateľov Supertubes zvyčajne uplatňujeme nasledujúci prístup: začíname s určitou konfiguráciou (infraštruktúra + nastavenia), potom meráme jej výkon, upravujeme nastavenia brokerov a proces opakujeme. To trvá, kým nie je úplne využitý potenciál najpomalšieho komponentu infraštruktúry.
Týmto spôsobom získavame jasnejšiu predstavu o tom, koľko brokerov je potrebné klasteru na zvládnutie určitej záťaže (počet brokerov závisí aj od iných faktorov, ako je minimálny počet replik správ na zabezpečenie robustnosti, počet partition lídrov atď.). Okrem toho získavame predstavu o tom, pre ktorý infraštruktúrny komponent by bolo žiaduce vertikálne škálovanie.
V tomto článku pôjde o kroky, ktoré podnikáme, aby sme 'vyžmýkali všetko' z najpomalších komponentov v počiatočných konfiguráciách a merali priepustnosť klastera Kafka. Vysoko odolná konfigurácia vyžaduje prítomnosť aspoň troch funkčných brokerov (min.insync.replicas=3), rozdelených do troch rôznych zón dostupnosti. Na konfiguráciu, škálovanie a monitorovanie infraštruktúry Kubernetes používame našu vlastnú platformu na správu kontajnerov pre hybridné cloudové riešenia — . Podporuje on-premise (bare metal, VMware) a päť typov cloudu (Alibaba, AWS, Azure, Google, Oracle), ako aj akékoľvek ich kombinácie.
Názory na infraštruktúru a konfiguráciu klastru Kafka
Pre nižšie uvedené príklady sme vybrali AWS ako poskytovateľa cloudových služieb a EKS ako distribúciu Kubernetes. Podobnú konfiguráciu je možné implementovať pomocou — distribúcie Kubernetes od Banzai Cloud, certifikovaného CNCF.
Disk
Amazon ponúka rôzne . V základe gp2 a io1 sú SSD disky, avšak pre zabezpečenie vysokej priepustnosti gp2 spotrebuje nahromadené kredity (I/O kredity), preto sme uprednostnili typ io1, ktorý ponúka stabilnú vysokú priepustnosť.
Typy inštancií
Výkon Kafka veľmi závisí od stránkovacieho cache operačného systému, a preto potrebujeme inštancie s dostatočným množstvom pamäte pre brokerov (JVM) a stránkovací cache. Inštancia c5.2xlarge — nie je zlý začiatok, keďže má 16 GB pamäte a . Jej nevýhodou je, že dokáže zabezpečiť maximálny výkon maximálne 30 minút každých 24 hodín. Ak pracovná záťaž vyžaduje maximálny výkon počas dlhšej doby, malo by sa pozrieť na iné typy inštancií. My sme presne tak urobili a rozhodli sa pre c5.4xlarge. Zabezpečuje maximálnu priepustnosť v 593,75 MB/s. Maximálna priepustnosť objemu EBS io1 je vyššia ako u inštancie c5.4xlarge, a preto sa zdá, že najpomalším prvkom infraštruktúry je priepustnosť I/O tohto typu inštancie (čo by mali potvrdiť aj výsledky našich záťažových testov).
Sieť
Priepustnosť siete by mala byť dostatočne veľká v porovnaní s výkonom inštancie VM a disku, inak sa sieť stáva úzkym hrdlom. V našom prípade sieťové rozhranie c5.4xlarge podporuje rýchlosť do 10 Gb/s, čo je výrazne viac ako priepustnosť I/O inštancie VM.
Nasadenie brokerov
Brokery by mali byť nasadené (plánované v Kubernetes) na vyhradené uzly, aby sa predišlo súťaženiu s inými procesmi o zdroje procesora, pamäte, siete a disku.
Verzia Java
Logickou voľbou je Java 11, pretože je kompatibilná s Dockerom v tom zmysle, že JVM správne určuje procesory a pamäť dostupné pre kontajner, v ktorom beží broker. Keďže limity procesorov sú dôležité, JVM vnútorné a transparentne nastavuje počet GC vlákien a vlákien JIT kompilátora. Použili sme obraz Kafka banzaicloud/kafka:2.13-2.4.0, vrátane verzie Kafka 2.4.0 (Scala 2.13) na Java 11.
Ak sa chcete dozvedieť viac o Java/JVM na Kubernetes, pozrite si naše nasledujúce publikácie:
- ;
- .
Nastavenia pamäte brokera
Existujú dva kľúčové aspekty pri nastavovaní pamäte brokera: nastavenia pre JVM a pre pod Kubernetes. Limit pamäte nastavený pre pod musí byť väčší ako maximálny heap size, aby mal JVM miesto pre metapriestor Java, ktorý sa nachádza vo vlastnej pamäti, a pre stránkový cache operačného systému, ktorý Kafka aktívne využíva. V našich testoch sme spúšťali brokery Kafka s parametrami -Xmx4G -Xms2G, pričom limit pamäte pre pod bol 10 Gi. Upozorňujeme, že nastavenia pamäte pre JVM je možné automaticky získavať pomocou -XX:MaxRAMPercentage a -X:MinRAMPercentage, vychádzajúc z limitu pamäte pre pod.
Procesorové nastavenia brokera
Všeobecne platí, že môžete zvýšiť výkon zvýšením paralelizmu zvýšením počtu vlákien používaných Kafka. Čím viac procesorov je dostupných pre Kafka, tým lepšie. V našom teste sme začali s limitom 6 procesorov a postupne (iteráciami) sme ich počet zvýšili na 15. Okrem toho sme nastavili num.network.threads=12 v nastaveniach brokera, aby sme zvýšili počet vlákien, ktoré prijímajú dáta zo siete a posielajú ich. Hneď ako sme zistili, že brokery-následovníci nemôžu dostávať repliky dostatočne rýchlo, zvýšili sme num.replica.fetchers na 4, aby sme zvýšili rýchlosť, s ktorou brokery-následovníci replikovali správy od lídrov.
Nástroj na generovanie záťaže
Je potrebné zabezpečiť, aby potenciál vybraného generátora záťaže nevychladol skôr, než klaster Kafka (pre ktorý sa robí benchmark) dosiahne svoju maximálnu záťaž. Inými slovami, je nutné vykonať predbežné hodnotenie schopností nástroja na generovanie záťaže a vybrať preň typy inštancií s dostatočným počtom procesorov a pamäte. V tomto prípade náš nástroj bude produkovať viac záťaže, než čo dokáže spracovať klaster Kafka. Po mnohých experimentoch sme sa zastavili pri troch inštanciách c5.4xlarge, pričom každá z nich mala spustený generátor.
Benchmarking
Meranie výkonu je iteratívny proces, ktorý zahŕňa nasledujúce fázy:
- nastavenie infraštruktúry (klaster EKS, klaster Kafka, nástroj na generovanie záťaže, ako aj Prometheus a Grafana);
- generovanie záťaže počas určitého obdobia na filtrovanie náhodných odchýlok v zhromaždených ukazovateľoch výkonu;
- úprava infraštruktúry a konfigurácie brokera na základe pozorovaných ukazovateľov výkonu;
- opakovanie procesu, kým nie je dosiahnutá požadovaná úroveň priepustnosti klastera Kafka. Tá by mala byť stabilne reprodukovateľná a vykazovať minimálne variácie priepustnosti.
V nasledujúcej časti sú popísané kroky, ktoré sa vykonali v procese benchmarkovania testovacieho klastera.
Nástroje
Na rýchle nasadenie základnej konfigurácie, generovanie záťaže a meranie výkonu boli použité nasledujúce nástroje:
- na zorganizovanie klastera EKS od Amazonu s (na zhromažďovanie metrík Kafka a infraštruktúry) a (na vizualizáciu týchto metrík). Využili sme integrované v služby, ktoré zabezpečujú federatívne monitorovanie, centralizované zhromažďovanie logov, skenovanie zraniteľností, obnovenie po výpadkoch, bezpečnosť na úrovni podniku a mnoho ďalšieho.
- je nástroj na záťažové testovanie klastera Kafka.
- Panely Grafana na vizualizáciu metrík Kafka a infraštruktúry: , .
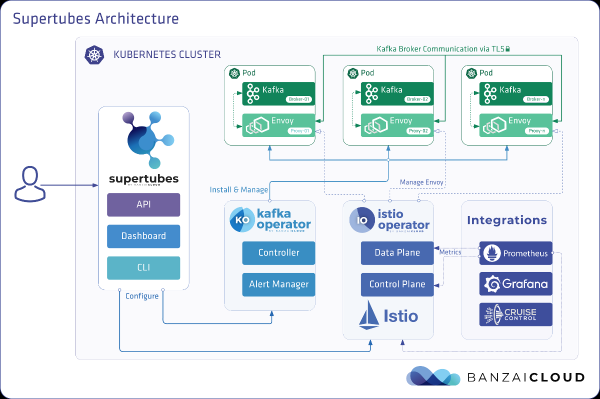
- Supertubes CLI pre maximálne jednoduché nastavenie klastru Kafka v Kubernetes. Zookeeper, Kafka operator, Envoy a množstvo ďalších komponentov sú nainštalované a správne nakonfigurované pre spustenie klastru Kafka pripraveného na produkciu v Kubernetes.
- Na inštaláciu supertubes CLI využite pokyny uvedené .
Klastor EKS
Pripravte klaster EKS s vyhradenými pracovnými uzlami c5.4xlarge v rôznych zónach dostupnosti pre pod’y s brokerami Kafka, ako aj vyhradené uzly pre generátor záťaže a monitorovaciu infraštruktúru.
banzai cluster create -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/cluster_eks_202001.jsonKeď klaster EKS začne fungovať, aktivujte jeho integrovanú — tá sa rozvinie s Prometheus a Grafana v klastri.
Systémové komponenty Kafka
Nainštalujte systémové komponenty Kafka (Zookeeper, kafka-operator) v EKS pomocou supertubes CLI:
supertubes install -a --no-democluster --kubeconfigKlastor Kafka
Vo výchozom nastavení sa v EKS používajú EBS objemy typu gp2, preto je potrebné vytvoriť samostatnú triedu úložiska založenú na objemoch io1 pre klaster Kafka:
kubectl create -f - <<EOF
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: fast-ssd
provisioner: kubernetes.io/aws-ebs
parameters:
  type: io1
  iopsPerGB: "50"
  fsType: ext4
volumeBindingMode: WaitForFirstConsumer
EOF
Nastavte pre brokerov parameter min.insync.replicas=3 a rozviňte pod’y brokerov na uzloch v troch rôznych zónach dostupnosti:
supertubes cluster create -n kafka --kubeconfig -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/kafka_202001_3brokers.yaml --wait --timeout 600Témy
Súčasne sme spustili tri inštancie generátora záťaže. Každý z nich píše do svojho vlastného tématu, to znamená, že potrebujeme celkovo tri témy:
supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest1
spec:
  name: perftest1
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
    name: perftest2
spec:
  name: perftest2
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest3
spec:
  name: perftest3
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF
Pre každé téma je faktor replikácie 3 — minimálna odporúčaná hodnota pre vysoko dostupné produkčné systémy.
Nástroj na generovanie záťaže
Spustili sme tri inštancie generátora záťaže (každá zapisovala do samostatnej témy). Pre pod’y generátora záťaže je potrebné nastaviť node affinity, aby sa plánovali iba na vyhradené uzly:
apiVersion: extensions/v1beta1
kind: Deployment
metadata:
  labels:
    app: loadtest
  name: perf-load1
  namespace: kafka
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      app: loadtest
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        app: loadtest
    spec:
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
            - matchExpressions:
              - key: nodepool.banzaicloud.io/name
                operator: In
                values:
                - loadgen
      containers:
      - args:
        - -brokers=kafka-0:29092,kafka-1:29092,kafka-2:29092,kafka-3:29092
        - -topic=perftest1
        - -required-acks=all
        - -message-size=512
        - -workers=20
        image: banzaicloud/perfload:0.1.0-blog
        imagePullPolicy: Always
        name: sangrenel
        resources:
          limits:
            cpu: 2
            memory: 1Gi
          requests:
            cpu: 2
            memory: 1Gi
        terminationMessagePath: /dev/termination-log
        terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      terminationGracePeriodSeconds: 30
Niekoľko aspektov, na ktoré treba poukázať:
- Generátor záťaže generuje správy s dĺžkou 512 bajtov a publikuje ich v Kafka v dávkach po 500 správ.
- Pomocou argumentu
-required-acks=allsa publikácia považuje za úspešnú, keď sú všetky synchronizované repliky správy prijaté a potvrdené brokerami Kafka. To znamená, že v benchmarku sme merali nielen rýchlosť práce lídrov, ktorí prijímajú správy, ale aj ich následníkov, ktorí replikujú správy. Cieľom tohto testu nie je oceniť rýchlosť čítania spotrebiteľmi (consumers) nedávno prijatých správ, ktoré zatiaľ zostávajú v stránkovom cache systému a jej porovnanie s rýchlosťou čítania správ, ktoré sú uložené na disku. - Generátor záťaže spúšťa súčasne 20 worker’ov (
-workers=20). Každý worker obsahuje 5 producer’ov, ktorí spoločne využívajú pripojenie worker’a ku klasteru Kafka. V konečnom dôsledku každý generátor zahŕňa 100 producer’ov, a všetci posielajú správy do klasteru Kafka.
Pozorovanie stavu klasteru
Počas záťažového testovania klastera Kafka sme tiež sledovali jeho zdravie, aby sme sa uistili, že nedochádza k reštartovaniu podov, nesúladným replikám a maximálnej priepustnosti s minimálnymi výkyvmi:
- Generátor zaťaženia píše štandardnú štatistiku o počte publikovaných správ a úrovni chýb. Percento chýb by malo zostať na hodnote
0,00%. - , nasadený kafka-operatorom, poskytuje panel monitorovania, na ktorom môžeme tiež sledovať stav klastera. Na zobrazenie tohto panelu vykonajte:
supertubes cluster cruisecontrol show -n kafka --kubeconfig - Úroveň ISR (počet replik „synchronizovaných“) zmršťovanie a rozširovanie sú rovné 0.
Výsledky merania
3 brokery, veľkosť správ — 512 byte
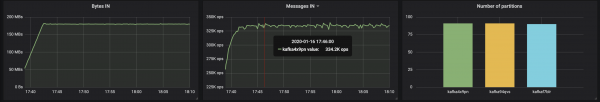
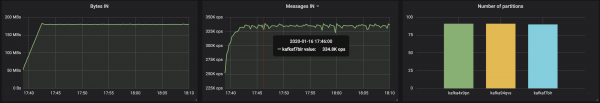
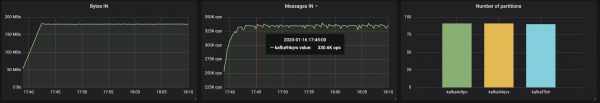
S partitionami rovnomerne rozdelenými medzi tri brokery sa nám podarilo dosiahnuť výkon ~500 MB/s (približne 990 tisíc správ za sekundu):
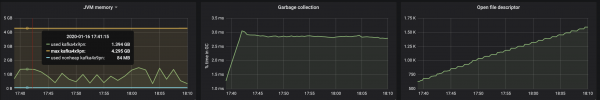
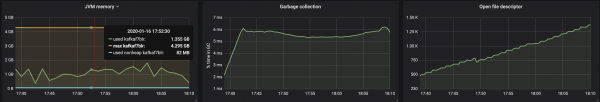
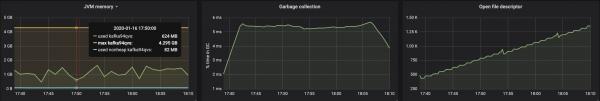
Spotreba pamäte virtuálnym strojom JVM nepresiahla 2 GB:
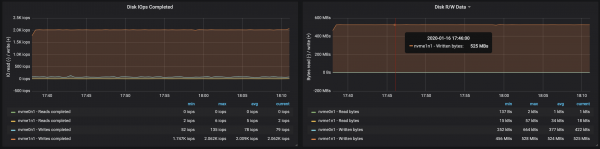
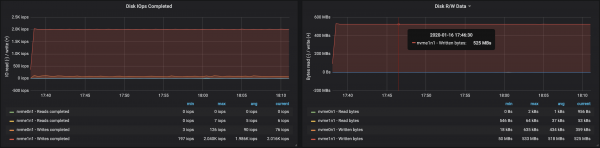
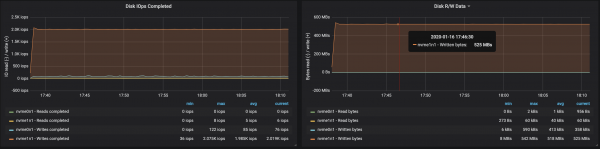
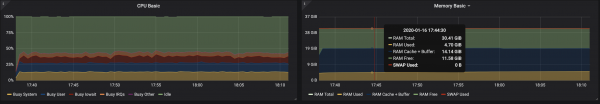
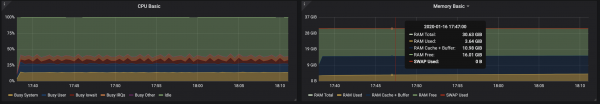
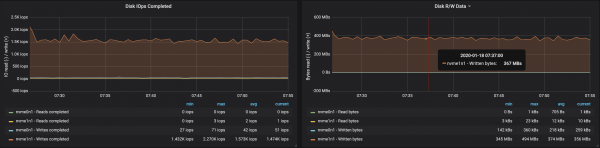
Priepustnosť disku dosiahla maximálnu priepustnosť I/O uzla na všetkých troch inštanciách, na ktorých pracovné brokery:
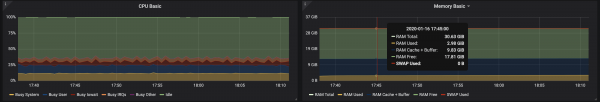
Z údajov o využití pamäte uzlami vyplýva, že systémové vyrovnávanie a caching zaberali ~10-15 GB:
3 brokery, veľkosť správ — 100 byte
So zmenou veľkosti správ klesá priepustnosť približne o 15-20%: prejavuje sa to časom stráveným spracovaním každej správy. Okrem toho sa záťaž procesora zvýšila takmer dvojnásobne.
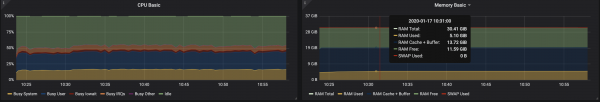
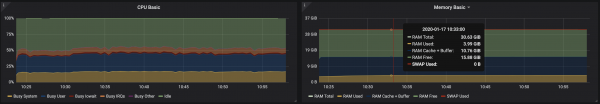
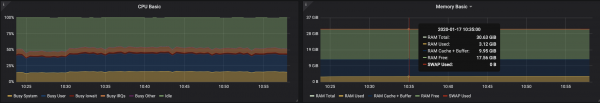
Keďže na uzloch brokerov sú stále nevyužité jadra, výkon je možné zvýšiť zmenou konfigurácie Kafka. To nie je jednoduchá úloha, preto je lepšie pracovať so správami väčšej veľkosti na zvýšenie priepustnosti.
4 brokery, veľkosť správ — 512 byte
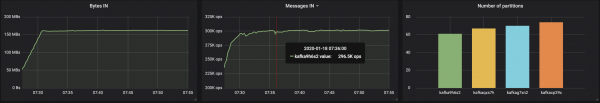
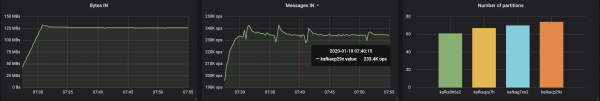
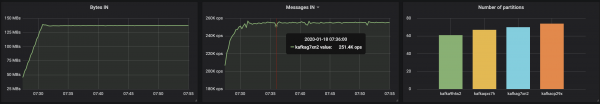
Výkon klastera Kafka je možné ľahko zvýšiť jednoducho pridaním nových brokerov a zachovaním vyváženia partitionov (to zabezpečuje rovnomerné rozdelenie záťaže medzi brokermi). V našom prípade po pridaní brokeru priepustnosť klastera vzrástla na ~580 MB/s (~1,1 milióna správ za sekundu). Rast bol menší, ako sa očakávalo: väčšinou to vysvetľuje nevyváženosť partitionov (nie všetci brokeri pracujú na vrchole svojich možností).
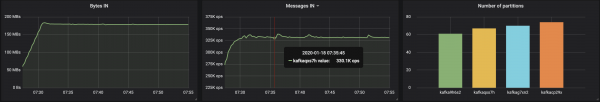
Spotreba pamäte JVM zostala pod 2 GB:
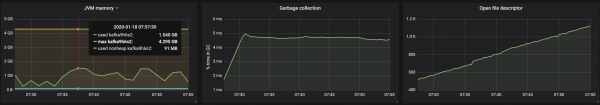
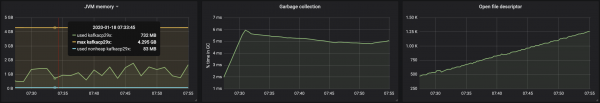
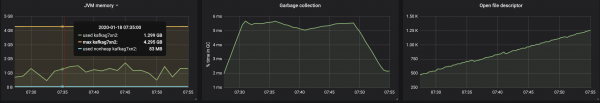
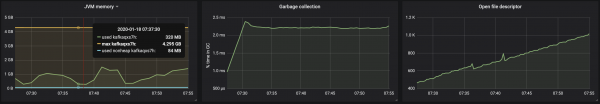
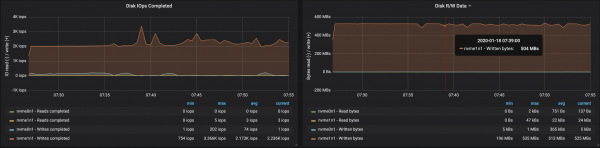
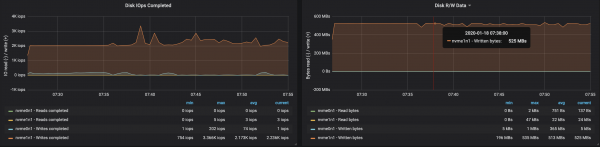
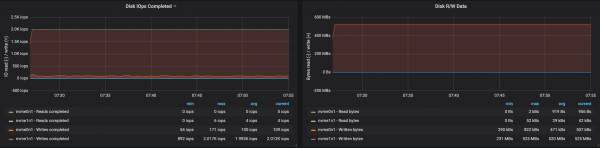
Práca brokerov s akumulátormi bola ovplyvnená nerovnováhou partitionov:
Zhrnutie
Predložený iteratívny prístup možno rozšíriť na pokrytie zložitejších scenárov, ktoré zahŕňajú stovky consumerov, repartitioning, vrstvové aktualizácie, reštarty podov atď. To všetko nám umožňuje posúdiť limity schopností klastru Kafka za rôznych podmienok, identifikovať úzke miesta v jeho fungovaní a nájsť spôsoby, ako s nimi bojovať.
Vyvinuli sme Supertubes na rýchle a jednoduché nasadenie klastru, jeho konfiguráciu, pridávanie/odstraňovanie brokerov a tém, reagovanie na upozornenia a zabezpečenie správneho fungovania Kafka v Kubernetes ako celku. Naším cieľom je pomôcť sústrediť sa na hlavnú úlohu ("generovať" a "spotrebúvať" správy Kafka) a všetku ťažkú prácu prenechať Supertubes a Kafka operatorovi.
Ak vás zaujímajú technológie a Open Source projekty Banzai Cloud, sledujte spoločnosť na , alebo .
P.S. od prekladateľa
Prečítajte si tiež na našom blogu:
- «»;
- «»;
- «».
Zdroj: habr.com
