

Analytická SYSTÉM ZPRACOVÁNÍ DAT ClickHouse zpracovává mnoho různých řetězců, čímž spotřebovává zdroje. Aby se urychlil chod systému, neustále se přidávají nová vylepšení. Vývojář ClickHouse Nikolaj Kočetov hovoří o řetězcovém datovém typu, včetně nového typu LowCardinality, a vysvětluje, jak lze urychlit práci s řetězci.
— Nejprve si objasněme, jak lze řetězce uchovávat.
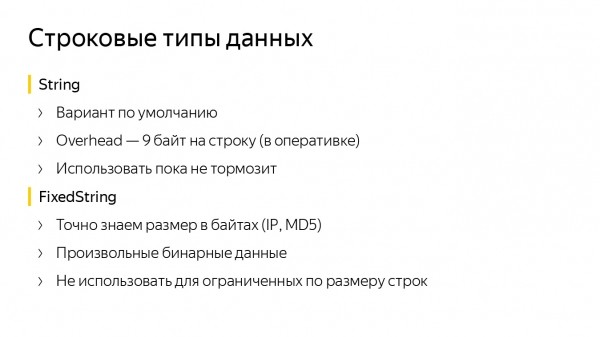
Máme řetězcové datové typy. String se dobře hodí jako výchozí, měl by se používat téměř vždy. Má malý overhead — 9 bajtů na jeden řetězec. Pokud chceme, aby velikost řetězců byla pevná a známá předem, je lepší použít FixedString. V něm lze stanovit požadovaný počet bajtů, je praktický pro data jako IP adresy nebo hashovací funkce.
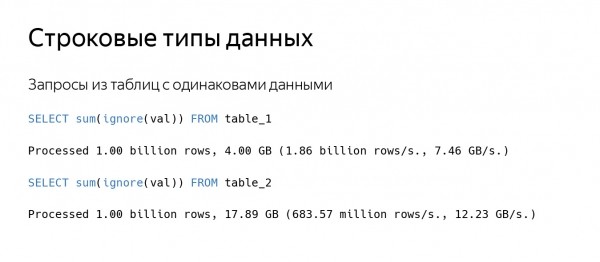
Samozřejmě, někdy něco zpomaluje. Představte si, že děláte dotaz na tabulku. ClickHouse čte docela velké množství dat, dejme tomu rychlostí 100 GB/s, přičemž počet zpracovávaných řetězců je malý. Máme dvě tabulky, které uchovávají téměř stejné údaje. Z druhé tabulky ClickHouse čte data vyšší rychlostí, ale počet řetězců za sekundu se čte třikrát méně.
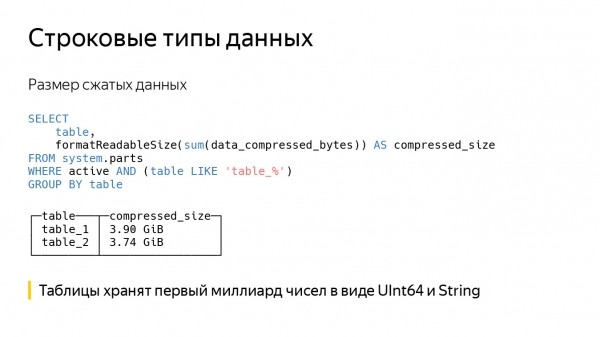
Pokud se podíváme na velikost komprimovaných dat, bude téměř stejná. Ve skutečnosti jsou v tabulkách zapsány stejné údaje — prvních miliard číslic — pouze v prvním sloupci jsou zapsány jako UInt64, zatímco ve druhém jako String. Z toho důvodu druhý dotaz čte data z disku déle a dekomprimuje je.
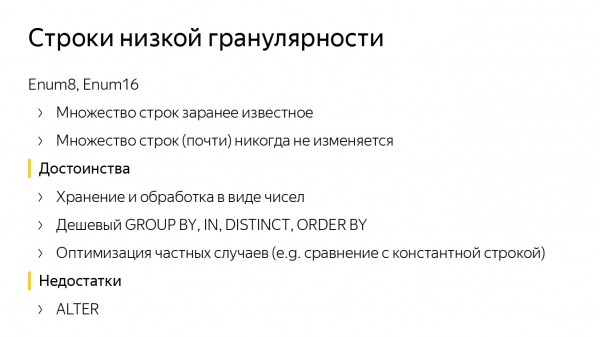
Zde je jiný příklad. Předpokládejme, že existuje předem známá řada řetězců, která je omezena konstantou 1000 nebo 10 000 a skoro se nikdy nemění. Pro tento případ nám vyhovuje datový typ Enum, v ClickHouse jsou dva — Enum8 a Enum16. Díky uchovávání v Enum rychle zpracováváme dotazy.
V ClickHouse existují zrychlení pro GROUP BY, IN, DISTINCT a optimalizace pro některé funkce, například pro porovnání s konstantním řetězcem. Samozřejmě, že čísla v řetězci se nepřevádějí, ale naopak, konstantní řetězec se převádí na hodnotu Enum. Poté se vše rychle porovná.
Ale jsou tu i nevýhody. I když známe přesně počet řetězců, někdy se musí doplnit. Přišla nová řetězec — musíme provést ALTER.
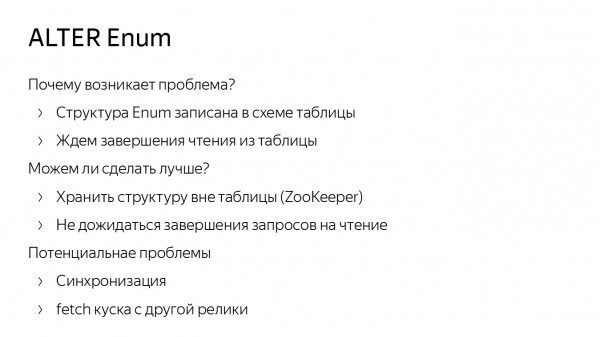
ALTER pre enum v ClickHouse je implementovaný optimálne. Neprepisujeme údaje na disku, avšak ALTER môže spomaliť z dôvodu, že štruktúry Enum sú uložené v schéme samotnej tabuľky. Preto musíme počkať na požiadavky na čítanie z tabuľky, napríklad.
Vyskytuje sa otázka, dá sa to urobiť lepšie? Asi áno. Môžeme uchovať štruktúru Enum nie v schéme tabuľky, ale v ZooKeeper. Môžu sa však vyskytnúť problémy so synchronizáciou. Napríklad jedna replika dostala údaje, druhá nie, a ak má starý Enum, tak sa niečo pokazí. (V ClickHouse sme takmer dokončili neblokujúce ALTER požiadavky. Keď ich dokončíme úplne, nebudeme musieť čakať na požiadavky na čítanie.)
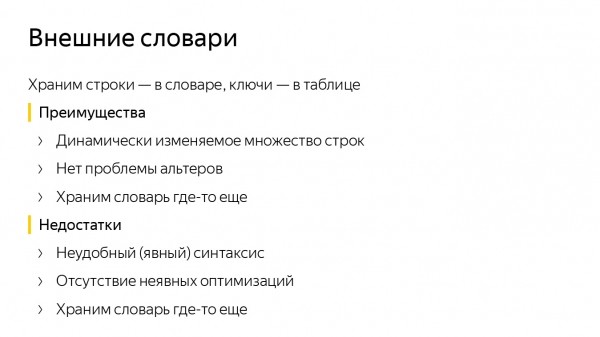
Aby sme sa nezaoberali ALTER Enum, môžeme použiť externé slovníky ClickHouse. Pripomínam, že ide o štruktúru dát key-value vnútri ClickHouse, pomocou ktorej môžeme získavať údaje z externých zdrojov, napríklad z tabuliek MySQL.
V slovníku ClickHouse uchovávame množstvo rôznych reťazcov, a v tabuľke sú ich identifikátory vo forme čísel. Ak potrebujeme získať reťazec, voláme funkciu dictGet a pracujeme s ním. Potom už nemusíme robiť ALTER. Aby sme niečo pridali do Enum, vkladáme to do tej istej tabuľky MySQL.
Ale tu vznikajú iné problémy. Po prvé, nepríjemná syntax. Ak chceme získať reťazec, musíme volať dictGet. Po druhé, absencia niektorých optimalizácií. Porovnávanie s konštantným reťazcom pre slovníky tak rýchlo neurobíme.
Ešte môžu nastať problémy s aktualizáciou. Predpokladajme, že sme požiadali o reťazec v cache-slovníku, a ten sa do cache nedostal. Potom musíme čakať, kým sa načítajú údaje z externého zdroja.
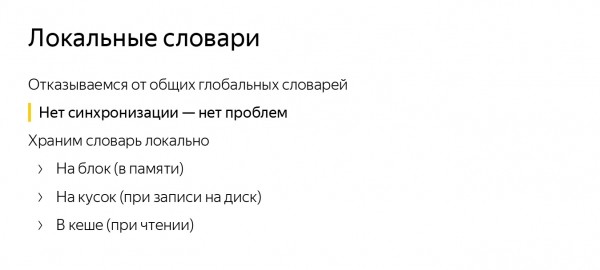
Spoločným nedostatkom oboch metód je, že uchovávame všetky kľúče na jednom mieste a synchronizujeme ich. Tak prečo ich neuchovávať lokálne? Žiadna synchronizácia — žiadne problémy. Môžeme uchovávať slovník lokálne v kuse na disku. To znamená, že sme urobili Insert, zapísali slovník. Ak pracujeme s údajmi v pamäti, môžeme zapísať slovník buď do bloku dát, alebo do kusu stĺpca, alebo do nejakého cache, aby sme urýchlili výpočty.
Kódovanie reťazcov pomocou slovníka
Tak sme prišli k vytvoreniu nového typu údajov v ClickHouse — LowCardinality. Je to formát ukladania údajov: ako sa zapisujú na disk a ako sa čítajú, ako sú reprezentované v pamäti a schéma ich spracovania.
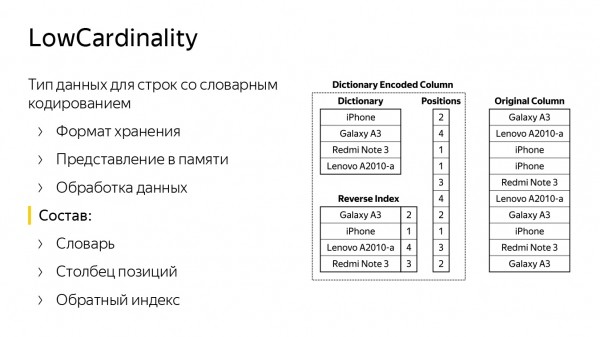
Na snímke sú dve kolónky. Vpravo sa riadky uchovávajú štandardne, v type String. Je jasné, že ide o nejaké modely mobilných telefónov. Vľavo je presne taká istá kolónka, iba v type LowCardinality. Skladá sa zo slovníka s množstvom rôznych riadkov (riadky z kolónky vpravo) a zoznamu pozícií (čísel riadkov).
S pomocou týchto dvoch štruktúr je možné obnoviť pôvodnú kolónku. Existuje tiež opačný index — hash tabuľka, ktorá pomáha nájsť pozíciu v slovníku podľa riadku. Je potrebná na urýchlenie niektorých dotazov. Napríklad, ak chceme porovnať, vyhľadať riadok v našej kolónke alebo ich zlúčiť.
LowCardinality — je parametrový typ údajov. Môže to byť číslo, alebo niečo, čo je uchovávané ako číslo, alebo reťazec, alebo Nullable z nich.
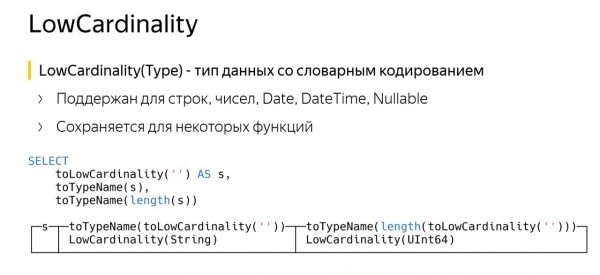
Špeciálnosť LowCardinality spočíva v tom, že sa môže uchovávať pre niektoré funkcie. Na snímke je vidieť príklad dotazu. V prvej vetě som vytvoril kolónku typu LowCardinality od String a nazval ju S. Potom som sa spýtal na jej názov — ClickHouse povedal, že je to LowCardinality od String. Všetko je správne.
Tretia veta je takmer rovnaká, iba sme zavolali funkciu length. V ClickHouse funkcia length vracia typ údajov UInt64. Ale dostali sme LowCardinality od UInt64. O čo ide?
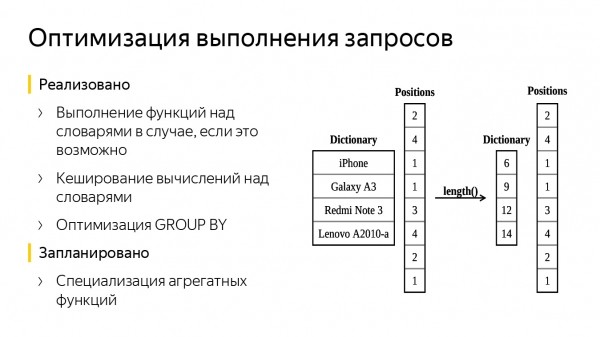
V slovníku boli uložené názvy mobilných telefónov, použili sme funkciu length. Teraz máme analogický slovník, ktorý sa skladá iba z čísel — to sú dĺžky reťazcov. Stĺpec s pozíciami sa nezmenil. Napokon sme spracovali menej údajov, ušetrili sme čas pri dotazovaní.
Môžu byť aj iné optimalizácie, napríklad pridanie jednoduchého cache. Pri výpočte hodnoty funkcie si ju môžeme zapamätať a zložiť rovnakú, nemusíme ju počítať znovu.
Môže sa tiež spraviť optimalizácia GROUP BY, pretože naša kolónka so slovníkom už bola čiastočne agregovaná — je možné rýchlejšie vypočítavať hodnotu hash funkcií a približne nájsť bucket, do ktorého sa má vložiť ďalší riadok. Okrem toho je možné špecializovať niektoré agregačné funkcie, napríklad uniq, pretože do nej môžeme poslať iba slovník a pozície nechať nedotknuté — takto všetko bude fungovať rýchlejšie. Prvé dve optimalizácie sme už pridali do ClickHouse.
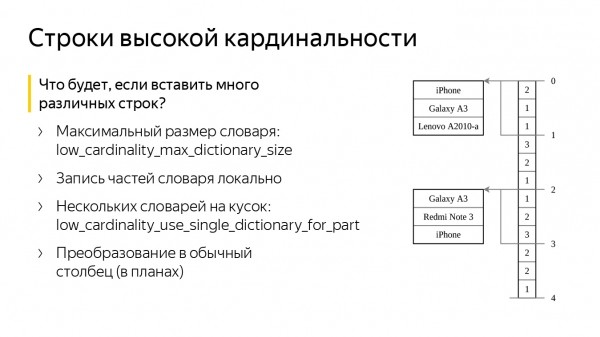
A čo ak vytvoríme stĺpec s naším typom údajov a vložíme do neho veľa zlých rôznych riadkov? Nepreplní sa naša pamäť? Nie, na to má ClickHouse dve špeciálne nastavenia. Prvé – low_cardinality_max_dictionary_size. To je maximálna veľkosť slovníka, ktorá môže byť zapísaná na disk. Vkladanie prebieha takto: keď vkladáme údaje, prichádza k nám prúd riadkov, z ktorých vytvárame veľký spoločný slovník. Ak sa slovník stane väčším, než je hodnota nastavenia, zapíšeme aktuálny slovník na disk, a ostatné riadky – niekde „navyše“, vedľa indexov. Nakoniec nikdy neprepočítame veľký slovník a nedostaneme problémy s pamäťou.
Druhé nastavenie sa nazýva low_cardinality_use_single_dictionary_for_part. Predstavte si, že v predchádzajúcej schéme, keď sme vkladali údaje, náš slovník preplnil a my sme ho zapísali na disk. Vyvstáva otázka, prečo by sme teraz nemohli vytvoriť ešte jeden presne taký istý slovník?
Keď sa preplní, znovu ho zapíšeme na disk a začneme vytvárať tretí. Toto nastavenie presne vypína takúto možnosť predvolene.
V skutočnosti môže byť veľa slovníkov užitočných, ak chceme vložiť nejakú množinu riadkov, ale náhodou sme vložili "odpadky". Povedzme, že najprv sme vložili zlé riadky, a potom sme vložili dobré. Potom sa slovník rozdelí na veľa malých slovníkov. Časť z nich bude s "odpadkami", ale posledné budú s dobrými riadkami. A ak prečítame, povedzme, iba poslednú granulu, všetko bude fungovať rýchlo.
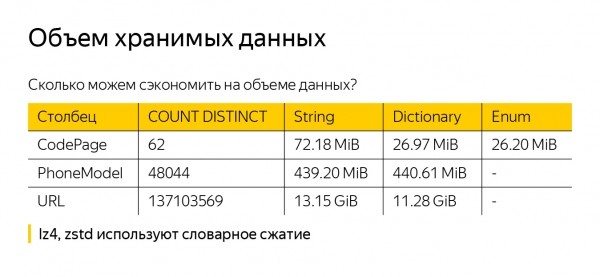
Predtým, než hovoríme o výhodách LowCardinality, hneď poviem, že sotva dosiahneme zmenšenie údajov na disku (aj keď sa to môže stať), pretože ClickHouse komprimuje údaje. Existuje predvolená možnosť – LZ4. Môže sa tiež použiť kompresia pomocou ZSTD. Ale oba algoritmy už realizujú slovníkové kompresie, takže náš externý slovník ClickHouse veľmi nepomôže.
Aby som nebol len rečami, vzal som niektoré údaje z metriky — String, LowCardinality(String) a Enum — a uložil ich do rôznych typov údajov. Vznikli tri stĺpce, kde je zapísaných jedna miliarda riadkov. V prvom stĺpci, CodePage, je celkovo 62 hodnôt. A je vidno, že v LowCardinality(String) sme ich lepšie skompresovali. String je o niečo horší, ale pravdepodobne to súvisí s tým, že reťazce sú krátke, uchovávame ich dĺžky, a tie zaberajú veľa miesta, ťažko sa komprimujú.
Ak vezmeme PhoneModel, je ich 48 tisíc — už viac, a rozdiely medzi String a LowCardinality(String) sú takmer žiadne. Pri URL sme úsporu dosiahli len 2 GB — myslím, že na to sa netreba spoliehať.
Hodnotenie rýchlosti práce
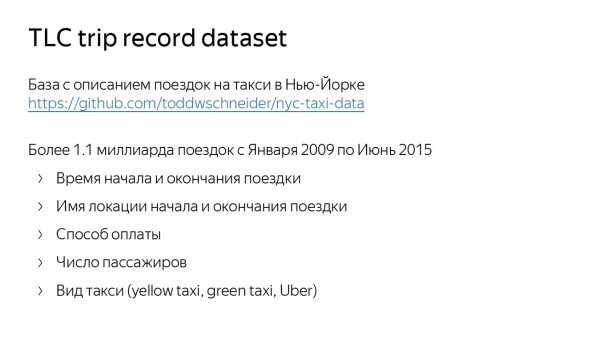
Teraz ohodnotíme rýchlosť práce. Na jej hodnotenie som použil dataset s popisom jázd taxíkom v New Yorku. Je na GitHub. Obsahuje niečo viac než miliardu jázd. Zobrazuje umiestnenie, čas začiatku a ukončenia jazdy, spôsob platby, počet pasažierov a dokonca aj typ taxíka — zelený, žltý alebo Uber.
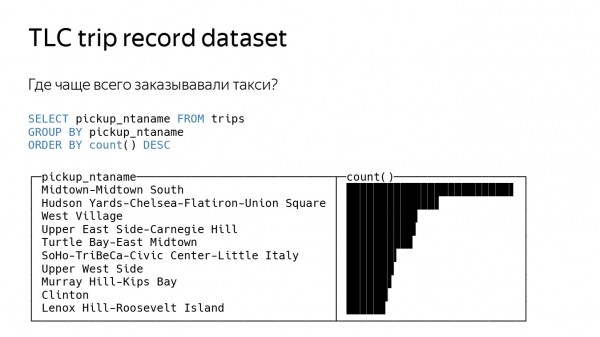
Prvý dotaz som urobil celkom jednoduchý — spýtal som sa, kde sa najčastejšie objednávajú taxíky. Na to treba vziať umiestnenie, odkiaľ sa objednávalo, urobiť na ňom GROUP BY a spočítať funkciu count. Tu ClickHouse niečo vyprodukuje.
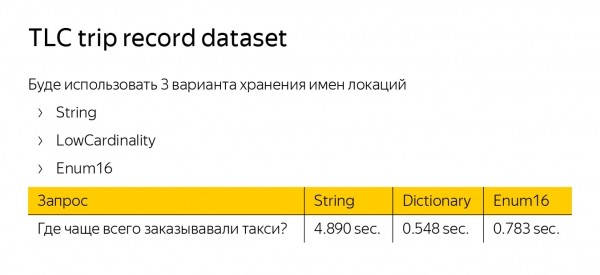
Na meranie rýchlosti spracovania dotazu som vytvoril tri tabuľky s rovnakými údajmi, ale pre našu štartovaciu lokalitu som použil tri rôzne typy údajov — String, LowCardinality a Enum. LowCardinality a Enum boli päťkrát rýchlejšie ako String. Enum je rýchlejší, pretože pracuje s číslami. LowCardinality — pretože bola implementovaná optimalizácia GROUP BY.
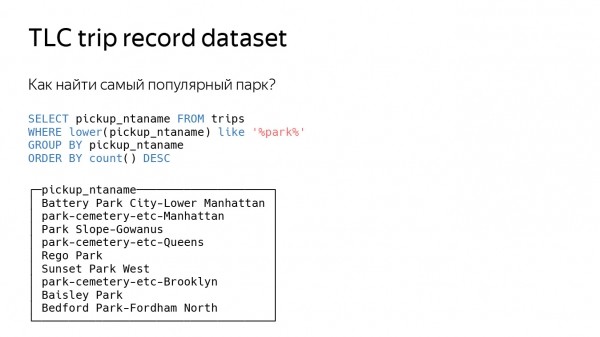
Poďme ešte skomplikovať dotaz — opýtajme sa, kde sa nachádza najpopulárnejší park v New Yorku. Opäť to budeme merať podľa toho, kde sa najčastejšie objednávajú taxíky, ale filtrujeme len tie umiestnenia, kde je slovo „park“. Taktiež pridáme funkciu like.
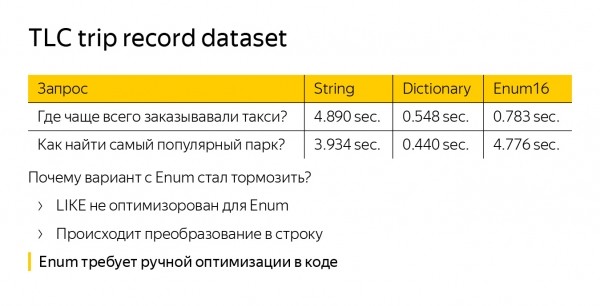
Pozeráme na čas — vidíme, že Enum zrazu začal spomaľovať. A pracuje ešte pomalšie ako štandardný typ údajov String. To sa deje, pretože funkcia like nie je vôbec optimalizovaná pre Enum. Musíme prevádzať naše reťazce z Enum na obyčajné reťazce — vykonávame viac práce. LowCardinality(String) tiež nie je predvolene optimalizovaný, ale tam like funguje nad slovníkom, takže sa požiadavka urýchli v porovnaní so String.
Pri práci s Enum existuje väčší problém. Ak ho chceme optimalizovať, musíme to urobiť na každom mieste v kóde. Predpokladajme, že sme napísali novú funkciu — určite musíme vymyslieť optimalizáciu pre Enum. A v LowCardinality je všetko optimalizované predvolene.
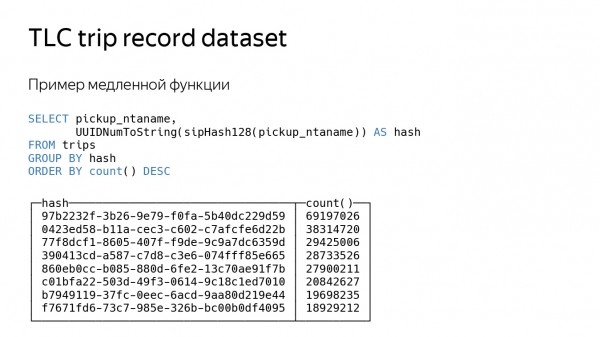
Pozrime sa na posledný dotaz, ktorý je umelý. Jednoducho vypočítame hash funkciu našej lokality. Hash funkcia je dosť pomalý dotaz, počíta sa dlho, preto sa všetko spomalí trikrát.
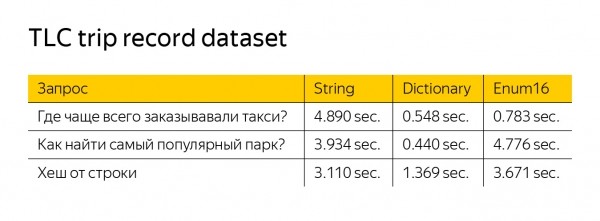
LowCardinality stále funguje rýchlejšie, hoci tu nie je filtrovanie. To sa deje preto, lebo naše funkcie pracujú iba so slovníkom. Funkcia na výpočet hash má jeden argument — dokáže spracovávať menej údajov a tiež môže vrátiť LowCardinality.
Náš globálny plán je dosiahnuť rýchlosť výkonu nie nižšiu ako pri String vo všetkých prípadoch a zachovať zrýchlenie. A možno raz v budúcnosti nahradíme String LowCardinality, aktualizujete ClickHouse a všetko vám pôjde o niečo rýchlejšie.
Zdroj: habr.com
