

Čo môže nútiť takú veľkú spoločnosť ako Lamoda s precízne nastaveným procesom a desiatkami vzájomne prepojených služieb zásadne zmeniť prístup? Motivácia môže byť úplne rôzna: od legislatívnych dôvodov po túžbu všetkých programátorov experimentovať.
Ale to rozhodne neznamená, že sa nedá počítať s dodatočným ziskom. O čom konkrétne môžete získať, ak implementujete events-driven API na Kafka, vám povie Sergej Zaika (). O zraneniach a zaujímavých objavoch sa takisto určite dozviete – experimenty sa bez nich nezaobídu.
Disclaimer: Tento článok je založený na materiáloch meetupu, ktorý Sergej uskutočnil v novembri 2018 na HighLoad++. Skúsenosti Lamoda s Kafka pritiahli poslucháčov rovnako ako ostatné prednášky v programe. Myslíme si, že je to výborný príklad toho, že vždy je možné a potrebné nájsť priateľov v obore, a organizátori HighLoad++ budú naďalej usilovať o vytvorenie takej atmosféry.
O procese
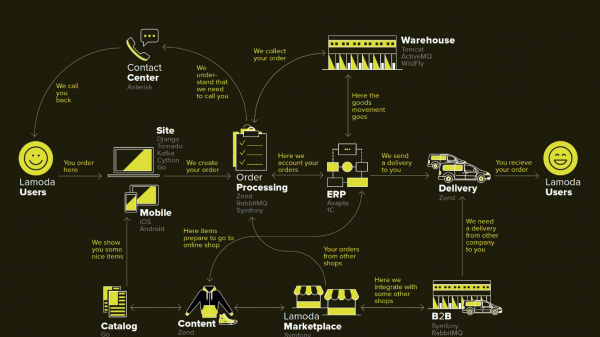
Lamoda je veľká e-commerce platforma, ktorá má svoj kontaktný centrá, doručovaciu službu (a množstvo partnerov), fotostúdio, obrovský sklad a všetko to pracuje na svojom softvéri. Existuje desiatky spôsobov platby, b2b-partneri, ktorí môžu využívať časť alebo všetky tieto služby a chcú poznať aktuálne informácie o svojich produktoch. Okrem toho Lamoda pôsobí v troch krajinách mimo RF a tam to všetko funguje trošku inak. Celkovo teda existuje asi viac ako sto spôsobov, ako konfigurovať novú objednávku, ktorá musí byť spracovaná po svojom. Všetko to pracuje s pomocou desiatok služieb, ktoré niekedy komunikujú spôsobom, ktorý nie je zjavný. Existuje aj centrálna systém, ktorého hlavnou zodpovednosťou sú stavy objednávok. Nazývame to BOB, pracujem s ním.
Refund Tool with events-driven API
Slovo events-driven je už dosť používané, neskôr presnejšie definujeme, čo to znamená. Začnem kontextom, v ktorom sme sa rozhodli vyskúšať prístup events-driven API v Kafka.
V akomkoľvek obchode, okrem objednávok, za ktoré zákazníci platia, sú aj momenty, keď obchod musí vrátiť peniaze, pretože zákazníkovi produkt nevyhovoval. Tento relatívne krátky proces spočíva v overení informácií, ak je to potrebné, a v prevode peňazí.
Avšak vrátenie sa skomplikovalo z dôvodu zmien v legislatíve, a preto sme museli implementovať samostatnú mikroslužbu na tento účel.
Naša motivácia:
- Zákon FZ-54 — v skratke, zákon vyžaduje nahlasovať každu finančnú transakciu, či už ide o vrátenie alebo prichádzajúce platby, v relatívne krátkom SLA, počas niekoľkých minút. My, ako e-commerce, vykonávame množstvo operácií. Technicky to znamená novú zodpovednosť (a teda novú službu) a úpravy vo všetkých dotknutých systémoch.
- BOB split — interný projekt spoločnosti na zbavenie BOB množstva nepotrebných zodpovedností a zníženie jeho celkovej zložitosti.
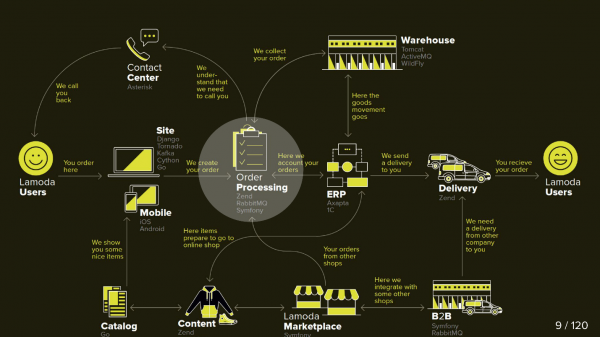
Na tejto schéme sú znázornené hlavné systémy Lamoda. V súčasnosti väčšina z nich predstavuje skôr konšteláciu z 5-10 mikroslužieb okolo sa zmenšujúceho monolitu. Pomaly rastú, ale snažíme sa ich zmenšovať, pretože je desivé nasadzovať vyčlenený fragment uprostred — nesmieme dopustiť, aby zlyhal. Všetky výmeny (šípky) musíme rezervovať a počítať s tým, že ktorýkoľvek z nich môže byť nedostupný.
V BOB tiež existuje pomerne veľa výmen: systémy platieb, dodávok, notifikácií atď.
Technicky je BOB:
- ~150k riadkov kódu + ~100k riadkov testov;
- php7.2 + Zend 1 & Symfony Components 3;
- >100 API & ~50 odchádzajúcich integrácií;
- 4 krajiny s vlastnou biznis logikou.
Nasadzovanie BOB je nákladné a bolestivé, počet kódu a úloh, ktoré rieši, je taký, že nikto ho nemôže mať v hlave celý. V skratke, existuje veľa dôvodov na jeho zjednodušenie.
Proces vrátenia
Pôvodne sú do procesu zapojené dva systémy: BOB a Payment. Teraz pribúdajú ďalšie dva:
- Fiskalizácie Služba, ktorá preberie problémy s fiskalizáciou a komunikáciu s externými službami.
- Refund Tool, do ktorého sa jednoducho prevezú nové výmeny, aby sa nepreháňal BOB.
Teraz proces vyzerá takto:
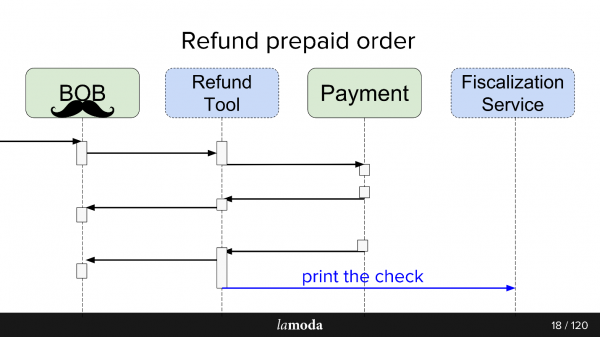
- K BOB prichádza žiadosť o vrátenie peňazí.
- BOB o tom informuje Refund Tool.
- Refund Tool hovorí Payment: „Vráť peniaze“.
- Payment vráti peniaze.
- Refund Tool a BOB synchronizujú medzi sebou stavy, pretože sú obom momentálne potrebné. Ešte nie sme pripravení úplne prejsť na Refund Tool, pretože v BOB je UI, reporty pre účtovníctvo a vôbec veľa dát, ktoré nie je možné tak jednoducho preniesť. Musíme sedieť na dvoch stoličkách.
- Odosiela sa žiadosť na fiskalizáciu.
Nakoniec sme vytvorili na Kafka akýsi event-bus, na ktorom sa všetko viazalo. Hurá, teraz máme jediné miesto zlyhania (sarkazmus).
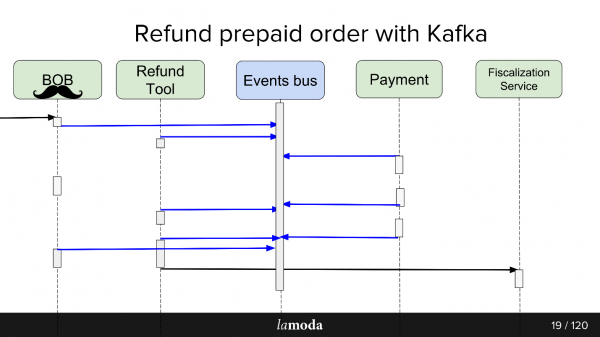
Plusy a mínusy sú celkom zrejmé. Urobili sme bus, takže teraz všetky služby od neho závisia. To zjednodušuje navrhovanie, ale prináša do systému jediné miesto zlyhania. Ak sa Kafka zrúti, proces sa zastaví.
Čo je to events-driven API
Dobrú odpoveď na túto otázku dáva prezentácia Martina Fowléra (GOTO 2017) .
Stručne, čo sme urobili:
- Zabalili sme všetky asynchronicé výmeny cez events storage. Namiesto toho, aby sme oznamovali každému zainteresovanému spotrebiteľovi v sieti o zmene stavu, zapisujeme do centralizovaného úložiska udalosť o zmene stavu, a zainteresovaní spotrebitelia čítajú všetko, čo sa tam objaví.
- Udalosť (event) v tomto prípade je oznámenie (notifications) o tom, že sa niečo niekde zmenilo. Napríklad, zmenil sa stav objednávky. Spotrebiteľ, ktorému sú dôležité nejaké sprievodné údaje o zmene stavu, ktoré nie sú v oznámení, si môže zistiť ich stav sám.
- Maximálna varianta je plnohodnotné event sourcing, state transfer, pri ktorom udalosť obsahuje všetky informácie potrebné na spracovanie: odkiaľ a do akého stavu prešli, ako presne sa dáta zmenili atď. Otázka je len v účelnosti a objeme informácií, ktoré si môžete dovoliť uchovávať.
V rámci spustenia Refund Tool sme použili tretí variant. To zjednodušilo spracovanie udalostí, pretože nebolo potrebné získavať podrobné informácie, navyše to vylúčilo scenár, keď každá nová udalosť vytvorí nával doplňujúcich GET požiadaviek od spotrebiteľov.
Služba Refund Tool není zaťažená, takže Kafka tam skôr slúži ako pokus ako potreba. Nemyslím si, že by bol biznis rád, keby sa služba vrátenia peňazí stala highload projektom.
Async exchange AS IS
Pre asynchrónne výmeny bežne používame RabbitMQ. Zhromaždíme údaje na požiadavku, vložíme ich do fronty, a spotrebiteľ tej istej služby ich prečíta a odošle (alebo neodošle). Pre samotné API Lamoda aktívne využíva Swagger. Navrhujeme API, popisujeme ho v Swaggeri, generujeme klientsky a serverový kód. Ešte používame mierne rozšírený JSON RPC 2.0.
Niekde sa používajú esb-busy, niekto žije na ActiveMQ, ale vo všeobecnosti, RabbitMQ — štandard.
Async exchange TO BE
Pri navrhovaní výmeny cez events-bus sa dá sledovať analógia. Podobným spôsobom popisujeme budúcu výmenu údajov cez popisy štruktúry eventu. Formát yaml, kódová generácia musela byť vykonaná ručne, generátor podľa špecifikácie vytvára DTO a učí klientov a servery s nimi pracovať. Generácia prebieha na dva jazyky — golang a php. To umožňuje udržiavať knižnice v súlade. Generátor je napísaný v golangu, za čo dostal meno gogi.
Event sourcing na Kafka je typický. Existuje riešenie od hlavnej enterprise verzie Kafka Confluent, je tu aj , riešenie od našich 'bratov' v oblasti domény Zalando. Naša motivácia začať s vanilla Kafka je ponechať riešenie bezplatným, kým sa definitívne nerozhodneme, či ho budeme všade používať, a taktiež si nechať priestor na manévrovanie a úpravy: chceme podporu svojho JSON RPC 2.0, generátory pre dva jazyky a uvidíme, čo ešte.
Ironicky, aj v takom šťastnom prípade, keď existuje približne podobný obchod Zalando, ktorý urobil približne podobné riešenie, ho nemôžeme efektívne využiť.
Architektonicky na spustení je vzor taký: čítame priamo z Kafka, ale zapisujeme len cez events-bus. Pre čítanie v Kafka je veľa hotového: brokeri, vyvažovače a je viac-menej pripravená na horizontálne škálovanie, to sme chceli zachovať. Zápis sme chceli obaliť cez jeden Gateway aka Events-bus, a to je aj dôvod.
Events-bus
Alebo autobus udalostí. To je jednoducho stateless http gateway, ktorý preberá na seba niekoľko dôležitých úloh:
- Validácia produkcie — kontrolujeme, či udalosti zodpovedajú našej špecifikácii.
- Hlavný systém pre udalosti, to je hlavný a jediný systém v spoločnosti, ktorý odpovedá na otázku, aké sú vlastne validné udalosti s akými štruktúrami. V validácii sú zahrnuté jednoducho typy údajov a enums pre prísnu špecifikáciu obsahu.
- Hash funkcia pre shardovanie — štruktúra správy Kafka je key-value a hash z key sa používa na výpočet, kam to umiestniť.
Prečo
Pracujeme vo veľkej spoločnosti s nastaveným procesom. Prečo niečo meniť? Je to experiment, a máme v úmysle získať niekoľko výhod.
1:n+1 výmeny (jeden ku mnohým)
S Kafka je veľmi jednoduché pripojiť nových spotrebiteľov k API.
Predpokladajme, že máte adresár, ktorý je potrebné udržiavať aktuálny v niekoľkých systémoch naraz (a v nejakých nových). Predtým sme vymysleli bundle, ktorý realizoval set-API, a master-systému sme oznámili adresy spotrebiteľov. Teraz master-systém zasiela aktualizácie do topiku a všetci, ktorých to zaujíma, to čítajú. Objavil sa nový systém – prihlásili sme ho na topik. Áno, tiež bundle, ale jednoduchšie.
V prípade refund-tool, ktorý je vlastne kúsok BOB, nám vyhovuje držať ich synchronizované cez Kafka. Payment hovorí, že peniaze vrátili: BOB, RT sa o tom dozvedeli, zmenili si stavy, Fiscalization Service o tom vedel a vystavil bloček.
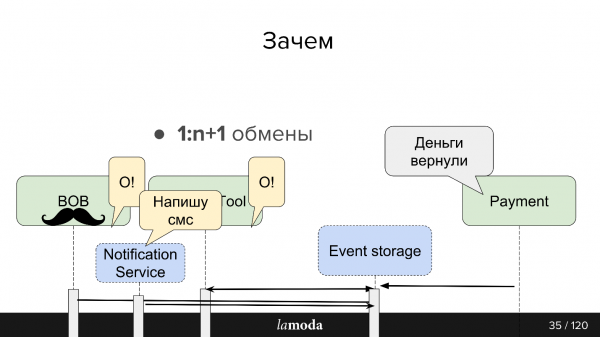
Máme plány vytvoriť jednotný Notifications Service, ktorý by informoval klienta o novinkách k jeho objednávke / vráteniam. Momentálne je táto zodpovednosť rozdelená medzi systémy. Stačí, ak naučíme Notifications Service odchytávať z Kafka relevantné informácie a reagovať na ne (a vypnúť tieto upozornenia v ostatných systémoch). Nebudú potrebné žiadne nové priame výmeny.
Data-driven
Informácie medzi systémami sa stávajú transparentnými – nech je akýkoľvek „krvavý enterprise“ u vás a akýkoľvek hrubý váš backlog. V Lamode máme oddelenie Data Analytics, ktoré zhromažďuje údaje zo systémov a prevádza ich do opakovane použiteľného formátu, ako pre biznis, tak aj pre inteligentné systémy. Kafka umožňuje rýchlo im poskytnúť veľa údajov a udržiavať tento informačný tok aktuálny.
Replication log
Správy nezmiznú po prečítaní, ako v RabbitMQ. Keď event obsahuje dostatok informácií na spracovanie, máme históriu posledných zmien objektu a, pri želaní, možnosť tieto zmeny aplikovať.
Doba uchovávania replication log závisí od intenzity zápisu do tohto topika, Kafka umožňuje flexibilne nastaviť limity času uchovávania a objemu údajov. Pre intenzívne topiky je dôležité, aby všetci spotrebitelia stihli prečítať informácie skôr, než zmiznú, aj v prípade krátkodobej nefunkčnosti. Zvyčajne sa podarí uchovávať údaje za jednotky dní, čo je úplne dostatočné pre podporu.
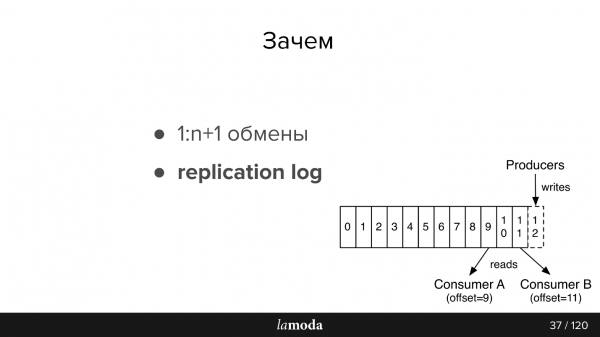
Ďalej len trošku zhrnutia dokumentácie pre tých, ktorí nie sú oboznámení s Kafka (obrázok tiež z dokumentácie)
V AMQP sú fronty: zapisujeme správy do fronty pre spotrebiteľa. Zvyčajne jednu frontu spravuje jeden systém s jednou a tou istou obchodnou logikou. Ak je potrebné upozorniť viacero systémov, môžeme naučiť aplikáciu zapisovať do viacerých front alebo nastaviť exchange s mechanizmom fanout, ktorý ich sám klonuje.
V Kafke existuje podobná abstrakcia témata, do ktorých zapisujete správy, ale po ich prečítaní nezmiznú. Predvolene, pri pripojení na Kafku, dostanete všetky správy a pritom je tu možnosť uložiť miesto, na ktorom ste sa zastavili. To znamená, že čítate sekvenčne, nemusíte označiť správu ako prečítanú, ale môžete si uložiť id, od ktorého potom pokračujete v čítaní. Id, na ktorom ste sa zastavili, sa nazýva offset (posun), a mechanizmus je commit offset.
Prislúchajúco môžete implementovať rôznu logiku. Napríklad, máme BOB existujúci v 4 inštanciách pre rôzne krajiny – Lamoda je v Rusku, Kazachstane, Ukrajine, Bielorusku. Keďže sa nasadzujú samostatne, majú trochu svoje vlastné konfigurácie a svoju obchodnú logiku. V správe uvádzame, k akej krajine patrí. Každý spotrebiteľ BOB v každej krajine číta s rôznymi groupId, a ak sa správa na neho nevzťahuje, preskočí ju, t.j. okamžite commitne offset +1. Ak to isté téma číta náš Platobný servis, tak to robí s oddelenou skupinou, a preto sa offsety neprekrývajú.
Požiadavky na udalosti:
- Úplnosť údajov. Chceli by sme, aby v udalosti bolo dostatok údajov, aby ju bolo možné spracovať.
- Integrita. Delegujeme Events-bus na kontrolu toho, že udalosť je konzistentná a on ju môže spracovať.
- Poradie je dôležité. V prípade vrátenia sme nútení pracovať s historickými údajmi. Pri notifikáciách poradie nie je dôležité, ak sú to homogénne notifikácie, e-mail bude rovnaký bez ohľadu na to, ktorý objednávka prišla prvý. V prípade vrátenia existuje jasný proces, ak zmeníte poradie, môžu vzniknúť výnimky, refundácia sa nevytvorí alebo nebude spracovaná – dostaneme sa do iného stavu.
- Konzistencia. Máme úložisko, a teraz namiesto API vytvárame udalosti. Potrebujeme spôsob, ako rýchlo a lacno posielať do našich služieb informácie o nových udalostiach a o zmenách v už existujúcich. To sa dosahuje pomocou spoločnej špecifikácie v samostatnom git repozitári a kódo-generátorov. Preto sú klienti a servery v rôznych službách u nás vzájomne dohodnuté.
Kafka v Lamoda
Máme tri inštalácie Kafka:
- Logs;
- R&D;
- Events-bus.
Dnes hovoríme len o poslednom bode. V events-bus máme nie veľmi veľké inštalácie - 3 brokeri (servery) a celkom 27 tém. Zvyčajne jedna téma je jeden proces. Ale to je jemný moment, a teraz sa k nemu dostaneme.
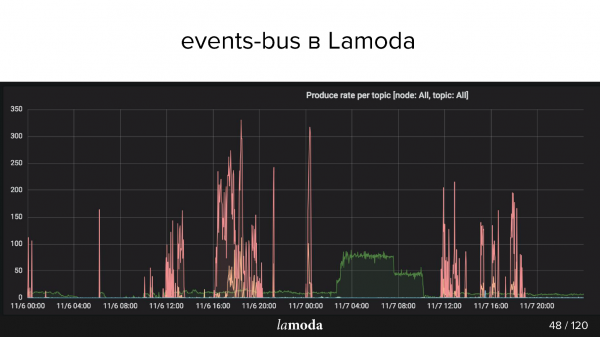
Na obrázku vyššie sú grafy rps. Proces refundácií je označený tyrkysovou čiarou (áno, tou, ktorá leží na osi X), a ružovou je proces aktualizácie obsahu.
Katalóg Lamoda obsahuje milióny produktov, pričom údaje sa neustále aktualizujú. Niektoré kolekcie vychádzajú z módy, na ich miesto sa uvádzajú nové, v katalógu sa neustále objavujú nové modely. Snažíme sa predpovedať, čo bude zajtra zaujímavé pre našich zákazníkov, a preto neustále nakupujeme nové veci, fotíme ich a aktualizujeme výklad.
Ružové vrcholy sú produktové aktualizácie, teda zmeny produktov. Je vidieť, že chalani fotili, fotili, a potom bum! - nahrali šaržu udalostí.
Use cases Lamoda Events
Vytvorenú architektúru používame na takéto operácie:
- Sledovanie stavov vrátení: call-to-action a sledovanie stavov zo všetkých zapojených systémov. Platba, stavy, fiskalizácia, notifikácie. Tu sme vyskúšali prístup, vytvorili nástroje, zhromaždili všetky chyby, napísali dokumentáciu a povedali kolegom, ako to používať.
- Aktualizácia kariet produktov: konfigurácia, meta-údaje, charakteristiky. Číta jeden systém (ktorý zobrazuje), a píšu ich viaceré.
- Email, push a sms: objednávka bola zhromaždená, objednávka dorazila, vrátenie prijaté a pod., mnoho ich.
- Sklad, aktualizácia stavu — kvantitatívna aktualizácia názvov, len čísla: príchod na sklad, vrátenie. Je potrebné, aby všetky systémy spojené s rezervovaním tovaru pracovaly s čo najaktuálnejšími údajmi. Teraz je systém aktualizácie skladu dosť zložitý, Kafka ho umožní zjednodušiť.
- Analýza dát (R&D oddelenie), ML nástroje, analýza, štatistika. Chceme, aby bola informácia transparentná – na to je Kafka veľmi vhodná.
Teraz tá zaujímavejšia časť o zbieraní skúseností a zaujímavých objavoch, ktoré sa stali za pol roka.
Problémy s dizajnom
Predpokladajme, že chceme spraviť novú vec – napríklad preniesť celý proces dodávky na Kafka. Momentálne je časť procesu implementovaná v Order Processing v BOB. Za prenosom objednávky do dopravnej služby, premiestnením na medziúložisko a podobne stojí model stavov. Existuje celý monolit, dokonca dva, plus množstvo API venovaných dodávke. Vedia oveľa viac o dodávke.
Zdá sa, že sú to podobné oblasti, ale pre Order Processing v BOB a pre systém dodávky sa stavy líšia. Napríklad niektoré kuriérske služby neposielajú medzičasové stavy, ale len konečné: „doručené“ alebo „stratené“. Iné naopak veľmi podrobne informujú o pohybe tovaru. Každý má svoje pravidlá validácie: pre niekoho je platný email, takže ho spracujú; pre ďalších je neplatný, ale objednávka sa aj tak spracuje, pretože je tam telefón na kontakt, a niekto povie, že takú objednávku vôbec spracovávať nebude.
Tok dát
V prípade Kafky vzniká otázka organizácie toku dát. Táto úloha súvisí s výberom stratégie z niekoľkých bodov, prejdeme si nimi všetkými.
Do jedného topiku alebo do rôznych?
Máme špecifikáciu udalosti. V BOB píšeme, že taká objednávka má byť doručená, a uvádzame: číslo objednávky, jej obsah, nejaké SKU a čiarové kódy atď. Keď tovar dorazí na sklad, doručenie môže získať stavy, timestamps a všetko, čo je potrebné. Ale ďalej chceme v BOB prijímať aktualizácie týchto údajov. Vzniká nám spätný proces prijímania dát z dodávky. Je to tá istá udalosť? Alebo je to samostatná výmena, ktorá si zaslúži samostatný topik?
Pravdepodobne budú veľmi podobné a pokušenie spraviť jeden topik nie je nezmyselné, pretože samostatný topik to sú samostatní konzumenti, samostatné konfigurácie, samostatná generácia všetkého tohto. Ale nie je to isté.
Nové pole alebo nová udalosť?
Ale ak používame tie isté udalosti, vzniká iný problém. Napríklad, nie všetky doručovacie systémy môžu vygenerovať také DTO, ktoré dokáže generovať BOB. Posielame im id, a oni ich neuchovávajú, pretože ich nepotrebujú, a z pohľadu začiatku procesu event-bus je toto pole povinné.
Ak zavedieme pre event-bus pravidlo, že toto pole je povinné, musíme v BOB alebo v spracovateľovi počiatočnej udalosti dať ďalšie pravidlá validácie. Validácia sa začína rozplývať po službe - to nie je veľmi praktické.
Ďalší problém - to je lákavá inkramentálna vývoj. Povedia nám, že treba niečo pridať do udalosti a možno, ak dobre porozmýšľame, to malo byť samostatná udalosť. Ale v našej schéme je samostatná udalosť - to samostatné téma. Samostatné téma - to je celý ten proces, ktorý som opísal vyššie. U vývojára sa objavuje pokušenie jednoducho pridať ďalšie pole do JSON schémy a regenerovať.
V prípade refunds sme tak za pol roka prišli k udalosti udalostí. Mali sme jedno meta-udalosť, ktoré sa nazýva refund update, v ktorom bolo pole type, popisujúce, v čom vlastne tento update spočíva. Z toho sme mali "nádherné" prepínače s validátormi, ktoré hovorili, ako je potrebné validovať túto udalosť s týmto type.
Verzionovanie udalostí
Na validáciu správ v Kafka je možné využiť , ale bolo potrebné to hneď započítať a použiť Confluent. V našom prípade s verzionovaním musíme byť opatrní. Nie vždy bude možné prečítať správy z replication log, pretože model "odišiel". Hlavne, je potrebné stavať verzie tak, aby bol model spätne kompatibilný: napríklad, urobiť pole dočasne nepovinné. Ak sú rozdiely príliš silné, začneme písať do nového témy, a klientov presúvame, keď dočítajú staré.
Záruka poradia čítania partitions
Témy vnútri Kafka sú rozdelené na partitions. To nie je veľmi dôležité, kým navrhujeme entity a výmeny, ale je to dôležité, keď sa rozhodujeme, ako to konzumovať a škálovať.
V bežných prípadoch zapisujete do Kafka jednu tému. Predvolené nastavenie používa jeden partition a všetky správy tejto témy končia v ňom. A konzument ich potom postupne číta. Predpokladajme, že teraz je potrebné systém rozšíriť, aby správy čítali dvaja rôzni konzumenti. Ak napríklad posielate SMS, môžete povedať, aby Kafka vytvorila ďalší partition, a Kafka začne rozdeľovať správy do dvoch častí – polovicu sem, polovicu tam.
Ako ich Kafka delí? Každá správa má telo (v ktorom uchovávame JSON) a má kľúč. K tomuto kľúču môžeme pripojiť hashovaciu funkciu, ktorá určuje, do ktorého partition správa patrí.
V našom prípade s refundami je to dôležité, ak vezmeme dva partition, existuje riziko, že paralelný konzument spracuje druhú udalosť skôr než prvú, čo by spôsobilo problém. Hashovacia funkcia zaručuje, že správy so samotným kľúčom skončia v jednom a tom istom partition.
Udalosti vs príkazy
Toto je ďalší problém, s ktorým sme sa stretli. Udalosť — to je istá udalosť: hovoríme, že niečo niekde nastalo (something_happened), napríklad položka bola zrušená alebo došlo k refundácii. Ak tieto udalosti niekto počúva, potom na „položka bola zrušená“ sa vytvorí entita refund, a „došlo k refundácii“ sa zapíše niekde v nastaveniach.
Ale zvyčajne, keď navrhujete udalosti, nechcete ich písať zbytočne — predpokladáte, že ich niekto bude čítať. Je lákavé napísať nie niečo_happened (item_canceled, refund_refunded), ale niečo_should_be_done. Napríklad, položka je pripravená na vrátenie.
Na jednej strane to naznačuje, ako sa udalosť bude používať. Na druhej strane to oveľa menej pripomína normálny názov udalosti. Okrem toho, odtiaľ je už len krôčik k príkazu do_something. Ale nemáte záruku, že túto udalosť niekto prečítal; a ak ju prečítal, prečítal ju úspešne; a ak ju prečítal úspešne, niečo urobil, a to niečo prešlo úspešne. V momente, keď sa udalosť stáva do_something, je potrebná spätná väzba, a to je problém.
Pri asynchrónnej výmene v RabbitMQ, keď prečítate správu, navštívite http, máte odpoveď — aspoň, že správa bola prijatá. Keď zapíšete do Kafka, máte správu, že ste zapísali do Kafka, ale o tom, ako bola spracovaná, nič neviete.
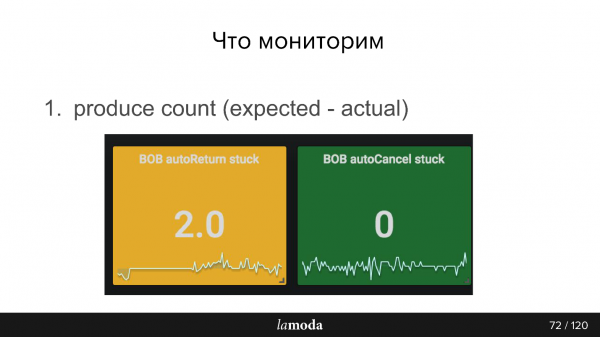
Preto sme museli zaviesť spätnú udalosť a nastaviť monitorovanie, aby sme zistili, že ak sa udialo toľko udalostí, v danom čase by sa malo vyskytnúť toľko odpovedajúcich udalostí. Ak sa to nestalo, akoby sme mali pocit, že niečo sa pokazilo. Napríklad, ak sme odoslali udalosť „item_ready_to_refund“, očakávame, že refundácia sa vytvorí, peniaze sa vrátia klientovi a vyjde nám udalosť „money_refunded“. Ale to nie je isté, preto potrebujeme monitorovanie.
Nuansy
Existuje dosť zjavný problém: ak čítate z topiku postupne a máte nejakú zložitú správu, spotrebiteľ sa zrúti a ďalej sa nedostanete. Musíte zastaviť všetkých spotrebiteľov, potvrdiť posun ďalej, aby ste mohli pokračovať v čítaní.
O tom sme vedeli, s tým sme počítali, a aj tak sa to stalo. Stalo sa to preto, že udalosť bola platná z pohľadu events-bus, udalosť bola platná z pohľadu validátora aplikácie, ale nebola platná z pohľadu PostgreSQL, pretože sme mali v jednej sústave MySQL s UNSIGNED INT, a v novo napísanej sústave bol PostgreSQL jednoducho s INT. Jeho veľkosť je o niečo menšia a ID sa nezmestilo. Symfony sa zrútilo s výnimkou. Samozrejme, zachytili sme túto výnimku, pretože sme na ňu počítali a plánovali sme potvrdiť tento posun, ale predtým sme chceli zvýšiť počet problémov, keďže správa bola nesprávne spracovaná. Počítadlá v tomto projekte sú tiež uložené v databáze a Symfony už uzavrelo komunikáciu s databázou, a druhá výnimka zabila celý proces bez šance na potvrdenie posunu.
N nejaký čas služba ležala - našťastie, s Kafka to nie je tak strašné, pretože správy zostávajú. Keď sa práca obnoví, môžete ich dočítať. Je to pohodlné.
Kafka má možnosť cez tooling nastaviť ľubovoľný posun. Ale aby ste to mohli urobiť, musíte zastaviť všetkých spotrebiteľov - v našom prípade pripraviť samostatné vydanie, v ktorom nebudú spotrebitelia, redeployments. Potom môžete pomocou toolingu v Kafke posunúť posun a správa prejde.
Ďalší nuans - replication log vs rdkafka.so — je spojená so špecifikami nášho projektu. Máme PHP a v PHP zvyčajne všetky knižnice komunikujú s Kafka cez repozitár rdkafka.so, a ďalej nasleduje nejaký wrapper. Možno sú to naše osobné ťažkosti, ale ukázalo sa, že jednoducho prečítať kúsok už prečítaného nie je také jednoduché. Všeobecne sme mali softvérové problémy.
Návrat k špecifikám práce s partitions, priamo v dokumentácii je napísané consumers >= topic partitions. Ale dozvedel som sa o tom oveľa neskôr, ako by som chcel. Ak chcete škálovať a mať dvoch konzumentov, potrebujete aspoň dve partitions. Teda, ak ste mali jeden partition, v ktorom sa nahromadilo 20 000 správ, a vytvorili ste nový, počet správ sa nevyrovná tak rýchlo. Preto, aby ste mali dvoch paralelných konzumentov, treba sa zaoberať partitions.
Monitorovanie
Myslím, že podľa toho, ako monitorujeme, bude ešte jasnejšie, aké problémy existujú v súčasnom prístupe.
Napríklad počítame, koľko produktov v databáze nedávno zmenilo stav a podľa týchto zmien mali nastať udalosti, a posielame toto číslo do nášho monitorovacieho systému. Potom z Kafka dostávame druhé číslo, koľko skutočne bolo zaznamenaných udalostí. Je zrejmé, že rozdiel medzi týmito dvoma číslami by mal byť vždy nulový.
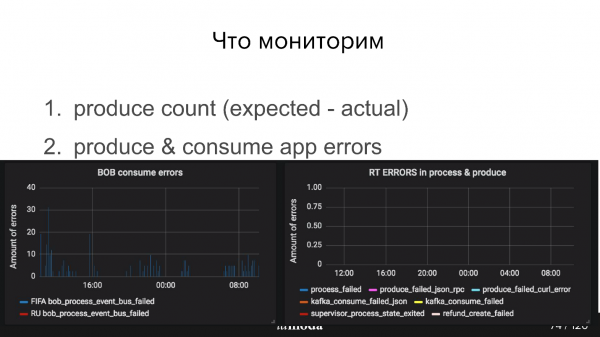
Okrem toho je potrebné monitorovať, ako si stojí producent, či prijal events-bus správy, a ako si stojí konzument. Napríklad na grafoch nižšie je všetko v poriadku s Refund Tool, ale BOB má jasne nejaké problémy (modré vrcholy).
Už som spomínal consumer-group lag. Hovorím zjednodušene, že to je počet neprečítaných správ. Celkovo naši konzumenti fungujú rýchlo, takže lag je obvykle 0, ale niekedy môže nastať krátkodobý vrchol. Kafka to zvláda z krabice, ale musíte zadať určitý interval.
Existuje projekt , ktorý vám poskytne viac informácií o Kafka. Jednoducho cez API poskytuje stav podľa consumer-group, ako sa tejto skupine darí. Okrem OK a Failed tam existuje aj warning, a zistíte, že vaše konzumenti nestíhajú tempo produkcie - nestíhajú čítať to, čo sa píše. Systém je dosť inteligentný a pohodlne sa používa.
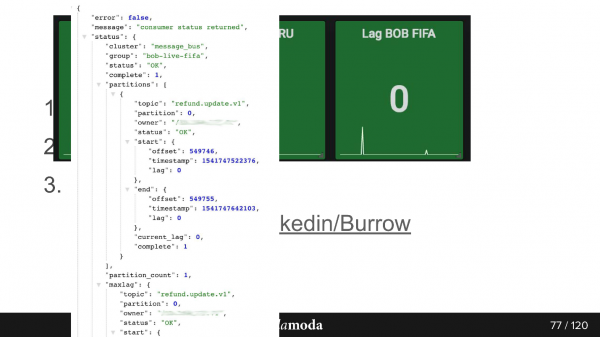
Takto vyzerá odpoveď cez API. Tu je skupina bob-live-fifa, partition refund.update.v1, stav OK, lag 0 - posledný konečný offset je takýto.
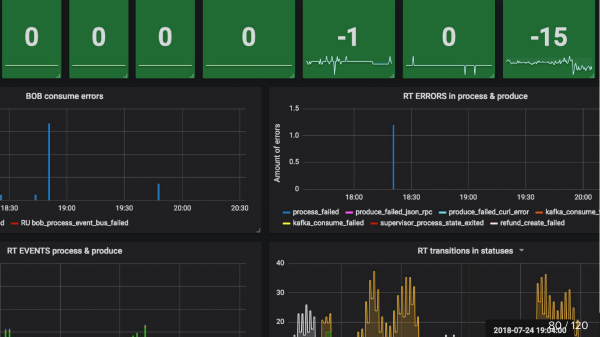
Monitorovanie updated_at SLA (stuck) Už som spomínal. Napríklad, tovar prešiel do stavu, že je pripravený na vrátenie. Nastavujeme Cron, ktorý hovorí, že ak za 5 minút tento objekt neprešiel do refundácie (peniaze vraciame prostredníctvom platobných systémov veľmi rýchlo), niečo určite nešlo tak, ako malo a je to určite prípad pre podporu. Preto jednoducho vezmeme Cron, ktorý číta takéto veci, a ak sú ich počet väčší ako 0, posiela upozornenie.
Na záver, používanie udalostí je pohodlné, keď:
- informácie potrebujú niekoľko systémov;
- výsledok spracovania nie je dôležitý;
- je málo udalostí alebo sú udalosti malé.
Skoro by sa zdalo, že článok má veľmi konkrétnu tému – asynchrónne API na Kafka, ale v súvislosti s ním chcem hneď odporučiť množstvo vecí.
Po prvé, nasledujúci nás treba čakať do novembra, už v apríli bude jeho peterburská verzia, a v júni sa budeme rozprávať o vysokých záťažiach v Novosibirsku.
Po druhé, autor správy Sergej Zaika patrí do Programového výboru našej novej konferencie o správe znalostí . Konferencia je jednedeňná, prebehne 26. apríla, ale má veľmi bohatý program.
A v máji sa uskutoční a (s DevOpsConf ako súčasťou) – do tejto konferencie je možné ešte navrhnúť svojou tému, podeliť sa o svoje skúsenosti a zdieľať svoje nabité rany.
Zdroj: habr.com
