

Každý veľký projekt začínal s pár servermi. Spočiatku bol jeden databázový server, potom k nemu pribudli slave servery na škálovanie čítania. A tu – stop! Mám jedného mastera a veľa slave serverov; ak jeden zo slave serverov zlyhá, všetko bude v poriadku, ale ak zlyhá master – bude zle: downtime, administrátori sa snažia obnoviť server. Čo robiť? Rezervovať mastera. Môj kolega Pavel už o tom písal , nebudem to opakovať. Namiesto toho vám poviem, prečo potrebujete Orchestrator pre MySQL!
Začneme hlavným otáznikom: „Ako prepneme kód na nový server pri zlyhaní mastera?“
- Schéma s VIP (virtuálna IP) sa mi páči najviac, o nej budeme hovoriť nižšie. Je najjednoduchšia a najsamozrejmejšia, hoci má jedno jasné obmedzenie: master, ktorého budeme rezervovať, musí byť v L2 segmente s novým strojom, teda na druhej lokalite sa môžeme zabudnúť. A navyše, ak by sme sa mali riadiť pravidlom, že veľké L2 je zlé, pretože L2 je len na stojan a medzi stojanmi je L3, a taká schéma má ešte viac obmedzení.
- Môžeme do kódu napísať DNS meno a rozresolvovať ho cez /etc/hosts. V skutočnosti ale rozrezolva nebude. Výhodou tejto schémy je, že nemá obmedzenie charakteristické pre prvý spôsob, takže môžeme organizovať aj cross-Datacenters. Ale napadá ma zjavná otázka, ako rýchlo zmeníme v /etc/hosts cez Puppet-Ansible.
- Druhý spôsob môžeme mierne upraviť: na všetkých webových serveroch nastavíme cachingový DNS, cez ktorý kód pôjde do master databázy. Môžeme nastaviť TTL 60 pre túto záznam v DNS. Zdá sa, že pri správnej implementácii je tento spôsob dobrý.
- Schéma so službou objavovania, ktorá predpokladá použitie Consul a etcd.
- Zaujímavá možnosť s . Musíme celý traffic na MySQL previesť cez ProxySQL, ProxySQL sám dokáže určiť, kto je teraz master. Mimochodom, o jednom z použití tohto produktu sa môžete dočítať v mojom .
Autor Orchestratora, pracujúci v Github, najprv implementoval prvú schému s VIP, a potom ju prepracoval na schému s consul.
Typická schéma infraštruktúry:
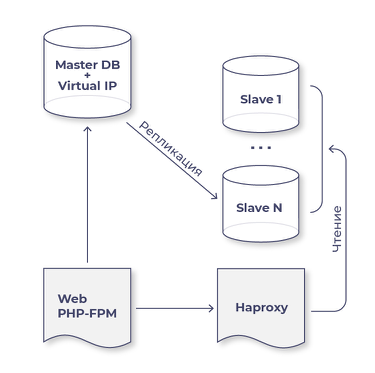
Ihneď popíšem očividné situácie, ktoré je potrebné zohľadniť:
- VIP adresa by nemala byť uvedená v konfigurácii na žiadnom zo serverov. Predstavme si situáciu: master sa reštartoval, a kým sa načíta, Orchestrator prešiel do režimu failover a urobil z jedného zo slave serverov mastera; potom sa starý master spustil, a teraz je VIP na dvoch zariadeniach. To je zle.
- Pre orchestrátora bude potrebné napísať skript na oslovovanie starého a nového majstra. Na starom by sa mala vykonať operácia ifdown, zatiaľ čo na novom majstrovi — ifup vip. Bolo by fajn tiež do tohoto skriptu zahrnúť, aby sa v prípade failoveru port na prepínači starého majstra jednoducho vypol, aby sa predišlo akémukoľvek splitbrainu.
- Po tom, čo Orchestrator spustil váš skript na prvé zrušenie VIP a/alebo vypnutie portu na prepínači, a následne na novom majstrovi spustil skript na aktiváciu VIP, nezabudnite príkazom arping informovať všetkých, že nový VIP je teraz tu.
- Vo všetkých slave by malo byť nastavené read_only=1, a akonáhle povýšite slave na majstra, mala by sa nastaviť read_only=0.
- Nezabúdajte, že majstrom sa môže stať akýkoľvek slave, ktorého sme vybrali na tento účel (orchestrátor má celý mechanizmus preferencií, ktorý slave považovať za kandidáta na nového majstra v prvom rade, ktorý v druhom, a ktorý slave by sa za žiadnych okolností nemal stať majstrom). Ak sa slave stane majstrom, zostane mu záťaž slava a pribudne záťaž majstra, toto je potrebné zohľadniť.
Prečo potrebujete Orchestrator, ak ho nemáte?
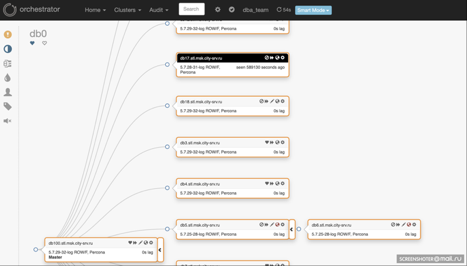
- Orchestrator má veľmi prívetivé grafické rozhranie, ktoré zobrazuje celú topológiu (pozrite screenshot nižšie).
- Orchestrator môže sledovať, ktoré slave sú pozadu, a kde sa replikácia úplne pokazila (k Orchestratoru sú pripojené skripty na posielanie SMS).
- Orchestrator vám hovorí, na ktorých slave je chyba GTID errant.
Rozhranie Orchestrator:
Čo je to GTID errant?
Existujú dva základné požiadavky na fungovanie Orchestratoru:
- Musí byť na všetkých strojoch MySQL klastru povolený pseudo GTID, máme povolený GTID.
- Musí byť všade rovnaký typ binlogov, môže to byť statement. Mali sme takú konfiguráciu, pri ktorej bol na majstrovi a na väčšine slave Row, zatiaľ čo na dvoch zostal historicky režim Mixed. V dôsledku toho tieto slave Orchestrator jednoducho nechcel pripojiť k novému majstrovi.
Pamätajte, že najdôležitejšie na production slave je jeho konzistencia s majstrom! Ak máte na majstrovi aj na slave zapnutý Global Transaction ID (GTID), môžete cez funkciu gtid_subset zistiť, či na týchto strojoch boli vykonané rovnaké príkazy na zmenu dát. O tom si môžete prečítať viac. .
Takže Orchestrator vám prostredníctvom chyby GTID errant ukazuje, že na slave sú transakcie, ktoré na masteri nie sú. Prečo sa to deje?
- Na slave nie je povolený read_only=1, niekto sa pripojil a vykonal príkaz na zmenu údajov.
- Na slave nie je povolený super_read_only=1, takže administrátor, zamieňajúc servery, sa prihlásil a tam vykonal príkaz.
- Ak ste zohľadnili oba predchádzajúce body, existuje ešte jeden trik: v MySQL príkaz na flush binlogov sa tiež zapisuje do binlogu, takže pri prvom flush na masteri a na všetkých slave sa objaví GTID errant. Ako tomu predísť? V perona-5.7.25-28 sa objavila konfigurácia binlog_skip_flush_commands=1, ktorá zakazuje zapisovanie flush do binlogov. Na stránke mysql.com je to zaregistrované. .
Zhrňujem všetko predchádzajúce. Ak zatiaľ nechcete používať Orchestrator v režime failover, nastavte ho na režim sledovania. Potom vždy budete mať na očiach mapu interakcie MySQL strojov a prehľadné informácie o type replikácie na každom stroji, či sú slave pozadu a najdôležitejšie — ako veľmi sú konzistentné s masterom!
Zrejmá otázka: „Ako má Orchestrator fungovať?“ Musí vybrať nového mástra z aktuálnych slave a potom na neho prepojiť všetky slave (presne na to je potrebný GTID; ak by ste použili starý mechanizmus s binlog_name a binlog_pos, prechod slave z aktuálneho mástra na nový by bol jednoducho nemožný!). Predtým, než sme mali Orchestrator, musel som to raz robiť ručne. Starý master zamieňal kvôli poruchovému ovládaču Adaptec, mal okolo 10 slave. Musel som preniesť VIP z mástra na jeden z slave a prepojiť naň všetky ostatné slave. Koľko konzol som musel otvoriť, koľko súčasných príkazov zadať... Musel som čakať do 3. hodiny ráno, uvoľniť záťaž zo všetkých slave, okrem dvoch, urobiť z prvej mašiny z dvoch mástra, okamžite k nej pripojiť druhú mašinu, takže ku novému mástrovi pripojiť všetky ostatné slave a vrátiť záťaž. Skrátka, hrozné...
Ako Orchestrator funguje, keď prechádza do režimu failover? Najľahšie to ukážem na príklade situácie, keď chceme urobiť mástrem výkonnejší, modernejší stroj, než aký máme teraz.
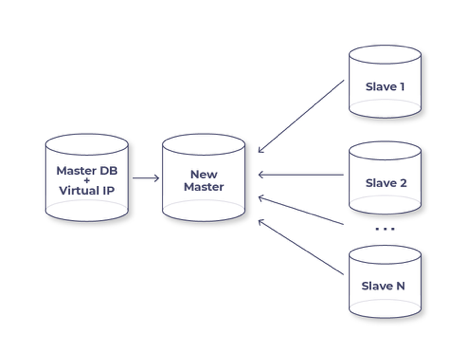
Na obrázku je zobrazená stredná fáza procesu. Čo už bolo urobené pred týmto okamihom? Povedali sme, že chceme spraviť nejakého sl jeva novým majstrom, Orchestrator začal jednoducho prepojíť k nemu všetkých ostatných sl eevov, pričom nový majster plní úlohu tranzitného stroja. Pri tejto schéme sa chyby nevyskytujú, všetci sl evi pracujú, Orchestrator odstráni VIP zo starého majstra, presunie ho na nový, nastaví read_only=0 a zabudne na starého majstra. A je to! Doba nefunkčnosti našich služieb je čas potrebný na presun VIP, čo sú 2-3 sekundy.
Dnes je to všetko, ďakujem všetkým. Čoskoro bude druhý článok o Orchestrator. V známej sovietskej filme „Garáž“ jeden hrdina povedal „S ním by som do prieskumu nešiel!“ Takže, Orchestrator, s tebou by som do prieskumu šiel!
Zdroj: habr.com
