

V Linuxe je veľa nástrojov na ladenie jadra a aplikácií. Väčšina z nich negatívne ovplyvňuje výkon aplikácií a nemôže byť použitá v produkcii.
Pred niekoľkými rokmi bol vyvinutý ďalší nástroj V súčasnosti už existuje množstvo aplikačných utilít, ktoré využívajú eBPF, a v tomto článku si ukážeme, ako napísať vlastnú utilitu na profilovanie na základe knižnice
PythonBCC Ceph Is Slow
Do clustra Ceph bol pridaný nový hostiteľ. Po migrácii časti údajov na neho sme si všimli, že rýchlosť spracovania zápisových požiadaviek na ňom je oveľa nižšia ako na ostatných serveroch.
Na rozdiel od iných platforiem, na tomto hoste sa používal bcache a nové jadro linux 4.15. Takáto konfigurácia hosta tu bola použitá prvýkrát. A bolo jasné, že príčinou problému mohla byť teoreticky čokoľvek.
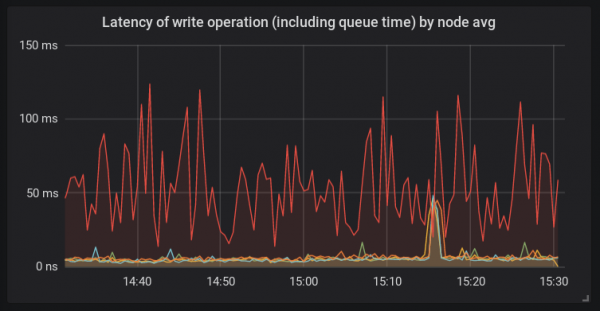
Investigating the Host
Začneme tým, že sa pozrieme na to, čo sa deje v procese ceph-osd. Na tento účel využijeme
flamescope a Obrázok nám hovorí, že funkcia ):
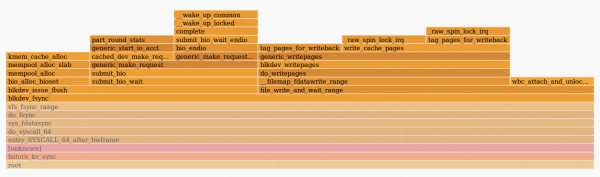
strávila veľa času pri odosielaní požiadavky do funkcie fdatasync() generic_make_request() . To znamená, že pravdepodobne problém je niekde mimo samotného demóna osd. Môže to byť buď jadro, alebo disky. Výstup iostat ukazoval vysokú oneskorenosť spracovania požiadaviek bcache-diskami.Pri kontrole hosta sme zistili, že demón systemd-udevd spotrebováva veľké množstvo času CPU — okolo 20 % na niekoľkých jadrách. Toto je zvláštne správanie, takže je potrebné zistiť jeho príčinu. Keďže Systemd-udevd pracuje s ueventami, rozhodli sme sa nazrieť do nich prostredníctvom
udevadm monitor . Ukazuje sa, že sa generovalo veľké množstvo change-udalostí pre každý blokový zariadení v systéme. To je dosť nezvyčajné, takže sa budeme musieť pozrieť, čo generuje všetky tieto udalosti.Using the BCC Toolkit
Ako sme už zistili, jadro (a demón ceph v systémovom volaní) trávi veľa času v
. Pokúsime sa zmerať rýchlosť práce tejto funkcie. V . To znamená, že pravdepodobne problém je niekde mimo samotného demóna osd. Môže to byť buď jadro, alebo disky. Výstup iostat ukazoval vysokú oneskorenosť spracovania požiadaviek bcache-diskami.BCC funclatency funclatency. Budeme sledovať démon jeho PID s intervalom medzi výstupmi informácií 1 sekundu a výstupom výsledku v milisekundách.
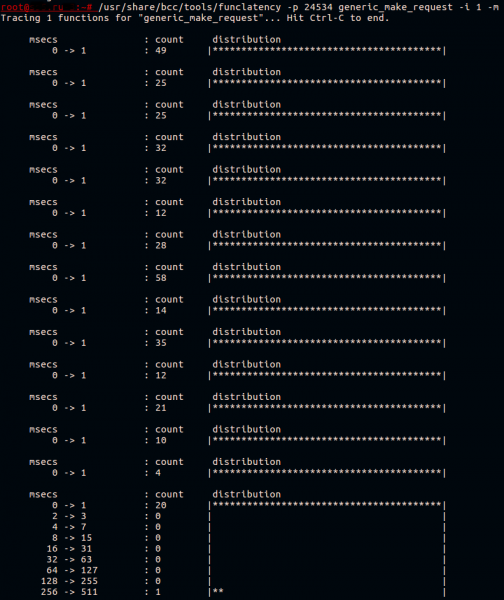
Zvyčajne táto funkcia pracuje rýchlo. Všetko, čo robí, je odosielanie požiadavky do fronty ovládača zariadenia.
Bcache je zložitý zariadenie, ktoré sa v skutočnosti skladá z troch diskov:
- backing device (cacheovaný disk), v tomto prípade pomalý HDD;
- caching device (cacheovací disk), tu ide o jeden partition NVMe zariadenia;
- virtuálne zariadenie bcache, s ktorým aplikačný program interaguje.
Vieme, že odosielanie požiadavky spomaľuje, ale pre ktoré zo zariadení? S tým sa zaoberáme o chvíľu.
Momentálne vieme, že ueventy pravdepodobne spôsobujú problémy. Nájdenie toho, čo presne spôsobuje ich generáciu, nie je také jednoduché. Predpokladajme, že ide o nejaký softvér, ktorý sa spúšťa periodicky. Pozrieme sa, aký softvér sa spúšťa v systéme s pomocou skriptu execsnoop z toho istého . Spustíme ho a nasmerujeme výstup do súboru.
Napríklad takto:
/usr/share/bcc/tools/execsnoop | tee ./execdump
Nebudeme tu uvádzať celý výstup execsnoop, ale zaujímavý riadok vyzeral takto:
sh 1764905 5802 0 sudo arcconf getconfig 1 AD | grep Temperature | awk -F '[:\/]' '{print $2}' | sed 's\/^ ([0-9]*) C.*\/1\/'
Tretí stĺpec je PPID (parent PID) procesu. Proces s PID 5802 bol jedným z vlákien nášho monitorovacieho systému. Pri kontrole konfigurácie monitorovacieho systému boli nájdené nesprávne nastavené parametre. Teplota HBA-adaptéra bola zaznamenávaná každých 30 sekúnd, čo je oveľa častejšie, ako potrebné. Po zmene intervalu kontroly na dlhší sme zistili, že oneskorenie spracovania požiadaviek na tomto hostiteľovi prestalo vyčnievať na pozadí ostatných hostiteľov.
Ale stále nie je jasné, prečo bcache zariadenie tak spomaľovalo. Pripravili sme testovaciu platformu s identickou konfiguráciou a pokúsili sa problém reprodukovať, spustením fio na bcache a periodicky spúšťaním udevadm trigger na generovanie uevents.
Písanie nástrojov založených na BCC
Skúsime napísať jednoduchý nástroj na sledovanie a zobrazenie najpomalších volaní . To znamená, že pravdepodobne problém je niekde mimo samotného demóna osd. Môže to byť buď jadro, alebo disky. Výstup iostat ukazoval vysokú oneskorenosť spracovania požiadaviek bcache-diskami.. Zaujíma nás aj názov disku, pre ktorý bola táto funkcia vyvolaná.
Plán je jednoduchý:
- Registrovať kprobe na . To znamená, že pravdepodobne problém je niekde mimo samotného demóna osd. Môže to byť buď jadro, alebo disky. Výstup iostat ukazoval vysokú oneskorenosť spracovania požiadaviek bcache-diskami.:
- Uložiť do pamäte názov disku, ktorý je dostupný cez argument funkcie;
- Uložiť časovú pečiatku.
- Registrovať kretprobe na návrat z . To znamená, že pravdepodobne problém je niekde mimo samotného demóna osd. Môže to byť buď jadro, alebo disky. Výstup iostat ukazoval vysokú oneskorenosť spracovania požiadaviek bcache-diskami.:
- Získať aktuálnu časovú pečiatku;
- Hľadať uloženú časovú pečiatku a porovnať s aktuálnou;
- Ak výsledok presahuje danú hodnotu, nájdeme uložené meno disku a zobrazíme ho na termináli.
Kprobes a kretprobes používajú mechanizmus breakpointov na dynamickú zmenu kódu funkcií. Môžete si prečítať a článok na túto tému. Ak sa pozrieme na kód rôznych utilít v , môžeme si všimnúť, že majú identickú štruktúru. Preto v tomto článku preskočíme parsovanie argumentov skriptu a prejdeme k samotnému BPF programu.
Text eBPF vo python-skripte vyzerá nasledovne:
bpf_text = """ # Tu bude kód programu bpf """
Na výmenu údajov medzi funkciami, eBPF programy používajú . Takto urobíme aj my. Ako kľúč použijeme PID procesu a ako hodnotu určíme štruktúru:
struct data_t {
	u64 pid;
	u64 ts;
	char comm[TASK_COMM_LEN];
	u64 lat;
	char disk[DISK_NAME_LEN];
};

BPF_HASH(p, u64, struct data_t);
BPF_PERF_OUTPUT(events);
Tu registrujeme hashovaciu tabuľku, ktorá sa nazýva p, s kľúčom typu u64 a hodnotou typu struct data_t. Tabuľka bude dostupná v kontexte našej BPF-programu. Makro BPF_PERF_OUTPUT registruje inú tabuľku, nazývanú events, ktorá sa používa na do používateľského priestoru.
Pri meraní oneskorení medzi volaním funkcie a jej návratom, alebo medzi volaniami rôznych funkcií, musíme mať na pamäti, že získané údaje musia patriť rovnakému kontextu. Inými slovami, treba pamätať na možný paralelný beh funkcií. Máme možnosť zmerať oneskorenie medzi volaním funkcie v kontexte jedného procesu a návratom z tejto funkcie v kontexte iného procesu, ale to bude pravdepodobne zbytočné. Dobrým príkladom tu môže byť , kde ako kľúč hashovacej tabuľky slúži ukazovateľ na struct request, ktorá odráža jeden požiadavok na disk.
Ďalej musíme napísať kód, ktorý sa spustí pri volaní skúmanej funkcie:
void start(struct pt_regs *ctx, struct bio *bio) {
	u64 pid = bpf_get_current_pid_tgid();
	struct data_t data = {};
	u64 ts = bpf_ktime_get_ns();
	data.pid = pid;
	data.ts = ts;
	bpf_probe_read_str(&data.disk, sizeof(data.disk), (void*)bio->bi_disk->disk_name);
	p.update(&pid, &data);
}
Tu bude ako druhý argument zadaný prvý argument volanej funkcie . Po tomto dostaneme PID procesu, v ktorom pracujeme, a aktuálnu časovú pečiatku v nanosekundách. Zaznamenáme to všetko do čerstvo alokovanej struct data_t data. Meno disku získavame zo štruktúry bio, ktorá sa prenáša pri volaní . To znamená, že pravdepodobne problém je niekde mimo samotného demóna osd. Môže to byť buď jadro, alebo disky. Výstup iostat ukazoval vysokú oneskorenosť spracovania požiadaviek bcache-diskami., a uchovávame ju v tej istej štruktúre data. Posledným krokom je pridať záznam do hash tabuľky, o ktorej sme hovorili skôr.
Nasledujúca funkcia sa bude volať pri návrate z . To znamená, že pravdepodobne problém je niekde mimo samotného demóna osd. Môže to byť buď jadro, alebo disky. Výstup iostat ukazoval vysokú oneskorenosť spracovania požiadaviek bcache-diskami.:
void stop(struct pt_regs *ctx) {
    u64 pid = bpf_get_current_pid_tgid();
    u64 ts = bpf_ktime_get_ns();
    struct data_t* data = p.lookup(&pid);
    if (data != 0 && data->ts > 0) {
        bpf_get_current_comm(&data->comm, sizeof(data->comm));
        data->lat = (ts - data->ts) / 1000;
        if (data->lat > MIN_US) {
            FACTOR
            data->pid >>= 32;
            events.perf_submit(ctx, data, sizeof(struct data_t));
        }
        p.delete(&pid);
    }
}
Táto funkcia je podobná predchádzajúcej: zistíme PID procesu a časovú pečiatku, ale nevyčleňujeme pamäť pre novú štruktúru data. Namiesto toho hľadáme v hash tabuľke už existujúcu štruktúru podľa kľúča == aktuálny PID. Ak bola štruktúra nájdená, zistíme meno spusteného procesu a pridáme ho do nej.
Binaries shift, ktorý tu používame, je potrebný na získanie GID vlákna, t.j. PID hlavného procesu, ktorý spustil vlákno, v kontexte, v ktorom pracujeme. Voláme funkciu vracia GID vlákna aj jeho PID v jednom 64-bitovom hodnotení.
Pri výstupe do terminálu nás teraz nezaujíma vlákno, ale zaujíma nás hlavný proces. Po porovnaní získanej latencie so zadaným prahom, posúvame našu štruktúru data do používateľského priestoru prostredníctvom tabuľky events, po čom odstránime záznam z p.
V python skripte, ktorý načíta tento kód, musíme nahradiť MIN_US a FACTOR prahmi latencie a jednotkami času, ktoré predáme prostredníctvom argumentov:
bpf_text = bpf_text.replace('MIN_US', str(min_usec))
if args.milliseconds:
	bpf_text = bpf_text.replace('FACTOR', 'data->lat /= 1000;')
	label = "msec"
else:
	bpf_text = bpf_text.replace('FACTOR', '')
	label = "usec"
Teraz musíme pripraviť BPF program prostredníctvom a zaregistrovať stupne:
b = BPF(text=bpf_text)
b.attach_kprobe(event="generic_make_request", fn_name="start")
b.attach_kretprobe(event="generic_make_request", fn_name="stop")
Tiež budeme musieť definovať struct data_t v našom skripte, inak nič nebudeme môcť čítať:
TASK_COMM_LEN = 16	# linux/sched.h
DISK_NAME_LEN = 32	# linux/genhd.h
class Data(ct.Structure):
	_fields_ = [("pid", ct.c_ulonglong),
            	("ts", ct.c_ulonglong),
            	("comm", ct.c_char * TASK_COMM_LEN),
            	("lat", ct.c_ulonglong),
            	("disk", ct.c_char * DISK_NAME_LEN)]
Posledný krok — výstup údajov na terminál:
def print_event(cpu, data, size):
    global start
    event = ct.cast(data, ct.POINTER(Data)).contents
    if start == 0:
        start = event.ts
    time_s = (float(event.ts - start)) / 1000000000
    print("%-18.9f %-16s %-6d   %-1s %s   %s" % (time_s, event.comm, event.pid, event.lat, label, event.disk))

b["events"].open_perf_buffer(print_event)
# format output
start = 0
while 1:
    try:
        b.perf_buffer_poll()
    except KeyboardInterrupt:
        exit()
Skript je k dispozici na . Pokusíme se jej spustit na testovací platformě, kde běží fio zapisující na bcache, a spustíme udevadm monitor:
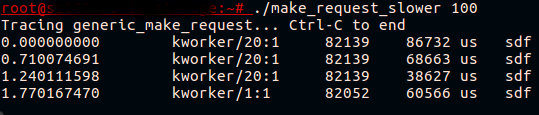
Konečně! Nyní vidíme, že to, co vypadalo jako zpomalující zařízení bcache, je ve skutečnosti zpomalující volání . To znamená, že pravdepodobne problém je niekde mimo samotného demóna osd. Môže to byť buď jadro, alebo disky. Výstup iostat ukazoval vysokú oneskorenosť spracovania požiadaviek bcache-diskami. pro cacheovaný disk.
Analyzujte jádro
Co přesně zpomaluje při zpracování požadavku? Vidíme, že zpoždění nastává ještě před tím, než začne akce účtování požadavku, tj. sledování konkrétního požadavku pro další statistiku ( /proc/diskstats nebo iostat) ještě nebylo zahájeno. To lze snadno zkontrolovat spuštěním iostat během reprodukce problému, nebo , který se zakládá na začátku a konci účtování požadavků. Žádný z těchto nástrojů neukáže problémy pro požadavky na cacheovaný disk.
Pokud se podíváme na funkci . To znamená, že pravdepodobne problém je niekde mimo samotného demóna osd. Môže to byť buď jadro, alebo disky. Výstup iostat ukazoval vysokú oneskorenosť spracovania požiadaviek bcache-diskami., uvidíme, že ještě před zahájením účtování požadavku jsou volány další dvě funkce. První — generic_make_request_checks(), provádí validaci požadavku vzhledem k nastavením disku. Druhá — , ve které se nachází zajímavé volání :
ret = wait_event_interruptible(q->mq_freeze_wq,
	(atomic_read(&q->mq_freeze_depth) == 0 &&
	(preempt || !blk_queue_preempt_only(q))) ||
	blk_queue_dying(q));
V něm jádro čeká na odmrazení fronty. Změřme zpoždění blk_queue_enter():
~# /usr/share/bcc/tools/funclatency  blk_queue_enter -i 1 -m
Sledování 1 funkcí pro "blk_queue_enter"... Stiskněte Ctrl-C pro ukončení.

 	msecs           	: počet 	odělení
     	0 -> 1      	: 341  	|****************************************|

 	msecs           	: počet 	odělení
     	0 -> 1      	: 316  	|****************************************|

 	msecs           	: počet 	odělení
     	0 -> 1      	: 255  	|****************************************|
     	2 -> 3      	: 0    	|                                    	|
     	4 -> 7      	: 0    	|                                    	|
     	8 -> 15     	: 1    	|                                    	|
Zdá se, že jsme blízko k rozluštění. Funkce používané pro "zmrazení/odmrazení" fronty jsou a . Používají se, když je nezbytné změnit nastavení fronty požadavků, které by mohly být nebezpečné pro požadavky nacházející se v této frontě. Při volání blk_mq_freeze_queue() funkcí se inkrementuje čítač q->mq_freeze_depth. Po tomto jadro čaká na vyprázdnenie fronty v .
Čas čakania na vyprázdnenie tejto fronty je ekvivalentný oneskoreniu disku, pretože jadro čaká na dokončenie všetkých operácií vo fronte. Akonáhle je fronta prázdna, uskutočňujú sa zmeny nastavení. Potom sa volá , dekrementujúci počítadlo freeze_depth.
Teraz vieme dosť na to, aby sme situáciu napravili. Príkaz udevadm trigger vedie k aplikácii nastavení pre blokové zariadenie. Tieto nastavenia sú popísané v pravidlách udev. Môžeme zistiť, ktoré konkrétne nastavenia "zmrazujú" frontu, pokusom o ich zmenu cez sysfs alebo pozretím zdrojového kódu jadra. Môžeme tiež vyskúšať nástroj BCC , ktorý vypíše do terminálu stopy zásobníka jadra a užívateľského priestoru pre každý hovor blk_freeze_queue, napríklad:
~# /usr/share/bcc/tools/trace blk_freeze_queue -K -U
PID 	TID 	COMM        	FUNC
3809642 3809642 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [javorník]
    	elevator_switch+0x29 [javorník]
    	elv_iosched_store+0x197 [javorník]
    	queue_attr_store+0x5c [javorník]
    	sysfs_kf_write+0x3c [javorník]
    	kernfs_fop_write+0x125 [javorník]
    	__vfs_write+0x1b [javorník]
    	vfs_write+0xb8 [javorník]
    	sys_write+0x55 [javorník]
    	do_syscall_64+0x73 [javorník]
    	entry_SYSCALL_64_after_hwframe+0x3d [javorník]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[neznáme]

3809631 3809631 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [javorník]
    	queue_requests_store+0xb6 [javorník]
    	queue_attr_store+0x5c [javorník]
    	sysfs_kf_write+0x3c [javorník]
    	kernfs_fop_write+0x125 [javorník]
    	__vfs_write+0x1b [javorník]
    	vfs_write+0xb8 [javorník]
    	sys_write+0x55 [javorník]
    	do_syscall_64+0x73 [javorník]
    	entry_SYSCALL_64_after_hwframe+0x3d [javorník]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[neznáme]
Pravidlá udev sa menia pomerne zriedkavo a zvyčajne sa to deje pod kontrolou. Vidíme teda, že aj aplikácia už zadaných hodnôt spôsobuje nárast latencie pri prenose požiadavky z aplikácie na disk. Samozrejme, generovať udalosti udev, keď nie sú žiadne zmeny v konfigurácii diskov (napríklad zariadenie sa nepripojuje/odpojuje), nie je práve najlepšou praxou. Napriek tomu môžeme pomôcť jadru, aby sa vyhlo zbytočnej práci a nezamrazovalo frontu požiadaviek, ak to nie je potrebné. napravujú situáciu.
Záver
eBPF je veľmi flexibilný a mocný nástroj. V článku sme si prešli jeden praktický prípad a predviedli sme malú časť toho, čo je možné dosiahnuť. Ak vás zaujíma vývoj nástrojov BCC, stojí za to sa pozrieť na , ktorý dobre popisuje základy práce.
Existujú aj iné zaujímavé nástroje na ladenie a profilovanie založené na eBPF. Jeden z nich je , ktorý umožňuje písať mocné jednorázové skripty a malé programy v awk-like jazyku. Ďalší je , ktorý umožňuje zhromažďovať nízkovrstvové metriky s vysokým rozlíšením priamo na váš prometheus server, s možnosťou následne získať peknú vizualizáciu a dokonca aj upozornenia.
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish