

Ahoj, Habr!
Pripomíname, že sme vydali ďalšiu mimoriadne zaujímavú a užitočnú o vzoroch Kubernetes. Všetko to začalo s "" Brendana Burnsa, a, mimochodom, práca v tejto oblasti u nás . Dnes vám ponúkame prečítať si článok z blogu MinIO, ktorý stručne zobrazuje trendy a špecifiká vzorov ukladania údajov v Kubernetes.
Kubernetes zásadne zmenil tradičné vzory vývoja a nasadzovania aplikácií. Teraz môže tím stráviť len niekoľko dní na vývoji, testovaní a nasadení aplikácie – v rôznych prostrediach, a to všetko v rámci klastrov Kubernetes. Takáto práca s technológiami predchádzajúcich generácií obyčajne trvala celé týždne, ak nie mesiace.
Toto zrýchlenie sa stalo možným vďaka abstrakcii, ktorú Kubernetes poskytuje – to znamená, že Kubernetes sám uskutočňuje interakciu s nízkovrstvovými detailmi fyzických alebo virtuálnych strojov, pričom užívateľom umožňuje vyhlasovať medzi inými parametrami potrebný procesor, potrebný objem pamäte a počet inštancií kontajnerov. Keďže podporou Kubernetes je zaangažované obrovské spoločenstvo a rozsah nasadenia Kubernetes sa neustále rozširuje, s veľkým odstupom vedie medzi všetkými platformami orchestrácie kontajnerov.
S rastúcim využitím Kubernetes sa zvyšuje aj zmätok ohľadom vzorov ukladania údajov, ktoré v ňom používajú..
Pri všeobecnej konkurencii o kúsok koláča Kubernetes (teda o úložisko údajov), keď sa hovorí o uložení údajov, jej signál sa stráca v silnom šume.
Kubernetes zosobňuje moderný model vývoja a nasadzovania aplikácií, ako aj ich správy. Tento moderný model oddeluje ukladanie údajov od výpočtov. Aby ste plne pochopili takéto oddelenie v kontexte Kubernetes, musíte tiež pochopiť, čo sú aplikácie s uchovaním stavu a bez uchovania stavu a ako to súvisí s ukladaním údajov. Tu má prístup REST API, ktorý sa používa v S3, zjavné výhody v porovnaní s prístupom POSIX/CSI, charakteristickým pre iné riešenia.
V tomto článku sa budeme rozprávať o vzoroch ukladania údajov v Kubernetes a osobitne sa dotkneme debaty o aplikáciách fungujúcich s ukladaním a bez ukladania stavu, aby sme porozumeli, aký je medzi nimi rozdiel a prečo je to dôležité. Ďalej v texte budú preskúmané aplikácie a použité vzory ukladania údajov v svetle osvedčených praktík práce s kontajnermi a Kubernetes.
Kontajnery bez ukladania stavu
Kontajnery sú zo svojej podstaty ľahké a efemérne. Možno ich bez problémov zastavovať, mazať alebo nasadzovať na iný uzol – všetko to trvá len niekoľko sekúnd. V veľkom systéme orchestrácie kontajnerov sa takéto operácie dejú neustále a používatelia si ani nevšimnú takéto zmeny. Avšak presuny sú možné iba vtedy, ak kontajner nemá žiadne závislosti od uzla, na ktorom sa nachádza. O takých kontajneroch hovoríme, že fungujú bez ukladania stavu.
Kontajnery s ukladaním stavu
Ak kontajner uchováva údaje na lokálne pripojených zariadeniach (alebo na blokovom zariadení), potom sa úložisko údajov, na ktorom sa nachádza, musí presunúť na nový uzol spolu s kontajnerom – v prípade zlyhania. Je to dôležité, pretože inak aplikácia bežiaca v kontajneri nebude schopná správne fungovať, keďže potrebuje pristupovať k údajom uloženým na miestnych médiách. O takých kontajneroch hovoríme, že fungujú s ukladaním stavu.
Z čisto technického hľadiska je možné kontajnery s ukladaním stavu tiež presúvať na iné uzly. Obvykle to zabezpečuje pomocou distribuovaných súborových systémov alebo blokových sieťových úložísk pripojených ku všetkým uzlom, na ktorých pracujú kontajnery. Týmto spôsobom kontajnery získavajú prístup k objemom pre trvalé ukladanie údajov a informácie sú uložené na diskoch nachádzajúcich sa po celej sieti. Tento prístup nazvem „kontajnerovým prístupom s ukladaním stavu“, a v zostávajúcej časti článku ho tak budem nazývať pre zachovanie jednotnosti.
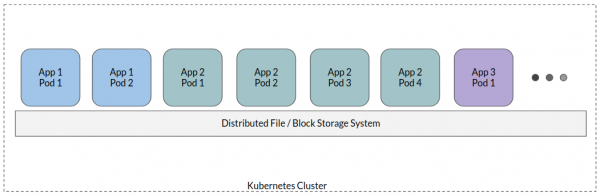
Pri typickom prístupe k softvérovým kontajnerom s udržiavaním stavu sú všetky pod aplikácií pripojené k jednej distribuovanej súborovej sústave – ide v podstate o akúsi zdieľanú pamäť, kde sa nachádzajú všetky dáta aplikácií. Hoci sú možné niektoré variácie, toto je vysokonávrhový prístup.
Teraz sa pozrime, prečo je prístup k softvérovým kontajnerom s udržiavaním stavu v prostredí orientovanom na cloud antipatrom.
Cloudovo orientované navrhovanie aplikácií
Tradične aplikácie používali databázy na štruktúrované ukladanie informácií a lokálne disky alebo distribuované súborové systémy, kam sa ukladali všetky neštruktúrované alebo dokonca pološtruktúrované dáta. S narastajúcim objemom neštruktúrovaných dát si vývojári uvedomili, že POSIX je príliš "rozprávaný", spojený so značnými nákladmi a nakoniec bráni činnosti aplikácie pri prechode na naozaj veľké objemy.
To v podstate viedlo k vzniku nového štandardu ukladania dát, t. j. cloudovo orientovaných úložísk, ktoré pracujú prevažne na základe REST API a oslobodzujú aplikáciu od zaťažovania údržbou lokálneho ukladania dát. V takom prípade aplikácia vlastne prechádza do režimu bez udržiavania stavu (keďže stav sa nachádza v vzdialenom úložisku). Moderné aplikácie sú vybudované od nuly už s ohľadom na tento faktor. Zvyčajne je akákoľvek moderná aplikácia, ktorá spracúva dáta rôzneho druhu (logy, metadáta, blob-y a pod.) postavená na cloudovo orientovanej paradigme, kde sa stav presúva do špeciálne určenej softvérovej systémy na jeho uloženie.
Prístup k softvérovým kontajnerom s udržiavaním stavu núti celú túto paradigmu vrátiť sa presne tam, odkiaľ začínala!
Pri používaní rozhraní POSIX na ukladanie údajov aplikácie fungujú rovnako, ako keby uchovávali stav, a z tohto dôvodu sa odchylujú od najdôležitejších postulátov cloudového dizajnu, t.j. od možnosti variabilne upravovať veľkosti pracovných tokov aplikácie v závislosti od prichádzajúcej záťaže, presunúť sa na nový uzol, hneď ako aktuálny uzol zlyhá, a podobne.
Keď sa na túto situáciu pozrieme bližšie, zisťujeme, že pri výbere úložiska údajov sa opäť a opäť stretávame s dilemou „POSIX vs. REST API“, ALE so spôsobeným zhoršením problémov POSIX, ktoré vyplýva zo distribuovanej povahy prostredí Kubernetes. Konkrétne,
- POSIX je rozvláčny.: Semantika POSIX si vyžaduje asociáciu s každou operáciou metadát a deskriptorov súborov, ktoré pomáhajú udržiavať stav operácie. To vedie k významným nákladom, ktoré nemajú žiadnu skutočnú hodnotu. API na ukladanie objektov, konkrétne S3 API, sa týchto požiadaviek zbavili, čo umožňuje aplikácii pracovať a potom „zabudnúť“ na toto volanie. Odpoveď systému ukladania údajov ukazuje, či bola táto akcia úspešne vykonaná alebo nie. V prípade zlyhania môže aplikácia vykonať opätovný pokus.
- Sieťové obmedzenia: V distribuovanom systéme sa predpokladá, že môže existovať množstvo aplikácií, ktoré sa snažia zapisovať údaje na rovnaké pripojené zariadenie. Preto nie je len to, že aplikácie budú súťažiť medzi sebou o šírku pásma (aby poslali údaje na zariadenie), samotný systém ukladania údajov bude súťažiť o túto šírku pásma, rozosielajúc údaje po fyzických diskoch. V dôsledku rozvláčnosti POSIX sa počet sieťových volaní násobne zvyšuje. Na druhej strane, S3 API zabezpečuje jasné rozdelenie sieťových volaní medzi tými, ktoré prichádzajú od klienta na server a tými, ktoré sa dejú v rámci servera.
- Bezpečnosť: Model zabezpečenia POSIX si vyžaduje aktívnu účasť človeka: administrátori konfigurujú konkrétne úrovne prístupu pre každého používateľa alebo skupinu. Táto paradigma sa ťažko prispôsobuje svetu orientovanému na cloud. Moderné aplikácie závisia od modelov zabezpečenia, ktoré sú viazané na API, kde sa práva na prístup určujú ako súbor politík, vyčleňujú sa servisné účty, dočasné prihlasovacie údaje atď.
- Spravovateľnosť: Kontajnery s pretrvávajúcim stavom prinášajú určité náklady spojené s manažmentom. Ide o synchronizáciu paralelného prístupu k dátam, zabezpečenie konzistencie dát; to všetko si vyžaduje starostlivé zváženie, aké vzorce prístupu k dátam použiť. Je potrebné inštalovať, kontrolovať a konfigurovať ďalšie programy, nehovoriac o dodatočných nákladoch na vývoj.
Kontajnerové rozhranie úložiska dát
Zatiaľ čo rozhranie kontajnerového úložiska dát (CSI) výrazne pomohlo s rozšírením úrovne zväzkov Kubernetes, čiastočne ho prenieslo na externých poskytovateľov úložiska, ale náhodne prispelo aj k presvedčeniu, že kontajnerový prístup s pretrvávajúcim stavom je odporúčanou metódou ukladania dát v Kubernetes.
CSI bol navrhnutý ako štandard poskytovania ľubovoľných systémov blokového a súborového úložiska pre dedičné aplikácie pri práci s Kubernetes. A ako bolo preukázané v tomto článku, jediná situácia, v ktorej je odôvodnené kontajnerové riešenie s pretrvávajúcim stavom (a CSI v jeho súčasnej forme) – je, keď je sama aplikácia dedičným systémom, v ktorom nie je možné pridať podporu API objektového úložiska dát.
Je dôležité pochopiť, že pri používaní CSI v jeho súčasnej forme, to znamená pripojením zväzkov pre moderné aplikácie, sa stretneme s približne rovnakými problémami, aké sa objavili v systémoch, kde je ukladanie údajov organizované podľa štýlu POSIX.
Kvalitnejší prístup
V tomto prípade je dôležité chápať, že väčšina aplikácií v podstate nie je optimalizovaná na prácu so stavom alebo bez neho. Toto správanie závisí od celkovej architektúry systému a od konkrétnych variantov zvolených pri návrhu. Povedzme si niečo o aplikáciách, ktoré uchovávajú stav.
V zásade je možné sa všetky dáta aplikácií rozdeľovať do niekoľkých širokých typov:
- Logové dáta
- Dáta časových pečiatok
- Transakčné dáta
- Metadáta
- Obrazy kontajnerov
- Blobové dáta (veľké binárne objekty)
Všetky tieto typy dát sú veľmi dobre podporované na moderných platformách ukladania dát a existuje niekoľko cloudovo orientovaných platforiem, ktoré sú prispôsobené na dodávanie dát v každom z týchto konkrétnych formátov. Napríklad transakčné dáta a metadáta môžu byť v modernej cloudovo orientovanej databáze, ako je CockroachDB, YugaByte atď. Obrazy kontajnerov alebo blobové dáta môžu byť uložené v docker registry založenom na MinIO. Dáta časových pečiatok môžu byť uložené v databáze časových radov, napríklad InfluxDB atď. Nebudeme sa tu zaoberať detailami každého typu dát a príslušných aplikácií, ale všeobecná myšlienka je vyhnúť sa trvalému uloženiu dát na báze lokálneho montovania diskov.
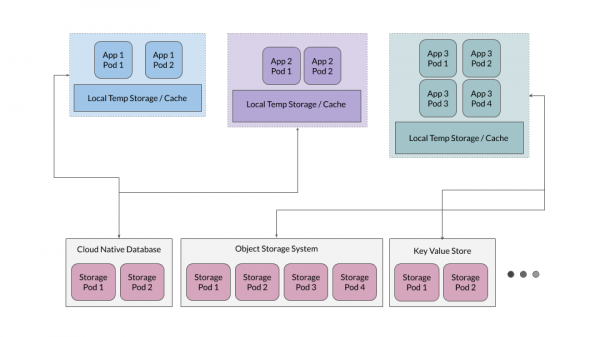
Okrem toho sa často ukazuje, že je efektívne poskytnúť úroveň dočasného cachovania, ktorá slúži aplikáciám ako akési úložisko dočasných súborov, avšak aplikácie by na túto úroveň nemali spolíhať ako na zdroj pravdy.
Úložisko pre aplikácie so stavom
Zatiaľ čo v väčšine prípadov je užitočné udržiavať aplikácie bez stavu, aplikácie určené na uchovávanie dát - ako sú databázy, objektové úložiská, úložiská kľúčov a hodnôt - by mali uchovávať stav. Poďme sa pozrieť na to, prečo sa tieto aplikácie nasadzujú na Kubernetes. Ako príklad vezmeme MinIO, avšak podobné princípy sú použiteľné aj na iné veľké cloudovo orientované systémy ukladania dát.
Aplikácie orientované na cloud sú navrhnuté tak, aby maximálne využívali flexibilitu, ktorá je vlastná kontajnerom. To znamená, že nerobia žiadne predpoklady o prostredí, v ktorom budú nasadené. Napríklad MinIO využíva interný mechanizmus rozšíreného kódovania (erasure coding), ktorý zabezpečuje dostatočnú odolnosť systému, aby zostal funkčný aj pri zlyhaní polovice diskov. MinIO tiež spravuje integritu a bezpečnosť dát použitím vlastného hashovania a šifrovania na serverovej strane.
Pre takéto aplikácie orientované na cloud sú lokálne perzistentné objemy (PV) najvhodnejším riešením pre záložné úložisko. Lokálne PV umožňuje ukladanie surových dát, pričom aplikácie bežiace na týchto PV samostatne zhromažďujú informácie, ktoré umožňujú škálovanie dát a správu rastúcich požiadaviek na dáta.
Tento prístup je omnoho jednoduchší a oveľa lepšie sa škáluje v porovnaní s PV na báze CSI, ktoré do systému zavádzajú vlastné úrovne správy dát a redundancie; problémom je, že tieto úrovne obvykle konfliktujú s aplikáciami navrhnutými na princípe uchovávania stavu.
Sebavedomý krok k oddeleniu dát od výpočtov
V tomto článku sme hovorili o tom, ako sa aplikácie preorientovávajú na prácu bez uchovávania stavu, inými slovami, uchovávanie dát je oddelené od výpočtov nad nimi. Na záver si pozrieme niekoľko reálnych príkladov tohto trendu.
, známa platforma na analýzu dát, sa tradične používala s uchovávaním stavu a nasadením v súborovom systéme HDFS. Avšak, s prechodom Spark do sveta orientovaného na cloud, sa táto platforma čoraz častejšie využíva bez uchovávania stavu pomocou `s3a`. Spark používa s3a na prenos stavu do iných systémov, pričom samotné kontajnery Spark fungujú úplne bez uchovávania stavu. Iní veľkí hráči v oblasti analýzy veľkých dát, konkrétne , , taktiež prechádzajú k práci s oddelením uchovávania dát a výpočtov nad nimi.
Podobné vzory sa dajú pozorovať aj na iných veľkých analytických platformách, medzi ktoré patrí Presto, TensorFlow do R, Jupyter. Exportovaním stavu do vzdialených cloudových úložných systémov sa oveľa jednoduchšie spravuje vaša aplikácia a jej škálovanie. Okrem toho to podporuje prenosnosť aplikácie do rôznych prostredí.
Zdroj: habr.com
