

Zdá sa, že vývojári Terraform ponúkajú dostatočne pohodlné osvedčené postupy na prácu s AWS infraštruktúrou. Lenže je tu malý háčik. S časom sa zvyšuje počet prostredí, v každom sa objavujú špecifiká. Takmer kópia aplikačného steku sa nachádza v susednom regióne. A Terraform kód je potrebné starostlivo skopírovať a upraviť podľa nových požiadaviek, alebo vytvoriť snehovú vločku.
Môj príspevok je o vzoroch v Terraformu na boj s chaosom a manuálnou rutinou v rozsiahlych a dlhých projektoch.
Video:
Mám 40 rokov, v IT pracujem 20 rokov. 12 rokov pracujem vo firme Ixtens. Zaoberáme sa rozvojom poháňaným ecommerce. A 5 rokov praktizujem DevOps praktiky.
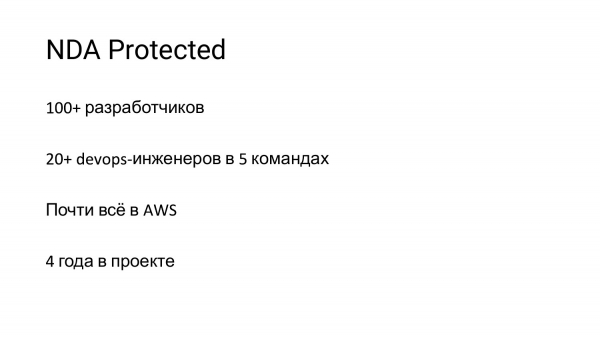
Môj príbeh bude o skúsenostiach z projektu vo firme, ktorej meno nebudem prezrádzať kvôli dohovoru o dôvernosti.
Čísla na slide slúžia na to, aby sme pochopili rozsah projektu. A všetko, o čom budem ďalej hovoriť, sa týka Amazonu.
K tomuto projektu som sa pridal pred 4 rokmi. A uprostred prebiehal refaktorovanie infraštruktúry, pretože projekt rástol. A vzory, ktoré sa používali, už nevyhovovali. A vzhľadom na plánovaný rast projektu bolo potrebné vymyslieť niečo nové.
Ďakujem Matvemu, ktorý včera hovoril, čo sa dialo v Dodo Pizze. To je to, čo sa u nás dialo pred 4 rokmi.
Prišli vývojári a začali robiť infraštruktúrny kód.
Najjasnejšie dôvody, prečo to bolo potrebné, boli urýchlenie uvádzania na trh. Bolo potrebné zabezpečiť, aby DevOps tím nebol úzkym miestom pri nasadení. A okrem všetkého na najzákladnejšej úrovni boli použité Terraform a Puppet.
Terraform je open source projekt spoločnosti HashiCorp. A pre tých, ktorí úplne nevedia, čo to je, nasledujúce niekoľko slideov.
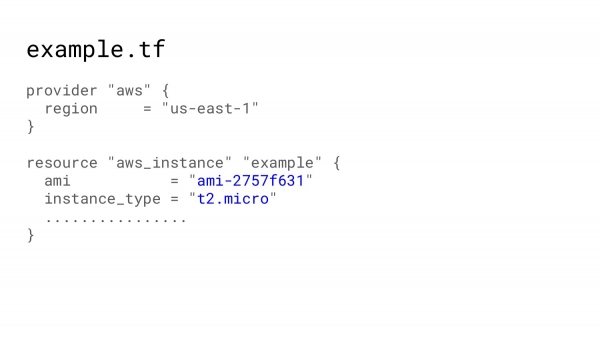
Infrastruktúra ako kód znamená, že môžeme opísať našu infraštruktúru a požiadať nejakých robotov, aby nám zabezpečili zdroje, ktoré sme opísali.
Napríklad potrebujeme virtuálna mašina. Opíšeme, pridáme niekoľko povinných parametrov.
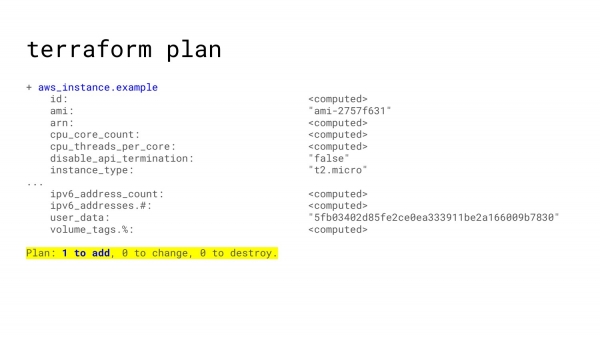
Potom v konzole nastavíme prístup k Amazonu. A požiadame Terraform plan. Terraform plan povie: „Ok, pre váš zdroj môžeme urobiť takéto veci“. A aspoň jeden zdroj bude pridaný. A žiadne zmeny sa neplánujú.
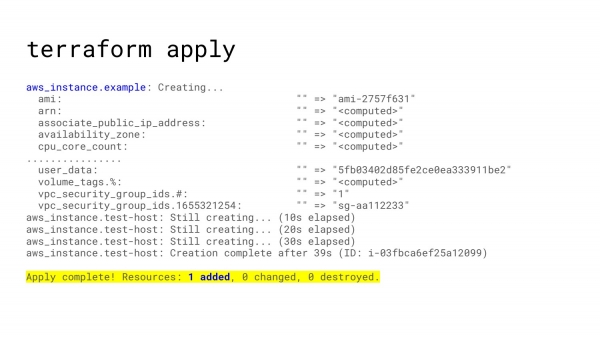
Po tom, čo vás všetko uspokojí, môžete požiadať Terraform apply a Terraform vám vytvorí instance, a dostanete virtuálny stroj vo vašej облаčne.
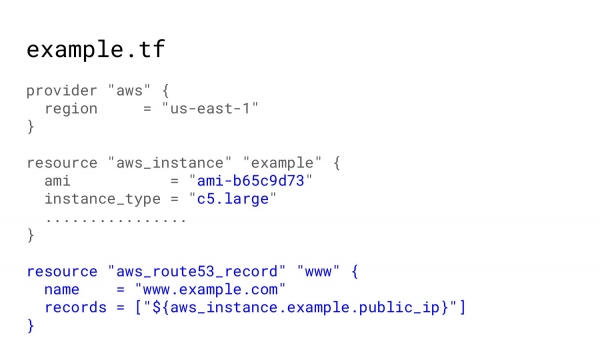
Ďalej náš projekt pokračuje. Pridávame tam nejaké zmeny. Žiadame o viac instances, pridávame 53 záznam.
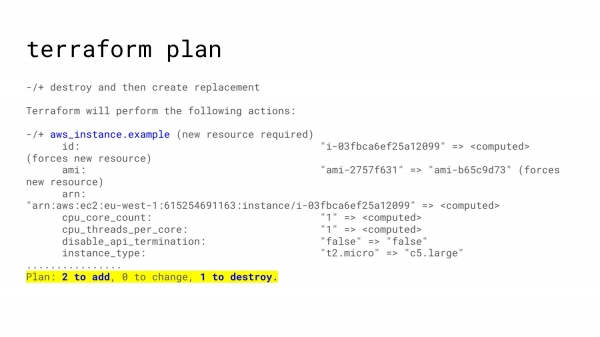
A opakujeme. Žiadame plán. Vidíme, aké zmeny sú plánované. Aplikujeme. Takto naša infraštruktúra rastie.
Terraform využíva niečo, čo sa nazýva state súbory. T. j. všetky zmeny, ktoré idú na Amazon, ukladá do súboru, v ktorom každému zdroju, ktorý ste opísali, zodpovedajú zdroje, ktoré boli vytvorené v Amazon. Takže pri zmene popisu nejakého zdroja, Terraform presne vie, čo treba zmeniť na Amazone.
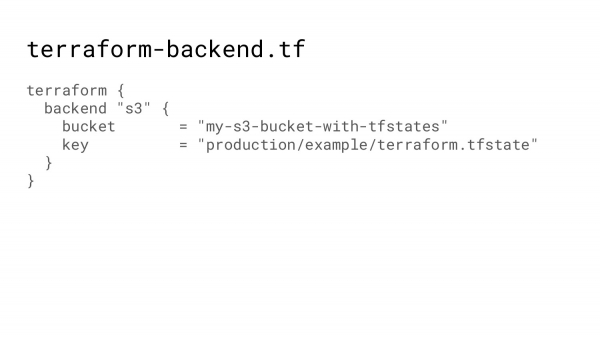
Tieto state súbory boli pôvodne len súbormi. A uchovávali sme ich v Gite, čo bolo veľmi nepraktické. Neustále niekto zabudol poslať zmeny, a vznikalo veľa konfliktov.
Teraz je možné používať backend, t. j. Terraformu sa určuje, v akom bucket-e a pod akým kľúčom sa má uložiť state súbor. A Terraform sa postará o to, aby tento state súbor získal, vykonal všetku magiu a vrátil späť konečný výsledok.
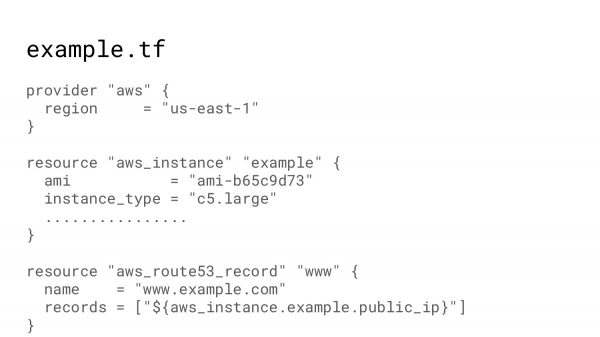
Naša infraštruktúra rastie. Tu je náš kód. A teraz nechceme len vytvoriť virtuálny stroj, chceme mať testovacie prostredie.
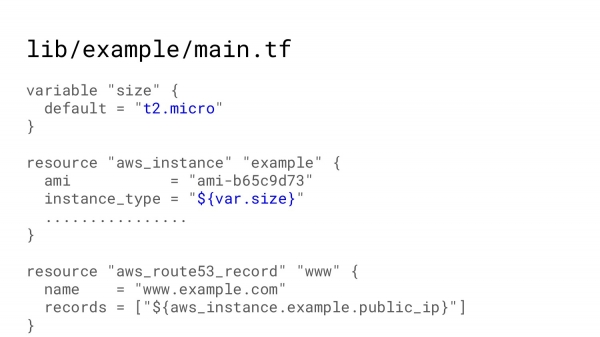
Terraform umožňuje vytvoriť niečo ako modul, t. j. to isté opísať v nejakej zložke.
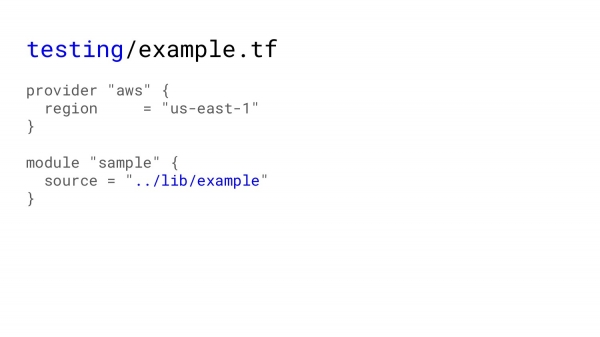
A napríklad v testovaní zavolať tento modul a získať to isté, ako keby sme vykonávali Terraform apply v samotnom module. Pre testovanie bude takýto kód.
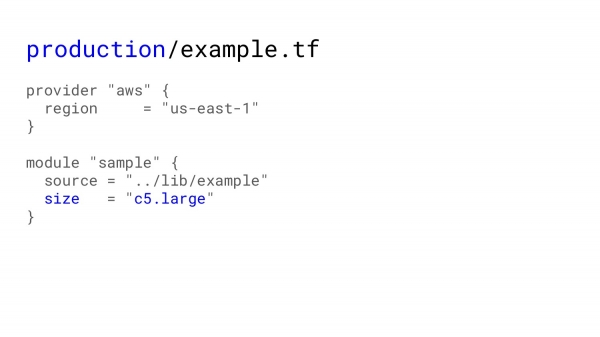
Pre produkciu môžeme poslať nejaké zmeny, pretože v testovaní nepotrebujeme veľké instances, v produkcii sa veľké instances práve hodia.
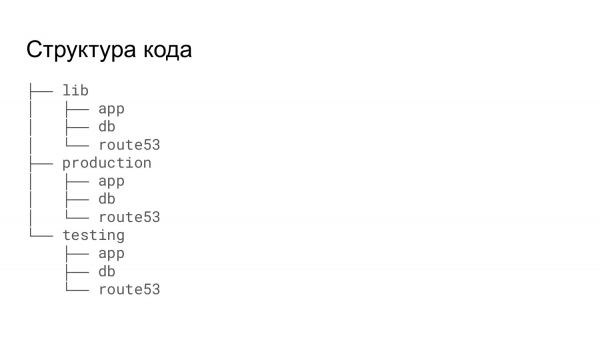
A potom sa vrátim späť k projektu. Bola to zložitá úloha, infraštruktúra bola plánovaná veľmi rozsiahla. A bolo treba nejak rozmiestniť celý kód, aby to bolo pohodlné pre všetkých: pre tých, ktorí sa starajú o tento kód, a pre tých, ktorí robia zmeny. Plánovalo sa, že akýkoľvek vývojár môže ísť a opraviť infraštruktúru tak, ako to potrebujú pre svoju časť platformy.
Toto je stromový diagram adresárov, ktorý odporúča samotný HashiCorp, ak máte veľký projekt a má zmysel rozdeliť celú infraštruktúru na malé kúsky a každý kúsok opisovať v samostatnej zložke.
S rozsiahlym knižnicou zdrojov môžeme v testovaní a v produkcii volať približne to isté.
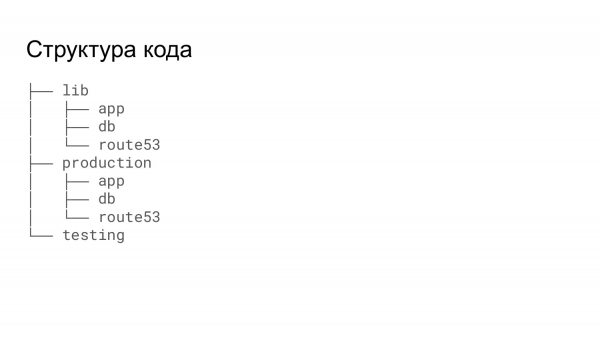
V našom prípade to nebolo celkom vhodné, pretože testovací stack pre vývojárov alebo na testovanie bolo potrebné získať nejako jednoduchšie. Nechcelo sa nám prechádzať medzi priečinkami a aplikovať ich v správnom poradí a obávať sa, že sa spustí databáza a potom instance, ktorá túto databázu používa. Preto sa celý testing spúšťal z jedného priečinka. Tam sa volali tie isté moduly, ale prebiehalo to všetko na jedenkrát.
Terraform sa stará o všetky závislosti. A vždy vytvára zdroje v tom poradí, aby bolo možné získať IP adresu, napríklad od novovytvoreného instance a získať túto IP adresu v route53 zázname.
Okrem toho je platforma veľmi veľká. A spustenie testovacieho stacku, aj keď na hodinu, aj keď na 8 hodín – to je dosť nákladné.
A my sme to automatizovali. Jenkins job umožňoval spustiť stack. V ňom bolo potrebné spustiť pull request so zmenami, ktoré chcel vývojár testovať, uviesť všetky potrebuje možnosti, komponenty a aj veľkosti. Ak chcel performance testovanie, mohol si zobrať viac instance. Ak potreboval len overiť, že nejaký formulár sa otvára, mohol spustiť na minimálnych hodnotách. A tiež uviesť, či potrebuje cluster alebo nie, atď.
A potom Jenkins spustil shell skript, ktorý trošku modifikoval kód v priečinku Terraform. Odstraňoval nepotrebné súbory, pridával potrebné súbory. A potom jedným spustením sa prostredníctvom Terraform apply stack spustil.
A ďalej už nasledovali ďalšie kroky, do ktorých sa nechcem hĺbiť.
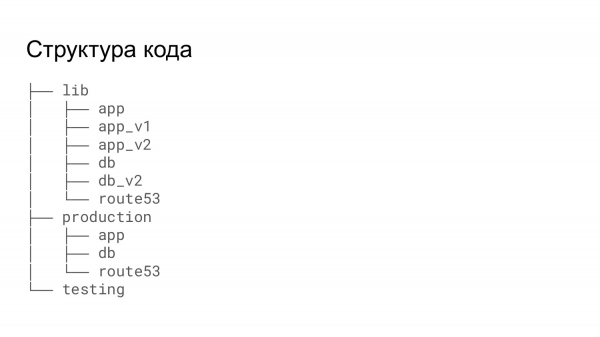
Kvôli tomu, že na testovanie sme potrebovali trošku viac možností, než v produkcii, museli sme vytvárať kópie modulov, aby sme do týchto kópií mohli pridať tie funkcie, ktoré sú potrebné iba v testovaní.
A tak sa stalo, že v testovaní sa akoby chcelo testovať tie zmeny, ktoré potom pôjdu do produkcie. Ale v skutočnosti sa testovalo jedno, a v produkcii sa uplatňovalo trošku iné. A bol tam malý rozpor, pretože všetky zmeny v produkcii uplatňoval operačný tím. A niekedy sa stalo, že zmeny, ktoré mali prejsť z testovania do produkcie, ostávali v inej verzii.
Okrem toho sa objavil problém, že sa pridávala nová služba, ktorá sa trochu odlišovala od už existujúcej. Namiesto toho, aby sme modifikovali existujúci modul, bolo potrebné urobiť jeho kópiu a pridať potrebné zmeny.
V podstate Terraform nie je skutočný jazyk. Je to deklarácia. Ak potrebujeme niečo deklarovať, tak to deklarujeme. A všetko to funguje.
V istom okamihu, keď sa diskutovalo o jednom z mojich pull requestov, jeden z kolegov povedal, že netreba množiť snehové vločky. Zaujímalo ma, čo tým myslí. Existuje taký vedecký fakt, že na svete niet dvoch rovnakých snehových vločiek, všetky sú trochu odlišné. A hneď keď som to počul, pocítil som celú váhu Terraform kódu. Pretože keď bolo potrebné prejsť z verzie na verziu, Terraform vyžadoval breaking change, t.j. kód už nebol kompatibilný s nasledujúcou verziou. A bolo potrebné vykonať pull request, ktorý pokrýval takmer polovicu súborov v infraštruktúre, aby sa infraštruktúra dostala na ďalšiu verziu Terraform.
A po tom, ako sa objavila taká snehová vločka, celý Terraform kód, ktorý sme mali, sa zmenil na obrovskú kopu snehu.
Pre externého vývojára, ktorý nie je v operáciách, to nemá veľký význam, pretože urobil pull request, jeho zdroj sa spustil. A tým to končí, ďalej sa o to nemusí starať. Ale tímu DevOps, ktorý dbá na to, aby všetko fungovalo správne, je potrebné vykonať všetky tieto zmeny. A cena týchto zmien veľmi, veľmi narastala s každou pridanou snehovou vločkou.
Existuje príbeh o tom, ako študent na seminári nakreslí kriedou na tabuli dva dokonalé kruhy. A učiteľ sa diví, ako sa mu podarilo tak presne nakresliť bez kružidla. Študent odpovedá: "Veľmi jednoducho, dva roky v armáde som krútil mlynček na mäso."
A z tých štyroch rokov, počas ktorých sa zúčastňujem na tomto projekte, som asi dva roky venoval Terraformu. A samozrejme, mám určité tipy a rady, ako zjednodušiť Terraform kód, pracovať s ním ako s programovacím jazykom a znížiť zaťaženie vývojárov, ktorí musia udržiavať tento kód aktuálny.
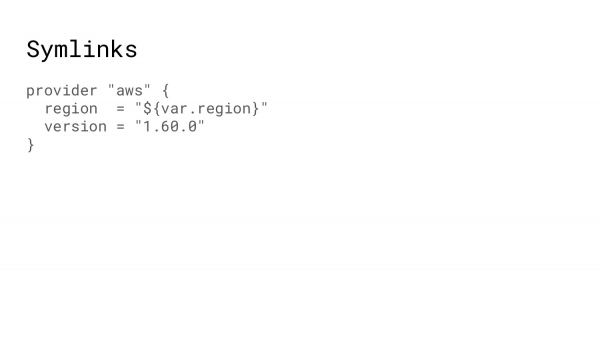
Prvá vec, o ktorej by som chcel hovoriť, sú symlink. Terraform má veľa opakujúceho sa kódu. Napríklad, volanie poskytovateľa sa vyskytuje prakticky v každom bode, kde vytvárame kúsok infraštruktúry, a je rovnaké. A je logické presunúť ho do samostatnej zložky. A všade, kde je poskytovateľ potrebný, urobte symlink na tento súbor.
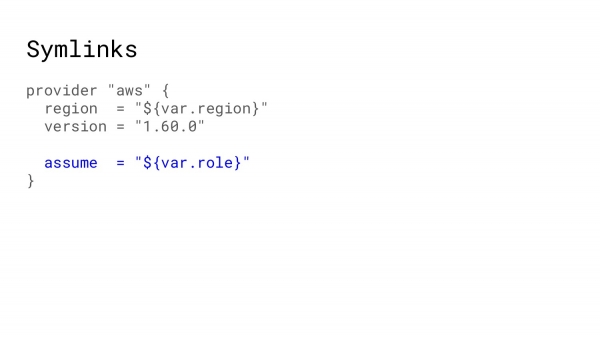
Napríklad, vo vašej produkcii sa používa predpokladaná rola, ktorá vám umožňuje získať prístupové práva na nejaký externý Amazon účet. A zmenou jedného súboru budú všetky ostatné v strome zdrojov mať požadované práva, aby Terraform vedel, na ktorý segment Amazonu sa odvoláva.
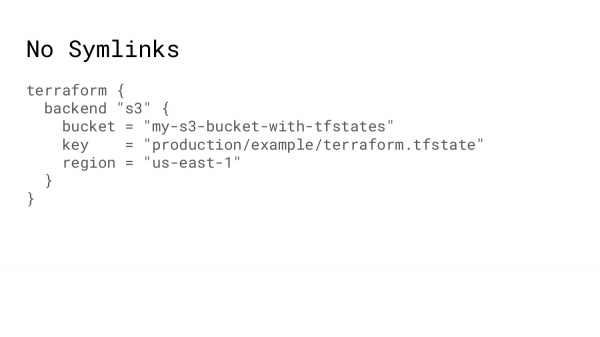
Kde symlinky nefungujú? Ako som už povedal, v Terraforme sú state súbory. A sú naozaj veľmi, veľmi dobré. Ale problém je, že Terraform inicializuje backend na úplne prvom mieste. A nemôže použiť v týchto parametroch žiadne premenné, vždy ich musíte písať textovo.
A ako výsledok, keď niekto vytvára nový zdroj, kopíruje časť kódu z iných zložiek. A môže sa pomýliť s kľúčom alebo s bucketom. Napríklad, vytvorí niečo zo sandboxu a potom to urobí v produkcii. A môže sa stať, že bucket v produkcii bude používaný zo sandboxu. Samozrejme, to sa rýchlo zistí. Bude to možné nejako opraviť, ale aj tak je to strata času a do určitej miery aj zdrojov.
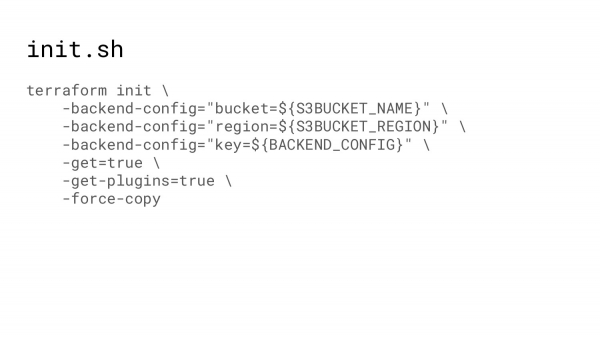
Čo môžeme urobiť ďalej? Predtým, ako začneme pracovať s Terraformom, musíme ho inicializovať. Počas inicializácie Terraform sťahuje všetky pluginy. V istom okamihu sa zmonolitizovali na mikroservisnú architektúru. A vždy sa musí vykonať Terraform init, aby sťahoval všetky moduly, všetky pluginy.
A môžete použiť shell skript, ktorý však môže získať všetky premenné. Shell skript nie je nijak obmedzený. A po druhé, cesty. Ak stále používame tú cestu, ktorá je v repozitári ako kľúč k state súboru, ergo, chyba tu bude vylúčená.
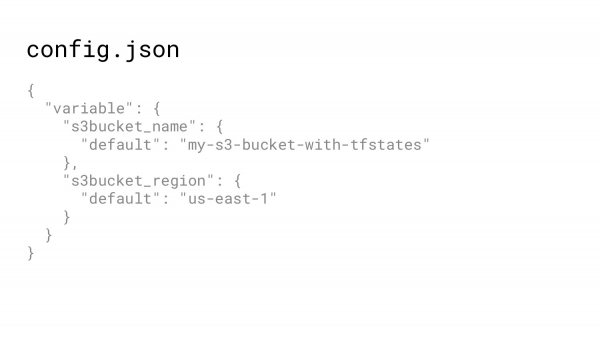
Odkiaľ získať dáta? JSON súbor. Terraform umožňuje zapisovať infraštruktúru nielen v hcl (HashiCorp Configuration Language), ale aj v JSON.
JSON sa ľahko číta z shell skriptu. Preto je možné umiestniť konfiguračný súbor s bucketom na nejaké miesto. A použiť tento bucket ako v Terraform kóde, tak aj v shell skripte pre inicializáciu.
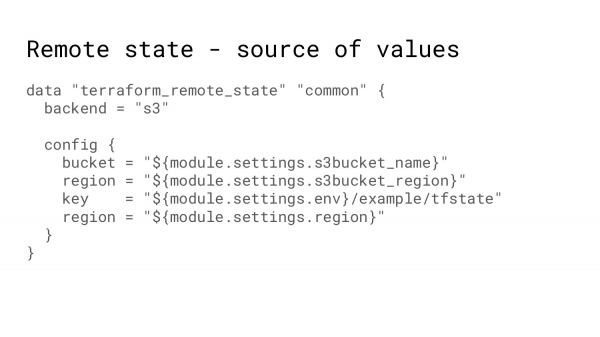
Prečo je dôležité mať bucket pre Terraform? Pretože existuje niečo ako remote state súbory. T. j. keď vytváram nejaký zdroj, potrebujem povedať Amazonu: „Prosím, vytvor instance“, a musím uviesť veľmi veľa povinných parametrov.
A tieto identifikátory sú uložené v nejakej inej zložke. A môžem si povedať: „Terraform, choď prosím do state súboru toho zdroja a získaj mi tieto identifikátory“. Takýmto spôsobom vzniká určitá unifikácia medzi rôznymi regiónmi alebo prostrediami.
Nie vždy je možné použiť vzdialený state súbor. Napríklad, ak ste ručne vytvorili VPC. A ten Terraform kód, ktorý vytvára VPC, vytvára tak odlišný VPC, že ho bude trvať veľmi dlho prispôsobovať jeden druhému, takže môžeme použiť nasledujúci trik.
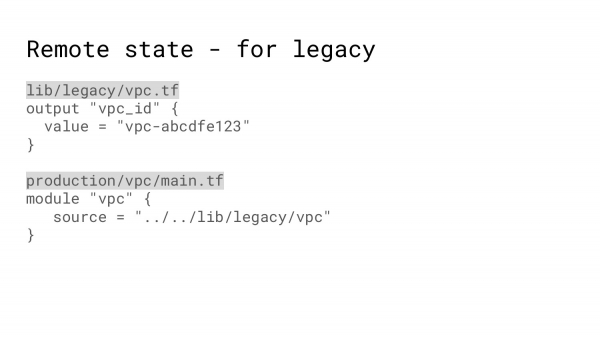
T. j. vytvoriť modul, ktorý akoby vytvára VPC a akoby vám vydáva identifikátory, ale v skutočnosti ide len o súbor so zakódovanými hodnotami, ktorý možno využiť na vytvorenie toho istého instance.
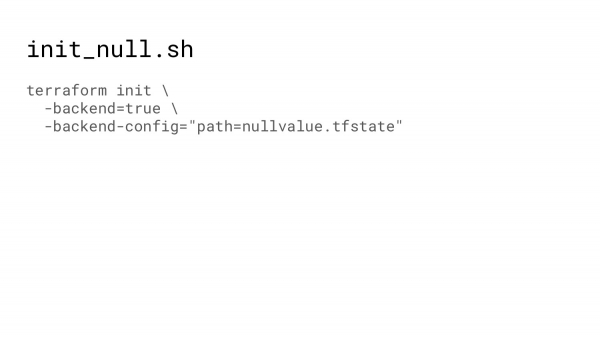
Nie vždy je potrebné uchovávať state súbor v cloude. Napríklad, keď testujete moduly, môžete použiť inicializáciu backendu, pri ktorej bude súbor uložený jednoducho na disku počas testovania.
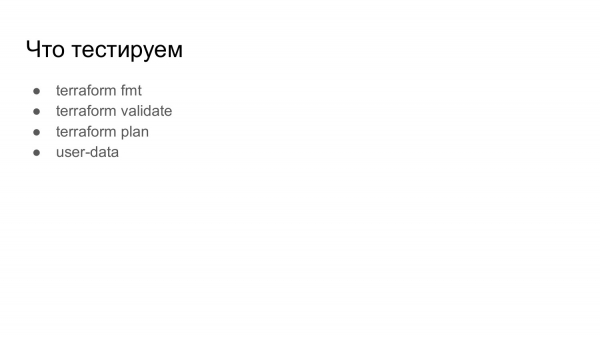
Teraz trochu o testovaní. Čo je možné testovať v Terraform? Určite toho je veľa, ale budem hovoriť o týchto 4 veciach.
HashiCorp má predstavu o tom, ako by mal byť kód Terraformu naformátovaný. A Terraform fmt vám umožňuje naformátovať kód, ktorý upravujete, v súlade s touto víziou. Preto testy musia nevyhnutne skontrolovať, či formátovanie zodpovedá tomu, čo zanechal HashiCorp, aby ste nemuseli meniť umiestnenie zátvoriek atď.
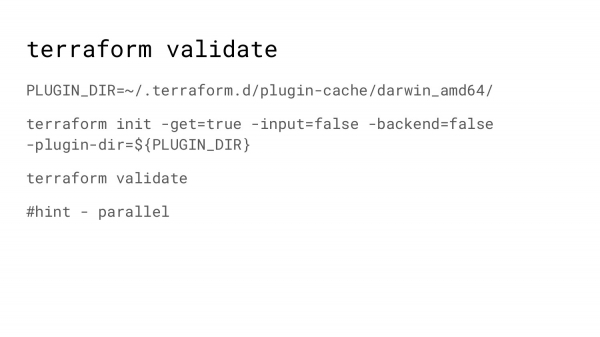
Ďalšie je Terraform validate. Robí niečo viac ako len kontrolu syntaxe – t. j. či sú všetky zátvorky párové. Čo je dôležité? Naša infraštruktúra je veľmi rozsiahla. Obsahuje veľmi veľa rôznych zložiek. A v každej je potrebné spustiť Terraform validate.
Preto, aby sme urýchlili testovanie, spúšťame niekoľko procesov paralelne, využívajúc paralelitu.
Paralelita je veľmi skvelá vec, využívajte ju.
Ale každýkrát, keď sa inicializuje Terraform, ide na HashiCorp a pýta sa: „Aké sú najnovšie verzie pluginov? A ten plugin, ktorý mám v cache – je to ten správny alebo nie?“. A to na každom kroku spôsobovalo spomalenie.
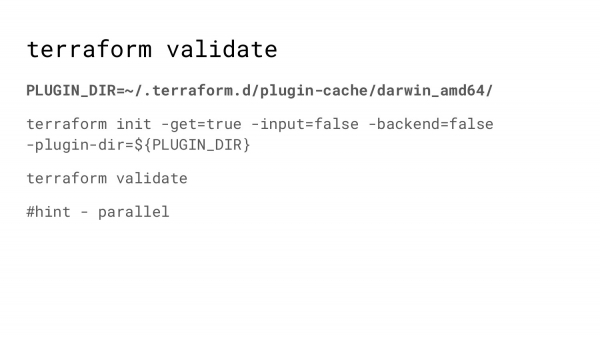
Ak Terraform povieme, kde sú pluginy, tak Terraform povie: „Ok, asi je to najnovšie, čo máme. Nepôjdem nikam, hneď začnem overovať váš Terraform kód.“
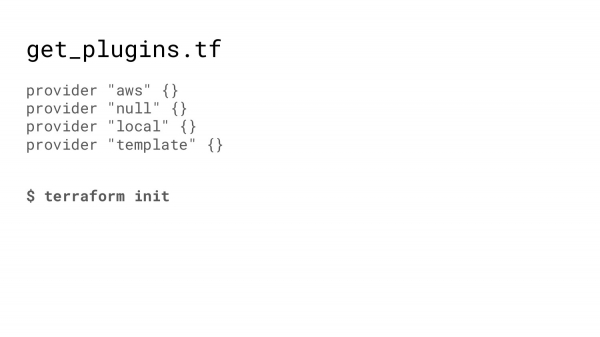
Aby sme naplnili priečinok potrebnými pluginmi, máme veľmi jednoduchý Terraform kód, ktorý stačí len inicializovať. Tu je samozrejme potrebné uviesť všetkých poskytovateľov, ktorí sa akýmkoľvek spôsobom podieľajú na vašom kóde, inak Terraform povie: „Neznám nejakého poskytovateľa, pretože ho nemám v cache.“
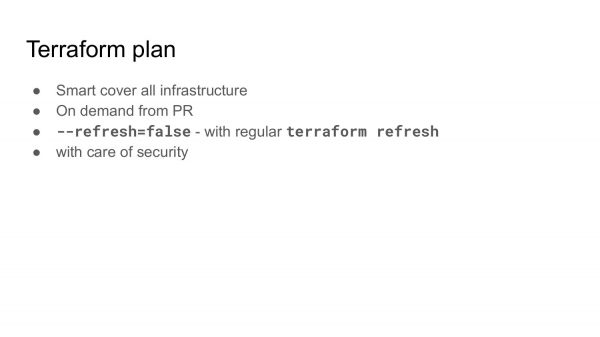
Ďalším krokom je Terraform plan. Ako som povedal, vývoj je cyklický. Robíme kód so zmenami. A potom je potrebné zistiť, aké zmeny sa plánujú na infraštruktúre.
A keď je infraštruktúra veľmi, veľmi veľká, môžete zmeniť jeden modul, opravit nejaké testovacie prostredie alebo nejaký konkrétny región a rozbiť nejaký susedný. Preto by sa Terraform plan mal vykonávať na celej infraštruktúre a ukazovať, aké zmeny sa plánujú.
Môžete to robiť rozumne. Napríklad sme napísali skript v Pythone, ktorý rozrieši závislosti. A v závislosti od toho, čo sa zmenilo: Terraform modul alebo len nejaká konkrétna súčiastka, vytvára plány pre všetky závislé priečinky.
Terraform plan by sa mal robiť na požiadanie. Aspoň to robíme my.
Testy sú, samozrejme, dobré robiť na každú zmenu, na každý commit, ale plány – to je dosť nákladná záležitosť. A my v pull request hovoríme: „Prosím, daj mi plány“. Spustí sa robot. A posiela do komentárov alebo príloh všetky plány, ktoré sú predpokladané z vašich zmien.
Plán je dosť nákladný. Zaberá to čas, pretože Terraform ide na Amazon a pýta sa: „Existuje ešte tento inštanc? A má tento autoscale skutočne také parametre?“. A aby sa to urýchlilo, môžete použiť taký parameter, ako refresh=false. To znamená, že Terraform stiahne zo S3 state. A bude veriť, že state presne zodpovedá tomu, čo sa nachádza v Amazone.
Taký Terraform plán sa vykonáva oveľa rýchlejšie, ale stav musí zodpovedať vašej infraštruktúre, t. j. niekde, niekedy by sa mal spustiť Terraform refresh. Terraform refresh robí presne to, aby stav zodpovedal tomu, čo sa nachádza v reálnej infraštruktúre.
A treba povedať o bezpečnosti. S týmto sa malo začínať. Tam, kde spúšťate Terraform a Terraform pracuje s vašou infraštruktúrou, existuje zraniteľnosť. T. j. v podstate vykonávate kód. A ak pull request obsahuje nejaký škodlivý kód, môže sa vykonať v infraštruktúre, ktorá má príliš veľký prístup. Preto buďte opatrní, kde spúšťate Terraform plán.
Ďalšia téma, o ktorej by som chcel hovoriť, je testovanie user-data.
Čo je to user-data? V Amazon, keď vytvárame inštanciu, môžeme z inštancie poslať akýsi e-mail – meta-dáta. Keď sa inštancia spúšťa, obvykle je cloud init vždy prítomný na týchto inštanciách. Cloud init prečíta tento e-mail a povie: „O. K., dnes som load balancer“. A v súlade s týmito príkazmi vykonáva nejaké akcie.
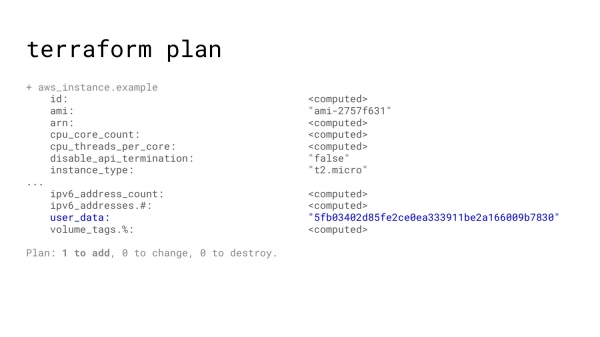
Ale, bohužiaľ, keď robíme Terraform plán a Terraform aplikáciu, user-data vyzerá ako akási kaša z čísel. T. j. jednoducho vám posiela hash. A všetko, čo môžete vidieť v pláne, sú zmeny alebo hash zostane rovnaký.
A ak na to nevenujete pozornosť, môže na Amazon, na reálnu infraštruktúru, odísť nejaký poškodený textový súbor.
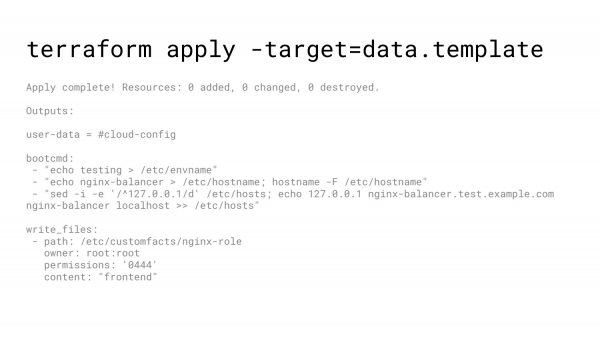
Ako alternatíva, môžete pri vykonávaní uviesť nie celú infraštruktúru, ale len šablónu. A v kóde povedať: „Prosím, zobraz mi túto šablónu“. A nakoniec môžete získať vytlačenie, ako budú vyzerať vaše dáta na Amazone.
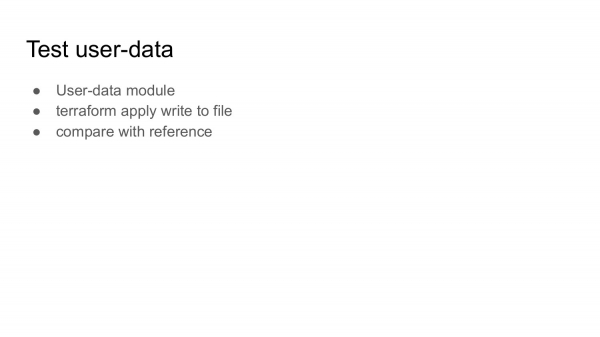
Ďalšia možnosť je použiť modul na generovanie user-data. Aplikujete tento modul. Získate súbor na disku. Porovnáte ho s referenčným. A tak, ak nejaký junior sa rozhodne upraviť trošku user-data, vaše testy povedia: „O. K., tu a tu sú nejaké zmeny – to je v poriadku“.
Ďalšia téma, o ktorej by som chcel hovoriť, je Automate Terraform apply.
Samozrejme, je dosť strašidelné vykonávať Terraform apply automaticky, pretože, kto vie, aké tam prišli zmeny a aké môžu byť ničivé pre živú infraštruktúru.
Pre testovacie prostredie je to všetko v poriadku. T. j. job, ktorý vytvára testovacie prostredie, je to, čo potrebujú všetci vývojári. A také vyjadrenie ako „mne všetko fungovalo“ — to nie je smiešny meme, ale dôkaz toho, že sa človek zamyslel, postavil stack, spustil na tento stack nejaké testy. A uistil sa, že je všetko v poriadku a povedal: „OK, ten kód, ktorý vydávam, bol otestovaný.“
Vo produkcii, sandboxe a iných prostrediach, ktoré sú dôležitejšie pre biznis, je možné časť niektorých zdrojov aplikovať pomerne bezpečne, pretože to nevedie k tomu, že niekto zomrie. To sú: autoscale skupiny, security skupiny, role, route53 a zoznam môže byť dosť veľký. Ale sledujte, čo sa deje, čítajte správy o automatických aplikáciách.
Tam, kde je aplikácia nebezpečná alebo sa obávate, napríklad ak ide o nejaké zdroje s persistentným prístupom, s databázami, získajte správy o tom, že v nejakom kúsku infraštruktúry sú neaplikované zmeny. A inžinier už pod dozorom spúšťa jobs, aby ich aplikoval, alebo to robí z vlastnej konzoly.
V Amazone existuje niečo ako Terminate protection. A môže ochrániť v niektorých prípadoch pred nepotrebnými zmenami. T. j. Terraform išiel na Amazon a hovorí: „Potrebujem zabiť tento instance, aby som urobil iný“. A Amazon hovorí: „Prepáčte, dnes nie. Máme nastavené Terminate protection.“
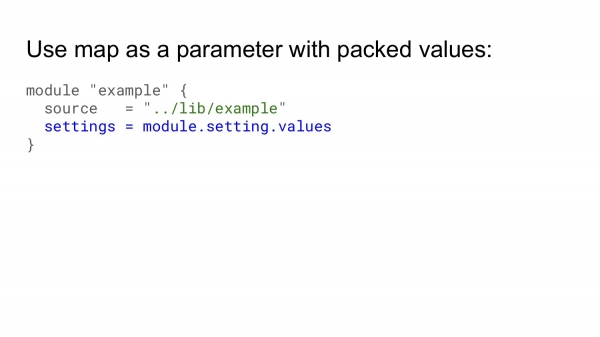
A čerešnička na torte – to je optimalizácia kódu. Keď pracujeme s Terraform kódom, musíme do modulu poslať veľmi veľké množstvo parametrov. To sú tie parametre, ktoré sú potrebné na vytvorenie nejakého zdroja. A kód sa mení na veľké zoznamy parametrov, ktoré je potrebné preniesť z modulu do modulu, z modulu do modulu, najmä ak sú moduly vnorené.
A to je veľmi ťažko čitateľné. Na tom je veľmi ťažké robiť review. A veľmi často sa stáva, že niektoré parametre prechádzajú review a nie sú úplne tie, ktoré sú potrebné. A to stojí čas a peniaze, aby sa to neskôr opravilo.
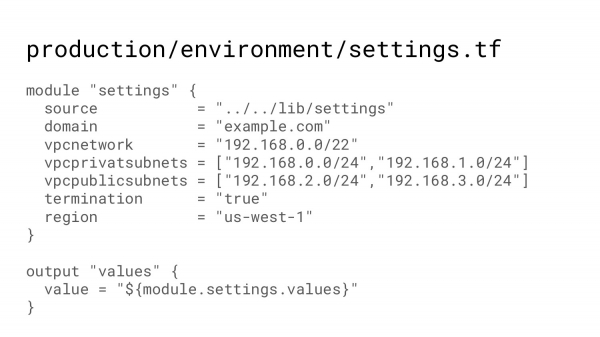
Preto vám odporúčam použiť takú vec ako zložený parameter, ktorý obsahuje istú štruktúru hodnôt. T. j. potrebujete nejakú zložku, kde sú uvedené všetky hodnoty, ktoré by ste chceli mať v nejakom prostredí.
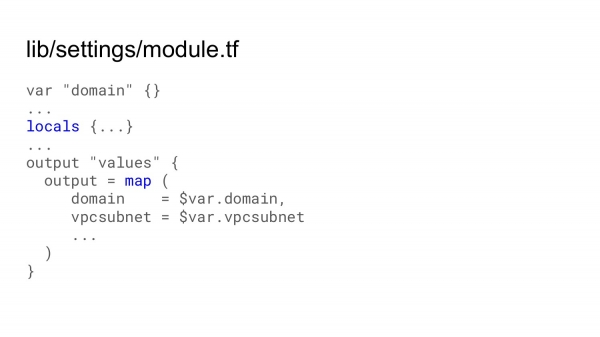
A vyvolaním tohto modulu je možné získať strom, ktorý sa generuje v jednom spoločnom module, t. j. v spoločnom module, ktorý funguje rovnako pre celú infraštruktúru.
V tomto module je možné vykonať určité výpočty, pomocou takej novej funkcie v Terraform, ako sú locals. A potom jedným outputom výdať nejaký zložitý parameter, ktorý môže obsahovať hashe, polia atď.
Týmto by som chcel skončiť so všetkými najlepšími nálezmi, ktoré mám. A chcel by som rozprávať príbeh o Kolumbovi. Keď hľadal peniaze na svoju expedíciu, aby objavil Indiu (ako si vtedy myslel), nikto mu neveril a považovali to za nemožné. Vtedy povedal: „Urobte tak, aby vajce nespadlo.“ Všetci bankári, veľmi bohatí a pravdepodobne múdri ľudia, sa snažili nejakým spôsobom postaviť vajce, a neustále padalo. Potom Kolumbus vzal vajce, trochu naň pritlačil. Škrupina sa deformovala a vajce zostalo nehybné. Povedali: „Oh, to je príliš jednoduché!“. A Kolumbus odpovedal: „Áno, to je príliš jednoduché. A keď objavím Indiu, všetci budú používať túto obchodnú cestu.“
A to, čo som vám teraz povedal, sú pravdepodobne celkom jednoduché a triviálne veci. A keď sa o nich dozviete a začnete ich používať, je to v poriadku. Takže využívajte ich. A ak sú pre vás to úplne normálne veci, tak aspoň viete, ako postaviť vajce, aby nespadlo.
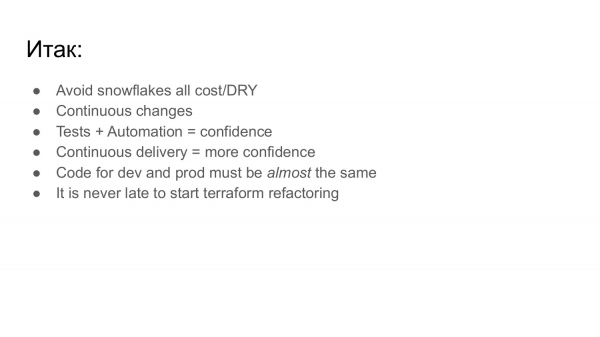
Zhrňme to:
- Snažte sa vyhýbať snehovým vločkám. A tým menej snehových vločiek, tým menej zdrojov budete potrebovať na vykonávanie nejakých zmien v celej vašej veľkej infraštruktúre.
- Trvalé zmeny. T. j. keď v kóde nastali nejaké zmeny, je potrebné čo najskôr prispôsobiť vašu infraštruktúru týmto zmenám. Nemala by existovať situácia, keď niekto po dvoch-troch mesiacoch príde, aby sa pozrel na Elasticsearch, urobí Terraform plan a tam je množstvo zmien, s ktorými nepočítal. A trávi sa veľmi veľa času na to, aby sa všetko vrátilo do poriadku.
- Testy a automatizácia. Čím viac váš kód pokrývajú testy a funkcie, tým väčšiu máte istotu, že všetko robíte správne. A automatická dodávka váš pocit dôvery značně zvýši.
- Kód pre testovacie a produkčné prostredie by mal byť takmer identický. Takmer, pretože produkcia je predsa len trochu iná a určite tam budú nejaké nuansy, ktoré presahujú testovacie prostredie. Napriek tomu, plus mínus, to možno zabezpečiť.
- A ak máte veľmi veľa Terraform kódu a údržba tohto kódu si vyžaduje veľmi veľa času, nikdy nie je neskoro spraviť refaktoring a uviesť ho do dobrej formy.
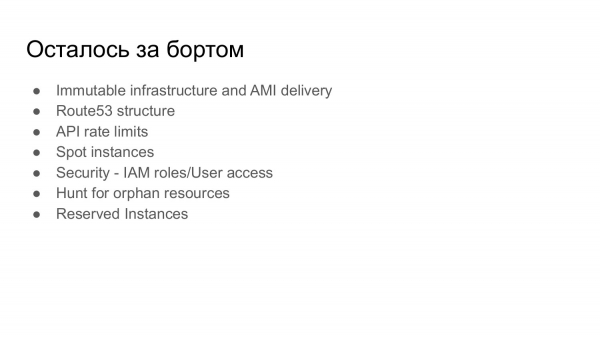
- Immutable infrastructure. Dodávka AMI podľa rozvrhu.
- Štruktúra pre Route53, keď máte veľa záznamov a chcete, aby boli v súlade v poradí.
- Boj s API rate limits. To je, keď Amazon hovorí: „Všetko, už viac nemôžem prijímať požiadavky, prosím, počkajte.“ A polovica firmy čaká, kým bude môcť spustiť svoju infraštruktúru.
- Spot instances. Amazon – nie je to lacná záležitosť a spoty umožňujú dosť ušetriť. A tam sa dá porozprávať celý referát o tom.
- Bezpečnosť a IAM role.
- Hľadanie stratených zdrojov, keď máte v Amazone instances nejasného pôvodu, ktoré vám zhltajú peniaze. Aj keď jedna instance stojí 100-150 dolárov mesačne – za rok je to viac ako 1 000. Hľadanie takýchto zdrojov je zisková činnosť.
- A rezervované instances.
Na tomto mám všetko. Terraform – to je veľmi skvelé, používajte to. Ďakujem!
Otázky
Ďakujem za referát! Váš state súbor leží v S3, ale ako riešite problém, že niekoľko ľudí ho môže zobrať a pokúsiť sa rozbehnúť?
Po prvé, neponáhľame sa. Po druhé, máme flagy, kde oznamujeme, že pracujeme na nejakom úseku kódu. T.j. napriek tomu, že infraštruktúra je veľmi veľká, to neznamená, že stále niekto niečo aplikuje. A keď bola aktívna fáza – to bol problém, mali sme state súbory v Gite. To bolo dôležité, inak niekto spraví state súbor a my sme museli ručne zbierať tie hromady, aby všetko pokračovalo ďalej. Teraz taký problém nie je. A vôbec, Terraform túto úlohu vyriešil. A ak sa niečo neustále mení, môžu sa použiť zámky, ktoré zabraňujú tomu, čo ste povedali.
Používate otvorenú verziu alebo enterprise?
Žiadne enterprise, t.j. všetko, čo sa dá získať a stiahnuť zadarmo.
Volám sa Stanislav. Chcel som doplniť jednu malú poznámku. Hovorili ste o funkcii Amazon, ktorá umožňuje spraviť inštanciu nezničiteľnou. To je možné aj v samotnom Terrafome, v bloku Life Second môžete určiť zákaz úpravy alebo zákaz zničenia.
Bol som časovo obmedzený. Dobrý postreh.
Ešte som sa chcel spýtať na dve veci. Po prvé, hovorili ste o testovaní. Používali ste nejaké nástroje na testovanie? Počul som o plugine Test Kitchen. Možno existuje niečo ďalšie. A chcel by som sa ešte spýtať na Local Values. Aký je vlastne ich rozdiel od Input Variables? A prečo nemôžem parametrizeovať niečo len cez Local Values? Snažil som sa túto tému pochopiť, ale nejako som sa s tým nezorientoval.
Môžeme podrobnejšie hovoriť za týmto sálom. Nástroje na testovanie – to u nás je úplný domáci výrobok. Tam nie je nič také, čo by sa dalo otestovať. Existujú však možnosti, kedy automatické testy spúšťajú infraštruktúru niekde, kontrolujú, či je všetko v poriadku, a potom všetko zničia s prehľadom, že vaša infraštruktúra je stále v dobrom stave. To u nás nemáme, lebo testovacie steky sa spúšťajú každý deň. A to je dosť. A ak sa niečo začne pokaziť, začne sa to rozpadávať bez toho, aby sme to ešte niekde overovali.
Pokiaľ ide o Local Values, pokračujme v rozhovore za sálom.
Ahoj! Ďakujem za prednášku! Veľmi poučné. Hovoril si, že máte veľmi veľa jednorázového kódu na opis infraštruktúry. Nezvažovali ste možnosť generovania tohto kódu?
Skvelá otázka, ďakujem! V skutočnosti, keď používame infraštruktúru ako kód, predpokladáme, že sa pozeráme na kód a rozumieme, aká infraštruktúra za týmto kódom leží. Ak sa kód generuje, musíme si predstaviť, aký kód bude vygenerovaný, aby sme pochopili, aká infraštruktúra tam bude. Alebo generujeme kód, odosielame ho a v zásade dostaneme to isté. Preto sme sa vybrali cestou, akou sme napísali, to sme dostali. Plus generátory sa objavili neskôr, keď sme už začali pracovať. A už bolo neskoro na zmenu.
Počuli ste niečo o jsonnete?
Nie.
Pozri, to je veľmi skvelá vec. Vidím konkrétny prípad, kde to možno využiť a generovať štruktúru dát.
Generátory sú skvelé, keď máte situáciu ako v anekdote o holiacom prístroji. T. j. prvýkrát má každý iné tváre, ale potom sú tváre všetkých rovnaké. Generátory sa veľmi dobre používajú. Ale žiaľ, my máme trochu iné tváre. To je problém.
Jednoducho sa pozri. Ďakujem!
Volám sa Maxim, som zo Sberbank. Trochu ste povedali, že ste sa snažili prispôsobiť Terraform analógu programovacieho jazyka. Nie je jednoduchšie používať Ansible?
To sú veľmi odlišné veci. Môžete vytvárať zdroje aj pomocou Ansible, aj Puppet môžete vytvárať zdroje na Amazone. Ale Terraform je priamo optimalizovaný.
Máte len Amazon?
Nie je to o tom, že máme len Amazon. Takmer máme len Amazon. Ale kľúčová funkcia je v tom, že Terraform si pamätá. V Ansible, ak poviete: „Zvýš mi 5 inštancií“, tak vytvorí, a potom poviete: „A teraz potrebujem 3“. A Terraform povie: „OK, 2 zruším“, a Ansible povie: „OK, tu máš 3“. Takže 8.
Dobrý deň! Ďakujem za vašu prezentáciu! Bolo veľmi zaujímavé počuť o Terraform. Hneď chcem poskytnúť malý komentár k tomu, že Terraform predsa len nemá stabilný release, preto buďte veľmi opatrní s Terraform.
Kde je dobré si dávať pozor na čas. T. j. ak potrebujete riešenie, občas odložíte to, čo je nestabilné atď., ale funguje to a pomohlo nám to.
Mám takú otázku. Používate Remote backend, používate S3. Prečo nepoužívate oficiálny backend?
Oficiálny?
Terraform Cloud.
Keď sa objavil?
Pred 4 mesiacmi.
Keby sa objavil pred 4 rokmi, pravdepodobne by som odpovedal na vašu otázku.
Tam je už zabudovaná funkcia a locky, a môžete uchovávať state súbor. Skúste to. Ale tiež som to netestoval.
Ideme veľkým vlakom, ktorý jazdí veľkou rýchlosťou. A nemôžete len tak vziať a vyhodiť niekoľko vozňov.
Hovorili ste o snehových vločkách, prečo ste nepoužili branch? Prečo to nevyšlo?
Máme taký prístup, že celá infraštruktúra je v jednom repozitári. Terraform, Puppet, všetky skripty, ktoré sa akýmkoľvek spôsobom týkajú tohto, sú všetky v jednom repozitári. Takto môžeme zaručiť, že inkrementálne zmeny sú testované jedna po druhej. Keby to bolo množstvo branchov, taký projekt je takmer nemožné spravovať. Prejdú pol roka a rozchádzajú sa natoľko, že je to proste neúnosné. To je to, čomu som sa chcel vyhnúť pred refaktorovaním.
T. j. to nefunguje?
To vôbec nefunguje.
V branchi som vystrihol slide zložky. T. j. ak by sme spravili pre každý testovací stack, napríklad, tím A – má svoju zložku, tím B má svoju zložku, tak to tiež nefunguje. Vytvorili sme zjednotený kód testovacieho prostredia, ktorý bol dostatočne flexibilný, aby vyhovoval všetkým. T. j. jeden kód sme spravovali.
Ahoj! Volám sa Jura! Ďakujem za prednášku! Mám otázku ohľadom modulov. Hovoríte, že používate moduly. Ako riešite problém, ak v jednom module sú vykonané zmeny, ktoré nie sú kompatibilné so zmenami inej osoby? Verzionujete moduly nejako, alebo sa snažíte prispôsobiť „vunderwaffle“, aby vyhovovali dvom požiadavkám?
To je problém veľkého snežného kompresora. To je to, čím trpíme, keď nejaká neškodná zmena môže zničiť nejakú časť infraštruktúry. A to bude viditeľné až po dlhšom čase.
T. j. zatiaľ sa to nijako nerieši?
Dávate univerzálne moduly. Vyhýbajte sa snežinkám. A všetko bude fungovať. Druhá polovica prednášky je o tom, ako sa tomu vyhnúť.
Dobrý deň! Ďakujem za prednášku! Chcel by som overiť jednu vec. Za scénou zostala veľká kôpka, kvôli ktorej som prišiel. Akým spôsobom sú integrované Puppet a rozdávanie rolí?
User-data.
T. j. len jednoducho vyhodíte súbor a na jeho základe to nejako vykonávate?
User-data je poznámka, t. j. keď vytvárame klon obrazu, tak sa spustí Daemon a snaží sa zistiť, kto je, číta poznámku, že je load balancer.
T. j. ide o nejaký samostatný proces, ktorý sa odovzdáva?
My sme ho nevymysleli. Používame ho.
Dobrý deň! Mám otázku ohľadom User-data. Povedali ste, že tam sú problémy, že niekto môže niečo poslať na nesprávne miesto. Existuje nejaký spôsob, ako uchovávať user-data v tom istom Gite, aby vždy bolo jasné, na čo sa User-data odkazuje?
Generujeme User-data z šablóny. To znamená, že sa používajú určité premenné. A Terraform generuje konečný výsledok. Preto sa nedá len tak pozrieť na šablónu a povedať, čo dostaneme, pretože všetky problémy sú spojené s tým, že vývojár si myslí, že do tejto premennej posiela string, a pri tom sa dodáva pole. A zrazu - bum, a ja -ten, ten, ďalší riadok, a všetko sa rozpadlo. Ak je to nový zdroj a človek ho nasadzuje, uvidí, že niečo nefunguje, to sa rýchlo vyrieši. Ale ak sa aktualizuje autoscale-skupina, tak v určitom momente sa inštancie v autoscale-skupine začnú meniť. A hop, niečo nefunguje. To je nepríjemné.
Takže jediné riešenie je testovať?
Áno, vidíte problém, pridávate tam testovacie kroky. To znamená, že sa dá testovať aj output. Možno to nie je tak pohodlné, ale tiež sa dajú nastaviť nejaké značky - kontrolujte, že User-data tu je pribité hřebíkom.
Volám sa Timur. Je super, že sú prednášky o tom, ako správne organizovať Terraform.
Ešte som ani nezačal.
Myslím si, že na ďalšej konferencii by to mohlo byť. Mám jednoduchú otázku. Prečo hardkodujete hodnotu v samostatnom module, namiesto použitia tfvars, t.j. čím je lepší modul so hodnotami, než tfvars?
T.j. musím tu (snímak: Production/environment/settings.tf) napísať: domain = premenna, domain vpcnetwork, premenna vpcnetwork a stvars - získať to isté?
Robíme to presne takto. Odkazujeme na zdroj nastavení modulu, napríklad.
V podstate je to taký tfvars. Tfvars je veľmi pohodlný v testovacom prostredí. Mám tfvars pre veľké inštancie, pre malé. A jeden súbor som hodil do priečinka. A dostal som to, čo som chcel. Keď vyvíjame infraštruktúru, chceme, aby sme sa mohli pozrieť a ihneď všetko pochopiť. Takto je to, že sa pozriete sem, potom pozriete do tfvars.
Takže, aby všetko bolo na jednom mieste?
Áno, tfvars - to je keď máte jeden kód. A ten sa používa na viacerých rôznych miestach s rôznymi nuansami. Potom by ste tfvars hodili a dostali svoje nuansy. A my - to je infraštruktúra ako kód v čistej forme. Pozreli ste sa a pochopili.
Ahoj! Stretli ste sa niekedy so situáciami, keď cloudový poskytovateľ zasahuje do toho, čo ste vytvorili pomocou Terraform? Povedzme, že upravujeme metaúdaje. Sú tam ssh kľúče. A Google neustále pridáva svoje metaúdaje a kľúče. A Terraform vždy píše, že má nejaké zmeny. Po každom spustení, aj keď sa nič nemení, vždy hovorí, že toto pole teraz aktualizuje.
S kľúčmi, ale áno, časť infraštruktúry je ovplyvnená takouto vecou, teda Terraform nič nemôže zmeniť. Ani my sami nemôžeme nič zmeniť. Zatiaľ žijeme s týmto.
Teda ste sa s týmto už stretli, ale nič ste nevymysleli, on to robí sám, aj tak?
Bohužiaľ, áno.
Ahoj! Volám sa Stanislav Starkov. Mail.ru Group. Ako riešite problém s generovaním tagu na …, ako ho prenášate dnu? Chápem to správne, cez User-data, aby ste uviedli názov hostiteľa, nasmerovať Puppet? A druhá časť otázky. Ako riešite tento problém v SG, teda keď generujete SG, stovku rovnakých instances, ako ich správne pomenovať?
Tieto instances, ktoré sú pre nás veľmi dôležité, pomenúvame pekne. Tieto, ktoré nie sú potrebné, tam bude priezvisko, že je to autoscale skupina. A teoreticky to možno zabiť a získať nové.
Čo sa týka problému s tagom, tak nie je to problém, ale úloha. A tagy sú u nás veľmi, veľmi silno používané, pretože infraštruktúra je veľká a drahá. Potrebujeme sledovať, na čo idú peniaze, preto tagy umožňujú zmapovať, čo a kam išlo. A podľa toho hľadať, kde sa míňa veľa peňazí.
O čom bol ešte otázka?
Keď SG vytvorí stovku instances, treba ich nejako rozlišovať?
Nie, netreba. Na každom instance je agent, ktorý hlási, že mám problém. Ak agent hlási, tak o ňom agent vie a aspoň jeho IP adresa existuje. Už sa dá niečo urobiť. Po druhé, používame Consul na Discovery, tam, kde nie je Kubernetes. A Consul tiež ukazuje IP adresu instance.
Teda orientujete sa presne na IP, a nie na názov hostiteľa?
Nie je možné orientovať sa podľa názvu hostiteľa, je ich príliš veľa. Existujú identifikátory instance – AE a podobne. Môžete ho niekde nájsť, môžete ho hodiť do vyhľadávania.
Ahoj! Pochopil som, že Terraform je dobrá vec, zameraná na cloudy.
Nie len to.
Toto je otázka, ktorá ma zaujíma. Ak sa rozhodnete hromadne prejsť na Bare Metal so všetkými svojimi instanciami, nebudú žiadne problémy? Alebo budete musieť použiť iné produkty, ako napríklad Ansible, ktorý tu bol spomenutý?
Ansible je trošku niečo iné. T. j. Ansible funguje, keď sa inštancia spustila. A Terraform funguje pred tým, ako sa inštancia spustila. Prechod na Bare Metal – nie.
Teraz nie, ale príde biznis a povie: „Poďme na to“.
Prechod na iný cloud – áno, ale tu je to trochu iné. Treba napísať Terraform kód tak, aby prechod na iný cloud bol čo najjednoduchší.
Pôvodne bola úloha taká, že naša celá infraštruktúra je agnostická, t. j. akýkoľvek cloud by mal fungovať, ale v určitom momente biznis rezignoval a povedal: „OK, v najbližších N rokoch nikam neodídeme, môžeme používať služby od Amazonu“.
Terraform umožňuje vytvárať v Front-End jobs, konfigurovať PagerDuty, data doc atď. Má toho naozaj veľa. Prakticky môže kontrolovať celý svet.
Ďakujem za prezentáciu! Užil som si už aj 4 roky prácu s Terraform. Pri hladkom prechode na Terraform, na infraštruktúru, na deklaratívny popis, sme sa stretli so situáciou, keď niekto niečo robil manuálne a vy ste sa snažili urobiť plán. A dostali ste nejakú chybu. Ako také problémy riešite? Ako nájdete stratené zdroje, ktoré boli uvedené?
Hlavne manuálne, pomocou našich očí, ak vidíme v správe niečo zvláštne, analyzujeme, čo sa deje, alebo to jednoducho zrušíme. A vo všeobecnosti, pull requesty sú bežná vec.
Ak sa objaví chyba, robíte rollback? Skúšali ste to?
Nie, to je rozhodnutie človeka v momente, keď vidí problém.
Zdroj: habr.com
