

Nedávno som hovoril o tom, ako pomocou typových receptov z PostgreSQL databázy. Dnes sa budeme zaoberať tým, ako môžeme urobiť zápis do DB efektívnejší bez použitia akýchkoľvek „vrtačiek“ v konfigurácii — jednoducho správne usporiadaním tokov dát.
#1. Секционирование
Článok o tom, ako a prečo by sa malo organizovať už bol, tu sa budeme zaoberať praktickým uplatnením niektorých prístupov v rámci našich .
„Časy dávno minulé…“
Pôvodne, ako každý MVP, náš projekt začal pod celkom malou záťažou — monitorovanie sa vykonávalo iba pre desiatku najkritickejších serverov, všetky tabuľky boli relatívne kompaktne… Ale čas plynul, sledovaných hostiteľov pribúdalo, a pokúsili sme sa znova spraviť niečo s jednou z tabuliek s rozmerom 1.5TB, pochopili sme, že žiť tak ďalej je síce možné, ale veľmi nepríjemné.
Časy boli takmer rozprávkové, aktuálne boli rôzne verzie PostgreSQL 9.x, preto všetko segmentovanie sa muselo robiť „ručne“ — cez dedičstvo tabuliek a spúšťace routing s dynamickým EXECUTE.
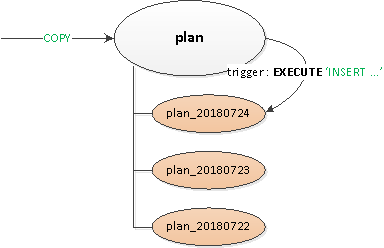
Výsledné riešenie sa ukázalo ako dostatočne univerzálne, aby ho bolo možné previesť na všetky tabuľky:
- Bola vyhlásená prázdna „hlavičková“ rodičovská tabuľka, na ktorej boli popísané všetky potrebné indexy a spúšťace.
- Zápis z pohľadu klienta sa vykonal do „koreňovej“ tabuľky, a vnútri pomocou spúšťaceho routingu
BEFORE INSERTsa zápis „fyzicky“ vložil do správnej sekcie. Ak taká ešte neexistovala — zachytili sme výnimku a … - ... pomocou podľa šablóny rodičovskej tabuľky sa vytvorila sekcia s obmedzením na požadovaný dátum, aby pri vyhľadávaní údajov sa čítanie vykonávalo iba v nej.
PG10: prvý pokus
Ale segmentácia cez dedičstvo nebola historicky veľmi prispôsobená pre prácu s aktívnym tokom zápisu alebo veľkým počtom sekcií potomkov. Napríklad, môžeme si spomenúť, že algoritmus výberu správnej sekcie mal kvadratickú zložitosti, čo pri 100+ sekciách funguje, sami chápete ako…
V PG10 sa táto situácia výrazne optimalizovala, implementujúc podporu . Preto sme sa ihneď pokúsili aplikovať to hneď po migrácii úložiska, ale…
Ako sa ukázalo po preštudovaní manuálu, nativne sekcionovaná tabuľka v tejto verzii:
- nepodporuje popis indexov
- nepodporuje triggere na nej
- nemôže byť nikým «potomkom»
- nepodporuje
INSERT ... ON CONFLICT - nedokáže automaticky generovať sekciu
Po bolestivom údere do hlavy sme si uvedomili, že bez modifikácie aplikácie sa nezaobídeme a odložili sme ďalšie výskumy na pol roka.
PG10: druhá šanca
Takže sme začali riešiť vyvstávajúce problémy po jednom:
- Keďže triggere a
ON CONFLICTsa nám na niektorých miestach predsa len zdali potrebné, na ich spracovanie sme vytvorili medzistupňovú proxy tabuľku. - zbavili sme sa «routing-u» v triggeroch — teda od
EXECUTE. - Naseparovali sme tabuľku-šablónu so všetkými indexami, aby ani neboli prítomné na proxy tabuľke.
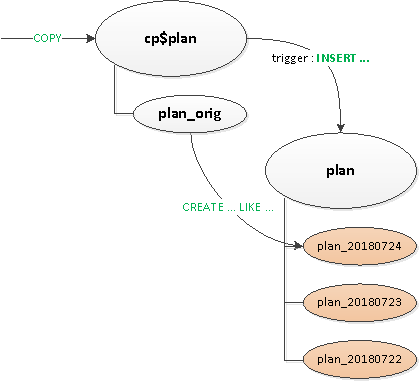
Nakoniec, po všetkom tom, sme nativne odsekcionovali hlavnú tabuľku. Vytvorenie novej sekcie zatiaľ zostalo na svedomí aplikácie.
„Pílime“ slovníky
Rovnako ako v každom analytickom systéme, mali sme aj my „fakty“ a „rezania“ (slovníky). V našom prípade vystupovali napríklad ako rovnakých pomalých dotazov alebo text samotného dotazu.
„Fakty“ už boli sekcionované podľa dní, takže sme si bez problémov mohli odstrániť zastarané sekcie, a tie nám neprekážali (logy predsa!). Ale so slovníkmi sa to zhoršilo…
Nedá sa povedať, že by ich bolo veľmi veľa, ale približne na 100TB „faktov“ vznikol slovník na 2,5TB. Z takej tabuľky sa pohodlne nedá nič odstrániť, nezmenšiť v rozumnom čase, a aj zápis do nej postupne spomaľoval.
Akoby slovník… v ňom by mala byť každá položka zastúpená presne raz… a to je správne, ale!.. Nikto nám nebráni mať na každý deň samostatný slovník! Áno, to prináša určitú nadbytočnosť, ale na druhej strane to umožňuje:
- rýchlejšie zapisovanie/čítanie vďaka menšej veľkosti sekcie
- spotrebovať menej pamäte vďaka práci s kompaktnými indexami
- uskladniť menej údajov vďaka možnosti rýchleho odstránenia zastaraných
V dôsledku celého komplexu opatrení záťaž CPU sa znížila o ~30%, na disku o ~50%:
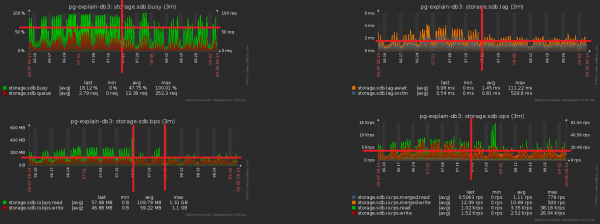
Pri tom sme naďalej zapisovali do databázy presne to isté, len s menšou záťažou.
#2. Эволюция и рефакторинг БД
Takže sme sa zastavili pri tom, že máme na každý deň svoju sekciu s údajmi. Vlastne, CHECK (dt = '2018-10-12'::date) — a to je kľúč sekcionovania a podmienka na zaradenie záznamu do konkrétnej sekcie.
Keďže všetky správy v našej službe sú zostavené podľa konkrétneho dátumu, aj indexy z "nesekcionovaných čias" pre ne boli všetky typu (Server, Dátum, Šablóna plánu), (Server, Dátum, Uzol plánu), (Dátum, Trieda chyby, Server),…
Ale teraz v každej sekcii žijú svoje inštancie každého takého indexu… A v rámci každej sekcie dátum je konštanta… Zisťujeme, že teraz do každého takého indexu banálne zapisujeme konštantu ako jedno z polí, čo zvyšuje jeho objem aj čas vyhľadávania, no neprináša žiadny výsledok. Sami sme si vytvorili problémy, ups...
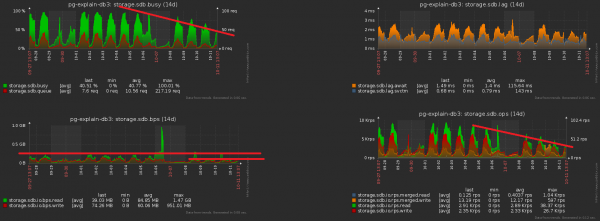
Smer optimalizácie je samozrejmý — jednoducho odstránime pole s dátumom zo všetkých indexov na sekcionovaných tabuľkách. Pri našich objemoch zisk — okolo 1TB/týždeň!
A teraz si všimnime, že tento terabajt sme ešte museli nejako zapísať. To znamená, že aj disk musíme teraz zaťažovať menej! Na tomto obrázku je dobre viditeľný dosiahnutý efekt odvedenej práce, ktorej sme venovali týždeň:
#3. «Размазываем» пиковую нагрузку
Jedným z veľkých problémov zaťažených systémov je zbytočná synchronizácia niektorých operácií, ktoré to nevyžadujú. Niekedy "pretože si to nevšimli", inokedy "tak to bolo jednoduchšie", ale skôr či neskôr sa od nej musíme zbaviť.
Priblížime predchádzajúci obrázok — a vidíme, že disk má "prenos" záťaže s dvojitou amplitúdou medzi susednými meraniami, čo jasne "štatisticky" nemalo byť pri takom množstve operácií:
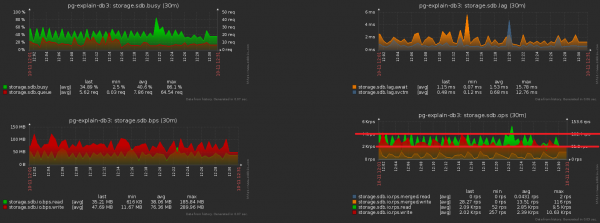
Dosiahnuť to je dosť jednoduché. Na monitorovanie sme mali zavedených už takmer 1000 serverov, každý spracováva samostatným logickým tokom, a každý tok ukladá nahromadené informácie na odoslanie do databázy s určitou pravidelnosťou, približne takto:
setInterval(sendToDB, interval)Problém spočíva presne v tom, že všetky toky sa spúšťajú približne v rovnakom čase, preto sú chvíle odosielania skoro vždy rovnaké "do bodky". Ups č. 2...
Našťastie sa to pomerne jednoducho opraví, pridaním "náhodného" rozptylu. časovo:
setInterval(sendToDB, interval * (1 + 0.1 * (Math.random() - 0.5)))#4. Кэшируем, что нужно можно
Tretí tradičný problém highloadu — absence cache tam, kde je mohol byť.
Napríklad, urobili sme možnosť analýzy z pohľadu uzlov plánu (všetky tieto Seq Scan on users), ale hneď si pomyslieť, že sú, v masovom, rovnaké — zabudli sme.
Nie, samozrejme, do databázy sa nič neopakuje, to odstraňuje spúšťač s INSERT ... ON CONFLICT DO NOTHING. Ale do databázy tieto údaje predsa len dorazia, a to ešte aj zbytočné čítanie na overenie konfliktu robiť musíme. Ups č. 3…
Rozdiel v počte záznamov posielaných do databázy pred/po zapnutí cachovania — je jasný:
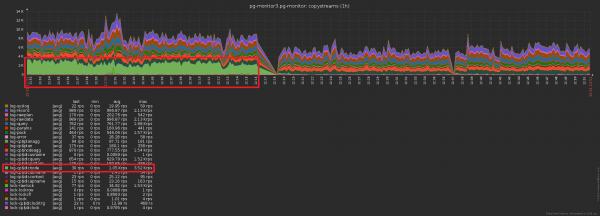
A toto — sprievodné poklesnutie záťaže na úložisku:
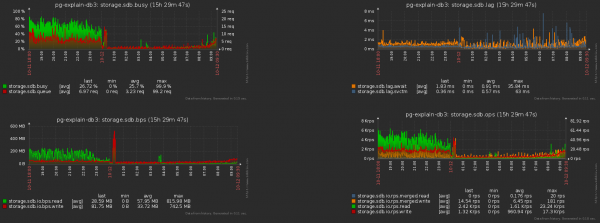
Spolu
Tera-bajt za deň“ znie iba hrozivo. Ak robíte všetko správne, je to len 2^40 bytov / 86400 sekúnd = ~12.5MB/s, čo udržali aj stolné IDE disky. 🙂
A ak sa na to pozrieme vážne, dokonca aj pri desatinásobnom „prevrhu“ záťaže počas dňa, sa v pohode môžete zmestiť do možností moderných SSD.
Zdroj: habr.com
