

Ahoj, Habr! Predstavujem vám preklad článku autorov Burak Yavuz, Brenner Heintz a Denny Lee, ktorý bol pripravený pred spustením kurzu od OTUS.
Údaje, podobne ako naše skúsenosti, sa neustále zhromažďujú a vyvíjajú. Aby sme nezostali pozadu, naše mentálne modely sveta musia prispôsobiť sa novým údajom, niektoré z nich obsahujú nové dimenzie — nové spôsoby pozorovania vecí, o ktorých sme predtým nemali predstavu. Tieto mentálne modely sa málo líšia od schém tabuliek, ktoré určujú, ako klasifikujeme a spracovávame nové informácie.
To nás privádza k otázke správy schém. Ako sa podnikové úlohy a požiadavky v priebehu času menia, mení sa aj štruktúra vašich údajov. Delta Lake umožňuje jednoducho zavádzať nové dimenzie pri zmene údajov. Používatelia majú prístup k jednoduchým semantickým nástrojom na správu schém svojich tabuliek. Tieto nástroje zahŕňajú uplatňovanie schémy (Schema Enforcement), ktoré chráni používateľov pred neúmyselným znečistením ich tabuliek chybami alebo nepotrebnými údajmi, ako aj evolúciu schémy (Schema Evolution), ktorá umožňuje automaticky pridávať nové stĺpce s cennými údajmi na príslušné miesta. V tomto článku sa hlbšie ponoríme do používania týchto nástrojov.
Porozumenie schémam tabuliek
Každý DataFrame v Apache Sparku obsahuje schému, ktorá určuje formu údajov, ako sú typy údajov, stĺpce a metadáta. Pomocou Delta Lake sa schéma tabuľky uchováva vo formáte JSON v rámci transakčného žurnálu.
Čo je uplatňovanie schémy?
Uplatňovanie schémy (Schema Enforcement), známe aj ako overenie schémy (Schema Validation), je ochranný mechanizmus v Delta Lake, ktorý zabezpečuje kvalitu údajov tým, že odmieta záznamy, ktoré nezodpovedajú schéme tabuľky. Rovnako ako hosť na recepcii v populárnej reštaurácii, ktorý prijíma iba na objednávku, kontroluje, či sú všetky údaje vkladané do tabuľky v zozname očakávaných stĺpcov (inými slovami, či je pre každý z nich „rezervácia“), a odmieta akékoľvek záznamy so stĺpcami, ktoré nie sú v zozname.
Ako funguje uplatňovanie schémy?
Delta Lake využíva kontrolu schémy pri zápise, čo znamená, že všetky nové záznamy v tabuľke sa kontrolujú na kompatibilitu so schémou cieľovej tabuľky počas zápisu. Ak je schéma nekompatibilná, Delta Lake úplne zruší transakciu (údaje sa nezapíšu) a vytvorí výnimku, aby informoval používateľa o neshode.
Na určenie kompatibility záznamu s tabuľkou Delta Lake používa nasledujúce pravidlá. Zapisovaný DataFrame:
- nemôže obsahovať ďalšie stĺpce, ktoré nie sú v schéme cieľovej tabuľky. Naopak, je v poriadku, ak prichádzajúce údaje neobsahujú všetky stĺpce z tabuľky - týmto stĺpcom budú jednoducho priradené nulové hodnoty.
- nemôže mať typy údajov stĺpcov, ktoré sa líšia od typov údajov stĺpcov v cieľovej tabuľke. Ak stĺpec cieľovej tabuľky obsahuje údaje typu StringType, ale zodpovedajúci stĺpec v DataFrame obsahuje údaje typu IntegerType, nútené uplatnenie schémy vyvolá výnimku a zabráni vykonaniu operácie zápisu.
- nemôže obsahovať názvy stĺpcov, ktoré sa líšia iba veľkosťou písmen. To znamená, že nemôžete mať stĺpce s názvami ‘Foo’ a ‘foo’ definované v jednej tabuľke. Hoci Spark môže byť používaný v režime citlivom alebo necitlivom na veľkosť písmen (predvolene necitlivom), Delta Lake uchováva veľkosť písmen, ale je necitlivo v rámci ukladaní schémy. Parquet je citlivý na veľkosť písmen pri uložení a vrátení informácií o stĺpci. Aby sa predišlo možným chybám, poškodeniu údajov alebo ich strate (s čím sme sa osobne stretli v Databricks), rozhodli sme sa pridať toto obmedzenie.
Aby sme to ilustrovali, pozrime sa na to, čo sa deje v nasledujúcom kóde pri pokuse pridať niektoré nedávno vygenerované stĺpce do tabuľky Delta Lake, ktorá ešte nie je nastavená na ich prijatie.
# Сгенерируем DataFrame ссуд, который мы добавим в нашу таблицу Delta Lake
loans = sql("""
            SELECT addr_state, CAST(rand(10)*count as bigint) AS count,
            CAST(rand(10) * 10000 * count AS double) AS amount
            FROM loan_by_state_delta
            """)

# Вывести исходную схему DataFrame
original_loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)

# Вывести новую схему DataFrame
loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)
  |-- amount: double (nullable = true) # new column

# Попытка добавить новый DataFrame (с новым столбцом) в существующую таблицу
loans.write.format("delta")
           .mode("append")
           .save(DELTALAKE_PATH)

Returns:

A schema mismatch detected when writing to the Delta table.

To enable schema migration, please set:
'.option("mergeSchema", "true")'

Table schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)

Data schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)
-- amount: double (nullable = true)

If Table ACLs are enabled, these options will be ignored. Please use the ALTER TABLE command for changing the schema.
Namiesto automatického pridávania nových stĺpcov, Delta Lake presadzuje schému a zastaví zápis. Aby pomohol určiť, ktorý stĺpec (alebo ich množstvo) spôsobuje neshodu, Spark vytlačí obe schémy zo zásobníka chýb na porovnanie.
Aký je prínos núteného uplatnenia schémy?
Keďže nútené uplatnenie schémy predstavuje dosť prísny test, je to vynikajúci nástroj na použitie ako strážca čistého, úplne transformovaného súboru údajov, ktorý je pripravený na produkciu alebo spotrebu. Zvyčajne sa aplikuje na tabuľky, ktoré priamo podávajú údaje:
- Algoritmy strojového učenia
- BI panelom
- Analytike údajov a nástrojom na vizualizáciu
- Akýkoľvek výrobný systém vyžadujúci prísne štruktúrované, prísne typizované sémantické schémy.
Aby ste pripravili svoje údaje na túto konečnú prekážku, mnohí používatelia používajú jednoduchú architektúru „multi-hop“, ktorá postupne vnáša štruktúru do ich tabuliek. Ak sa chcete dozvedieť viac, môžete si prečítať článok
Samozrejme, nútené uplatnenie schémy sa môže použiť kdekoľvek vo vašej pipeline, ale majte na pamäti, že streamovanie zápisu do tabuľky v takom prípade môže byť frustrujúce, pretože, napríklad, ste zabudli, že ste pridali ďalší stĺpec do prichádzajúcich údajov.
Prevencia zriedenia údajov
V tomto bode sa možno pýtate, prečo taký rozruch? Napokon, niekedy môže nečakaná chyba „nesúlad schémy“ potrápiť váš pracovný proces, najmä ak ste nováčik v Delta Lake. Prečo jednoducho nedovoliť schéme zmeniť sa tak, ako potrebuje, aby som mohol bez ohľadu na všetko zapísať svoj DataFrame?
Ako hovorí staré príslovie, „unca prevencie stojí za libra liečenia“. V určitom momente, ak sa nestaráte o uplatnenie svojej schémy, problémy s kompatibilitou typov údajov vystrčia svoje ohavné hlavy — na prvý pohľad homogénne zdroje surových údajov môžu obsahovať okrajové prípady, poškodené stĺpce, nesprávne vytvorené zobrazenia alebo iné desivé veci, ktoré sa objavujú v nočných morách. Najlepším prístupom je zastaviť týchto nepriateľov pri bráne — s pomocou núteného uplatnenia schémy — a vysporiadať sa s nimi na svetle, nie neskôr, keď začnú číhať v temných hĺbkach vášho pracovného kódu.
Povinné uplatňovanie schémy zabezpečuje, že štruktúra vašej tabuľky sa nezmení, pokiaľ sa sami nerozhodnete zmeniť ju. To predchádza "zriedenému" (dilúciu) dátam, ktoré môže nastať, keď sa nové stlpce pridávajú tak často, že predtým cenné, komprimované tabuľky strácajú svoj význam a užitočnosť kvôli záplave dát. Povzbudzujúc vás, aby ste boli zameraní, nastavovali vysoké štandardy a očakávali vysokú kvalitu, povinné uplatňovanie schémy robí presne to, na čo bolo určené — pomáha vám zostať zodpovedným a vaším tabuľkám — čistými.
Ak sa pri ďalšom preskúmaní rozhodnete, že vám vlastne je potrebné pridať nový stĺpec — žiaden problém, nižšie je uvedené jednorádkové riešenie. Riešenie je evolúcia schémy!
Čo je evolúcia schémy?
Evolúcia schémy je funkcia, ktorá užívateľom umožňuje jednoducho meniť aktuálnu schému tabuľky podľa údajov, ktoré sa menia v priebehu času. Najčastejšie sa používa pri vykonávaní operácie pridávania alebo prepísania, aby automaticky prispôsobila schému na zahrnutie jedného alebo viacerých nových stĺpcov.
Ako funguje evolúcia schémy?
Nasledujúc príklad z predchádzajúcej časti, vývojári môžu jednoducho využiť evolúciu schémy na pridanie nových stĺpcov, ktoré boli predtým odmietnuté z dôvodu nesúladu so schémou. Evolúcia schémy sa aktivuje pridaním .option('mergeSchema', 'true') k vašej Spark príkazu .write alebo .writeStream.
# Добавьте параметр mergeSchema
loans.write.format("delta")
           .option("mergeSchema", "true")
           .mode("append")
           .save(DELTALAKE_SILVER_PATH)
Aby ste videli plán, vykonajte nasledujúci Spark SQL dotaz
# Создайте график с новым столбцом, чтобы подтвердить, что запись прошла успешно
%sql
SELECT addr_state, sum(`amount`) AS amount
FROM loan_by_state_delta
GROUP BY addr_state
ORDER BY sum(`amount`)
DESC LIMIT 10 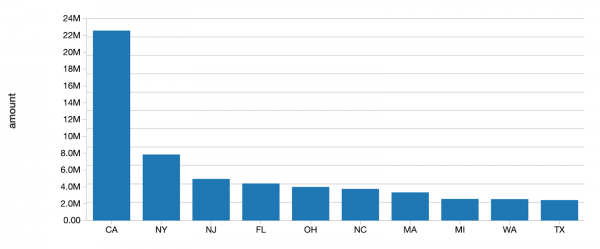
Alternatívne môžete nastaviť túto možnosť pre celú reláciu Spark pridaním spark.databricks.delta.schema.autoMerge = True do konfigurácie Spark. Ale používajte to s opatrnosťou, pretože povinné uplatňovanie schémy už vás nebude upozorňovať na neúmyselné nesúladnosti so schémou.
Ak do dotazu zahrniete parameter mergeSchema, všetky stĺpce, ktoré sú prítomné v DataFrame, ale chýbajú v cieľovej tabuľke, sa automaticky pridajú na koniec schémy v rámci transakcie zápisu. Môžu sa pridať aj vnorené polia, a tiež budú pridané na koniec príslušných stĺpcov štruktúry.
Dátum inžinieri a vedci môžu túto možnosť využiť na pridanie nových stĺpcov (možno nedávno sledované metriky alebo stĺpec ukazovateľov predaja za tento mesiac) do svojich existujúcich produkčných tabuliek strojového učenia, bez toho, aby sa narušili existujúce modely založené na starých stĺpikoch.
Nasledujúce typy zmien schémy sú prípustné v rámci evolúcie schémy pri pridávaní alebo prepise tabuľky:
- Pridanie nových stĺpcov (to je najbežnejší scenár)
- Zmena typov údajov z NullType -> akýkoľvek iný typ alebo zvyšovanie z ByteType -> ShortType -> IntegerType
Iné zmeny, ktoré nie sú prípustné v rámci evolúcie schémy, vyžadujú, aby bola schéma a údaje prepísané pridaním .option("overwriteSchema", "true"). Napríklad, keď bol stĺpec „Foo“ pôvodne integer a nová schéma by bola typu string, potom by všetky súbory Parquet (údaje) bolo potrebné prepísať. K takýmto zmenám patria:
- odstránenie stĺpca
- zmena typu údajov existujúceho stĺpca (na mieste)
- premenovanie stĺpcov, ktoré sa líšia iba veľkosťou písmen (napr. „Foo“ a „foo“)
Nakoniec, s nasledujúcou verziou Spark 3.0 sa bude plne podporovať explicitný DDL (použitím ALTER TABLE), čo umožní používateľom vykonávať nasledujúce operácie nad schémami tabuliek:
- pridávanie stĺpcov
- zmena komentárov k stĺpcom
- nastavenie vlastností tabuľky, ktoré určujú správanie tabuľky, napríklad nastavenie doby uchovávania protokolu transakcií.
Aký je prínos evolúcie schémy?
Evolúciu schémy môžete využiť vždy, keď máte v úmysle zmeniť schému svojej tabuľky (na rozdiel od tých prípadov, keď ste náhodou pridali do svojho DataFrame stĺpce, ktoré by tam nemali byť). Je to najjednoduchší spôsob, ako migrovať svoju schému, pretože automaticky pridáva správne mená stĺpcov a typy údajov bez potreby ich výslovného vyhlásenia.
Záver
Povinné uplatnenie schémy odmieta všetky nové stĺpce alebo iné zmeny schémy, ktoré nie sú kompatibilné s vašou tabuľkou. Stanovením a udržiavaním týchto vysokých štandardov môžu analytici a inžinieri dôverovať tomu, že ich údaje majú najvyššiu úroveň integrity, pričom o tom jasne a zreteľne premýšľajú, čo im umožňuje prijímať efektívnejšie obchodné rozhodnutia.
Na druhej strane, evolúcia schémy dopĺňa povinné uplatnenie, zjednodušuje predpokladané automatické zmeny schémy. Nakoniec, nemalo by to byť komplikované — pridať stĺpec.
Povinné uplatnenie schémy je jang, zatiaľ čo evolúcia schémy je jin. Spoločne tieto funkcie ako nikdy predtým zjednodušujú potlačenie šumu a ladenie signálu.
Taktiež by sme chceli poďakovať Mukulovi Murti a Pranavovi Anandovi za ich príspevok k tomuto článku.
Iné články z tejto série:
Články na tému
Zdroj: habr.com
