

TL;DR: Pred štyrmi rokmi som opustil Google s myšlienkou na nový nástroj na monitorovanie serverov. Nápad spočíval v tom, spojiť do jedného nástroja zvyčajne izolované funkcie a analýzy protokolov, zhromažďovania metrík, a panelu na sledovanie. Jedným z princípov je, že služba musí byť naozaj rýchla, poskytujúc devops tímom jednoduchú, interaktívnu a príjemnú prácu. To vyžaduje spracovanie súborov údajov s objemom niekoľkých gigabajtov za zlomok sekundy, bez prekročenia rozpočtu. Existujúce nástroje na prácu s protokolmi sú často pomalé a neohrabané, preto sme sa stretli s vážnou výzvou: dobre navrhnúť nástroj, aby sme používateľom priniesli nové zážitky z práce.
V tomto článku popisujeme, ako sme v Scalyr vyriešili tento problém, aplikovaním metód starého štýlu, hrubého prístupu, odstránením nadbytočných vrstiev a vyhýbaním sa zložitým dátovým štruktúram. Tieto poučenia môžete aplikovať na vlastné inžinierske úlohy.
Sila starého štýlu
Analýza protokolov zvyčajne začína vyhľadávaním: nájsť všetky správy, ktoré zodpovedajú určitému vzoru. V Scalyr je to desiatky alebo stovky gigabajtov protokolov z mnohých serverov. Moderné prístupy zvyčajne predpokladajú vytvorenie nejakej zložitej dátovej štruktúry optimalizovanej na vyhľadávanie. Videli sme to v Google, kde sú v takýchto veciach celkom dobrí. Ale my sme sa zastavili pri omnoho hrubšom prístupe: lineárnom skenovaní protokolov. A toto fungovalo – ponúkame rozhranie s vyhľadávaním, ktoré je porovnateľne rýchlejšie ako u konkurencie (pozrite sa na animáciu na konci).
Kľúčovým poznatkom bolo, že moderné procesory sú naozaj veľmi rýchle pri jednoduchých, priamych operáciách. To sa dá ľahko prehliadnuť v zložitých, mnohovrstvových systémoch, ktoré závisia od rýchlosti I/O a sieťových operácií, a takýchto systémov je dnes veľmi veľa. Takže sme navrhli dizajn, ktorý minimalizuje počet vrstiev a nadbytočného odpadku. S viacerými procesormi a servermi paralelne dosahujeme rýchlosti vyhľadávania až 1 TB za sekundu.
Kľúčové zistenia z tohto článku:
- Hrubé vyhľadávanie je celkom životaschopný prístup na riešenie reálnych, rozsiahlych problémov.
- Hrubá sila je technika navrhovania, nie oslobodenie sa od práce. Tak ako každá technika, aj ona sa lepšie hodí na niektoré problémy než na iné a môže byť zrealizovaná zle alebo dobre.
- Hrubá sila je obzvlášť dobrá na dosahovanie stabilným výkonnosti.
- Efektívne využitie hrubej sily si vyžaduje optimalizáciu kódu a včasné nasadenie dostatočného množstva zdrojov. Je vhodná, ak sú vaše servery pod veľkou záťažou, ktorá nie je spojená s používateľmi, a používateľské operácie majú prioritu.
- Výkonnosť závisí od dizajnu celého systému, nie len od algoritmu vnútorného cyklu.
(V tomto článku sa popisuje vyhľadávanie údajov v pamäti. Vo väčšine prípadov, keď používateľ vykonáva vyhľadávanie v logoch, servery Scalyr ich už ukladali do cache. V nasledujúcom článku sa budeme zaoberať vyhľadávaním v nekontrolovaných logoch. Používajú sa tie isté princípy: efektívny kód, metóda hrubej sily s veľkými výpočtovými zdrojmi).
Metóda hrubej sily
Tradične sa vyhľadávanie vo veľkom súbore údajov vykonáva podľa indexu kľúčových slov. V súvislosti so serverovými logmi to znamená vyhľadávanie každého jedinečného slova v zázname. Pre každé slovo treba zostaviť zoznam všetkých výskytov. To umožňuje ľahko nájsť všetky správy s týmto slovom, napríklad 'error', 'firefox' alebo 'transaction_16851951' — stačí sa pozrieť do indexu.
Takýto prístup som použil v Google a fungoval dobre. Ale v Scalyr hľadáme v logoch bajt po bajte.
Prečo? Z abstraktnej algoritmickej perspektívy sú indexy kľúčových slov oveľa efektívnejšie ako hrubé vyhľadávanie. Avšak nepredávame algoritmy, predávame výkonnosť. A výkonnosť nie je len o algoritmoch, ale aj o systémovom inžinierstve. Musíme zohľadniť všetko: objem údajov, typ vyhľadávania, dostupný hardvér a programový kontext. Rozhodli sme sa, že pre náš konkrétny problém je možnosť ako 'grep' lepšia než index.
Indexy sú výborné, ale majú určité obmedzenia. Jedno slovo je ľahké nájsť. Ale hľadanie správ s viacerými slovami, ako sú 'googlebot' a '404', je už oveľa zložitejšie. Hľadanie frázy ako 'uncaught exception' si vyžaduje objemnejší index, ktorý zaznamenáva nielen všetky správy s týmto slovom, ale aj konkrétne miesto slova.
Pravá obtiažnosť nastáva, keď hľadáte nie slová. Predpokladajme, že chcete zistiť, koľko prevádzky prichádza od botov. Prvá myšlienka - hľadanie v logoch podľa slova 'bot'. Tak nájdete niektoré boty: Googlebot, Bingbot a mnohých ďalších. Ale tu je 'bot' časťou slova, nie samotné slovo. Ak budete hľadať 'bot' v indexe, nenájdeme správy so slovom 'Googlebot'. Ak kontrolujeme každé slovo v indexe a potom skenujeme index podľa nájdených kľúčových slov, vyhľadávanie sa výrazne spomalí. Výsledkom je, že niektoré programy na prácu s logmi nedovoľujú vyhľadávanie podľa častí slova alebo (v lepšom prípade) umožňujú použiť špeciálnu syntaxi s nižším výkonom. Chceme sa tomu vyhnúť.
Ďalší problém - interpunkcia. Chcete nájsť všetky požiadavky od 50.168.29.7? Что насчёт отладки логов, содержащих [error]? Индексы обычно пропускают пунктуацию.
Nakoniec inžinieri milujú mocné nástroje a niekedy sa problém dá vyriešiť len pomocou regulárneho výrazu. Index kľúčových slov nie je na to veľmi vhodný.
Okrem toho sú indexy zložité. Každú správu je potrebné pridať do niekoľkých zoznamov kľúčových slov. Tieto zoznamy by sa mali neustále udržiavať v formáte vhodnom na vyhľadávanie. Požiadavky s frázami, fragmentami slov alebo regulárnymi výrazmi je potrebné prevádzať na operácie s viacerými zoznamami, a výsledky skenovať a kombinovať na získanie konečného súboru. V kontexte veľkoplošnej multiúžívateľskej služby táto zložitosť spôsobuje problémy s výkonom, ktoré nie sú viditeľné pri analýze algoritmov.
Indexy kľúčových slov tiež zaberajú veľa miesta a úložisko je hlavným nákladom v systéme správy logov.
Na druhej strane, hľadanie môže spotrebovať veľké množstvo výpočtovej sily. Naši používatelia ocenia rýchle vyhľadávanie na unikátne dotazy, no takéto dotazy sa vykonávajú relatívne zriedka. Pre typické vyhľadávacie požiadavky, ako je napríklad riadiaca doska, používame špeciálne techniky (popíšeme ich v nasledujúcom článku). Iné požiadavky sú dosť zriedkavé, takže zriedkakedy spracovávame viac ako jeden naraz. Ale to neznamená, že naše servery sú nečinné: sú zaťažené prácou na prijímaní, analýze a kompresii nových správ, hodnotení upozornení, kompresii starých dát a podobne. Takže máme pomerne značnú rezervu procesorov, ktoré môžeme využiť na vykonávanie požiadaviek.
Hrubá sila funguje, ak máte hrubý problém (a veľa sily).
Hrubá sila najlepšie funguje na jednoduchých úlohách s malými vnútornými cyklami. Často môžete optimalizovať vnútorný cyklus na veľmi vysoké rýchlosti. Ak je kód zložitý, je oveľa ťažšie ho optimalizovať.
Na začiatku nášho kódu na vyhľadávanie bol dosť veľký vnútorný cyklus. Ukladáme správy na stránkach po 4K; každá stránka obsahuje niektoré správy (vo formáte UTF-8) a metadáta pre každú správu. Metadáta sú štruktúra, v ktorej sú zakódované dĺžka hodnoty, vnútorné ID správy a ďalšie polia. Cyklus vyhľadávania vyzeral takto:
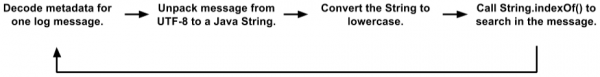
Toto je zjednodušená verzia oproti skutočnému kódu. Ale aj tu je vidieť niekoľko umiestnení objektu, kópií dát a volaní funkcií. JVM dosť dobre optimalizuje volania funkcií a pridelenie efemérnych objektov, takže tento kód fungoval lepšie, než sme si zaslúžili. Počas testovania klienti s ním celkom úspešne pracovali. Ale nakoniec sme prešli na novú úroveň.
(Môžete sa pýtať, prečo uchovávame správy v takom formáte s 4K stránkami, textom a metadátami, a nie pracujeme priamo s logmi. Existuje mnoho dôvodov, ktoré sa zameriavajú na to, že interný engine Scalyr je viac podobný distribuovanej databáze než súborovému systému. Textové vyhľadávanie sa často kombinuje s databázovými filtrami na poliach po spracovaní logov. Môžeme súčasne vyhľadávať v mnohých tisícoch logov a jednoduché textové súbory nie sú vhodné pre naše transakčné, replikované, rozdelené spravovanie dát).
Na prvý pohľad sa zdalo, že takýto kód nie je veľmi vhodný na optimalizáciu pomocou metódy brute force. "Skutočná práca" v String.indexOf() ani nesprevládala v profile CPU. Teda optimalizácia len tejto metódy by nepriniesla podstatný efekt.
Tak vyplynulo, že metadáta uchovávame na začiatku každej stránky, zatiaľ čo text všetkých správ je zabalený v UTF-8 na opačnom konci. Využijúc to, sme prepísali cyklus na vyhľadávanie okamžite na celej stránke:
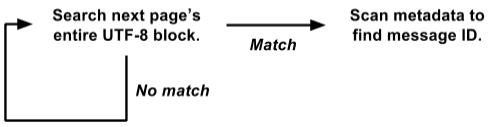
Taká verzia pracuje priamo na zobrazení raw byte[] a vyhľadáva všetky správy okamžite na celej stránke 4K.
Je to oveľa jednoduchšie optimalizovať pre metódu brute force. Interný vyhľadávací cyklus sa vyvoláva súčasne pre celú stránku 4K, a nie osobitne na každej správe. Nie sú žiadne kopírovanie dát ani alokácia objektov. A zložitejšie operácie s metadátami sa vyvolávajú len pri pozitívnom výsledku, nie pri každej správe. Takto sme vylúčili množstvo režijných nákladov, a zostatková záťaž je sústredená v malom vnútornom vyhľadávacom cykle, ktorý sa dobre hodí na ďalšiu optimalizáciu.
Náš skutočný vyhľadávací algoritmus je založený na . Je podobný algoritmu Boyera-Moora s preskočením približnej dĺžky vyhľadávacieho reťazca pri každom kroku. Hlavný rozdiel je v tom, že kontroluje dva byty naraz, aby minimalizoval falošné zhody.
Naša implementácia vyžaduje vytvorenie vyhľadávacej tabuľky 64K pre každý vyhľadávanie, ale to je zanedbateľné v porovnaní s gigabajtmi dát, v ktorých hľadáme. Interná slučka spracováva niekoľko gigabajtov za sekundu na jedinom jadre. V praxi je stabilný výkon približne 1,25 GB za sekundu na každom jadre a existuje potenciál na zlepšenie. Niektoré režijné náklady mimo vnútornej slučky môžeme odstrániť a plánujeme experimentovať s vnútornou slučkou v jazyku C namiesto Javy.
Využívame silu
Diskutovali sme, že vyhľadávanie v logoch môže byť realizované 'hrubo', ale koľko 'sily' máme? Nie je to málo.
1 jadro: Pri správnom použití je jedno jadro moderného procesora celkom výkonné samo o sebe.
8 jadier: V súčasnosti pracujeme na serveroch Amazon hi1.4xlarge a i2.4xlarge SSD, z ktorých každý má 8 jadier (16 vláken). Ako už bolo spomenuté, tieto jadrá sú zvyčajne zaneprázdnené pozadím operácií. Keď používateľ vykoná vyhľadávanie, pozadie operácie sú pozastavené, čím sa oslobodia všetky 8 jadier na vyhľadávanie. Vyhľadávanie sa zvyčajne dokončí za zlomok sekundy, po čom sa pozadová práca obnoví (program regulátor zabezpečuje, že nápor vyhľadávacích požiadaviek nebráni dôležitej pozadovej práci).
16 jadier: Pre spoľahlivosť organizujeme servery do skupín master/slave. Každý master má pod sebou jeden SSD server a jeden EBS. Ak hlavný server zlyhá, SSD server okamžite preberá jeho úlohu. Takmer po celú dobu master a slave fungujú normálne, takže každý blok dát je dostupný na vyhľadávanie na dvoch rôznych serveroch (podriadený EBS server má slabý procesor, takže ho nezohľadňujeme). Úlohu delíme medzi nimi, takže máme celkom 16 jadier.
Veľa jadier: V najbližšej budúcnosti rozdelíme dáta medzi servery tak, aby všetky sa podieľali na spracovaní každého netriviálneho požiadavku. Bude pracovať každé jadro. [Poznámka: implementovali sme plán a zvýšili rýchlosť vyhľadávania na 1 TB/s, pozri poznámku na konci článku].
Jednoduchosť zabezpečuje spoľahlivosť
Ďalšou výhodou metódy hrubej sily je pomerne stabilný výkon. Vo všeobecnosti nie je vyhľadávanie príliš citlivé na detaily úlohy a dátového súboru (myslím, že preto sa to nazýva 'hrubé').
Index kľúčových slov niekedy poskytuje neuveriteľne rýchle výsledky, ale inokedy nie. Predpokladajme, že máte 50 GB logov, v ktorých sa termín ‘customer_5987235982’ vyskytuje presne trikrát. Vyhľadávanie tohto termínu priamo z indexu nájde tri umiestnenia a skončí sa okamžite. Ale zložitý vyhľadávanie s wildcard znakmi môže prehľadávať tisíce kľúčových slov a trvať dlhší čas.
Na druhej strane, vyhľadávanie metódou hrubej sily pre akýkoľvek dotaz sa vykonáva s viac-menej rovnakou rýchlosťou. Vyhľadávanie dlhých slov je lepšie, ale aj hľadanie jedného znaku prebieha dostatočne rýchlo.
Jednoduchosť metódy hrubej sily znamená, že jej výkon sa blíži teoretickému maximu. Tu je menej možností pre nepredvídané preťaženie diskov, konflikty pri zámkach, svižnosť ukazovateľa a tisíce iných dôvodov pre zlyhania. Práve som sa pozrel na požiadavky, ktoré uskutočnili používatelia Scalyr minulý týždeň na našom najvyťaženejšom serveri. Bolo zaznamenaných 14 000 požiadaviek. Presne osem z nich trvalo viac ako jednu sekundu; 99 % bolo vykonaných v rámci 111 milisekúnd (ak ste nepoužívali nástroje na analýzu logov, verte mi: to je rýchlo).
Stabilný a spoľahlivý výkon je dôležitý pre užívateľské pohodlie služby. Ak občas spomaľuje, používatelia ho budú považovať za nespoľahlivý a neochotne ho používať.
Vyhľadávanie po logoch v akcii
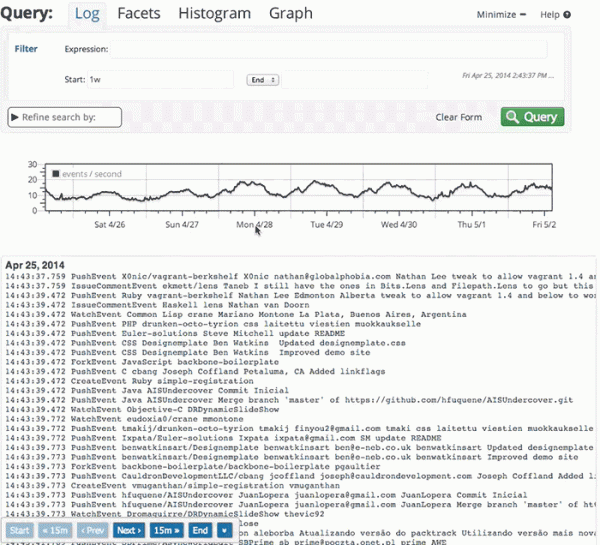
Tu je malá animácia, ktorá ukazuje, ako funguje vyhľadávanie Scalyr. Máme demo účet, kam importujeme každú udalosť zo všetkých verejných repozitárov Github. V tejto demonštrácii skúmam údaje za týždeň: približne 600 MB nezpracovaných logov.
Video je nahrávané naživo, bez špeciálnej prípravy, na mojom desktop počítači (asi 5000 kilometrov od servera). Výkon, ktorý uvidíte, je do značnej miery zaslúžený , ako aj rýchlemu a spoľahlivému backendu. Kedykoľvek nastane pauza bez indikátora ‘loading’, robím pauzu, aby ste mali čas prečítať si, čo idete kliknúť.
Na záver
Pri spracovávaní veľkých objemov dát je dôležité vybrať dobrý algoritmus, ale „dobrý“ neznamená „excentrický“. Zamyslite sa nad tým, ako bude váš kód fungovať v praxi. Niektoré faktory, ktoré môžu mať veľký význam v reálnom svete, vypadávajú z teoretickej analýzy algoritmov. Jednoduchšie algoritmy sa ľahšie optimalizujú a sú stabilnejšie v hraničných situáciách.
Zvážte aj kontext, v ktorom bude kód vykonávaný. V našom prípade potrebujeme dostatočne výkonné servery na správu pozadí úloh. Používatelia relatívne zriedkavo iniciujú vyhľadávanie, preto si môžeme na krátke obdobie požičať celú skupinu serverov potrebných na vykonanie každého vyhľadávania.
Metódou hrubej sily sme implementovali rýchle, spoľahlivé a flexibilné vyhľadávanie v súbore logov. Dúfame, že tieto nápady budú užitočné pre vaše projekty.
Úprava: názov a text boli zmenené z „Vyhľadávanie pri rýchlosti 20 GB za sekundu“ na „Vyhľadávanie pri rýchlosti 1 TB za sekundu“, aby odrážali zvýšenie výkonu za posledných niekoľko rokov. To zvýšenie rýchlosti súvisí predovšetkým so zmenou typu a počtu serverov EC2, ktoré dnes nasadzujeme na obsluhu rozšírenej zákazníckej základne. V blízkej budúcnosti sa očakávajú zmeny, ktoré zabezpečia ďalšie výrazné zvýšenie efektivity a tešíme sa, keď budeme mať možnosť o tom informovať.
Zdroj: habr.com
