

Pred šiestimi mesiaci — verejný na PostgreSQL.
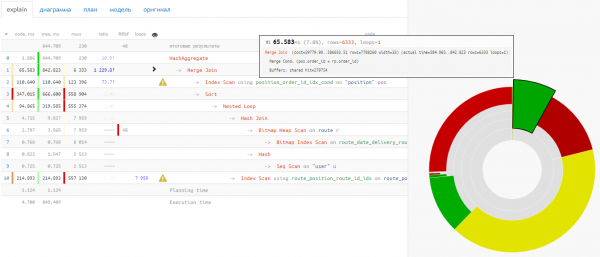
Za uplynulé mesiace sme vytvorili správu o ňom , pripravili sme zhrňujúci na základe odporúčaní, ktoré poskytuje... ale najdôležitejšie je, že sme zbierali vaše názory a sledovali reálne použitie.
A teraz sme pripravení povedať o nových možnostiach, ktoré môžete využívať.
Podpora rôznych formátov plánov
Plán z logu spolu so žiadosťou
Priamo z konzoly vyberáme celý blok, začínajúc riadkom s Text dotazu, so všetkými vedúcimi medzerami:
        Text dotazu: INSERT INTO dicquery_20200604 VALUES ($1.*) ON CONFLICT (query)
                           DO NOTHING;
        Insert on dicquery_20200604 (cost=0.00..0.05 rows=1 width=52) (actual time=40.376..40.376 rows=0 loops=1)
          Conflict Resolution: NOTHING
          Conflict Arbiter Indexes: dicquery_20200604_pkey
          Tuples Inserted: 1
          Conflicting Tuples: 0
          Buffers: shared hit=9 read=1 dirtied=1
          ->  Result (cost=0.00..0.05 rows=1 width=52) (actual time=0.001..0.001 rows=1 loops=1)
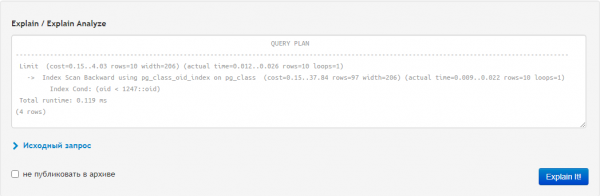
… a vložíme všetko skopírované priamo do poľa pre plán, nič neoddeľujeme:
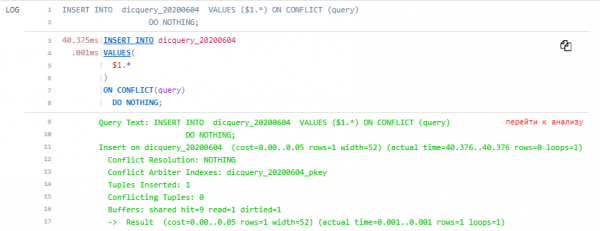
Na výstupe dostaneme k rozobratému plánu ešte aj záložku „kontext“, kde je náš dotaz prezentovaný v celej svojich krásach:
JSON a YAML
EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON)
SELECT * FROM pg_class;
"[
{
"Plan": {
"Node Type": "Seq Scan",
"Parallel Aware": false,
"Relation Name": "pg_class",
"Alias": "pg_class",
"Startup Cost": 0.00,
"Total Cost": 1336.20,
"Plan Rows": 13804,
"Plan Width": 539,
"Actual Startup Time": 0.006,
"Actual Total Time": 1.838,
"Actual Rows": 10266,
"Actual Loops": 1,
"Shared Hit Blocks": 646,
"Shared Read Blocks": 0,
"Shared Dirtied Blocks": 0,
"Shared Written Blocks": 0,
"Local Hit Blocks": 0,
"Local Read Blocks": 0,
"Local Dirtied Blocks": 0,
"Local Written Blocks": 0,
"Temp Read Blocks": 0,
"Temp Written Blocks": 0
},
"Planning Time": 5.135,
"Triggers": [
],
"Execution Time": 2.389
}
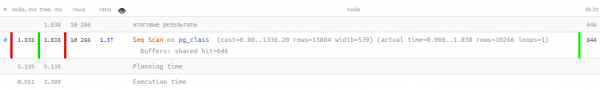
]"Bez ohľadu na to, či sú vonkajšie úvodzovky, ako kopíruje pgAdmin, alebo nie — hádžeme do toho istého poľa, na výstupe — krása:
Rozšírená vizualizácia
Planning Time / Execution Time
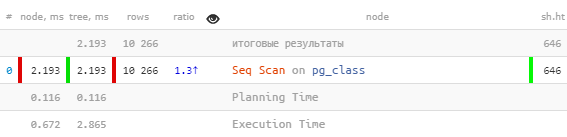
Teraz je lepšie vidieť, kam sa odhaduje dodatočný čas pri vykonávaní dotazu:
I/O Timing
Niekedy sa stretáme so situáciou, kedy sa v pláne akoby nečítalo-nezapisovalo príliš veľa zdrojov, ale čas vykonania je neprimerane dlhý.
Tu musíme povedať: "Ach, pravdepodobne bol v tom okamihu disk na serveri príliš preťažený, preto sa čítalo tak dlho!" Ale to nie je veľmi presné...
Ale môžeme to určiť absolútne presne. Ide o to, že medzi možnosťami konfigurácie PG-servera existuje :
Zahŕňa meranie času vstupno/výstupných operácií. Tento parameter je predvolene vypnutý, pretože na to je potrebné neustále sa pýtať na aktuálny čas operačného systému, čo môže významne spomaliť výkon na niektorých platformách. Na vyhodnotenie nákladov merania času na vašej platforme môžete využiť nástroj pg_test_timing. Štatistiku vstupno/výstupných operácií môžete získať cez pohľad pg_stat_database, v výstupe EXPLAIN (keď je použitý parameter BUFFERS) a cez pohľad pg_stat_statements.
Tento parameter môžete aktivovať aj v rámci lokálnej relácie:
SET track_io_timing = TRUE;A teraz to najpríjemnejšie - naučili sme sa chápavať a zobrazovať tieto údaje so zohľadnením všetkých transformácií vykonávacieho stromu:
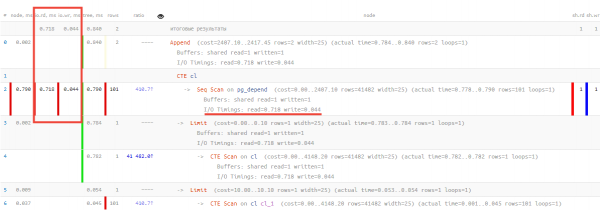
Tu si môžete všimnúť, že z 0,790 ms celkového času vykonávania 0,718 ms trvalo čítanie jednej stránky údajov, 0,044 ms - jej zápis, a na všetku ostatnú užitočnú aktivitu bolo vynaložených len 0,028 ms!
Budúcnosť s PostgreSQL 13
Úplný prehľad noviniek si môžete pozrieť , a my sa konkrétne zaoberáme zmenami v plánoch.
Plánovanie buffrov
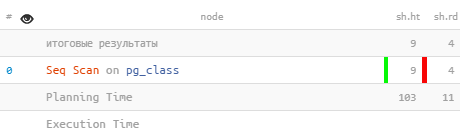
Zohľadnenie zdrojov priradených plánovaču sa odrazilo ešte v jednom patche, ktorý sa netýka pg_stat_statements. EXPLAIN s voľbou BUFFERS bude uvádzať počet buffrov použitých počas plánovania:
 Seq Scan na pg_class (skutočné riadky=386 slučky=1)
   Buffery: zdieľané hit=9 prečítané=4
 Čas plánovania: 0,782 ms
   Buffery: zdieľané hit=103 prečítané=11
 Čas vykonávania: 0,219 ms
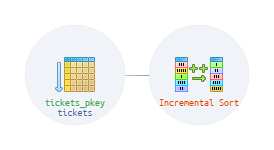
Inkrementálne triedenie
V prípadoch, keď je potrebné triedenie podľa mnohých kľúčov (k1, k2, k3…), plánovač teraz môže využiť vedomosť o tom, že údaje sú už triedené podľa niekoľkých z prvých kľúčov (napríklad k1 a k2). V takom prípade nie je potrebné znovu triediť všetky údaje, ale možno ich rozdeliť na postupné skupiny so shodnými hodnotami k1 a k2, a "dotridit" podľa kľúča k3.
Tak sa celkové triedenie rozpadá na niekoľko postupných triedení menšieho rozsahu. To znižuje objem potrebnej pamäte, a navyše umožňuje vydávať prvé údaje skôr, než bude celé triedenie dokončené.
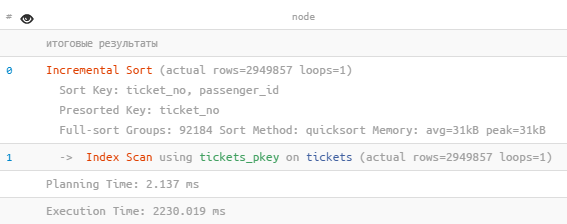
 Inkrementálne triedenie (skutočné riadky=2,949,857 slučky=1)
   Triediaci kľúč: ticket_no, passenger_id
   Predtriedený kľúč: ticket_no
   Plné triediace skupiny: 92,184 Triediaca metóda: quicksort Pamäť: priemer=31kB vrchol=31kB
   ->  Index Scan pomocou tickets_pkey na lístkoch (skutočné riadky=2,949,857 slučky=1)
 Čas plánovania: 2,137 ms
 Čas vykonávania: 2230,019 ms
Vylepšení UI/UX
Snímky obrazovky, sú všade!
Teraz sa na každej karte objavila možnosť rýchlo zobraziť snímku obrazovky záložky do schránky na celú šírku a hĺbku záložky — „terč“ vpravo hore:
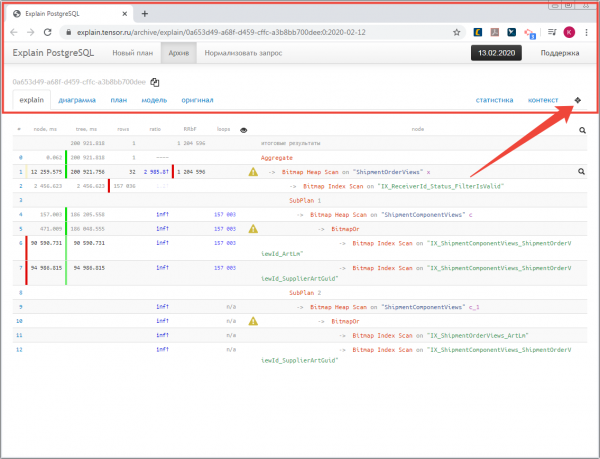
Svoje snímky pre túto publikáciu sme skutočne získali takto.
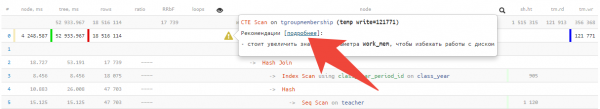
Odporúčania na uzloch
Nielenže ich pribudlo, ale o každom sa dá , prechodom na odkaz:
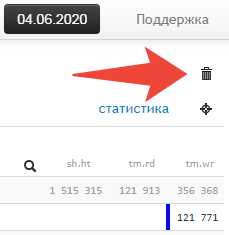
Odstránenie z archívu
Niektorí veľmi žiadali o pridanie možnosti odstraňovať „úplne“ aj nepublikované plány v archíve — prosím, stačí kliknúť na príslušnú ikonu:
No, a nezabúdame, že máme , kam môžete písať svoje pripomienky a návrhy.
Zdroj: habr.com
