

V priebehu svojej činnosti sa stretávam so situáciami, keď vývojár napíše dopyt a myslí si: "databáza je inteligentná, sama si poradí!"«
V niektorých prípadoch (čiastočne kvôli neznalosti možností DB, čiastočne kvôli predčasným optimalizáciám) tento prístup vedie k vzniku „frankensteinov“.
Najprv uvediem príklad takého dopytu:
-- pre každý kľúčový pár nachádzame asociované hodnoty polí
WITH RECURSIVE cte_bind AS (
  SELECT DISTINCT ON (key_a, key_b)
    key_a a
  , key_b b
  , fld1 bind_fld1
  , fld2 bind_fld2
  FROM
    tbl
)
-- nachádzame min/max hodnoty pre každý prvý kľúč
, cte_max AS (
  SELECT
    a
  , max(bind_fld1) bind_fld1
  , min(bind_fld2) bind_fld2
  FROM
    cte_bind
  GROUP BY
    a
)
-- spájame podľa prvého kľúča kľúčové páry a min/max-hodnoty
, cte_a_bind AS (
  SELECT
    cte_bind.a
  , cte_bind.b
  , cte_max.bind_fld1
  , cte_max.bind_fld2
  FROM
    cte_bind
  INNER JOIN
    cte_max
      ON cte_max.a = cte_bind.a
)
SELECT * FROM cte_a_bind;
Aby sme mohli objektívne posúdiť kvalitu dopytu, vytvorme určitú náhodnú sadu údajov:
CREATE TABLE tbl AS
SELECT
  (random() * 1000)::integer key_a
, (random() * 1000)::integer key_b
, (random() * 10000)::integer fld1
, (random() * 10000)::integer fld2
FROM
  generate_series(1, 10000);
CREATE INDEX ON tbl(key_a, key_b);
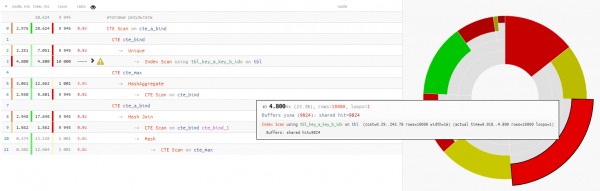
Ukazuje sa, že samotné čítať údaje trvalo menej ako štvrtinu celkového času vykonania dopytu:
Rozoberieme do detailov
Pozorne sa pozrieme na dopyt a zamyslíme sa:
- Prečo je tu WITH RECURSIVE, keď nie sú žiadne rekurzívne CTE?
- Prečo zhromažďovať min/max hodnoty v samostatnom CTE, keď sa neskôr aj tak viažu na pôvodný výber?
+25% času - Prečo na konci použiť opakované čítanie z predchádzajúceho CTE cez bezpodmienečný 'SELECT * FROM'?
+14% času
V tomto prípade sme sa ešte veľmi šťastne dostali k tomu, že bola zvolená Hash Join na spojenie, a nie Nested Loop, pretože inak by sme dostali nie jediné prechádzanie CTE Scan, ale 10K!
trochu o CTE ScanTu je potrebné si pripomenúť, že CTE Scan je ekvivalentom Seq Scan — takže žiadna indexácia, iba celkové prehľadávanie, ktoré by si vyžiadalo 10K x 0.3ms = 3000ms pri cykloch cez cte_max alebo 1K x 1.5ms = 1500ms pri cykloch cez cte_bind!
Vlastne, čo sme chceli získať ako výsledok? Aha, obyčajne sa takáto otázka objaví okolo piatej minúty analyzovania „trojposchodových“ dopytov.
Chceli sme pre každý unikátny kľúčový pár zobraziť min/max z skupiny podľa key_a.
Tak to využijeme :
SELECT DISTINCT ON(key_a, key_b)
	key_a a
,	key_b b
,	max(fld1) OVER(w) bind_fld1
,	min(fld2) OVER(w) bind_fld2
FROM
	tbl
WINDOW
w AS (PARTITION BY key_a); 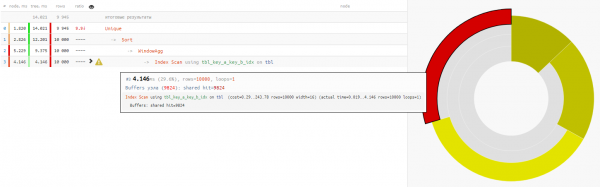
Keďže čítanie údajov v oboch variantoch trvá približne rovnako 4-5 ms, náš časový zisk je -32% — v čistej forme zaťaženie, ktoré bolo odstránené z CPU databázy, ak sa takýto dotaz vykonáva dostatočne často.
Celkovo by ste nemali nútiť databázu vykonávať "kruhové prevádzanie = nosenie, štvorcové = kotúľanie".
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish