

Dnes nebudeme mať žiadne zložité prípady a zložitých algoritmov v SQL. Všetko bude veľmi jednoduché, na úrovni Kapitána Zjavnosť — robíme prezeranie registra udalostí so zoradením podľa času.
To znamená, že v databáze máme tabuľku events, a má pole ts — presne ten čas, podľa ktorého chceme tieto záznamy usporiadať:
CREATE TABLE events(
  id
    serial
      PRIMARY KEY
, ts
    timestamp
, data
    json
);

CREATE INDEX ON events(ts DESC);
Je jasné, že záznamov tam bude viac než desať, preto budeme potrebovať nejaký typ stránkovej navigácie.
#0. «Я у мамы погроммист»
cur.execute("SELECT * FROM events;")
rows = cur.fetchall();
rows.sort(key=lambda row: row.ts, reverse=True);
limit = 26
print(rows[offset:offset+limit]);
Takmer to nie je žart — zriedka, ale stáva sa to v divokej prírode. Niekedy po práci s ORM je ťažké prepnúť na "priamu" prácu s SQL.
Ale poďme prejsť k bežnejším a menej zjavnými problémom.
#1. OFFSET
SELECT
  ...
FROM
  events
ORDER BY
  ts DESC
LIMIT 26 OFFSET $1; -- 26 - záznamov na stránke, $1 - začiatok stránky
Kde sa vzalo číslo 26? Toto je približný počet záznamov na vyplnenie jedného displeja. Presnejšie, 25 zobrazovaných záznamov, plus 1, signalizujúca, že v danej vzorke je niečo ďalej a dáva zmysel pokračovať.
Samozrejme, túto hodnotu nie je potrebné "vtesnávať" do tela požiadavky, ale predávať cez parameter. V tomto prípade plánovač PostgreSQL však nemôže vychádzať z poznania, že záznamov by malo byť relatívne málo — a ľahko si zvolí neefektívny plán.
A kým v rozhraní aplikácie je prezeranie registra realizované ako prepínanie medzi vizuálnymi „stranami“, nikto si dlhšie nič podozrivé nevšimne. Presne do okamihu, keď sa v boji za pohodlie UI/UX rozhodnú pre redesign rozhrania na „nekonečné rolovanie“ — to znamená, že všetky záznamy registra sú zobrazené ako jedinečný zoznam, ktorý si používateľ môže rolovať hore-dole.
A tak, pri ďalšom testovaní vás chytia na duplicite záznamov v registri. Prečo, veď na tabuľke je normálny index (ts), na ktorý sa spolieha váš dopyt?
Práve preto, že ste nezohľadnili, že ts nie je unikátnym kľúčom v tejto tabuľke. Vlastne, ani hodnoty nie sú jedinečné, ako pri každom „čase“ v reálnych podmienkach — preto sa tá istá položka v dvoch susedných dotazoach ľahko „preskočí“ zo stránky na stránku vďaka inému konečnému poradiu v rámci triedenia rovnakých hodnôt kľúča.
V skutočnosti sa tu ukrýva ešte aj druhý problém, ktorý si všimnúť je oveľa ťažšie — niektoré položky nebudú zobrazené vôbec! Veď „zdvojené“ položky zaberú niekoho miesto. Podrobné vysvetlenie s peknými obrázkami môžete .
Rozširujeme index
Šikovný vývojár chápe — je potrebné urobiť kľúč indexu jedinečným, a najjednoduchší spôsob — rozšíriť ho zjavne jedinečným poľom, ktorým môže byť PK:
CREATE UNIQUE INDEX ON events(ts DESC, id DESC);A dotaz mutuje:
SELECT
  ...
ORDER BY
  ts DESC, id DESC
LIMIT 26 OFFSET $1;
#2. Переход на «курсоры»
Niekedy neskôr k vám príde DBA a „poteší“, že vaše dotazy , a vôbec, bolo by načase prejsť na navigáciu od poslednej zobrazené hodnoty. Váš dotaz opäť mutuje:
SELECT
  ...
WHERE
  (ts, id) < ($1, $2) -- posledné získané hodnoty z predchádzajúceho kroku
ORDER BY
  ts DESC, id DESC
LIMIT 26;
Úľavou ste si vzdychli, kým nenastalo...
#3. Чистка индексов
Pretože raz váš DBA prečítal a pochopil, že „neposledný“ timestamp — to nie je dobré. A opäť prišiel k vám — teraz s myšlienkou, že ten index by sa mal predsa len opäť premeniť na (ts DESC).
Ale čo robiť s pôvodným problémom „skakania“ položiek medzi stránkami?.. A všetko je jednoduché — treba vyberať bloky s nefixovaným počtom položiek!
Vôbec, kto nám zakazuje čítať nie „presne 26“, ale „aspoň 26“? Napríklad tak, aby v nasledujúcom bloku sa objavili položky so zjavne inými hodnotami ts — vtedy predsa ani nebude problém s „preskakovaním“ položiek medzi blokmi!
Takto to dosiahnuť:
SELECT
  ...
WHERE
  ts = coalesce((
    SELECT
      ts
    FROM
      events
    WHERE
      ts < $1
    ORDER BY
      ts DESC
    LIMIT 1 OFFSET 25
  ), '-infinity')
ORDER BY
  ts DESC;
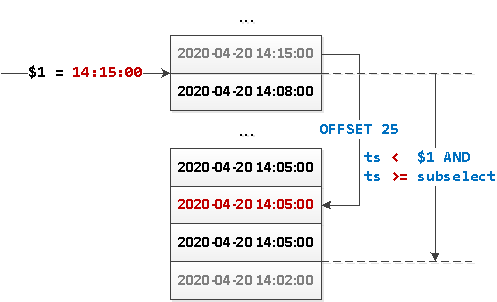
Čo sa tu vlastne deje?
- Krokujeme o 25 položiek „dole“ a získavame „hraničnú“ hodnotu
ts. - Ak tam už nič nie je, tak nahrádzame NULL-hodnotu na
-infinity. - Odcítame celý segment hodnôt medzi získanou hodnotou
tsa odovzdaným parametrom z rozhrania $1 (predchádzajúcou „poslednou“ hodnotou zobrazenou). - Ak blok vrátil menej ako 26 záznamov, je posledný.
Alebo to isté obrázkom:
Pretože teraz máme výber nemá žiadny konkrétny "začiatok", nič nám teda nebráni "rozvinúť" tento dopyt na opačnú stranu a implementovať dynamické načítanie blokov dát od "referenčného bodu" oboma smermi — ako nadol, tak aj nahor.
Poznámka
- Áno, v takom prípade sa odkazujeme na index dvakrát, ale všetko je "čisto po indexe". Preto vnorený dopyt prinesie len jedno ďalšie Index Only Scan..
- Je dostatočne zrejmé, že túto metodiku môžete používať len vtedy, keď máte hodnoty
tsktoré sa môžu prekrývať len náhodne, a je ich málo.. Ak je však váš typický prípad "milión záznamov v 00:00:00.000", tak to nerobte. Tým myslím, že by ste nemali dovoliť takýto prípad. Ale ak to tak už vyšlo, použite možnosť s rozšíreným indexom.
Zdroj: habr.com
