

Pokračujeme v sérii článkov, zameraných na prieskum menej známych spôsobov, ako zlepšiť výkon „na pohľad jednoduchých“ dopytov v PostgreSQL:
Nemyslite si, že až tak nenávidím JOIN… 🙂
Ale často je dopyt bez neho citelne výkonnejší ako s ním. Takže dnes sa pokúsime úplne zbaviť sa náročného JOIN — pomocou slovníka.
Začínajúc od PostgreSQL 12, časť nižšie popísaných situácií sa môže správať mierne inak kvôli . Toto správanie sa môže vrátiť do predchádzajúceho stavu pomocou zadaného kľúča
MATERIALIZED.
Veľa „faktov“ o obmedzenom slovníku
Poďme vziať úplne reálnu aplikovanú úlohu — musíme získať zoznam alebo aktívnych úloh so zadávateľmi:
25.01 | Ivanov I.I. | Pripraviť popis nového algoritmu.
22.01 | Ivanov I.I. | Napísať článok na Habr: život bez JOIN.
20.01 | Petrov P.P. | Pomôcť optimalizovať dopyt.
18.01 | Ivanov I.I. | Napísať článok na Habr: JOIN so zohľadnením distribúcie údajov.
16.01 | Petrov P.P. | Pomôcť optimalizovať dopyt.
V abstraktnom svete by autori úloh mali byť rovnomerne rozdelení medzi všetkých zamestnancov našej organizácie, ale v skutočnosti úlohy prichádzajú zvyčajne od pomerne obmedzeného množstva ľudí — „od nadriadených“ smerom nahor hierarchiou alebo „od kolegov“ z vedľajších oddelení (analytici, dizajnéri, marketing, …).
Predpokladajme, že v našej organizácii z 1000 ľudí len 20 autorov (zvyčajne ešte menej) zadáva úlohy každému konkrétnemu vykonávateľovi a , aby sme urýchlili „tradičný“ dopyt.
Generátor skriptov
-- zamestnanci
CREATE TABLE person AS
SELECT
  id
, repeat(chr(ascii('a') + (id % 26)), (id % 32) + 1) "name"
, '2000-01-01'::date - (random() * 1e4)::integer birth_date
FROM
  generate_series(1, 1000) id;

ALTER TABLE person ADD PRIMARY KEY(id);

-- úlohy s uvedeným rozdelením
CREATE TABLE task AS
WITH aid AS (
  SELECT
    id
  , array_agg((random() * 999)::integer + 1) aids
  FROM
    generate_series(1, 1000) id
  , generate_series(1, 20)
  GROUP BY
    1
)
SELECT
  *
FROM
  (
    SELECT
      id
    , '2020-01-01'::date - (random() * 1e3)::integer task_date
    , (random() * 999)::integer + 1 owner_id
    FROM
      generate_series(1, 100000) id
  ) T
, LATERAL(
    SELECT
      aids[(random() * (array_length(aids, 1) - 1))::integer + 1] author_id
    FROM
      aid
    WHERE
      id = T.owner_id
    LIMIT 1
  ) a;

ALTER TABLE task ADD PRIMARY KEY(id);
CREATE INDEX ON task(owner_id, task_date);
CREATE INDEX ON task(author_id);
Zobrazíme posledných 100 úloh pre konkrétneho vykonávateľa:
SELECT
  task.*
, person.name
FROM
  task
LEFT JOIN
  person
    ON person.id = task.author_id
WHERE
  owner_id = 777
ORDER BY
  task_date DESC
LIMIT 100; 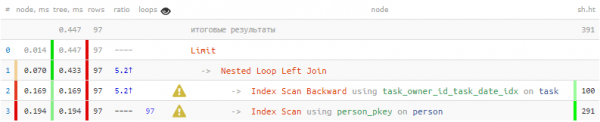
Z toho vyplýva, že 1/3 celkového času a 3/4 čítaní údajových stránok bolo vytvorených len na to, aby sme 100-krát hľadali autora — pre každú zobrazovanú úlohu. Ale vieme, že z týchto sto je iba 20 rôznych — či by sa toto poznanie nedalo využiť?
hstore-slovník
Využijeme na generovanie „slovníka“ kľúč-hodnota:
CREATE EXTENSION hstoreDo slovníka nám stačí vložiť ID autora a jeho meno, aby sme neskôr mohli extrahovať podľa tohto kľúča:
-- vytvoríme cieľový výber
WITH T AS (
  SELECT
    *
  FROM
    task
  WHERE
    owner_id = 777
  ORDER BY
    task_date DESC
  LIMIT 100
)
-- vytvoríme slovník pre jedinečné hodnoty
, dict AS (
  SELECT
    hstore( -- hstore(keys::text[], values::text[])
      array_agg(id)::text[]
    , array_agg(name)::text[]
    )
  FROM
    person
  WHERE
    id = ANY(ARRAY(
      SELECT DISTINCT
        author_id
      FROM
        T
    ))
)
-- získame súvisiace hodnoty slovníka
SELECT
  *
, (TABLE dict) -> author_id::text -- hstore -> kľúč
FROM
T; 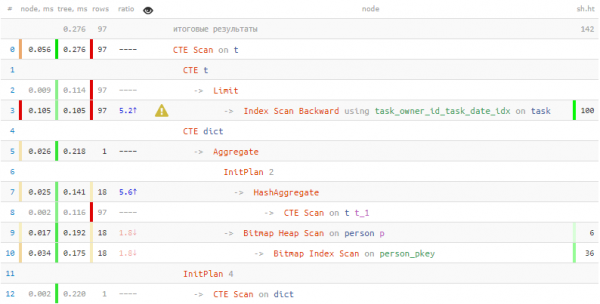
Na získanie informácií o osobách bolo vynaložené dvakrát menej času a sedemkrát menej prečítaných dát! Okrem „oslovarovania“, týchto výsledkov nám pomohlo dosiahnuť aj hromadné vyhľadávanie záznamov z tabuľky na jedinom prechode pomocou = ANY(ARRAY(...)).
Záznamy tabuľky: serializácia a deserializácia
Ale čo robiť, ak potrebujeme uložiť do slovníka nielen jedno textové pole, ale celú záznam? V takom prípade nám pomôže schopnosť PostgreSQL pracovať so záznamom tabuľky ako s jednou hodnotou:
...
, dict AS (
  SELECT
    hstore(
      array_agg(id)::text[]
    , array_agg(p)::text[] -- mágia #1
    )
  FROM
    person p
  WHERE
    ...
)
SELECT
  *
, (((TABLE dict) -> author_id::text)::person).* -- mágia #2
FROM
  T;
Poďme sa pozrieť, čo sa tu vlastne dialo:
- Vzali sme p ako alias k plnému zapisu tabuľky person a zozbierali z nich pole.
- Tento pole záznamov sme pretypovali do poľa textových reťazcov (person[]::text[]), aby sme ho umiestnili do hstore-slovníka ako pole hodnôt.
- Pri získavaní súvisiaceho záznamu sme ho vybrali zo slovníka podľa kľúča ako textový reťazec.
- Text musíme premeniť na hodnotu typu tabuľky person (pre každú tabuľku sa automaticky vytvára rovnomený typ).
- „Rozvinuli“ typizovaný záznam do stĺpcov pomocou
(...).*.
json-slovník
Ale taký trik, aký sme použili vyššie, neprejde, ak neexistuje zodpovedajúci tabuľkový typ, aby sme mohli urobiť „pretypovanie“. Presne taká istá situácia nastane, ak sa ako zdroj údajov pre serializáciu pokúsime použiť reťazec CTE, a nie „reálnu“ tabuľku.
V takom prípade nám pomôžu :
...
, p AS ( -- to už je CTE
  SELECT
    *
  FROM
    person
  WHERE
    ...
)
, dict AS (
  SELECT
    json_object( -- teraz to už je json
      array_agg(id)::text[]
    , array_agg(row_to_json(p))::text[] -- a vo vnútri json pre každý riadok
    )
  FROM
    p
)
SELECT
  *
FROM
  T
, LATERAL(
    SELECT
      *
    FROM
      json_to_record(
        ((TABLE dict) ->> author_id::text)::json -- vytiahli sme zo slovníka ako json
      ) AS j(name text, birth_date date) -- vyplnili potrebnú štruktúru
  ) j;
Treba poznamenať, že pri popise cieľovej štruktúry môžeme uvádzať nie všetky polia pôvodného reťazca, ale len tie, ktoré naozaj potrebujeme. Ak však máme „domovskú“ tabuľku, je lepšie využiť funkciu json_populate_record.
Prístup k slovníku máme aj naďalej jednorazový, ale náklady na json-[de]serializáciu sú dosť vysoké, preto je rozumné tento spôsob používať iba v niektorých prípadoch, keď „čestný“ CTE Scan sa osvedčuje horšie.
Testujeme výkonnosť
Tak sme získali dva spôsoby serializácie údajov do slovníka — hstore / json_object. Okrem toho samotné polia kľúčov a hodnôt môžeme vytvoriť taktiež dvoma spôsobmi, s vnútornou alebo vonkajšou konverziou na text: array_agg(i::text) / array_agg(i)::text[].
Skontrolujme efektívnosť rôznych druhov serializácie na čisto syntetickom príklade — serializujeme rôzne množstvo kľúčov:
WITH dict AS (
  SELECT
    hstore(
      array_agg(i::text)
    , array_agg(i::text)
    )
  FROM
    generate_series(1, ...) i
)
TABLE dict;
Oceňovací skript : serializácia
S T AS (
  SELECT
    *
  , (
      SELECT
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::real et
      FROM
        (
          SELECT
            array_agg(el) ea
          FROM
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              WITH dict AS (
                SELECT
                  hstore(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                FROM
                  generate_series(1, $$ || (1 << v) || $$) i
              )
              TABLE dict
            $$) T(el text)
        ) T
    ) et
  FROM
    generate_series(0, 19) v
  ,   LATERAL generate_series(1, 7) i
  ORDER BY
    1, 2
)
SELECT
  v
, avg(et)::numeric(32,3)
FROM
  T
GROUP BY
  1
ORDER BY
1; 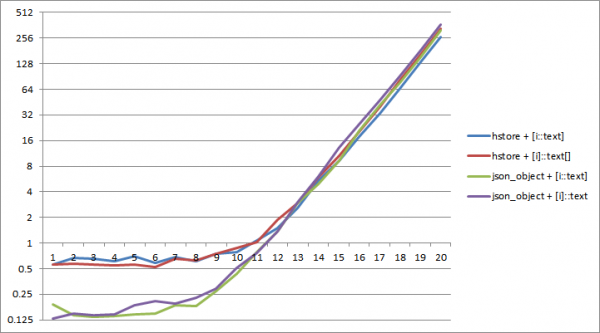
Na PostgreSQL 11 približne do veľkosti slovníka 2^12 kľúčov serializácia do json si vyžaduje menej času. Najefektívnejšia je kombinácia json_object a „interného“ premenovania typov array_agg(i::text).
Teraz skúsme prečítať hodnotu každého kľúča 8-krát — veď ak sa k slovníku nebudeme obracať, tak načo nám je?
Odhadovací skript : čítanie zo slovníka
S T AS (
  SELECT
    *
  , (
      SELECT
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::real et
      FROM
        (
          SELECT
            array_agg(el) ea
          FROM
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              WITH dict AS (
                SELECT
                  json_object(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                FROM
                  generate_series(1, $$ || (1 < (i % ($$ || (1 << v) || $$) + 1)::text
              FROM
                generate_series(1, $$ || (1 << (v + 3)) || $$) i
            $$) T(el text)
        ) T
    ) et
  FROM
    generate_series(0, 19) v
  , LATERAL generate_series(1, 7) i
  ORDER BY
    1, 2
)
SELECT
  v
, avg(et)::numeric(32,3)
FROM
  T
GROUP BY
  1
ORDER BY
1; 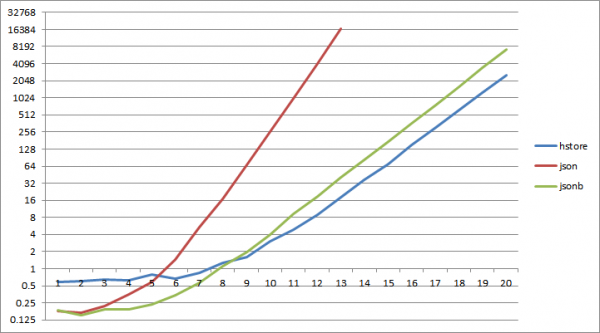
A… už približne pri 2^6 kľúčoch čítanie zo json-slovníka začne výrazne zaostávať za čítaním z hstore, pre jsonb to isté nastáva pri 2^9.
Záverečné závery:
- ak treba urobiť JOIN s viackrát opakovanými záznamami — je lepšie použiť „odoslovarovanie“ tabuľky
- ak váš slovník je očakávane malý a budete z neho čítať len trochu — môžete použiť json[b]
- vo všetkých ostatných prípadoch hstore + array_agg(i::text) bude efektívnejšie
Zdroj: habr.com
