

Ponúkam na oboznámenie sa s prepisom výkladu z januára 2016 od Vladimíra Sitnikova "PostgreSQL a JDBC – vyžmýkame všetko"
Dobrý deň! Volám sa Vladimír Sitnikov. Pracujem 10 rokov vo firme NetCracker. Hlavne sa zaoberám výkonom. Všetko, čo súvisí s Javou, všetko, čo súvisí so SQL – to je to, čo mám rád.
A dnes vám poviem o tom, s čím sme sa v spoločnosti stretli, keď sme začali používať PostgreSQL ako databázový server. A väčšinou pracujeme s Javou. Ale to, o čom dnes hovorím, nesúvisí len s Javou. Ako prax ukázala, objavuje sa to aj v iných jazykoch.
Budeme hovoriť o:
- výbere údajov.
- Uložení údajov.
- A taktiež o výkone.
- A o skrytých nástrahách, ktoré tam sú zakopané.
Začnime s jednoduchou otázkou. Vyberáme jeden riadok z tabuľky podľa primárneho kľúča.
Databáza sa nachádza na tom istom hostiteľovi. A celé toto trvá 20 milisekúnd.
Tých 20 milisekúnd je veľmi veľa. Ak máte takých 100 dopytov, tak miniete čas na sekundu na to, aby ste tieto dopyty spravili, t. j. premárnime čas.
Toto neradi robíme a sledujeme, čo nám ponúka databáza. Databáza nám ponúka dve možnosti vykonávania dopytov.
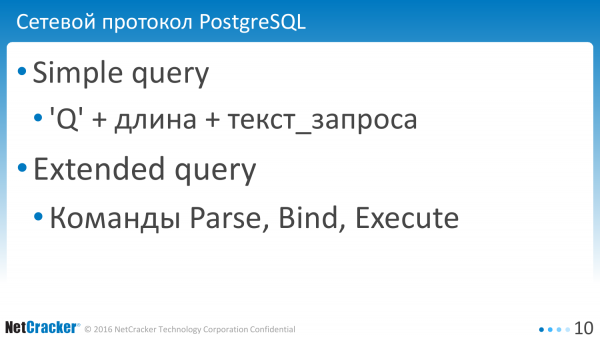
Prvá možnosť – to je jednoduchý dopyt. V čom je dobrý? V tom, že ho vezmeme a pošleme, a nič viac.
Databáza má ešte aj rozšírený dopyt, ktorý je rafinovanejší, ale funkčnejší. Môžete posielať dopyty na analýzu, vykonávanie, prepojenie premenných atď.
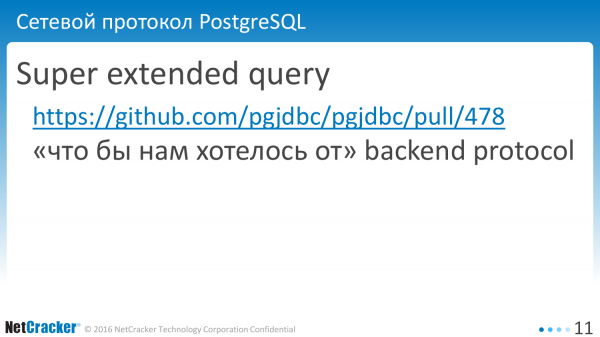
Super rozšírený dopyt – to je to, čo nebudeme pokrývať v aktuálnej prezentácii. Možno máme niečo, čo chceme od databázy, a existuje taký zoznam prianí, ktorý je v nejakom formáte formulovaný, t. j. to je to, čo chceme, ale momentálne a v najbližšom roku to nie je možné. Preto sme to jednoducho zapísali a budeme chodiť, aby sme presvedčili hlavných ľudí.
Ale to, čo môžeme urobiť, sú jednoduchý dopyt a rozšírený dopyt.
Aká je špecifikácia každého prístupu?
Jednoduchý dopyt je dobré použiť na jednorazové vykonanie. Raz ho vykonáte a zabudnete. Problém je, že nepodporuje binárny formát údajov, t. j. na niektoré vysoko výkonné systémy sa nehodí.
Rozšírené dopyty – šetria čas pri parsovaní. To je to, čo sme urobili a začali používať. Veľmi nám to pomohlo. Nie je to len úspora na parsovaní. Je aj úspora na prenosu dát. Prenášať dáta v binárnom formáte je oveľa efektívnejšie.
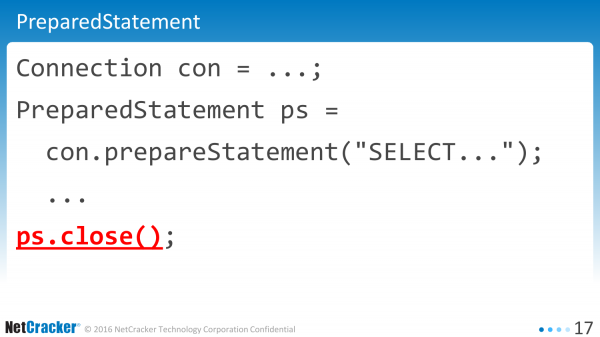
Prejdime k praxi. Takto vyzerá typická aplikácia. Môže to byť Java a podobne.
Vytvorili sme statement. Vykonali sme príkaz. Vytvorili sme close. Kde je tu chyba? Aký je problém? Žiadny problém. Tak je napísané vo všetkých knihách. Takto sa to má písať. Ak chcete maximálny výkon, píšte tak.
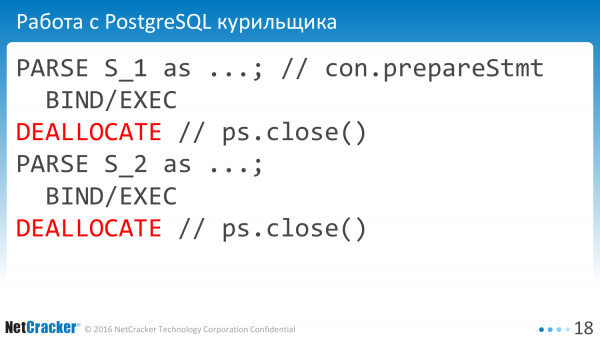
Ale prax ukázala, že to nefunguje. Prečo? Pretože máme metódu „close“. A keď to robíme takto, pre databázu to vyzerá – je to ako práca fajčiara s databázou. Povedali sme „PARSE EXECUTE DEALLOCATE“.
Prečo tieto zbytočné vytvorenia a uvoľnenie statements? Nikomu nie sú potrebné. Ale zvyčajne v PreparedStatement sa to tak deje, keď ich zatvárame, uzatvárajú všetko v databáze. To nie je to, čo chceme.
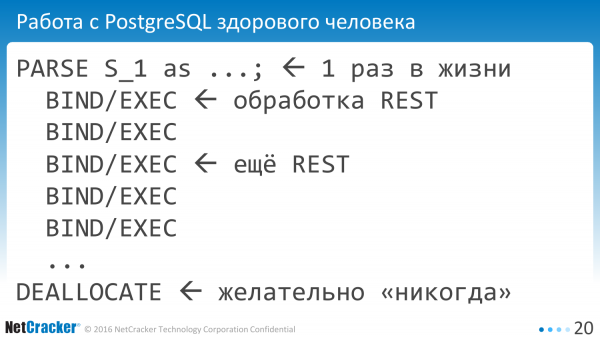
Chceme, aby sme s databázou pracovali ako zdraví ľudia. Jedenkrát sme vzali a pripravili náš statement, potom ho vykonávame mnohokrát. V skutočnosti mnohokrát – to je jedenkrát za celú existenciu aplikácie, kedy sme ho parsovali. A na rôznych REST používame ten istý statement id. Toto je náš cieľ.
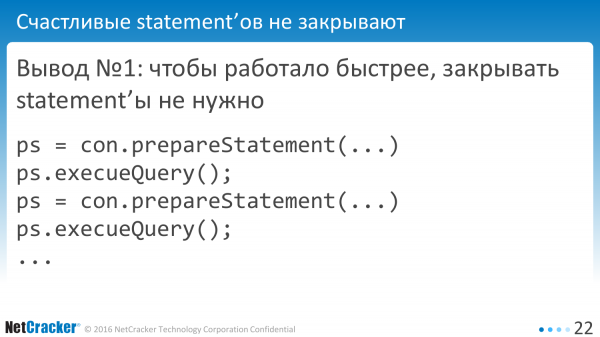
Ako to dosiahnuť?
Veľmi jednoducho – netreba zatvárať statements. Píšeme to takto: „prepare“ „execute“.
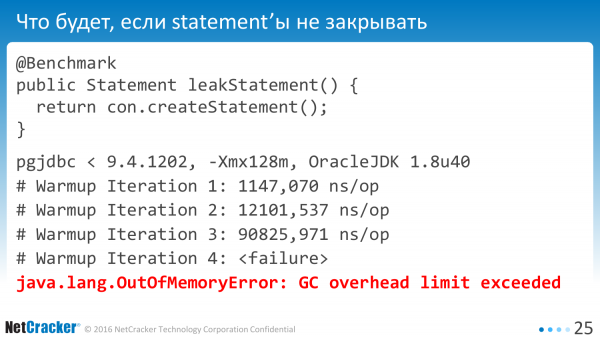
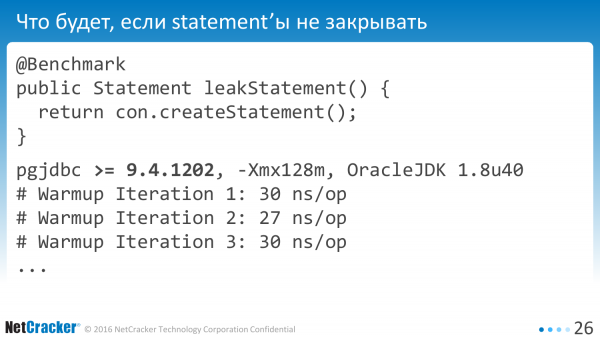
Ak spustíme niečo také, je jasné, že niekde niečo pretečie. Ak to nie je zrejmé, môžeme to zmerať. Vytvorme a napíšme benchmark, v ktorom máme takú jednoduchú metódu. Vytvoríme statement. Spustíme na určitej verzii ovládača a zistíme, že sa celkom rýchlo zrúti s celou pamäťou, ktorá sa nám stratila.
Je jasné, že takéto chyby sú ľahko opraviteľné. Nebudem o nich hovoriť. Ale poviem, že v novej verzii to funguje oveľa rýchlejšie. Metóda je bezvýznamná, ale aj tak.
Ako pracovať správne? Čo na to potrebujeme robiť?
V skutočnosti aplikácie vždy zatvárajú statements. Vo všetkých knihách sa píše, aby sme ich zatvárali, inak dôjde k úniku pamäti.
A PostgreSQL nevie cacheovať dopyty. Každá relácia si musí sama vytvoriť tento cache.
A nechceme ani strácať čas na parsovanie.
A ako obvykle máme dva varianty.
Prvá možnosť – vezmeme a povieme, že všetko zabalíme do PgSQL. Tam je cache. Všetko ukladá do cache. Bude to skvelé. Na toto sme sa už pozreli. Máme 100500 dopytov. Nepracuje to. Nesúhlasíme – ručne premieňať dopyty na procedúry. Nie-nie.
Máme druhú možnosť – vziať a sami to spraviť. Otvoríme zdrojové kódy a začneme kódovať. Kódujeme-kódujeme. Zistilo sa, že nie je tak ťažké to spraviť.
Objavilo sa to v auguste 2015. Teraz je to už modernejšia verzia. A všetko funguje skvele. Pracuje to tak dobre, že v aplikácii nič nemeníme. A dokonca sme prestali zvažovať PgSQL, t.j. to nám úplne stačilo na to, aby sme všetky vedľajšie náklady znížili takmer na nulu.
Príslušne sa Server-prepared statements aktivuje na 5. vykonaní, aby sa nestrácala pamäť v databáze na každý jednorazový dopyt.
Môžete sa opýtať – kde sú čísla? Čo dostanete? A tu vám čísla nedám, pretože pre každý dopyt sú svoje.
Mal som dopyty také, že na OLTP dopytoch sme míňali okolo 20 milisekúnd na parsovanie. Tam bolo 0,5 milisekundy na vykonanie, 20 milisekúnd na parsovanie. Dopyt – 10 KiB textu, 170 riadkov plánu. Toto je OLTP dopyt. Pýta 1, 5, 10 riadkov, niekedy viac.
Ale vôbec sme nechceli míňať 20 milisekúnd. Znížili sme to na 0. Všetko funguje skvele.
Čo si odtiaľto môžete vziať? Ak máte Java, zoberte modernú verziu ovládača a tešte sa.
Ak máte nejaký iný jazyk, zamyslite sa – možno to potrebujete aj vy? Pretože z pohľadu konečného jazyka, napríklad, ak je to PL 8 alebo máte LibPQ, tak vám nie je zrejmé, že míňate čas nie na vykonanie, ale na parsovanie a to stojí za to skontrolovať. Ako? Všetko zadarmo.
Okrem toho, že sú tam chyby, nejaké špecifiká. A práve o nich budeme teraz hovoriť. Veľká časť bude o priemyselnej archeológii, o tom, čo sme našli, na čo sme narazili.
Ak je dopyt generovaný dynamicky. To sa stáva. Niekto reťazí riadky, vzniká SQL dopyt.
Čím je zlý? Je zlý tým, že každý raz máme nakoniec inú reťazec.
A aj tento rôzny riadok je potrebné znovu spočítať hashCode. Je to naozaj CPU úloha – nájsť dlhý text dotazu v existujúcom hashi nie je jednoduché. Preto je výstup jednoduchý – nevytvárajte dotazy. Uložte ich do jednej premennej. A radujte sa.
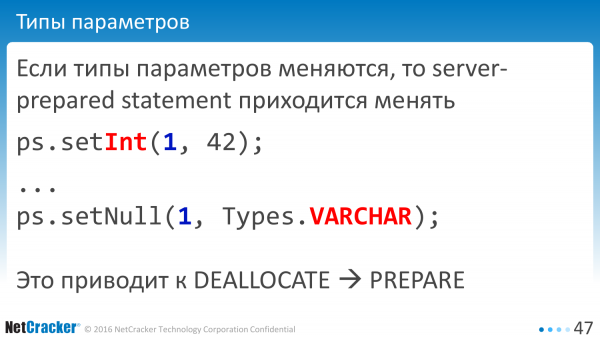
Nasledujúci problém. Typy údajov sú dôležité. Existujú ORM, ktoré tvrdia, že na akýkoľvek NULL nezáleží, nech je akýkoľvek. Ak je to Int, povedzme setInt. A ak je NULL, tak nech je vždy VARCHAR. A aký je vlastne rozdiel, či je tam NULL? Databáza to sama pochopí. A takáto predstava nefunguje.
V praxi databáze naozaj nezáleží. Ak ste po prvýkrát povedali, že to máte ako číslo, a druhýkrát ste povedali, že je to VARCHAR, nie je možné znovu použiť Server-prepared statements. A v takom prípade musíme náš statement znovu vytvoriť.
Ak vykonávate ten istý dotaz, dbajte na to, aby ste nemali pomiešané typy údajov v stĺpci. Je potrebné dávať pozor na NULL. To je častá chyba, ktorú sme mali po tom, čo sme začali používať PreparedStatements.
Dobre, zapli sme to. Zobrali sme, možno, ovládač. A výkon klesol. Všetko sa zhoršilo.
Ako to môže byť? Je to chyba alebo funkcia? Bohužiaľ, nedokázal som zistiť – či je to chyba alebo funkcia. Ale je tu celkom jednoduchý scenár, ako túto problémovú situáciu reprodukovať. Nečakane nás to prekvapilo. Spočíva to v dotaze iba z jednej tabuľky. Samozrejme, mali sme takých dotazov viac. Zvyčajne zahŕňali dve až tri tabuľky, ale existuje aj takýto scenár reprodukcie. Na vašej databáze akejkoľvek verzie ho môžete reprodukovať.
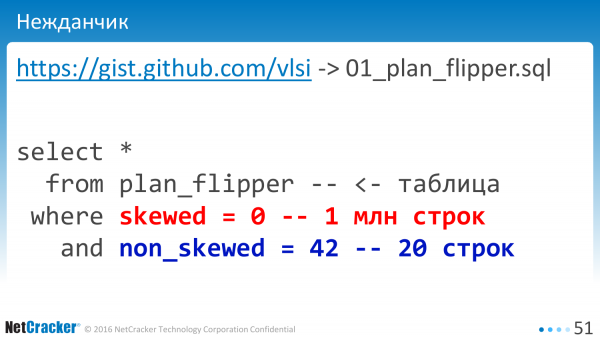
Podstatou je, že máme dve kolóny, z ktorých každá je indexovaná. V jednej kolóne je podľa hodnoty NULL milión riadkov. A v druhej kolóne je len 20 riadkov. Keď vykonávame bez prepojených premenných, všetko funguje dobre.
Ak začneme vykonávať s prepojenými premennými, t. j. vykonávame znak „?“ alebo „$1“ pre náš dopyt, čo vlastne dostaneme?
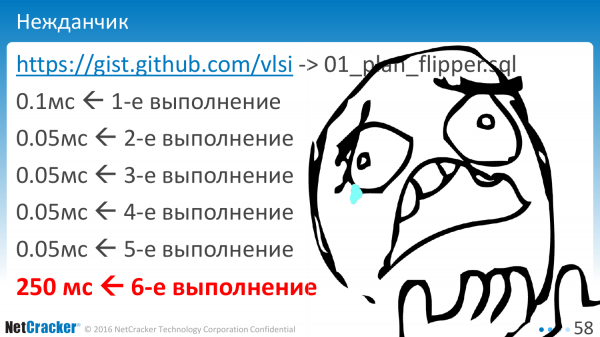
Prvé vykonanie – ako má byť. Druhé – o niečo rýchlejšie. Niečo bolo vyrovnané. Tretie-štvrté-piate. Potom bum – a nejako takto. A najhoršie je, že sa to stane pri šiestom vykonaní. Kto vedel, že treba urobiť presne šesť vykonaní, aby sme pochopili, aký je skutočný plán vykonania?
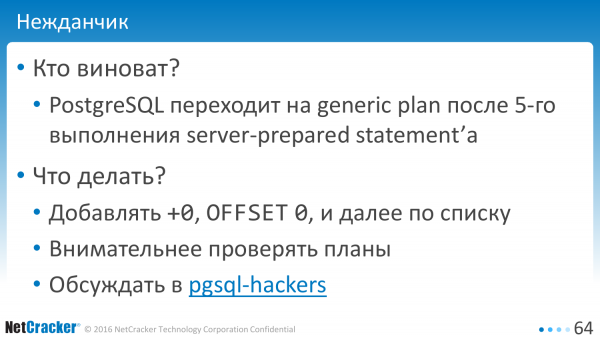
Kto je zodpovedný? Čo sa stalo? Databáza obsahuje optimalizáciu. A je takpovediac optimalizovaná pre generický prípad. A teda, začínajúc určitým spôsobom, prechádza na generický plán, ktorý, bohužiaľ, môže byť iný. Môže sa ukázať, že je taký istý, ale môže byť aj iný. A existuje nejaká prahová hodnota, ktorá vedie k takému správaniu.
Čo s tým môžeme robiť? Tu je samozrejme ťažšie niečo predpokladať. Existuje jednoduché riešenie, ktoré používame. Je to +0, OFFSET 0. Určite poznáte takéto riešenia. Jednoducho vezmeme a do dopytu pridáme „+0“ a všetko je dobré. Ukážem neskôr.
A je tu ešte jedna možnosť – pozrieť sa pozornejšie na plány. Vývojár by mal nielen napísať dopyt, ale aj šesťkrát povedať „explain analyze“. Ak päťkrát, tak to nevyhovuje.
A existuje ešte tretia možnosť – napísať list na pgsql-hackers. Napísal som, ale zatiaľ nie je jasné, či ide o chybu alebo funkciu.
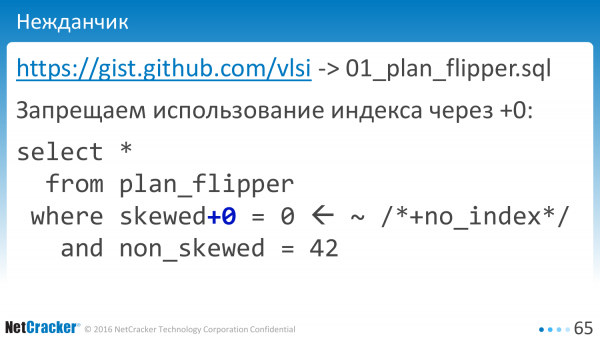
Než budeme uvažovať, či ide o chybu alebo funkciu, poďme to opraviť. Vezmeme náš dopyt a pridáme „+0“. Všetko je dobré. Dva symboly a ani netreba premýšľať, ako a čo tam je. Veľmi jednoduché. Jednoducho sme databáze zakázali používať index pre tento stĺpec. Nemáme index pre stĺpec „+0“ a všetko, databáza používa index, všetko je v poriadku.
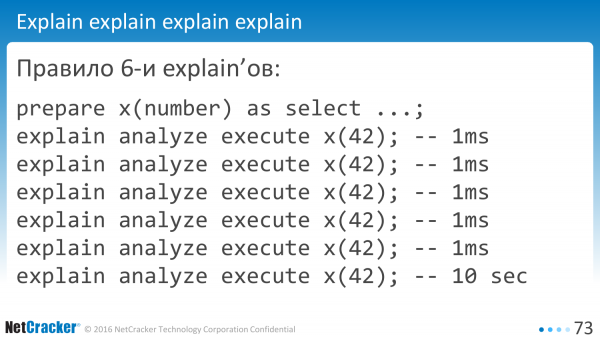
Toto je pravidlo šiestich explainov. V aktuálnych verziách je potrebné robiť to šesťkrát, ak máte súvisiace premenné. Ak nemáte súvisiace premenné, robíme to takto. A na konci tento dopyt padá. Nič zložitá záležitosť.
Na prvý pohľad, koľko toho môže byť? Tu chyba, tam chyba. V skutočnosti je chyba všade.
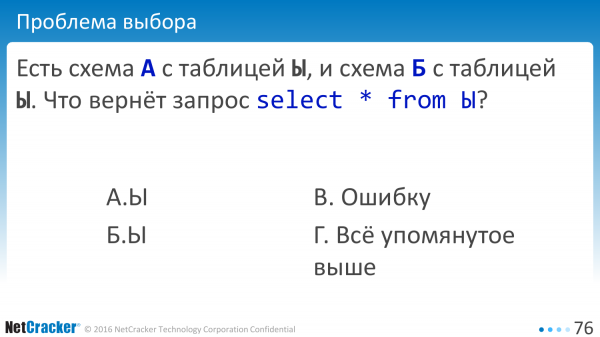
Poďme sa pozrieť ešte raz. Napríklad, máme dve schémy. Schéma A s tabuľkou Y a schéma B s tabuľkou Y. Dopyt – vybrať údaje z tabuľky. Čo máme pri tom? Budeme mať chybu. Budeme mať všetko, čo bolo uvedené vyššie. Pravidlo je také – chyba je všade, budeme mať všetko vyššie uvedené.
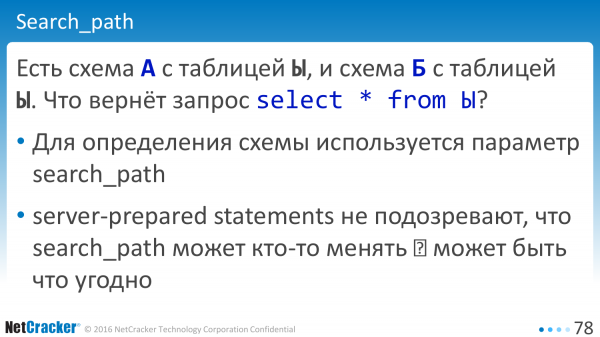
Teraz otázka: „Prečo?“. Na prvý pohľad je tu dokumentácia, ktorá hovorí, že ak máme schému, tak existuje premenná „search_path“, ktorá určuje, kde treba hľadať tabuľku. Na prvý pohľad, premenná existuje.
V čom je problém? Problém je v tom, že server-prepared statements si neuvedomujú, že niekto môže meniť search_path. Táto hodnota zostáva akoby konštantná pre databázu. A niektoré časti nemusia získať nové hodnoty.
Samozrejme, závisí to od verzie, na ktorej testujete. Záleží na tom, ako veľmi sa vaše tabuľky líšia. A verzia 9.1 jednoducho spracuje staré dotazy. Novšie verzie môžu odhaliť podvod a povedať, že máte chybu.
Ako to opraviť? Existuje jednoduchý recept – nerobte to. Nemeňte search_path v práci aplikácie. Ak použijete iné, je lepšie vytvoriť nové pripojenie.
Môžeme to prediskutovať, tj. otvoriť, prediskutovať, dopísať. Možno presvedčíme vývojárov databázy, že v prípade, ak niekto zmení hodnotu, databáza by mala klientovi povedať: „Pozrite, tu sa hodnota aktualizovala. Možno by ste mali resetovať statements, prekonať ich?“. Teraz sa databáza správa obmedzene a nijako neoznamuje, že sa niekde vo vnútri statements zmenili.
A opäť zdôrazním – to nie je typické pre Java. To isté uvidíme v PL/pgSQL jeden k jednému. Ale tam sa to obnoví.
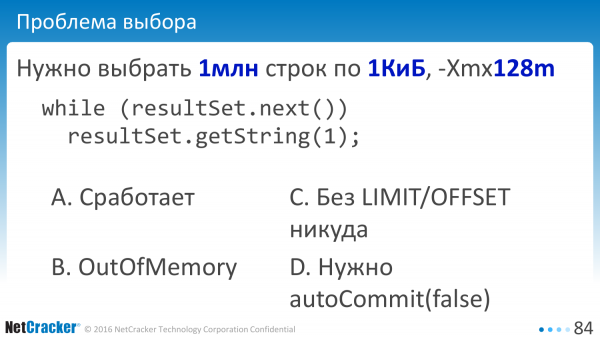
Skúsme znovu vybrať údaje. Vyberáme, vyberáme. Máme tabuľku s miliónom riadkov. Každý riadok má kilobajt. Približne gigabajt údajov. A máme pracovnú pamäť v Java stroj v 128 megabajtoch.
My, ako je odporúčané vo všetkých knihách, používame prúdovú spracovanie. Tj. otvárame resultSet a čítame z neho údaje po kusoch. Bude to fungovať? Nepadneme kvôli pamäti? Bude to čítať po troškách? Poďme veriť databáze, veríme v Postgres. Neveríme. Spadneme OutOFMemory? Kto mal OutOfMemory? A kto to dokázal opraviť potom? Niekto to dokázal opraviť.
Ak máte milión riadkov, nedá sa len tak vybrať. Je nutné použiť OFFSET/LIMIT. Kto je za taký variant? A kto je za variant, že by sme sa mali hrať s autoCommitom?
Tu, ako obvykle, sa najnečakanejší variant ukazuje ako správny. A ak náhodou vypnete autoCommit, pomôže to. Prečo je to tak? Veda o tom nevie.
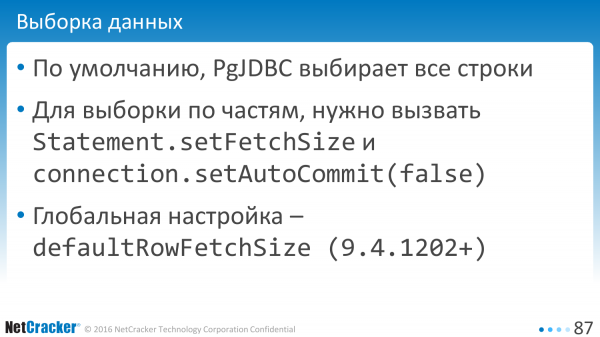
Ale predvolene všetci klienti pripojujúci sa k databáze Postgres vyberajú údaje celé. PgJDBC nie je v tomto ohľade výnimkou, vyberá všetky riadky.
Existuje variácia na tému FetchSize, t.j. môžete na úrovni jednotlivého statementu povedať, že tu, prosím, vyberte údaje po 10, 50. Ale to nefunguje, pokým nevypnete autoCommit. Vypnutý autoCommit – začne to fungovať.
Chodiť po kóde a všade nastavovať setFetchSize je nepraktické. Preto sme vytvorili nastavenie, ktoré bude pre celé spojenie hovoriť predvolenú hodnotu.
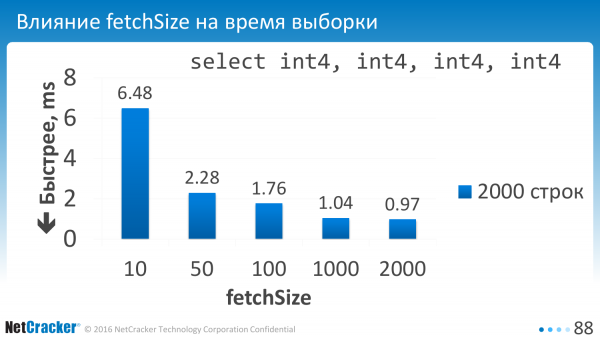
Povedali sme to. Nastavili sme parameter. A čo sme dosiahli? Ak vyberáme malé množstvo, napríklad 10 riadkov, máme dosť vysoké náklady. Preto by sme mali nastaviť túto hodnotu na približne sto.
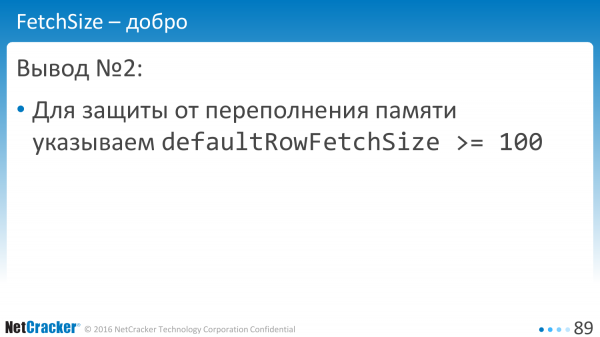
Ideálne by bolo naučiť sa obmedzovať aj v bajtoch, ale recept je taký: nastavujeme defaultRowFetchSize na viac ako sto a tešíme sa.
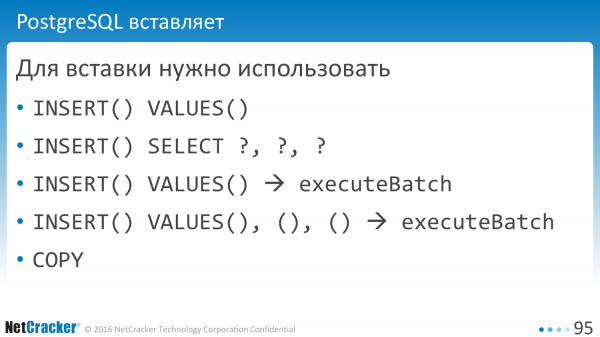
Prejdime k vkladaniu údajov. Vkladanie je jednoduché, existujú rôzne možnosti. Napríklad, INSERT, VALUES. To je dobrá možnosť. Môžeme povedať 'INSERT SELECT'. V praxi je to to isté. Žiadny rozdiel vo výkonnosti.
Knihy hovoria, že treba vykonávať Batch statement, knihy hovoria, že je možné vykonávať zložitejšie príkazy s viacerými zátvorkami. A v Postgres je výborná funkcia – môžeme robiť COPY, t.j. robiť to rýchlejšie.

Ak sa to zmeria, môžeme urobiť niekoľko zaujímavých objavov. Ako chceme, aby to fungovalo? Chceme, aby sme neparsanovali a vykonávali zbytočné príkazy.
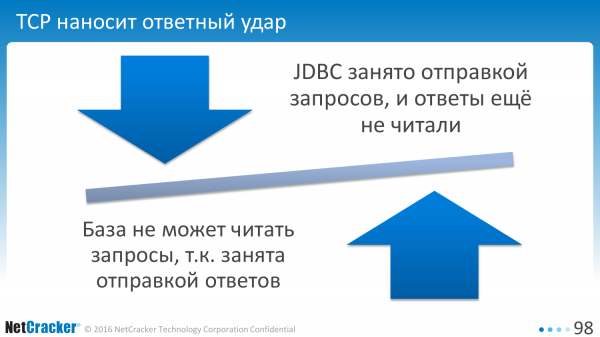
V praxi nám to TCP takto nedovolí. Ak je klient zaneprázdnený odosielaním požiadavky, databáza sa snaží odoslať nám odpovede, požiadavky nečíta. Nakoniec klient čaká na databázu, kým prečíta požiadavku, a databáza čaká na klienta, kým prečíta odpoveď.
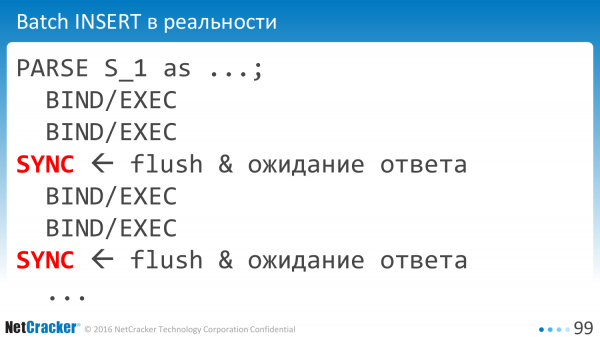
A preto je klient nútený občas posielať synchronizačný paket. Zbytočné sieťové interakcie, zbytočná strata času.
 A čím viac ich pridávame, tým horšie to je. Ovládač je veľmi pesimistický a pridáva ich dosť často, asi raz každých 200 riadkov, v závislosti od veľkosti riadkov a pod.
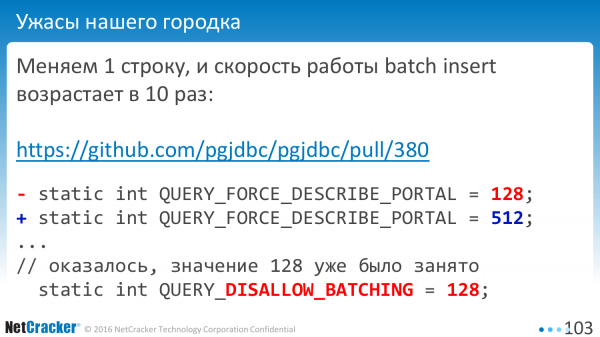
Stáva sa, že ak opravíte jeden riadok, zrazu sa to celé zrýchli desaťkrát. Takéto prípady sa stávajú. Prečo? Ako vždy, nejaká konštanta už bola niekde použitá. A hodnota '128' znamenala – nepoužívať batching.
Je dobré, že sa to nedostalo do oficiálnej verzie. Zistili sme to predtým, ako sme začali vydávať release. Všetky hodnoty, ktoré uvádzam, sú založené na moderných verziách.
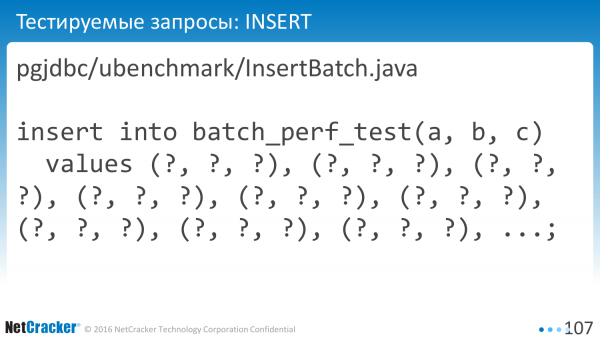
Zmerajme to. Meriame jednoduchý InsertBatch. Meriame viackrát InsertBatch, t.j. to isté, ale s mnohými hodnotami. Chytrý ťah. Nie každý to tak dokáže, ale je to jednoduchý prístup, oveľa jednoduchší ako COPY.
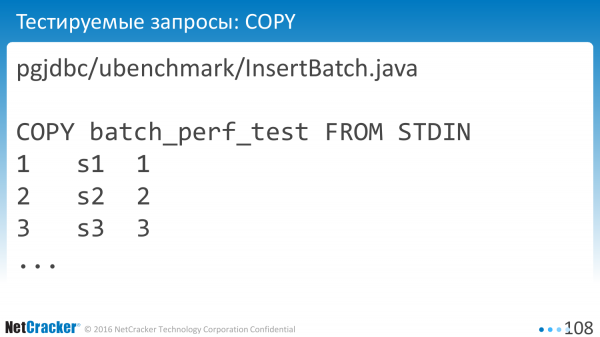
Môžeme robiť COPY.
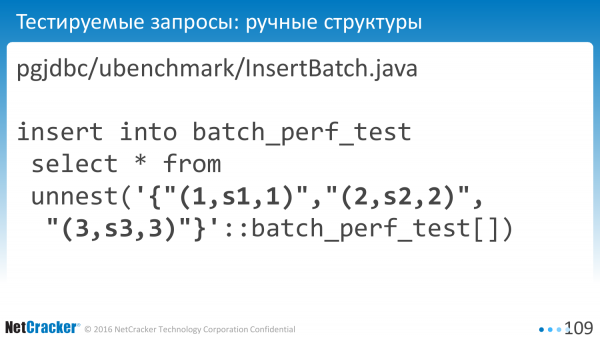
A možno to robiť na štruktúrach. Vyhlásiť predvolený typ používateľa, poslať pole a priamo vložiť do tabuľky.
Ak otvoríte odkaz: pgjdbc/ubenchmsrk/InsertBatch.java, tento kód je na GitHub. Môžete si pozrieť konkrétne, aké dopyty sa tam generujú. Nie je to podstatné.
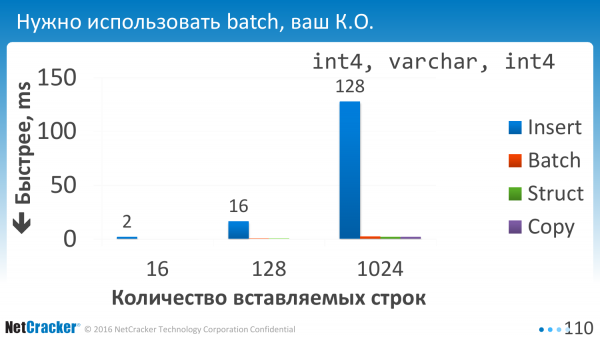
Spustili sme to. A prvé, čo sme pochopili, je, že batch sa jednoducho nesmie nepoužívať. Všetky možnosti batching sú nulové, t. j. čas vykonávania je prakticky nulový v porovnaní s jednorazovým vykonaním.
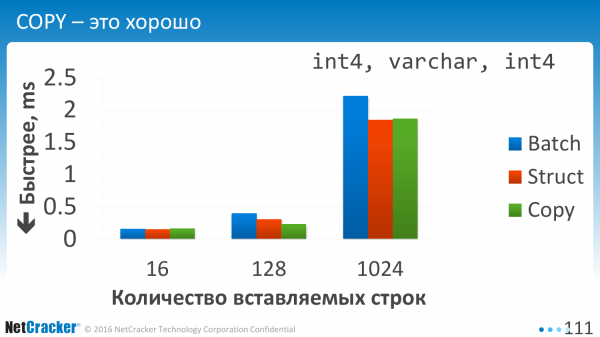
Vkladáme údaje. Je to relatívne jednoduchá tabuľka. Tri stĺpce. A čo tu vidíme? Vidíme, že všetky tieto tri možnosti sú približne porovnateľné. A COPY je samozrejme lepšia.
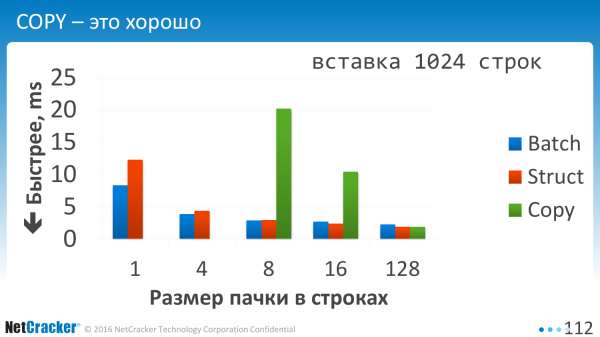
To je, keď vkladáme po častiach. Keď sme hovorili o jednom hodnote VALUES, dvoch hodnotách VALUES, troch hodnotách VALUES alebo sme ich tam 10 uviedli cez čiarku. To je presne teraz horizontálne. 1, 2, 4, 128. Je zrejmé, že Batch Insert, ktorý je zobrazený modro, sa tým naozaj uľahčuje. T. j. keď vkladáte po jednom alebo aj keď dávate po štyroch, je to dvakrát lepšie, jednoducho preto, že sme do VALUES naložili niečo viac. Menej operácií EXECUTE.
Používať COPY pri malých objemoch – je to extrémne nevyhliadnuteľné. Na prvé dva som ani nenakreslil. Idú k oblohe, t. j. tieto zelené čísla pre COPY.
COPY treba používať, keď máte objem údajov aspoň viac ako sto riadkov. Náklady na otvorenie tohto pripojenia sú veľké. A, úprimne, do tejto oblasti som sa nepustil. Batching som optimalizoval, COPY – nie.
Čo robíme ďalej? Zmerali sme. Rozumieme, že treba používať buď štruktúry, alebo rafinovaný batch, ktorý spája niekoľko hodnôt.
Čo treba vyťažiť z dnešnej prezentácie?
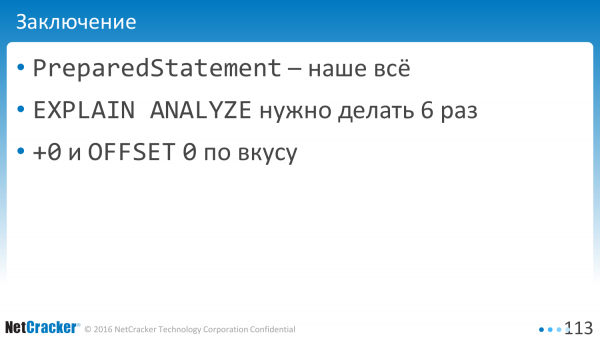
- PreparedStatement – to je naše všetko. To dosť pomáha výkonu. Prináša veľkú nádobu dechtu.
- A treba robiť EXPLAIN ANALYZE 6-krát.
- A treba naďalej rozmixovať OFFSET 0 a triky ako +0, aby sme upravili zostávajúci percento z našich problémových dopytov.
Zdroj: habr.com
