

Mnohí, ktorí už využívajú — našu službu vizualizácie plánov PostgreSQL, možno nevedia o jednej z jej super schopností — prevádzať ťažko čitateľný úryvok z logu servera...
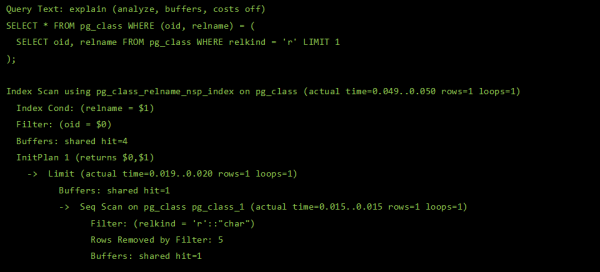
… na pekne naformulovaný dotaz s kontextovými nápovedami k príslušným uzlom plánu:
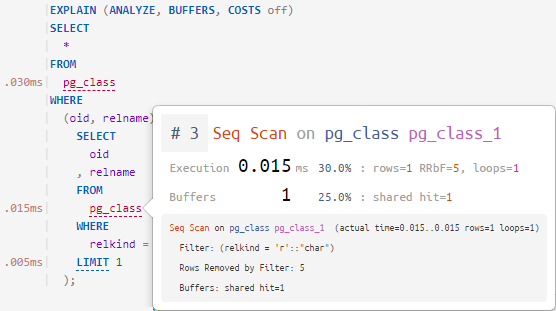
V tomto rozšírení druhej časti svojho poviem, ako sa nám to podarilo.
S prepisom prvej časti, venujúcej sa typickým problémom výkonu dotazov a ich riešeniam, sa môžete oboznámiť v článku .
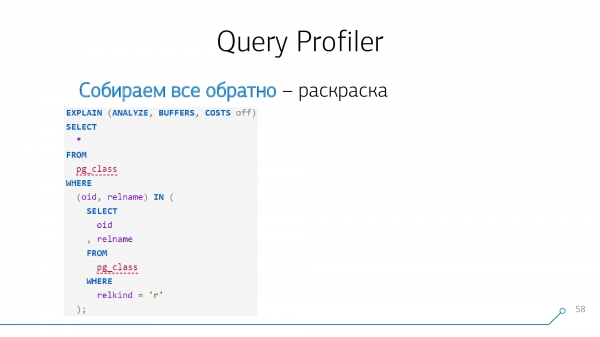
Najprv sa zameriame na farebné zvýraznenie — a farebne zvýrazníme už nie plán, ten sme už ozdobili, je pre nás už pekný a zrozumiteľný, ale dotaz.
Zdalo sa nám, že takto neformátovaná „plachta“ vytiahnutá z logu vyzerá veľmi škaredo a preto — je nepríjemná.
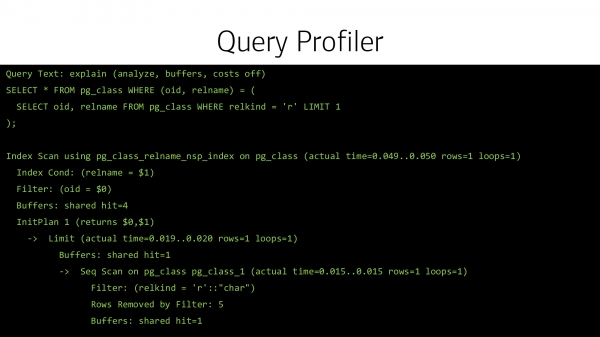
Obzvlášť, keď vývojári v kóde „lepia“ telo dotazu (to je samozrejme antipattern, ale stáva sa to) do jedného riadku. Hrozný pohľad!
Poďme to nakresliť nejak krajšie.
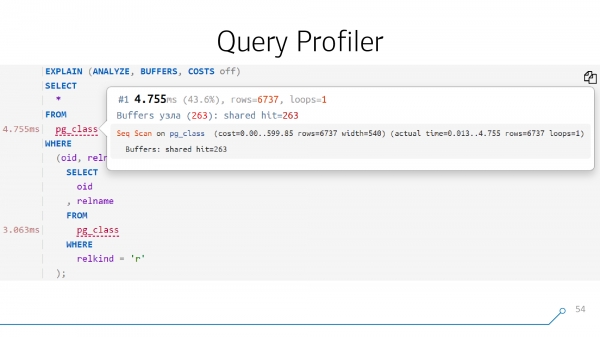
A ak to vieme nakresliť pekne, teda rozobrať a znovu poskladať telo dotazu, potom môžeme každý objekt tohto dotazu „pripojiť“ nápovedu — čo sa udialo v príslušnom bode plánu.
Syntaxové strom dotazu
Aby sme to dosiahli, musíme najprv dotaz rozobrať.
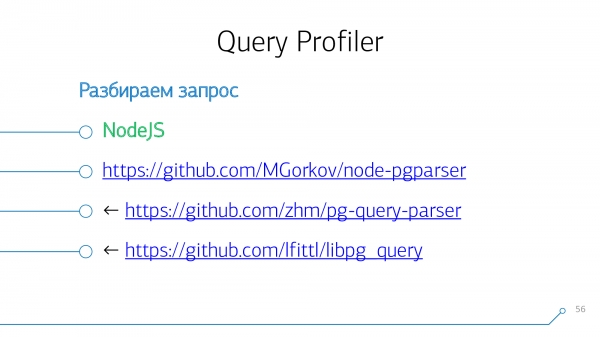
Keďže naše , vytvorili sme pre neho modul, môžete . V skutočnosti, to je rozšírené „bindingy“ k vnútornostiam parseru samotného PostgreSQL. Teda jednoducho binárne skompilovaná gramatika s bindingmi zo strany NodeJS. Vzali sme za základ cudzie moduly — nie je tu žiadne veľké tajomstvo.
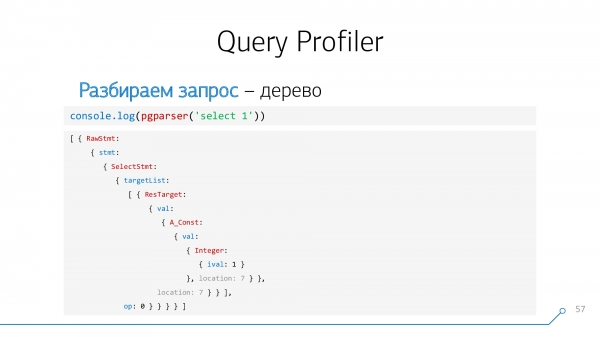
Predložíme telo dotazu ako vstup našej funkcii — na výstupe dostaneme rozobraté syntaxové strom vo forme JSON objektu.
Teraz po tomto strome môžeme prebehnúť zpätne a poskladať dotaz s tými odsadenia, farebným zvýraznením a formátovaním, ktoré chceme. Nie, nie je to konfigurovateľné, ale zdalo sa nám, že týmto spôsobom to bude pohodlné.
Mappiovanie uzlov dotazu a plánu
Teraz sa pozrieme, ako môžeme spojiť plán, ktorý sme rozobrali v prvom kroku, a dotaz, ktorý sme rozobrali v druhom.
Zoberme si jednoduchý príklad — máme dopyt, ktorý vytvára CTE a dvakrát z nej číta. Generuje takýto plán.
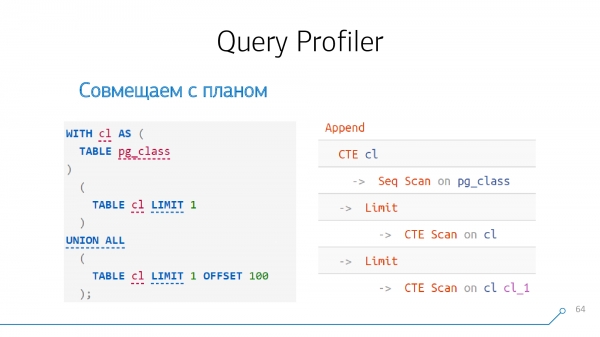
CTE
Ak sa na to pozrieme pozorne, pred 12. verziou (alebo od nej s kľúčovým slovom MATERIALIZED) vytváranie .
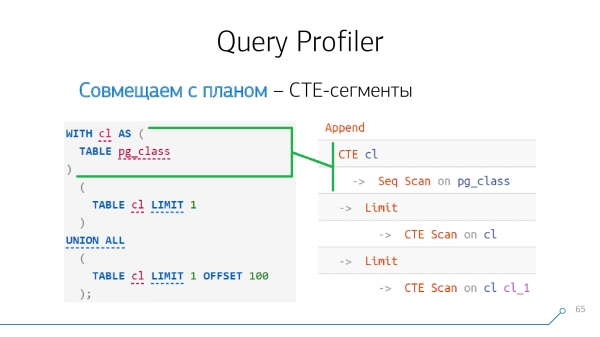
To znamená, že ak niekde v dopyte vidíme generáciu CTE a niekde v pláne uzol CTE, tieto uzly sú si navzájom 'rovné', môžeme ich hneď spojiť.
Úloha so hviezdičkou: CTE môžu byť vnorené.
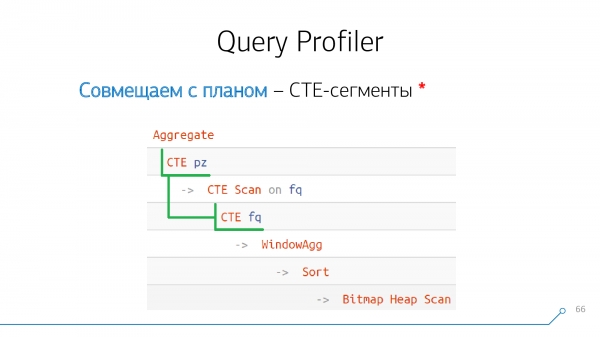
Môžu byť veľmi zle vnorené, a dokonca rovnomenné. Napríklad, môžete vo vnútri CTE A urobiť CTE X, a na tej istej úrovni vo vnútri CTE B urobiť opäť CTE X:
WITH A AS (
  WITH X AS (...)
  SELECT ...
)
, B AS (
  WITH X AS (...)
  SELECT ...
)
...
Pri porovnávaní by ste to mali chápať. Rozumieť tomu 'očami' — aj vidieť plán, aj vidieť telo dopytu — je veľmi ťažké. Ak máte zložitú, vnorenú generáciu CTE, veľké dopyty — potom sa to úplne stáva nevedomým.
operátor podporujú
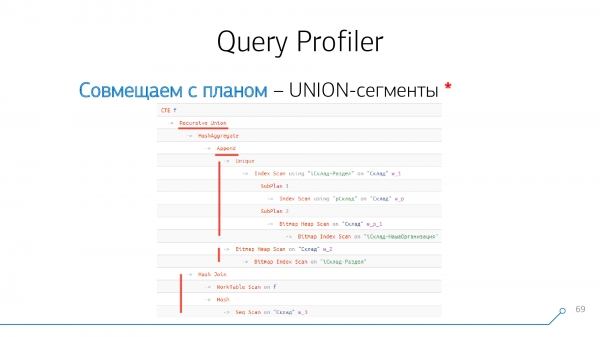
Ak máme v dopyte kľúčové slovo UNION [ALL] (operátor spojenia dvoch výberov), potom v pláne mu zodpovedá buď uzol Pridať, alebo nejaký Rekurzívna únia.
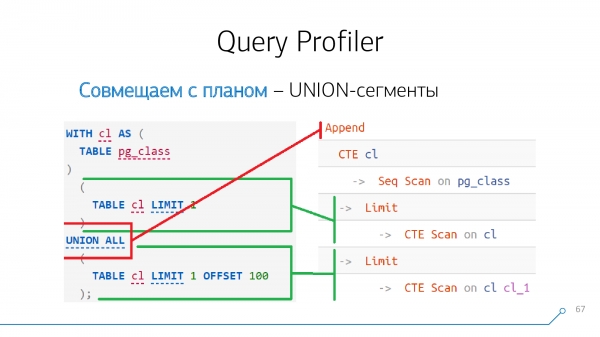
To, čo 'navrchu' nad operátor podporujú — je prvý potomok nášho uzla, čo 'dole' — druhý. Ak sú cez operátor podporujú nás 'prilepené' niekoľko blokov naraz, potom Pridať-uzol bude stále len jeden, ale detí bude nie dve, ale veľa — podľa poradia, ako prichádzajú:
  (...) -- #1
UNION ALL
  (...) -- #2
UNION ALL
  (...) -- #3
Append
-> ... #1
-> ... #2
-> ... #3
Úloha so hviezdičkou: vo vnútri generovania rekurzívneho výberu (WITH RECURSIVE) môže byť tiež viac než jeden operátor podporujú. Ale vždy rekurzívny je len posledný blok po poslednom operátor podporujú. Všetko, čo je vyššie — je jeden, ale iný operátor podporujú:
WITH RECURSIVE T AS(
  (...) -- #1
UNION ALL
  (...) -- #2, tu končí generácia štartovacieho stavu rekurzie
UNION ALL
  (...) -- #3, len tento blok je rekurzívny a môže obsahovať odvolanie na T
)
...
Takéto príklady treba tiež vedieť 'prilepovať'. Tu v tomto príklade vidíme, že operátor podporujú-segmentov v našom dopyte bolo 3 kusy. Preto jednému operátor podporujú zodpovedá Pridať-uzlu, a druhému — Rekurzívna únia.
Čítanie-zapisovanie dát
Všetko, rozložili sme, teraz vieme, ktorý kúsok dopytu zodpovedá ktorému kúsku plánu. A v týchto kúskoch môžeme ľahko a bez námahy nájsť tie objekty, ktoré 'sa čítajú'.
Z pohľadu dopytu nevieme — či je to tabuľka alebo CTE, ale označujú sa rovnakým uzlom Rozsahová premenná. A v pláne „číta sa“ — to je tiež dosť obmedzená sada uzlov:
Sekvenčné skenovanie na [tbl]Bitmapová hromadná kontrola na [tbl]Index [Only] Scan [Backward] using [idx] on [tbl]CTE skenovanie na [cte]Vložiť/Aktualizácia/Delete na [tbl]
Štruktúru plánu a dopytu poznáme, zhodu blokov poznáme, mená objektov poznáme — robíme jednoznačné zaradenie.
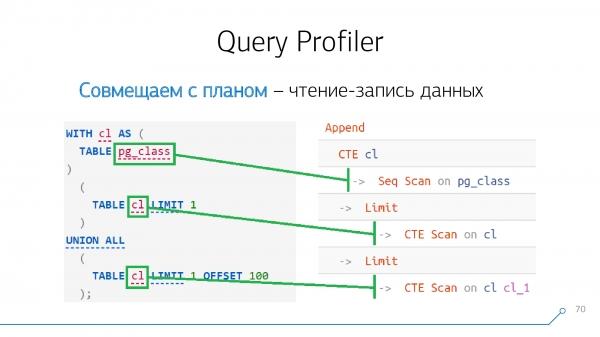
Opäť raz úloha „so hviezdičkou“. Berieme dopyt, vykonávame, nemáme žiadne aliasy — jednoducho dvakrát čítame z jednej CTE.
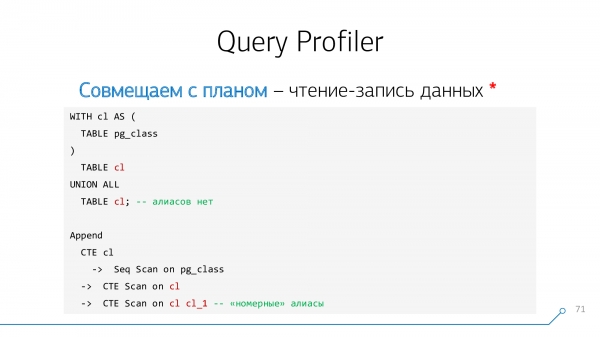
Pozrime sa do plánu — čo sa deje? Prečo sa nám alias objavil? Nepýtali sme sa na neho. Odkiaľ je taký „numerický“?
PostgreSQL ho pridáva samo. Musíme len chápať, že presne taký alias pre nás na účely zaradenia s plánom nemá žiadny význam, je tu jednoducho pridaný. Nevenujme mu pozornosť.
Druhá úloha „so hviezdičkou“: ak ideme čítať zo sekcionovanej tabuľky, dostaneme uzol Pridať alebo Zlúčiť Pripojiť, ktorý sa bude skladať z veľkého množstva „detí“, z ktorých každé bude nejakým Scan‘om z tabuľky-sekcie: Sekvenčné skenovanie, Bitmapová hromadná kontrola alebo Index Scan. Ale v každom prípade tieto „deti“ nebudú zložitými dopytmi — takto sa dajú rozlíšiť tieto uzly od Pridať pri operátor podporujú.
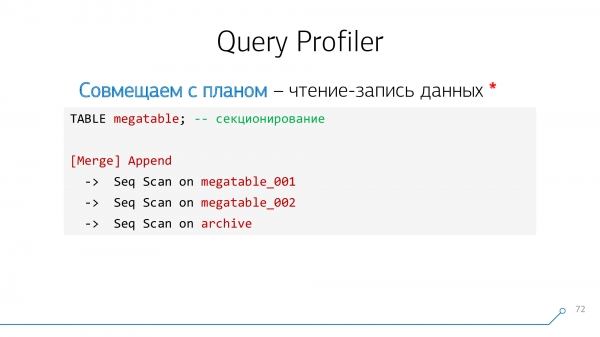
Takéto uzly tiež chápeme, zbierame ich „do jednej kopy“ a hovoríme: "všetko, čo si čítal z megatable — to je tu a smerom nadol po strome".
„Jednoduché“ uzly získavania dát
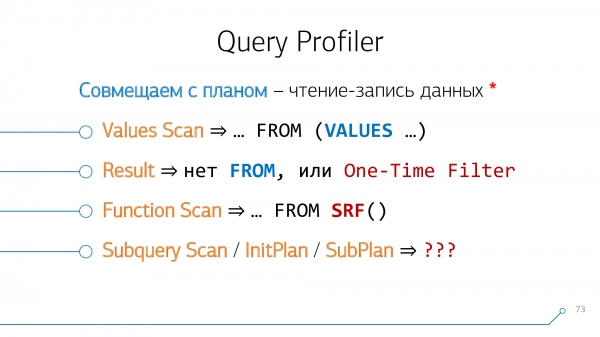
Skenovanie hodnôt v pláne zodpovedajú HODNOTY v dopyte.
Výsledok — je to dopyt bez FROM akoby SELECT 1. Alebo keď máte vopred falošný výraz v WHERE-bloku (vtedy vzniká atribút One-Time Filter):
EXPLAIN ANALYZE
SELECT * FROM pg_class WHERE FALSE; -- alebo 0 = 1
Výsledok (náklady=0.00..0.00 riadky=0 šírka=230) (skutočný čas=0.000..0.000 riadky=0 slučky=1)
One-Time Filter: false
Funkcia skenovania „mapujú“ sa na rovnomenované SRF.
Ale s vnorenými dopytmi je to zložitejšie — žiaľ, nie vždy sa menia na Základný plán/SubPlán. Niekedy sa menia na ... Join alebo ... Anti Join, najmä keď píšete niečo ako WHERE NOT EXISTS .... A tam kombinovať sa nie vždy dá — v texte plánu nie sú zodpovedajúce uzlom plánu operátori.
Opäť raz úloha „so hviezdičkou“: niekoľko HODNOTY v dopyte. V tomto prípade a v pláne dostanete niekoľko uzlov Skenovanie hodnôt.
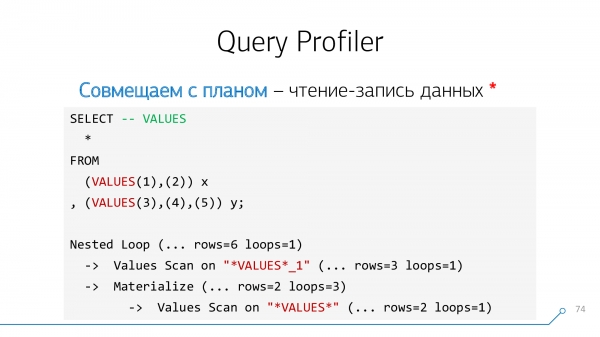
Rozlíšiť ich jeden od druhého pomôžu „číslicové“ prídavky — pridáva sa presne v poradí, v akom sa nájdu zodpovedajúce HODNOTY-bloky popri dopyte zhora nadol.
Spracovanie údajov
Akoby všetko v našom dopyte rozobrali — ostal len Obmedzenie.
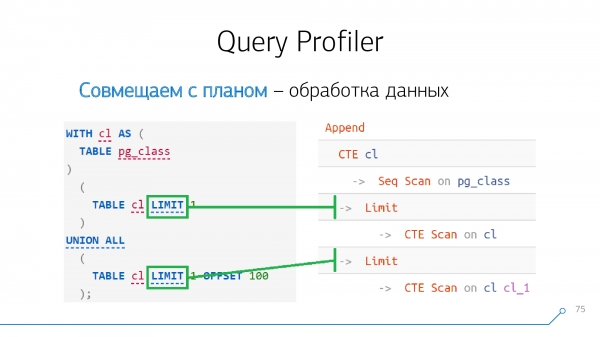
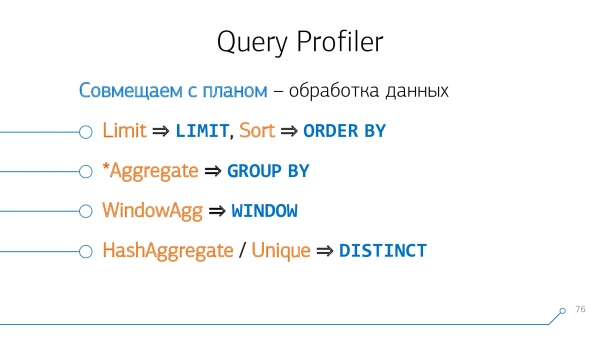
Ale tu je to jednoduché — také uzly ako Obmedzenie, Tried, Agregovať, WindowAgg, Unique „mapujú“ sa jeden na jeden na zodpovedajúce operátory v dopyte, ak tam sú. Tu nie sú žiadne „hviezdičky“ a zložitosti.
JOIN
Zložitosti vznikajú, keď chceme skombinovať JOIN medzi sebou. To nie je vždy možné, ale dá sa to.
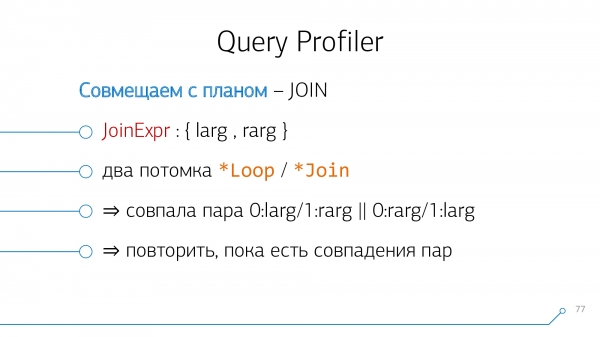
Z pohľadu parsera dotazu máme uzol PripojiťExpr, ktorý má presne dve potomkov — ľavý a pravý. To je, podľa toho, čo je „nad“ vaším JOIN a to, čo je „pod“ ním v dotaze.
A z pohľadu plánu sú to dve potomkovia nejakého * Cyklus/* Pripojiť-uzla. Zabudovaný cyklus, Hash Anti Join,… — niečo také.
Vyjdeme z jednoduché logiky: ak máme tabuľky A a B, ktoré sa „jounujú“ medzi sebou v pláne, môžu byť v dotaze usporiadané buď A-JOIN-B, alebo B-JOIN-A. Pokúsime sa ich zlúčiť tak, pokúsime sa ich zlúčiť naopak a takto, kým sa tieto páry neskončia.
Vezmeme naše syntaktické strom, vezmeme náš plán, pozrieme sa na ne… nevyzerá to!
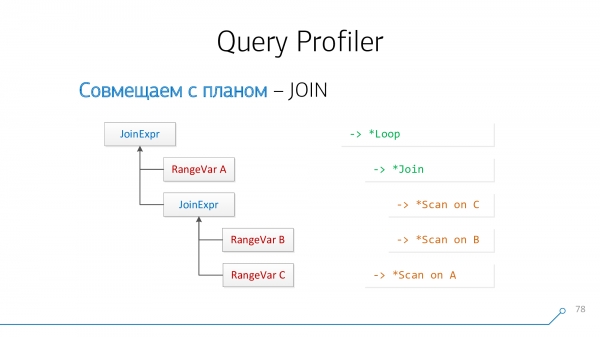
Prekreslime v podobe grafov — oh, už to vyzerá ako niečo!
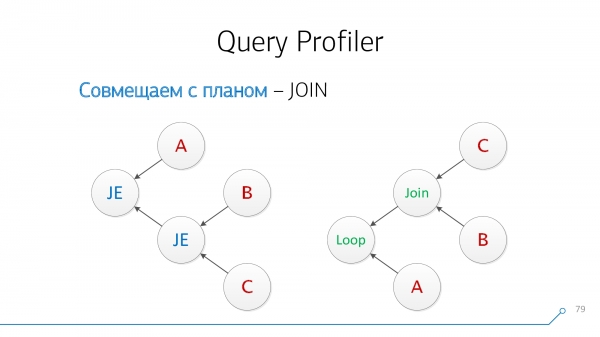
Poďme si všimnúť, že máme uzly, ktoré majú súčasne deti B a C — nezáleží nám na poradí. Zlúčime ich a otočíme obrázok uzla.
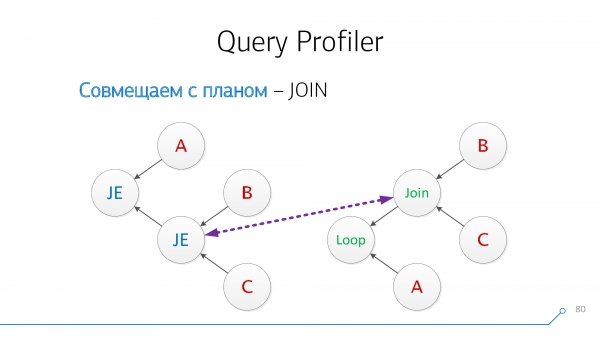
Pozrime sa znova. Teraz máme uzly s deťmi A a párom (B + C) — zlúčime aj ich.
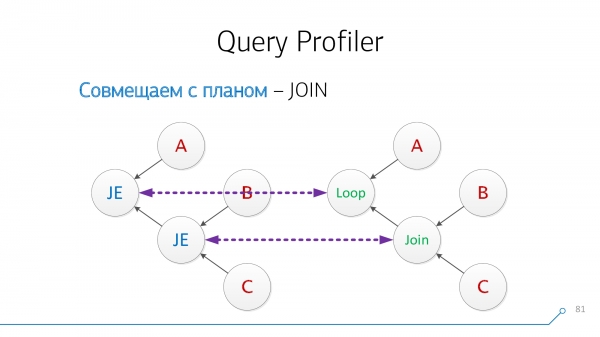
Výborne! Vychádza to tak, že sme tie dve JOIN z dotazu s uzlami plánu úspešne spojili.
Žiaľ, táto úloha nie je vždy riešiteľná.
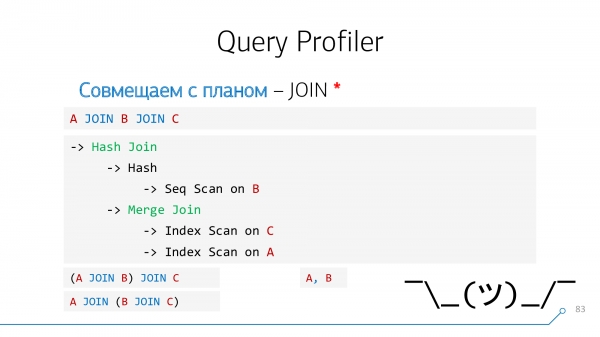
Napríklad, ak v dotaze A JOIN B JOIN C, a v pláne sa v prvom rade spojili „okrajové“ uzly A a C. A v dotaze nie je taký operátor, nemáme čo zvýrazniť, nemáme sa na čo pripojiť. To isté s „čiarkou“, keď píšete A, B.
No, vo väčšine prípadov sa takmer všetky uzly dajú „rozviazať“ a získať takýto profilovanie naľavo podľa času — doslova, ako v Google Chrome, keď analyzujete kód na JavaScripte. Vidíte, koľko času každé riadok a každý operátor „bežali“.
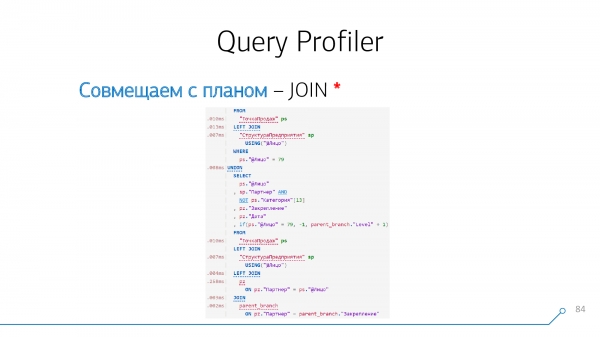
A aby vám to všetko bolo pohodlnejšie, vytvorili sme úložisko , kde si môžete uložiť a potom nájsť svoje plány spolu s asociovanými dotazmi alebo zdieľať niekomu odkaz.
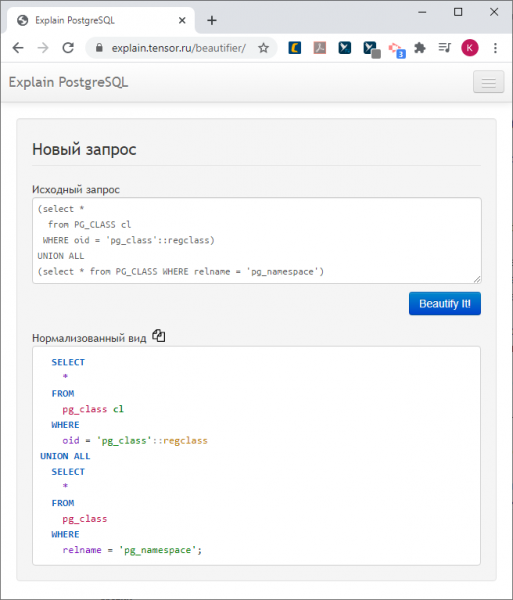
Ak potrebujete len uviesť nečitateľný dotaz do adekvátneho stavu, využite .
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish