

Úvod
Pri zavádzaní ďalšieho systému sme sa stretli s potrebou spracovávať veľké množstvo rôznorodých protokolov. Ako nástroj sme si vybrali ELK. V tomto článku sa podelíme o naše skúsenosti s nastavením tohto stacku.
Nemáme za cieľ popísať všetky jeho možnosti, ale chceme sa zamerať na riešenie praktických úloh. Je to spôsobené tým, že aj pri dostatočnom množstve dokumentácie a už hotových obrazov je tu množstvo úskalia, minimálne u nás sa objavili.
Zavádzali sme stack pomocou docker-compose. Navyše, mali sme dobre napísaný docker-compose.yml, ktorý nám umožnil takmer bez problémov spustiť stack. A zdalo sa, že víťazstvo je už blízko, teraz to len trošku prispôsobíme našim potrebám a všetko bude.
Žiaľ, pokus prispôsobiť systém na prijímanie a spracovanie protokolov z našej aplikácie nebol hneď úspešný. Preto sme sa rozhodli, že sa budeme zaoberať každým komponentom zvlášť a potom sa vrátime k ich vzťahom.
Tak sme začali s logstash.
Prostredie, zavedenie, spustenie Logstash v kontajneri
Na zavedenie používame docker-compose, popísané experimenty prebiehali na MacOS a Ubuntu 18.0.4.
Obraz logstash, ktorý sme mali vo svojom pôvodnom docker-compose.yml, je docker.elastic.co/logstash/logstash:6.3.2
Tento použijeme na naše experimenty.
Na spustenie logstash sme napísali samostatný docker-compose.yml. Mohli sme samozrejme spustiť obraz príkazovým riadkom, ale my sme predsa riešili konkrétnu úlohu, kde sa všetko spúšťa z docker-compose.
Krátko o konfiguračných súboroch
Ako je uvedené v popise, logstash sa dá spustiť buď pre jeden kanál, pričom mu treba pridať súbor *.conf, alebo pre viac kanálov, pričom mu treba pridať súbor pipelines.yml, ktorý zase odkazuje na súbory .conf pre každý kanál.
Rozhodli sme sa pre druhú cestu. Tá sa nám zdala byť univerzálnejšia a škálovateľnejšia. Preto sme vytvorili pipelines.yml a vytvorili sme adresár pipelines, do ktorého budeme ukladať súbory .conf pre každý kanál.
Vo vnútri kontajnera je ešte jeden konfiguračný súbor — logstash.yml. Ten sa nás netýka, používame ho tak, ako je.
Takže štruktúra našich adresárov je:
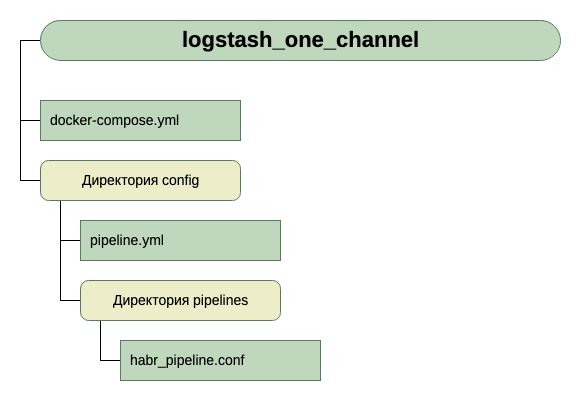
Na prijímanie vstupných dát predpokladáme, že to bude tcp na porte 5046, a pre výstup budeme používať stdout.
Toto je taká jednoduchá konfigurácia pre prvé spustenie. Skôr sa zameriavame na to, aby sme spustili.
Takže, máme tento docker-compose.yml
version: '3'

networks:
  elk:

volumes:
  elasticsearch:
    driver: local

services:

  logstash:
    container_name: logstash_one_channel
    image: docker.elastic.co/logstash/logstash:6.3.2
    networks:
      	- elk
    ports:
      	- 5046:5046
    volumes:
      	- ./config/pipelines.yml:/usr/share/logstash/config/pipelines.yml:ro
	- ./config/pipelines:/usr/share/logstash/config/pipelines:ro
Čo tu vidíme?
- Networks a volumes boli prevzaté z pôvodného docker-compose.yml (ten, kde sa spúšťa celý stack) a myslím, že na celkový obraz to nemá veľký dopad.
- Vytvárame jednu službu (services) logstash, z obrazu docker.elastic.co/logstash/logstash:6.3.2 a priraďujeme jej meno logstash_one_channel.
- Prekladáme port 5046 do kontajnera na rovnaký interný port.
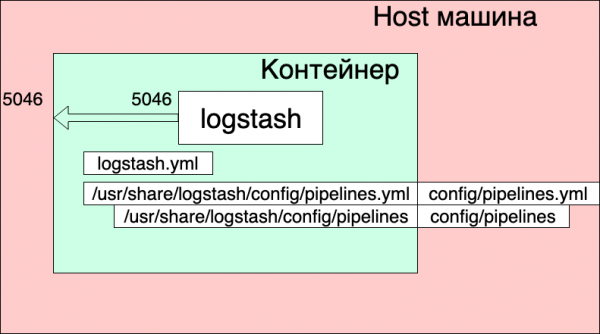
- Zobrazujeme náš konfiguračný súbor kanálov ./config/pipelines.yml na súbor /usr/share/logstash/config/pipelines.yml vnútri kontajnera, odkiaľ ho logstash prevezme a robíme ho iba na čítanie, pre istotu.
- Zobrazujeme adresár ./config/pipelines, kde máme súbory s nastaveniami kanálov, do adresára /usr/share/logstash/config/pipelines a tiež ho robíme iba na čítanie.
Súbor pipelines.yml
- pipeline.id: HABR
  pipeline.workers: 1
  pipeline.batch.size: 1
  path.config: "./config/pipelines/habr_pipeline.conf"
Tu je popísaný jeden kanál s identifikátorom HABR a cesta k jeho konfiguračnému súboru.
A nakoniec súbor "./config/pipelines/habr_pipeline.conf"
input {
  tcp {
    port => "5046"
   }
  }
filter {
  mutate {
    add_field => [ "habra_field", "Hello Habr" ]
    }
  }
output {
  stdout {

    }
  }
Nezaoberajme sa zatiaľ jeho popisom, pokúsme sa spustiť:
docker-compose up
Čo vidíme?
Kontajner sa spustil. Môžeme skontrolovať jeho funkčnosť:
echo '13123123123123123123123213123213' | nc localhost 5046
A vidíme v konzole kontajnera odpoveď:
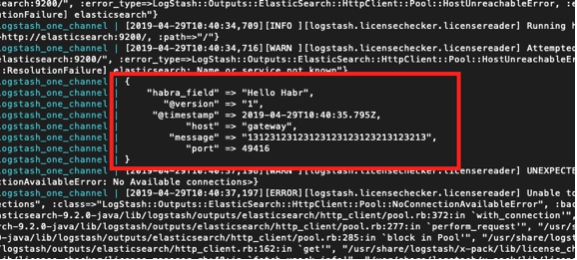
Ale zároveň vidíme aj:
logstash_one_channel | [2019-04-29T11:28:59,790][ERROR][logstash.licensechecker.licensereader] Unable to retrieve license information from license server {:message=>"Elasticsearch Unreachable: [http://elasticsearch:9200/][Manticore::ResolutionFailure] elasticsearch", …
logstash_one_channel | [2019-04-29T11:28:59,894][INFO ][logstash.pipeline ] Pipeline started successfully {:pipeline_id=>".monitoring-logstash", :thread=>"#"}
logstash_one_channel | [2019-04-29T11:28:59,988][INFO ][logstash.agent ] Pipelines running {:count=>2, :running_pipelines=>[:HABR, :".monitoring-logstash"], :non_running_pipelines=>[]}
logstash_one_channel | [2019-04-29T11:29:00,015][ERROR][logstash.inputs.metrics ] X-Pack is installed on Logstash but not on Elasticsearch. Please install X-Pack on Elasticsearch to use the monitoring feature. Other features may be available.
logstash_one_channel | [2019-04-29T11:29:00,526][INFO ][logstash.agent ] Successfully started Logstash API endpoint {:port=>9600}
logstash_one_channel | [2019-04-29T11:29:04,478][INFO ][logstash.outputs.elasticsearch] Spúšťam kontrolu stavu na overenie funkčnosti pripojenia k Elasticsearch {:healthcheck_url=http://elasticsearch:9200/, :path="/"}
logstash_one_channel | [2019-04-29T11:29:04,487][WARN ][logstash.outputs.elasticsearch] Pokus o obnovenie pripojenia k nefunkčnému ES inštancii zlyhal, ale dostal som chybu. {:url=«:9200/», :error_type=LogStash::Outputs::ElasticSearch::HttpClient::Pool::HostUnreachableError, :error=«Elasticsearch nedostupný: [http://elasticsearch:9200/][Manticore::ResolutionFailure] elasticsearch»}
logstash_one_channel | [2019-04-29T11:29:04,704][INFO ][logstash.licensechecker.licensereader] Spúšťam kontrolu stavu na overenie funkčnosti pripojenia k Elasticsearch {:healthcheck_url=http://elasticsearch:9200/, :path="/"}
logstash_one_channel | [2019-04-29T11:29:04,710][WARN ][logstash.licensechecker.licensereader] Pokus o obnovenie pripojenia k nefunkčnému ES inštancii zlyhal, ale dostal som chybu. {:url=«:9200/», :error_type=LogStash::Outputs::ElasticSearch::HttpClient::Pool::HostUnreachableError, :error=«Elasticsearch nedostupný: [http://elasticsearch:9200/][Manticore::ResolutionFailure] elasticsearch»}
A náš log sa neustále posúva nahor.
Tu som zvýraznil zelenou farbou správu, že pipeline sa úspešne spustila, červenou — správu o chybách a žltou — správu o pokuse o kontaktovanie :9200.
Dôvodom je, že v logstash.conf, ktorý je súčasťou obrazu, je nastavená kontrola prístupnosti elasticsearch. Logstash predpokladá, že funguje ako súčasť staku Elk, zatiaľ čo sme ho oddelili.
Pracovať sa dá, ale nie je to pohodlné.
Riešením je vypnúť túto kontrolu prostredníctvom premennej prostredia XPACK_MONITORING_ENABLED.
Upravíme súbor docker-compose.yml a znovu spustíme:
version: '3'

networks:
  elk:

volumes:
  elasticsearch:
    driver: local

services:

  logstash:
    container_name: logstash_one_channel
    image: docker.elastic.co/logstash/logstash:6.3.2
    networks:
      - elk
    environment:
      XPACK_MONITORING_ENABLED: "false"
    ports:
      - 5046:5046
   volumes:
      - ./config/pipelines.yml:/usr/share/logstash/config/pipelines.yml:ro
      - ./config/pipelines:/usr/share/logstash/config/pipelines:ro
Teraz je všetko v poriadku. Kontajner je pripravený na experimenty.
Môžeme znovu zadať v susednej konzole:
echo '13123123123123123123123213123213' | nc localhost 5046
A vidíme:
logstash_one_channel | {
logstash_one_channel |         "message" => "13123123123123123123123213123213",
logstash_one_channel |      "@timestamp" => 2019-04-29T11:43:44.582Z,
logstash_one_channel |        "@version" => "1",
logstash_one_channel |     "habra_field" => "Ahoj Habr",
logstash_one_channel |            "host" => "gateway",
logstash_one_channel |            "port" => 49418
logstash_one_channel | }
Práca v rámci jedného kanála
Takže sme sa spustili. Teraz sa môžeme venovať nastaveniu priamo logstash. Zatiaľ nebudeme zasahovať do súboru pipelines.yml, pozrime sa, čo môžeme získať, ak pracujeme s jedným kanálom.
Musím povedať, že všeobecný princíp práce so súborom konfigurácie kanála je dobre opísaný v oficiálnom sprievodcovi, tu
Ak chcete čítať po slovensky, použili sme tento (ale syntax požiadaviek tam je starý, treba to zohľadniť).
Prejdeme si to postupne od sekcie Input. Prácu cez tcp sme už videli. Čo ďalšie by mohlo byť zaujímavé?
Testovacie správy pomocou heartbeat
Existuje zaujímavá možnosť generovať automatické testovacie správy.
Na to musíte do sekcie input zapnúť plugin heartbeat.
input {
  heartbeat {
    message => "HeartBeat!"
   }
  }
Zapneme ho a začneme dostávať každú minútu
logstash_one_channel | {
logstash_one_channel |      "@timestamp" => 2019-04-29T13:52:04.567Z,
logstash_one_channel |     "habra_field" => "Hello Habr",
logstash_one_channel |         "message" => "HeartBeat!",
logstash_one_channel |        "@version" => "1",
logstash_one_channel |            "host" => "a0667e5c57ec"
logstash_one_channel | }
Chceme dostávať častejšie, musíme pridať parameter interval.
Takto budeme dostávať správu každých 10 sekúnd.
input {
  heartbeat {
    message => "HeartBeat!"
    interval => 10
   }
  }
Získavanie dát z súboru
Rozhodli sme sa pozrieť aj režim file. Ak s súborom funguje normálne, možno ani žiadneho agenta nebude treba, aspoň pre lokálne použitie.
Podľa popisu by mal byť režim práce podobný tail -f, t.j. číta nové riadky, alebo, ako možnosť, číta celý súbor.
Takže, čo chceme získať:
- Chceme dostávať riadky, ktoré sú pridané do jedného log súboru.
- Chceme získať dáta, ktoré sú zapísané do viacerých log súborov, pričom chceme mať možnosť rozlíšiť, čo je z ktorého zdroja.
- Chceme skontrolovať, že pri reštarte logstash nezíska tieto dáta znova.
- Chceme skontrolovať, že ak logstash vypneme a dáta do súborov sa stále zapisujú, pri reštarte dostaneme tieto dáta.
Na uskutočnenie experimentu pridáme ďalší riadok do docker-compose.yml, otvoríme adresár, do ktorého vkladáme súbory.
version: '3'

networks:
  elk:

volumes:
  elasticsearch:
    driver: local

services:

  logstash:
    container_name: logstash_one_channel
    image: docker.elastic.co/logstash/logstash:6.3.2
    networks:
      - elk
    environment:
      XPACK_MONITORING_ENABLED: "false"
    ports:
      - 5046:5046
   volumes:
      - ./config/pipelines.yml:/usr/share/logstash/config/pipelines.yml:ro
      - ./config/pipelines:/usr/share/logstash/config/pipelines:ro
      - ./logs:/usr/share/logstash/input
A zmeníme sekciu input v habr_pipeline.conf
input {
  file {
    path => "/usr/share/logstash/input/*.log"
   }
  }
Spúšťame sa:
docker-compose up
Na vytvorenie a zapisovanie log súborov budeme používať príkaz:
echo '1' >> logs/number1.log
{
logstash_one_channel |            "host" => "ac2d4e3ef70f",
logstash_one_channel |     "habra_field" => "Hello Habr",
logstash_one_channel |      "@timestamp" => 2019-04-29T14:28:53.876Z,
logstash_one_channel |        "@version" => "1",
logstash_one_channel |         "message" => "1",
logstash_one_channel |            "path" => "\/usr\/share\/logstash\/input\/number1.log"
logstash_one_channel | }
Áno, funguje!
Vidíme, že sa automaticky pridalo pole path. To znamená, že v budúcnosti budeme môcť podľa neho filtrovať záznamy.
Skúsime ešte:
echo '2' >> logs\/number1.log
{
logstash_one_channel |            "host" => "ac2d4e3ef70f",
logstash_one_channel |     "habra_field" => "Hello Habr",
logstash_one_channel |      "@timestamp" => 2019-04-29T14:28:59.906Z,
logstash_one_channel |        "@version" => "1",
logstash_one_channel |         "message" => "2",
logstash_one_channel |            "path" => "\/usr\/share\/logstash\/input\/number1.log"
logstash_one_channel | }
A teraz do iného súboru:
echo '1' >> logs\/number2.log
{
logstash_one_channel |            "host" => "ac2d4e3ef70f",
logstash_one_channel |     "habra_field" => "Hello Habr",
logstash_one_channel |      "@timestamp" => 2019-04-29T14:29:26.061Z,
logstash_one_channel |        "@version" => "1",
logstash_one_channel |         "message" => "1",
logstash_one_channel |            "path" => "\/usr\/share\/logstash\/input\/number2.log"
logstash_one_channel | }
Výborne! Súbor sa načítal, path je správne zadané, všetko funguje.
Zastavíme logstash a spustíme ho znova. Počkajte. Ticho. T.j. Záznamy sa už znova nedostanú.
A teraz ten najodvážnejší experiment.
Uložíme logstash a vykonáme:
echo '3' >> logs\/number2.log
echo '4' >> logs\/number1.log
Znova spúšťame logstash a vidíme:
logstash_one_channel | {
logstash_one_channel |            "host" => "ac2d4e3ef70f",
logstash_one_channel |     "habra_field" => "Hello Habr",
logstash_one_channel |         "message" => "3",
logstash_one_channel |        "@version" => "1",
logstash_one_channel |            "path" => "\/usr\/share\/logstash\/input\/number2.log",
logstash_one_channel |      "@timestamp" => 2019-04-29T14:48:50.589Z
logstash_one_channel | }
logstash_one_channel | {
logstash_one_channel |            "host" => "ac2d4e3ef70f",
logstash_one_channel |     "habra_field" => "Hello Habr",
logstash_one_channel |         "message" => "4",
logstash_one_channel |        "@version" => "1",
logstash_one_channel |            "path" => "\/usr\/share\/logstash\/input\/number1.log",
logstash_one_channel |      "@timestamp" => 2019-04-29T14:48:50.856Z
logstash_one_channel | }
Hurá! Všetko sa načítalo.
Ale treba varovať o nasledujúcom. Ak sa kontajner s logstash odstráni (docker stop logstash_one_channel && docker rm logstash_one_channel), nič sa neuloží. Vnútri kontajnera bola uložená pozícia súboru, do ktorej bol prečítaný. Ak sa spúšťame „od začiatku“, prijíma len nové riadky.
Čítanie už existujúcich súborov
Predpokladajme, že prvýkrát spúšťame logstash, ale už máme logy a chceli by sme ich spracovať.
Ak spustíme logstash s input sekciou, ktorú sme použili vyššie, nič nedostaneme. Len nové riadky budú spracované logstashom.
Aby sa načítali riadky z existujúcich súborov, musíme pridať do input sekcie ďalší riadok:
input {
  file {
    start_position => "beginning"
    path => "/usr/share/logstash/input/*.log"
   }
  }
Je však dôležité poznamenať, že to platí len pre nové súbory, ktoré logstash ešte nevidel. Pre súbory, ktoré už boli spracované, si logstash zapamätal ich veľkosť a teraz bude brať len nové záznamy.
Zatiaľ sa zastavíme na štúdiu input sekcie. Existuje mnoho možností, ale na naše ďalšie experimenty nám to bude stačiť.
Smerovanie a transformácia údajov
Skúsime vyriešiť nasledujúcu úlohu: predpokladajme, že máme správy z jedného kanála, časť z nich sú informačné a časť sú chybové správy. Rozlišujú sa podľa tagu. Jedny sú INFO, druhé ERROR.
Musíme ich na výstupe rozdeliť. T.j. informačné správy posielame do jedného kanála a chybové správy do druhého.
Na to prejdeme od sekcie input k filter a output.
Pomocou filter sekcie rozložíme prichádzajúcu správu, čím získame hash (páry kľúč-hodnota), s ktorým už môžeme pracovať, t.j. analyzovať podľa podmienok. A v output sekcii vyberieme správy a každú pošleme do svojho kanála.
Analýza správy pomocou grok
Aby sme rozobrali textové riadky a získali z nich množinu polí, v filter sekcii existuje špeciálny plugin — grok.
Nemám v úmysle poskytnúť podrobný popis (odkazujem na ), uvediem svoj jednoduchý príklad.
Na to sa musíme dohodnúť na formáte vstupných riadkov. Mám ich takéto:
1 INFO message1
2 ERROR message2
T.j. identifikátor na prvom mieste, potom INFO/ERROR, a nakoniec nejaké slovo bez medzier.
Nie je to ťažké, ale na pochopenie princípu fungovania to stačí.
Takže v filter sekcii v plugin grok musíme definovať vzor pre analýzu našich riadkov.
Bude vyzerať takto:
filter {
  grok {
    match => { "message" => ["%{INT:message_id} %{LOGLEVEL:message_type} %{WORD:message_text}"] }
   }
  }
V podstate ide o regulárny výraz. Používajú sa už pripravené vzory, ako INT, LOGLEVEL, WORD. Ich popis a ďalšie vzory môžete nájsť na
Teraz, prechádzajúc cez tento filter, sa náš riadok premení na hash z troch polí: message_id, message_type, message_text.
Tieto sa budú zobrazovať v output sekcii.
Smerovanie správ v sekcii output pomocou príkazu if
V sekcii output, ako sme si pamätali, sme sa plánovali rozdeliť správy na dva prúdy. Jedny — ktoré sú iNFO, budeme zobrazovať na konzole, a tie s chybami budeme zapisovať do súboru.
Ako rozdelíme tieto správy? Podmienka úlohy už naznačuje riešenie — máme predsa vyhradené pole message_type, ktoré môže prijať iba dve hodnoty INFO a ERROR. Práve na jeho základe urobíme výber pomocou operátora if.
if [message_type] == "ERROR" {
        # Tu zapisujeme do súboru
       } else
     {
      # Tu zobrazujeme na stdout
    }
Opis práce s poliami a operátormi si môžete pozrieť v tejto sekcii .
Teraz k samotnému výstupu.
Výstup na konzolu, tu je to jasné — stdout {}
Ale výstup do súboru — pripomeňme si, že to všetko spúšťame z kontajnera a aby bol súbor, do ktorého zapisujeme výsledky, prístupný z vonku, musíme otvoriť túto direktórium v docker-compose.yml.
Celkovo:
Sekcia output nášho súboru vyzerá takto:
output {
  if [message_type] == "ERROR" {
    file {
          path => "/usr/share/logstash/output/test.log"
          codec => line { format => "vlastný formát: %{message}"}
         }
    } else
     {stdout {
             }
     }
  }
Do docker-compose.yml pridáme ešte jeden objem pre výstup:
version: '3'

networks:
  elk:

volumes:
  elasticsearch:
    driver: local

services:

  logstash:
    container_name: logstash_one_channel
    image: docker.elastic.co/logstash/logstash:6.3.2
    networks:
      - elk
    environment:
      XPACK_MONITORING_ENABLED: "false"
    ports:
      - 5046:5046
   volumes:
      - ./config/pipelines.yml:/usr/share/logstash/config/pipelines.yml:ro
      - ./config/pipelines:/usr/share/logstash/config/pipelines:ro
      - ./logs:/usr/share/logstash/input
      - ./output:/usr/share/logstash/output
Spúšťame, skúšame, vidíme rozdelenie na dva prúdy.
Zdroj: habr.com
