

Tento príbeh je o tom, ako používame kontajnery v produktovom prostredí, najmä pod Kubernetes. Článok je venovaný zbieraniu metrík a logov z kontajnerov, ako aj budovaniu obrazov.
Sme fintech spoločnosť Exness, ktorá vyvíja služby pre online obchodovanie a fintech produkty pre B2B a B2C. V našom R&D máme rôzne tímy, v oddelení vývoja viac ako 100 zamestnancov.
Predstavujeme tím, ktorý zodpovedá za platformu na zhromažďovanie a spúšťanie kódu našimi vývojármi. Konkrétne zodpovedáme za zhromažďovanie, uchovávanie a poskytovanie metrík, logov a udalostí z aplikácií. V súčasnosti prevádzkujeme približne tri tisícky Docker kontajnerov v produktovom prostredí, podporujeme naše big data úložisko s kapacitou 50 TB a poskytujeme architektonické riešenia, ktoré sa budujú okolo našej infraštruktúry: Kubernetes, Rancher a rôzni verejní poskytovatelia cloudových služieb.
Naša motivácia
Čo horí? Nikto nevie odpovedať. Kde je ohnisko? Ťažko sa to dá pochopiť. Kedy sa to zapálilo? Dalo by sa zistiť, ale nie hneď.
Prečo niektoré kontajnery stoja a iné spadli? Ktorý kontajner za to môže? Veď zvonku sú kontajnery rovnaké, ale vo vnútri má každý svoj vlastný Neo.
Naši vývojári sú šikovní. Vytvárajú dobré služby, ktoré prinášajú firme zisk. Ale občas sa stávajú faily, keď kontajnery s aplikáciami sú rozhádzané. Jeden kontajner spotrebúva príliš veľa CPU, iný sieť, tretí operácie vstupu-výstupu, štvrtý má dokonca nejasnú činnosť so socketmi. Všetko to zlyháva a loď potápame.
Agenti
Aby sme pochopili, čo sa deje vo vnútri, rozhodli sme sa inštalovať agentov priamo do kontajnerov.
Títo agenti sú kontrolné programy, ktoré udržujú kontajnery v takom stave, aby si navzájom neublížili. Agenti sú štandardizovaní, čo umožňuje standardizáciu prístupu k údržbe kontajnerov.
V našom prípade musia agenti poskytovať logy v štandardnom formáte, označené a s throttlingom. Musia nám tiež poskytovať štandardizované metriky, ktoré sú rozšíriteľné z pohľadu biznis aplikácií.
Agentmi sa rozumejú aj utilitky na prevádzku a údržbu, schopné pracovať v rôznych orchestrátoroch a podporujúce rôzne obrazy (Debian, Alpine, Centos a pod.).
Nakoniec musia agenti udržiavať jednoduchý CI/CD, ktorý zahŕňa Docker súbory. Inak sa loď rozpadne, pretože kontajnery sa začnú dodávať po „krivých“ koľajniciach.
Proces zostavenia a vytvorenie cieľového obrázka
Aby bolo všetko štandardizované a ovládateľné, je potrebné dodržiavať nejaký štandardný proces zostavenia. Preto sme sa rozhodli zostavovať kontajnery pomocou kontajnerov – takáto rekurzia.
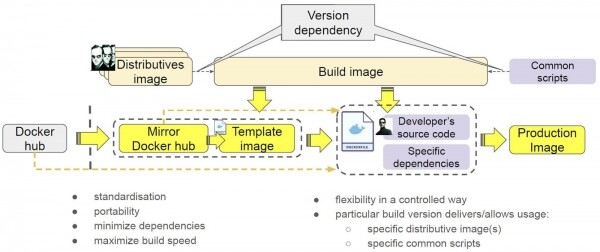
Tu sú kontajnery zobrazené ako plné obrysy. Takisto sme sa rozhodli dať do nich distribúcie, aby „život nebol taký ružový“. Prečo to bolo urobené, povieme neskôr.
V dôsledku toho vznikol nástroj na zostavenie – kontajner určitej verzie, ktorý odkazuje na určité verzie distribúcií a určité verzie skriptov.
Ako ho používame? Máme Docker Hub, v ktorom je kontajner. Zrkadlíme ho do našej siete, aby sme sa zbavili vonkajších závislostí. Vznikol kontajner, označený žltou farbou. Vytvárame šablónu, aby sme do kontajnera nainštalovali všetky potrebné distribúcie a skripty. Potom zostavíme hotový obraz: vývojári doň ukladajú kód a nejaké svoje špeciálne závislosti.
Čím je tento prístup dobrý?
- Po prvé, kompletný verzionálny kontrolný nástroj zostavenia – kontajner zostavenia, verzie skriptov a distribúcií.
- Po druhé, dosiahli sme štandardizáciu: rovnakým spôsobom vytvárame šablóny, medzičlánky a hotové obrazce.
- Po tretie, kontajnery nám zabezpečujú prenosnosť. Dnes používame Gitlab, zajtra prejdeme na TeamCity alebo Jenkins a presne takto budeme môcť spúšťať naše kontajnery.
- Po štvrté, minimalizácia závislostí. Nezávisle sme uložili distribúcie do kontajnera, pretože to umožňuje nekonečne ich sťahovať znova a znova z Internetu.
- Po piate, zvýšila sa rýchlosť zostavenia – prítomnosť miestnych kópií obrazov umožňuje nestrácať čas sťahovaním, pretože máme miestny obraz.
Inými slovami, dosiahli sme kontrolovaný a flexibilný proces zostavenia. Používame rovnaké prostriedky na zostavenie akýchkoľvek kontajnerov s kompletným verzionovaním.
Ako funguje náš postup zostavenia
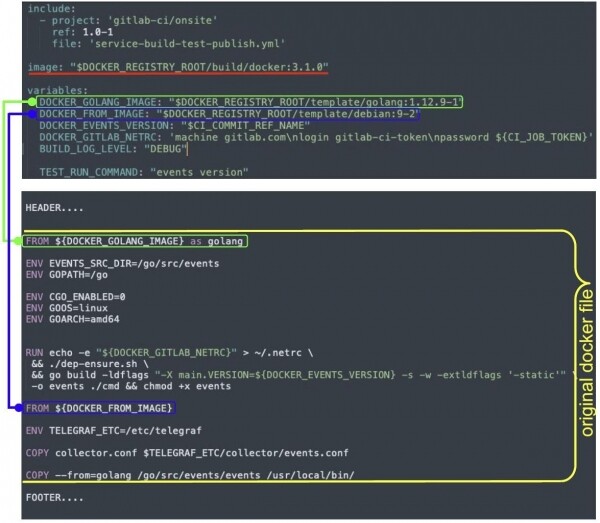
Spustenie sa realizuje jedným príkazom, proces prebieha v obraze (vyznačený červenou). Vývojár má Docker súbor (vyznačený žltou), ktorý renderujeme nahradením premenných hodnotami. A súčasne pridávame header a footer — to sú naši agenti.
Header pridáva distribúcie z príslušných obrazov. A footer nastavuje naše služby, konfiguruje spustenie pracovnej záťaže, logovanie a iných agentov, nahrádza entrypoint atď.
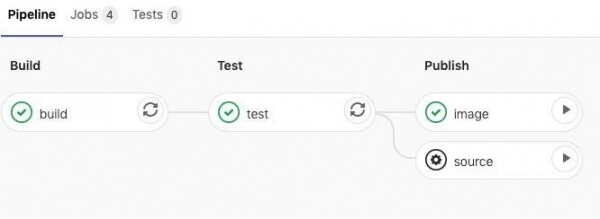
Dlho sme rozmýšľali, či nasadiť supervízor. Nakoniec sme sa rozhodli, že ho potrebujeme. Vybrali sme S6. Supervízor zabezpečuje správu kontajnera: umožňuje pripojiť sa k nemu v prípade pádu hlavného procesu a zabezpečuje ručné riadenie kontajnera bez jeho znovuvytvárania. Logy a metriky — to sú procesy vykonávané vnútri kontajnera. Tiež ich musíme nejakým spôsobom kontrolovať, a to robíme pomocou supervízora. Nakoniec S6 preberá vykonávanie housekeeping, spracovanie signálov a ďalšie úlohy.
Keďže používame rôzne orchestračné systémy, po zostavení a spustení by mal kontajner pochopiť, v akom prostredí sa nachádza, a konať podľa situácie. Napríklad:
To nám umožňuje zostaviť jeden obraz a spustiť ho v rôznych orchestračných systémoch, pričom spustenie bude zohľadňovať špecifiká daného orchestračného systému.
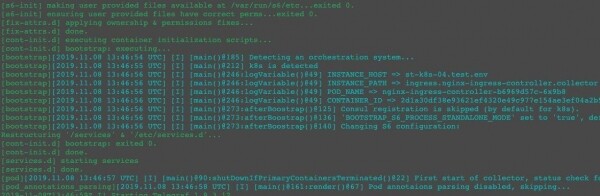
Pre ten istý kontajner získavame rôzne procesné stromy v Docker a Kubernetes:
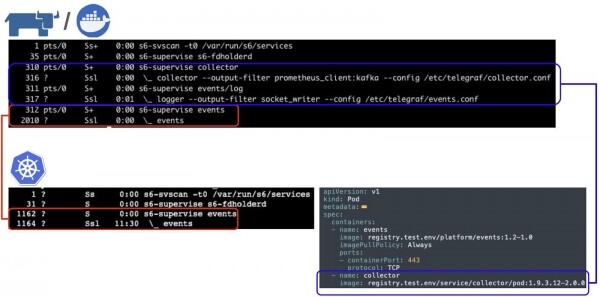
Načítanie sa vykonáva pod supervízorom S6. Upozorňujeme na collector a events — to sú naši agenti, ktorí sú zodpovední za logy a metriky. V Kubernetes ich nie je, zatiaľ čo v Dockeri sú. Prečo?
Ak sa pozrieme na špecifikáciu „podu“ (tu a ďalej – Kubernetes pod), uvidíme, že kontajner events beží v podu, v ktorom je samostatný kontajner collector, ktorý vykonáva funkciu zbierania metrík a logov. Môžeme využiť možnosti Kubernetes: spúšťanie kontajnerov v jednom pode, v jedinom procesnom a/alebo sieťovom priestore. Fakticky implementovať vlastných agentov a vykonávať nejaké funkcie. A ak sa tento istý kontajner spustí v Dockeri, dostane na výstupe všetky rovnaké možnosti, teda bude môcť dodávať logy a metriky, pretože agenti budú spustené vnútri.
Metriky a logy
Dodávanie metrík a logov je zložitá úloha. S jej riešením sú spojené rôzne aspekty.
Infrastruktúra sa vytvára na vykonávanie užitočnej záťaže, nie na masovú distribúciu protokolov. To znamená, že tento proces by mal prebiehať s minimálnymi požiadavkami na zdroje kontajnerov. Snažíme sa pomôcť našim vývojárom: „Zoberte kontajner z Docker Hub, spustite ho a my sa postaráme o doručenie protokolov.“
Druhý aspekt - obmedzenie objemu protokolov. Ak sa v niekoľkých kontajneroch vyskytne situácia s nárastom objemu protokolov (aplikácia v cykle vy/exportuje stack-trace), zvyšuje sa zaťaženie CPU, komunikačných kanálov, systému spracovania protokolov, a to ovplyvňuje činnosť hostiteľa ako celku a iných kontajnerov na hostiteľovi, čo niekedy vedie k „pádu“ hostiteľa.
Tretí aspekt - je potrebné podporovať čo najviac metód zberu metrických údajov už vo výchozom stave. Od čítania súborov a zisťovania Prometheus-endpoint po používanie špecifických protokolov aplikácií.
A posledný aspekt - je potrebné minimalizovať spotrebu zdrojov.
Vybrali sme open-source riešenie na Go s názvom Telegraf. Toto je univerzálny konektor, ktorý podporuje viac ako 140 typov vstupných kanálov (input plugins) a 30 typov výstupných (output plugins). Upravené, a teraz vám ukážeme, ako ho používame na príklade Kubernetes.
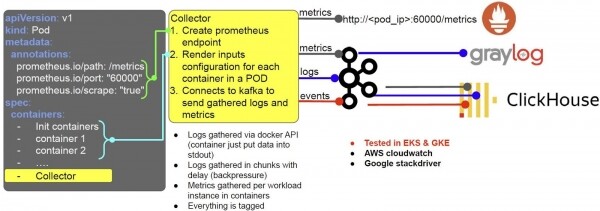
Predpokladajme, že vývojár nasadzuje záťaž a Kubernetes dostáva požiadavku na vytvorenie podu. V tomto okamihu sa pre každý pod automaticky vytvorí kontajner s názvom Collector (používame mutation webhook). Collector je náš agent. Pri štarte tento kontajner nastavuje seba na prácu s Prometheus a systémom zberu protokolov.
- Na tento účel využíva anotácie podu a v závislosti od jej obsahu vytvára, povedzme, koncovú bodovú promethus end-point;
- Na základe špecifikácie podu a špecifických nastavení kontajnerov určuje spôsob doručenia protokolov.
Protokoly zbierame cez Docker API: vývojárom stačí uložiť ich do stdout alebo stderr, a potom sa o to Collector postará. Protokoly sa zbierajú vo fragmentoch s určitým oneskorením, aby sa predišlo možnému preťaženiu hostiteľa.
Metriky sa zbierajú podľa inštancií pracovnej záťaže (procesy) v kontajneroch. Všetko je označené tagmi: namespace, pod a tak ďalej, a potom sa konvertuje do formátu Prometheus - a stáva sa dostupným na zber (okrem protokolov). Okrem toho protokoly, metriky a udalosti posielame do Kafky a ďalej:
- Protokoly sú dostupné v Graylogu (na vizuálnu analýzu);
- Logy, metriky, udalosti sa odosielajú do Clickhouse na dlhodobé uloženie.
Rovnako to funguje aj v AWS, len nahrádzame Graylog s Kafka za Cloudwatch. Odosielame tam logy, a všetko je veľmi pohodlné: hneď je jasné, ku ktorému klasteru a kontajneru patria. To isté platí aj pre Google Stackdriver. Naša schéma teda funguje rovnako on-premise s Kafka aj v oblaku.
Ak nemáme Kubernetes s podmi, schéma je o niečo zložitejšia, ale funguje na rovnakých princípoch.
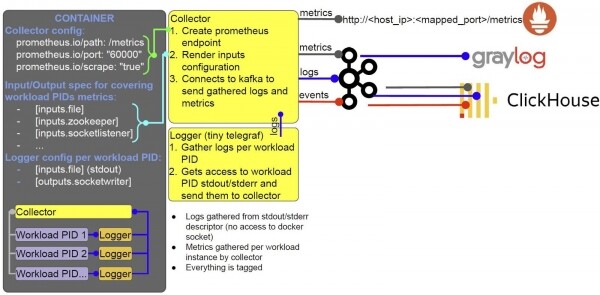
Vo vnútri kontajnera sa vykonávajú rovnaké procesy, ktoré sú orchestrálne riadené pomocou S6. Všetky tie isté procesy sú spustené v rámci jedného kontajnera.
Nakoniec
Vytvorili sme integrované riešenie na zostavenie a spustenie obrazov do prevádzky, s možnosťami zberu a dodávania logov a metrík:
- Vyvinuli sme štandardizovaný prístup k zostavovaniu obrazov a na jeho základe sme vyvinuli CI šablóny;
- Agenti na zber dát sú naše rozšírenia Telegraf. Dobre sme ich otestovali v produkcii;
- Používame mutation webhook na nasadzovanie kontajnerov s agentmi v podoch;
- Integrovali sme sa do ekosystému Kubernetes/Rancher;
- Môžeme spúšťať rovnaké kontajnery v rôznych orchestračných systémoch a dosiahnuť očakávaný výsledok;
- Vytvorili sme úplne dynamickú konfiguráciu riadenia kontajnerov.
Spoluautor: Ilya Prudnikov
Zdroj: habr.com
