

Webové aplikácie sú dnes využívané povinne, pričom HTTP zaberá veľkú časť medzi všetkými transportnými protokolmi. Pri skúmaní nuáns vývoja webových aplikácií väčšina venovala veľmi málo pozornosti operačnému systému, na ktorom tieto aplikácie reálne bežia. Rozdelenie vývoja (Dev) a prevádzky (Ops) len zhoršovalo situáciu. Avšak, s rozšírením kultúry DevOps, vývojári začínajú prevziať zodpovednosť za spúšťanie svojich aplikácií v cloude, a preto je pre nich veľmi užitočné dôkladne porozumieť backendu operačného systému. To je obzvlášť užitočné, ak sa snažíte nasadiť systém pre tisíce alebo desiatky tisíc simultánnych pripojení.
Obmedzenia vo webových službách sú veľmi podobné obmedzeniam v iných aplikáciách. Či už sa jedná o vyvažovače zaťaženia alebo servery DB, všetky tieto aplikácie čelí podobným problémom vo vysoko výkonnom prostredí. Pochopenie týchto základných obmedzení a spôsobov, ako ich prekonať, vám celkovo umožní odhadnúť výkonnosť a škálovateľnosť vašich webových aplikácií.
Píšem túto sériu článkov ako reakciu na otázky mladých vývojárov, ktorí chcú byť dobre informovanými systémovými architektmi. Nie je možné jasne porozumieť metódam optimalizácie aplikácií Linux, pokiaľ sa neposuniete do základov, ako fungujú na úrovni operačného systému. Hoci existuje veľa typov aplikácií, v tomto cykle chcem skúmať sieťové aplikácie, a nie desktopové, ako sú prehliadač alebo textový editor. Tento materiál je určený pre vývojárov a architektov, ktorí chcú pochopiť, ako fungujú programy Linux alebo Unix a ako ich štruktúrovať pre vysoký výkon.
Linux je serverový operačný systém a väčšinou vaše aplikácie bežia práve na tejto OS. Aj keď hovorím „Linux“, väčšinu času môžete s dôverou predpokladať, že sa má na mysli všetky Unix-podobné operačné systémy ako celok. Napriek tomu som neskúšal sprievodný kód na iných systémoch. Takže ak vás zaujíma FreeBSD alebo OpenBSD, výsledok sa môže líšiť. Keď vyskúšam niečo špecifické pre Linux, upozorním na to.
Aj keď môžete využiť získané vedomosti na vytvorenie aplikácie od nuly a bude skvele optimalizovaná, nie je to najlepší prístup. Ak napíšete nový webový server v C alebo C++ pre obchodnú aplikáciu vašej organizácie, možno to bude váš posledný deň v práci. Avšak poznanie štruktúry týchto aplikácií pomôže pri výbere už existujúcich programov. Budete môcť porovnávať systémy na základe procesov so systémami na základe vlákien, ako aj na základe udalostí. Pochopíte a oceníte, prečo Nginx funguje lepšie ako Apache httpd, prečo aplikácia Python založená na Tornade môže obsluhovať viac používateľov v porovnaní s aplikáciou Python založenou na Djangou.
ZeroHTTPd: vzdelávací nástroj
— webový server, ktorý som napísal od základov v C ako vzdelávací nástroj. Nemá žiadne externé závislosti, vrátane prístupu k Redis. Spúšťame naše vlastné procedúry Redis. Viac informácií nájdete nižšie.
Aj keď by sme mohli dlho diskutovať o teórii, nie je nič lepšie, než napísať kód, spustiť ho a porovnať medzi sebou všetky architektúry serverov. Je to najprezieravejší prístup. Preto budeme písať jednoduchý webový server ZeroHTTPd, pričom použijeme každý model: na základe procesov, vlákien a udalostí. Otestujeme každý z týchto serverov a pozrieme sa, ako fungujú v porovnaní navzájom. ZeroHTTPd je implementovaný v jednom súbore C. Súčasťou servera na základe udalostí je , výborná implementácia hashovacej tabuľky, ktorá je dodávaná v jednom hlavičkovom súbore. V ostatných prípadoch nie sú žiadne závislosti, aby sa projekt zbytočne nezložil.
V kóde je veľa komentárov, ktoré pomáhajú s pochopením. Ako jednoduchý webový server s niekoľkými riadkami kódu, ZeroHTTPd predstavuje aj minimálny rámec pre webový vývoj. Má obmedzenú funkcionalitu, ale dokáže dodávať statické súbory a veľmi jednoduché „dynamické“ stránky. Musím povedať, že ZeroHTTPd je vhodný na učenie, ako vytvárať vysokovýkonné aplikácie na Linuxe. Vo všeobecnosti väčšina webových služieb čaká na požiadavky, kontroluje ich a spracováva. To presne bude robiť ZeroHTTPd. Je to vzdelávací nástroj, nie nástroj pre produkciu. Nie je silný v spracovaní chýb a ťažko sa môže pochváliť najlepšími praktikami zabezpečenia (áno, použil som strcpy) alebo zložitými trikmi jazyka C. Ale dúfam, že si so svojou úlohou poradí dobre.
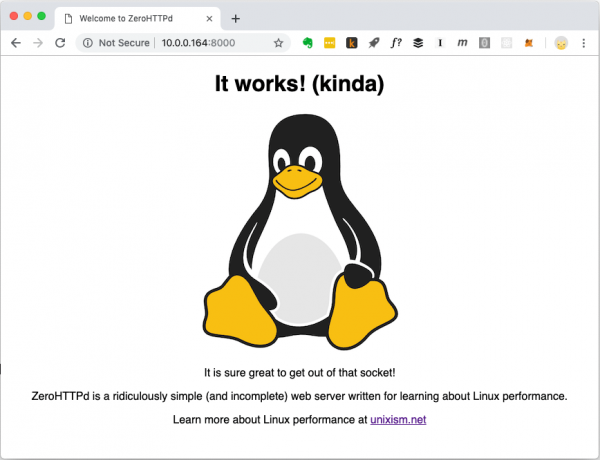
Úvodná stránka ZeroHTTPd. Môže poskytovať rôzne typy súborov, vrátane obrázkov
Aplikácia pre návštevnú knihu
Moderné webové aplikácie zvyčajne nie sú obmedzené na statické súbory. Majú zložitú interakciu s rôznymi databázami, cache a pod. Preto vytvoríme jednoduchú webovú aplikáciu nazvanú „Návštevná kniha“, kde návštevníci zanechávajú poznámky pod svojimi menami. V návštevnej knihe sa uchovávajú poznámky zanechané predtým. Na spodnej časti stránky je tiež počítadlo návštevníkov.
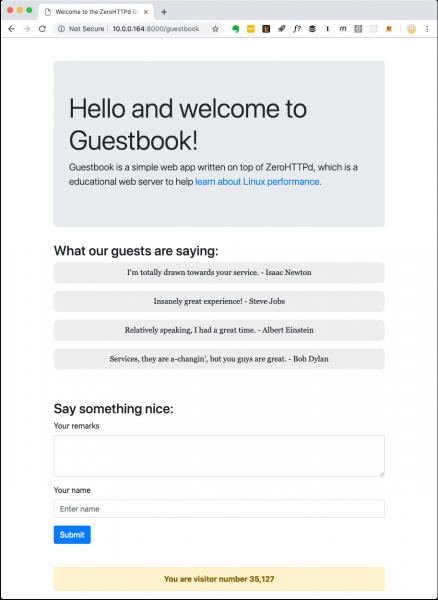
Webová aplikácia „Návštevná kniha“ ZeroHTTPd
Počítadlo návštevníkov a záznamy návštevnej knihy sa uchovávajú v Redis. Na komunikáciu s Redis boli implementované vlastné procedúry, ktoré nezávisia od externých knižníc. Nie som veľkým fanúšikom používania domáceho kódu, keď existujú verejne dostupné a dobre testované riešenia. Ale cieľom ZeroHTTPd je preskúmať výkon Linuxu a prístup k externým službám, zatiaľ čo spracovanie HTTP požiadaviek má výrazný dopad na výkon. Musíme mať úplnú kontrolu nad komunikáciou s Redis vo všetkých našich serverových architektúrach. V jednej architektúre používame blokujúce volania, v iných procedúry založené na udalostiach. Použitie externých klientských knižníc Redis nám nedá takú kontrolu. Okrem toho náš malý klient Redis vykonáva len niekoľko funkcií (získanie, nastavenie a zvýšenie kľúča; získanie a pridanie do poľa). Navyše, protokol Redis je mimoriadne elegantný a jednoduchý. Ani sa ho netreba špeciálne učiť. Skutočnosť, že celú prácu protokol vykonáva približne v sto riadkoch kódu, hovorí o tom, ako dobre je navrhnutý.
Na nasledujúcom obrázku sú zobrazené činnosti aplikácie, keď klient (prehliadač) požiada /guestbookURL.

Mechanizmus fungovania aplikácie návštevnej knihy
Keď je potrebné zobraziť stránku knihy hostí, dochádza k jednému volaniu do súborového systému na načítanie šablóny do pamäte a k trom sieťovým volaniam na Redis. Súbor šablóny obsahuje väčšinu obsahu HTML pre stránku na snímke hore. Obsahuje tiež špeciálne zástupné symboly pre dynamickú časť obsahu: záznamy a počítadlo návštevníkov. Získavame ich z Redis, vložíme na stránku a zákazníkovi poskytneme úplne vytvorený obsah. Tretie volanie Redis sa dá vyhnúť, pretože Redis vracia novú hodnotu kľúča pri zvýšení. Pre náš server s asynchrónnou architektúrou založenou na udalostiach je však množstvo sieťových volaní dobrým testom v učebných účeloch. Takže ignorujeme vrátenú hodnotu Redis o počte návštevníkov a žiadame ju samostatným volaním.
Serverové architektúry ZeroHTTPd
Staviame sedem verzií ZeroHTTPd s rovnakou funkcionalitou, ale rôznymi architektúrami:
- Iteratívna
- Fork server (jedno podproces na požiadavku)
- Pre-fork server (predbežné forkovanie procesov)
- Server s vláknami (jedno vlákno na požiadavku)
- Server s predbežným vytvorením vlákien
- Architektúra založená na
poll() - Architektúra založená na
epoll
Meráme výkon každej architektúry tým, že zaťažíme server HTTP požiadavkami. Pri porovnávaní architektúr s vysokou mierou paralelnosti sa počet požiadaviek zvyšuje. Testujeme trikrát a počítame priemer.
Metodológia testovania
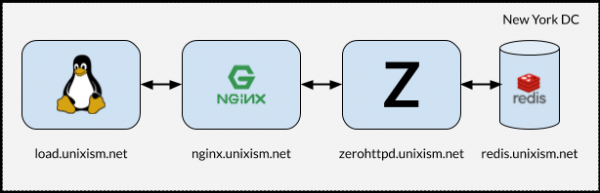
Nastavenie na záťažové testovanie ZeroHTTPd
Je dôležité, aby počas testovania všetky komponenty nepracovali na jednom stroji. V tomto prípade operačný systém nesie dodatočné náklady na plánovanie, pretože komponenty súťažia o CPU. Meranie nákladov operačného systému pri každej z vybraných serverových architektúr je jedným z najdôležitejších cieľov tohto cvičenia. Pridanie väčšieho počtu premenných by sa stalo škodlivým pre proces. Preto nastavenie na obrázku vyššie funguje najlepšie.
Čo robí každý z týchto serverov
- load.unixism.net: tu spúšťame
ab, utilitu Apache Benchmark. Generuje záťaž potrebnú na testovanie našich serverových architektúr. - nginx.unixism.net: Niekedy chceme spustiť viac ako jednu inštanciu serverovej aplikácie. Na to funguje server Nginx s príslušnými nastaveniami ako vyrovnávač záťaže pre ab naše serverové procesy.
- zerohttpd.unixism.net: tu spúšťame naše serverové aplikácie na siedmich rôznych architektúrach, jednu po druhej.
- redis.unixism.net: na tomto serveri beží démon Redis, kde sú uložené zápisy v návštevnej knihe a počítadlo návštevníkov.
Všetky servery fungujú na jednom procesorovom jadre. Myšlienka je posúdiť maximálny výkon každej z architektúr. Všetky serverové aplikácie sa testujú na jednom hardvéri, to je základná úroveň pre ich porovnanie. Moja testovacia inštalácia pozostáva z virtuálnych serverov prenajatých od Digital Ocean.
Čo meráme?
Môžeme merať rôzne ukazovatele. Posudzujeme výkon každej architektúry v tejto konfigurácii, zaťažením serverov požiadavkami na rôznych úrovniach paralelizmu: zaťaženie rastie od 20 do 15 000 súbežných používateľov.
Výsledky testov
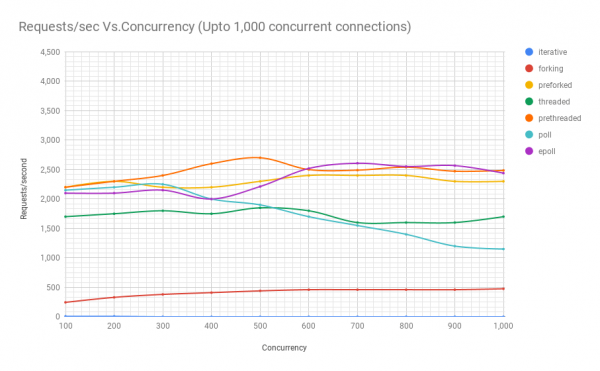
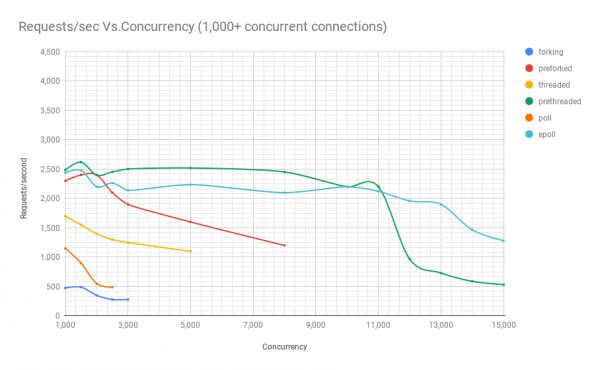
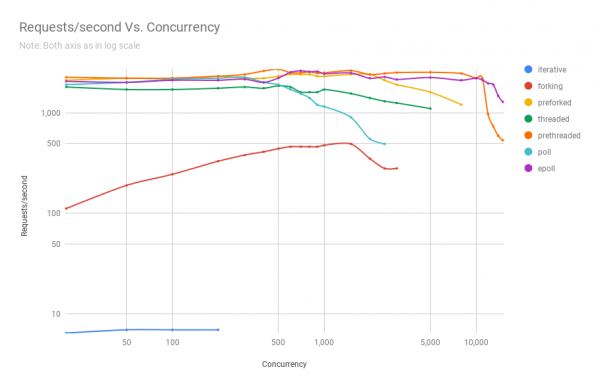
Na nasledujúcom grafe je zobrazený výkon serverov na rôznej architektúre pri rôznych úrovniach paralelizmu. Po osi y je množstvo požiadaviek za sekundu, po osi x sú súbežné pripojenia.
Nižšie je tabuľka s výsledkami.
požiadaviek za sekundu
paralelizmus
iteratívny
fork
pre-fork
vláknový
pre-vláknový
poll
epoll
20
7
112
2100
1800
2250
1900
2050
50
7
190
2200
1700
2200
2000
2000
100
7
245
2200
1700
2200
2150
2100
200
7
330
2300
1750
2300
2200
2100
300
–
380
2200
1800
2400
2250
2150
400
–
410
2200
1750
2600
2000
2000
500
–
440
2300
1850
2700
1900
2212
600
–
460
2400
1800
2500
1700
2519
700
–
460
2400
1600
2490
1550
2607
800
–
460
2400
1600
2540
1400
2553
900
–
460
2300
1600
2472
1200
2567
1000
–
475
2300
1700
2485
1150
2439
1500
–
490
2400
1550
2620
900
2479
2000
–
350
2400
1400
2396
550
2200
2500
–
280
2100
1300
2453
490
2262
3000
–
280
1900
1250
2502
veľký rozptyl
2138
5000
–
veľký rozptyl
1600
1100
2519
–
2235
8000
–
–
1200
veľký rozptyl
2451
–
2100
10 000
–
–
veľký rozptyl
–
2200
–
2200
11 000
–
–
–
–
2200
–
2122
12 000
–
–
–
–
970
–
1958
13 000
–
–
–
–
730
–
1897
14 000
–
–
–
–
590
–
1466
15 000
–
–
–
–
532
–
1281
Z grafu a tabuľky je vidno, že nad 8000 súbežných požiadaviek zostávajú iba dvaja hráči: pre-fork a epoll. Pri rastúcom zaťažení server založený na poll vykazuje horší výkon ako vláknový. Architektúra s predbežným vytvorením vlákien pozostáva z kvalitnej konkurencie pre epoll: to naznačuje, aké dobre plánuje Linuxové jadro veľký počet vlákien.
Zdrojový kód ZeroHTTPd
Zdrojový kód ZeroHTTPd . Pre každú architektúru osobitný adresár.
ZeroHTTPd
│
├── 01_iterative
│   ├── main.c
├── 02_forking
│   ├── main.c
├── 03_preforking
│   ├── main.c
├── 04_threading
│   ├── main.c
├── 05_prethreading
│   ├── main.c
├── 06_poll
│   ├── main.c
├── 07_epoll
│    └── main.c
├── Makefile
├── public
│   ├── index.html
│   └── tux.png
└── templates
    └── guestbook
        └── index.html
Okrem siedmich adresárov pre všetky architektúry sú v koreňovom adresári ešte dve: public a templates. V prvom sa nachádza súbor index.html a obrázok z prvého screenshotu. Môžete sem umiestniť ďalšie súbory a priečinky a ZeroHTTPd by mal bez problémov vydať tieto statické súbory. Ak cesta v prehliadači zodpovedá ceste v priečinku public, ZeroHTTPd hľadá v tomto adresári súbor index.html. Obsah pre knihu hostí sa generuje dynamicky. Má iba hlavnú stránku a jej obsah je založený na súbore ‘templates/guestbook/index.html’. Do ZeroHTTPd sa ľahko pridávajú dynamické stránky na rozšírenie. Myšlienkou je, že používatelia môžu do tohto adresára pridávať šablóny a rozširovať ZeroHTTPd podľa potreby.
Aby ste zostavili všetkých sedem serverov, spustite make all z koreňového adresára — a všetky zostavy sa zobrazia v tomto adresári. Spustiteľné súbory hľadajú adresáre public a templates v tom adresári, z ktorého sú spúšťané.
Linux API
Aby ste pochopili informácie v tomto cykle článkov, nie je potrebné rozumieť Linux API naozaj dobre. Odporúčam prečítať si viac o tejto téme, na internete je množstvo referenčných zdrojov. Hoci sa dotkneme niekoľkých kategórií Linux API, našu pozornosť budeme sústreďovať predovšetkým na procesy, vlákna, udalosti a sieťový zásobník. Okrem kníh a článkov o Linux API odporúčam tiež prečítať si man stránky pre systémové volania a používané knižničné funkcie.
Výkon a škálovateľnosť
Jedna poznámka k výkonu a škálovateľnosti. Teoreticky medzi nimi neexistuje žiadny vzťah. Môžete mať webovú službu, ktorá funguje veľmi dobre, s časom odozvy v niekoľkých milisekundách, ale v skutočnosti sa vôbec neškáluje. Presne tak môže existovať zle fungujúca webová aplikácia, ktorá potrebuje niekoľko sekúnd na odpoveď, ale je schopná škálovať na desiatky na spracovanie desiatok tisíc súbežných používateľov. Napriek tomu kombinácia vysokej výkonnosti a škálovateľnosti je veľmi silná kombinácia. Vysokovýkonné aplikácie zvyčajne hospodárne využívajú zdroje a tým pádom efektívne obsluhujú viac súbežných používateľov na serveri, čím znižujú náklady.
Úlohy CPU a I/O
Nakoniec, vo výpočtoch existujú vždy dva možné typy úloh: pre I/O a CPU. Získavanie požiadaviek cez internet (sieťový vstup-výstup), správa súborov (sieťový a diskový vstup-výstup), komunikácia s databázou (sieťový a diskový vstup-výstup) — to všetko sú akcie I/O. Niektoré požiadavky na DB môžu mierne zaťažiť CPU (triedenie, výpočet priemeru milióna výsledkov atď.). Väčšina webových aplikácií je obmedzená maximálnym I/O, zatiaľ čo procesor sa zriedka využíva na plnú kapacitu. Keď vidíte, že v nejakej úlohe vstupu-výstupu sa využíva veľa CPU, pravdepodobne ide o znak zlej architektúry aplikácie. Môže to znamenať, že prostriedky CPU sa míňajú na správu procesov a prepínanie kontextu — a to nie je veľmi užitočné. Ak robíte niečo ako spracovanie obrázkov, prevod audio súborov alebo strojové učenie, potom aplikácia potrebuje silné prostriedky CPU. Ale pre väčšinu aplikácií to tak nie je.
Podrobnejšie o serverových architektúrach
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish