

Odporúčam vám oboznámiť sa s prehľadom správy Nikolaja Samochvalova "Prmyselný prístup k ladenie PostgreSQL: experimenty nad databázami"
Shared_buffers = 25 % – je to veľa alebo málo? Alebo akurát? Ako zistiť, či je toto – pomerne zastarané – odporúčanie vhodné vo vašom konkrétnom prípade?
Prišiel čas zaoberať sa otázkou výberu parametrov postgresql.conf "dospelo". Nie pomocou slepých "autotunerov" alebo zastaraných rád z článkov a blogov, ale na základe:
- prísne overených experimentov na DB, vykonávaných automatizovane, vo veľkom množstve a za podmienok najviac príbuzných "bojovým".
- hlbokého porozumenia zvláštnostiam fungovania DBMS a OS.
Používajúc Nancy CLI (), preskúmame konkrétny príklad – notoricky známe shared_buffers – v rôznych situáciách, v rôznych projektoch a pokúsime sa zistiť, ako zvoliť optimálne nastavenie pre našu infraštruktúru, DB a záťaž.
Hovoríme o experimentoch nad databázami. Je to príbeh, ktorý trvá už viac ako pol roka.
Niečo o mne. Skúsenosti s Postgres už viac ako 14 rokov. Rôzne spoločnosti som založil v oblasti sociálnych sietí. Všade bol Postgres a stále sa používa.
A tiež skupina RuPostgres na Meetup, 2. miesto na svete. Pomaly sa blížime k 2 000 ľuďom. RuPostgres.org.
A na rôznych konferenciách vrátane Highload, zodpovedám za databázy, najmä Postgres od ich vzniku.
A v posledných niekoľkých rokoch som obnovil svoju prax v Postgres konzultácií v 11 časových zónach odtiaľto.
A keď som to urobil pred niekoľkými rokmi, mal som určité prerušenie aktívneho ručného práce s Postgresom, pravdepodobne od roku 2010. Prekvapilo ma, ako málo sa zmenil pracovný deň DBA, ako veľa ručnej práce je stále potrebné. A hneď sme si pomyslel, že tu niečo nie je v poriadku, je potrebné automatizovať oveľa viac.
A keďže to všetko bolo v odľahlých oblastiach, väčšina klientov bola v cloude. A už sa veľa automatizovalo, to je jasné. O tom neskôr. T.j. všetko to vyústilo do myšlienky, že musí existovať množstvo nástrojov, t.j. akási platforma, ktorá automatizuje prakticky všetky činnosti DBA, aby sa dalo spravovať veľké množstvo databáz.
V tejto správe nebude:
- "Strieborné guľky" a vyhlásenia typu – nastavte 8 GB alebo 25 % shared_buffers a budete v poriadku. O shared_buffers nebude toľko.
- Hardcore „vnútornosti“.
A čo bude?
- Bude existovať množstvo princípov optimalizácie, ktoré uplatňujeme a rozvíjame. Budú rôzne nápady, ktoré nám na ceste prichádzajú na um, a rôzne nástroje, ktoré vo väčšine vytvárame v Open Source, t.j. základ robíme v Open Source. Navyše, máme tikety, takmer všetka komunikácia prebieha v Open Source. Môžete sledovať, čo teraz robíme, čo bude v nasledujúcej verzii a pod.
- A tiež budú určité skúsenosti s použitím týchto princípov a nástrojov v rade spoločností: od malých startupov po veľké firmy.
Ako sa to všetko vyvíja?
Predovšetkým je hlavným úlohou DBA okrem zabezpečenia vytvárania instances, nasadzovania záloh a pod. hľadanie úzkych miest a optimalizácia výkonu.
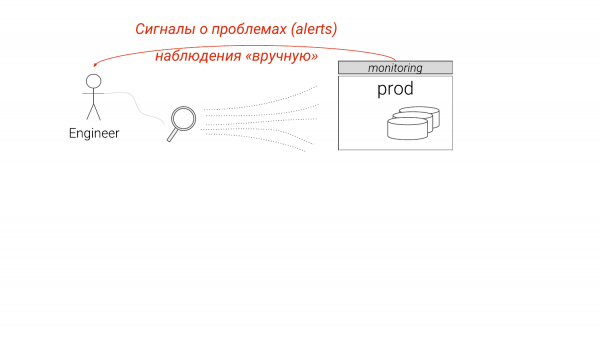
Momentálne to funguje takto. Sledujeme monitoring, niečo vidíme, niektoré podrobnosti nám chýbajú. Začíname sa dôkladnejšie skúmať, zvyčajne ručne, a chápeme, čo s tým robiť tak alebo onak.
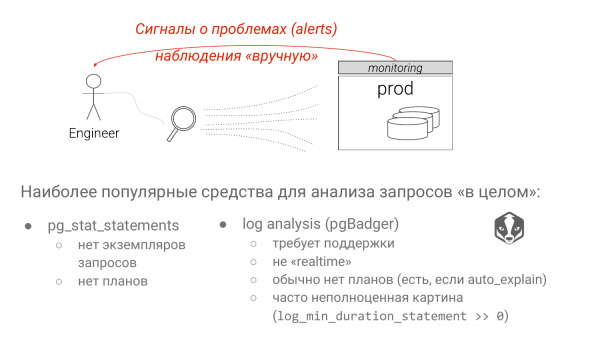
Existujú dva prístupy. Pg_stat_statements – štandardné predvolené riešenie na identifikáciu pomalých dopytov. A analýza logov Postgres pomocou pgBadger.
Oba prístupy majú vážne nedostatky. Pri prvom prístupe sú všetky parametre vynechané. A ak vidíme skupiny SELECT * FROM table where stĺpec je rovný znaku „?“ alebo „$“ od verzie Postgres 10. Nevieme, či ide o indexový prehľad alebo sekvenčný prehľad. Veľmi závisí od parametra. Použijete tam zriedkavo sa vyskytujúcu hodnotu, bude to indexový prehľad. Použijete hodnotu, ktorá zaberá 90 % tabuľky, bude to jednoznačne sekvenčný prehľad, pretože Postgres pozná štatistiku. A to je veľký nedostatok pg_stat_statements, hoci sa na tom pracuje.
Pri analýze logov je najväčší problém ten, že si nemôžete dovoliť „log_min_duration_statement = 0“, zvyčajne. A o tom budeme tiež hovoriť. Preto nevidíte celkom obrázku. A nejaký dopyt, ktorý je veľmi rýchly, môže spotrebovávať obrovské množstvo zdrojov, ale neuvidíte ho, pretože je pod vaším prahom.
Ako DBA riešia zistené problémy?
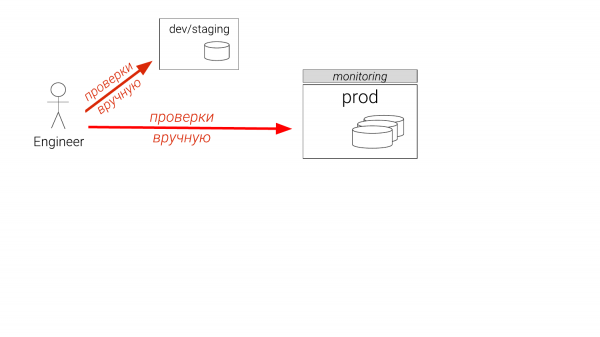
Napríklad, našli sme nejaký problém. Čo sa zvyčajne robí? Ak ste vývojár, budete niečo robiť na nejakom instanci, ktorý nie je takého rozmeru. Ak ste DBA, máte staging. A ten môže byť len jeden. A zastavil sa pred polrokom. A myslíte si, že prejdete na production. A aj skúsení DBA to potom kontrolujú na production, na replike. A niekedy vytvárajú dočasný index, presvedčia sa, že pomáha, zrušia ho a odovzdajú vývojárom, aby ho vložili do migračných súborov. Takýto nezmysel sa teraz deje. A to je tragédia.
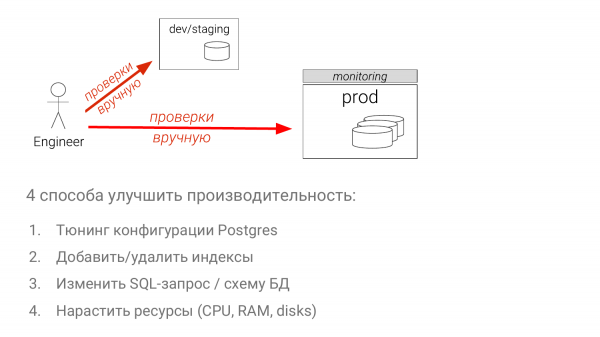
- Ladíť konfigurácie.
- Optimalizovať súbor indexov.
- Zmeniť samotný SQL dotaz (to je najkomplikovanejší spôsob).
- Pridať výkon (najjednoduchší spôsob vo väčšine prípadov).
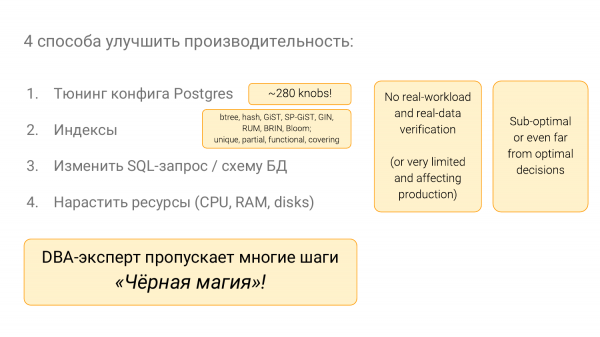
S týmito vecami je toho veľmi veľa. V PostgreSQL je veľa ovládacích prvkov. Je potrebné vedieť veľa. Mnoho indexov v PostgreSQL, vďaka aj organizátorom tejto konferencie. A všetko toto je potrebné vedieť, a práve to u nie DBA vyvoláva pocit, že sa DBA zaoberajú čiernou mágiou. T. j. je potrebné sa tomu venovať približne 10 rokov, aby ste to začali normálne chápať.
A ja som bojovník proti tejto čiernej mágii. Chcem, aby bola technológia, a nie intuícia vo všetkom tomto.
Príklady z praxe
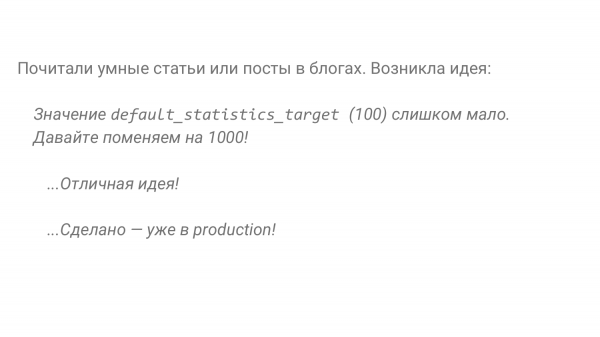
Toto som pozoroval aspoň v dvoch projektoch, vrátane svojho. Ďalší príspevok na blogu nám oznamuje, že hodnota 1 000 pre default_statistic_target – to je dobré. Dobre, skúsme to v production.
A tu sme, s naším nástrojom dva roky neskôr, pomocou experimentov s databázami, o ktorých dnes hovoríme, môžeme porovnať, čo bolo a čo sa stalo.
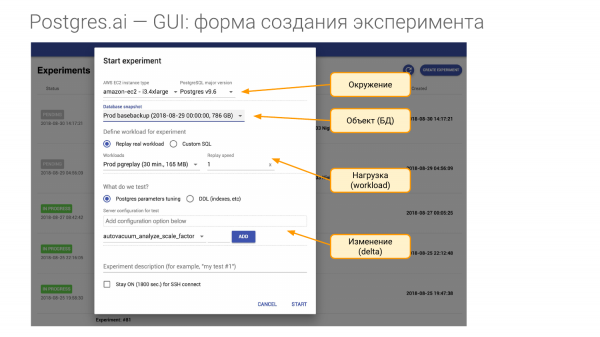
A na to potrebujeme vytvoriť experiment. Ten sa skladá zo štyroch častí.
- Prvá – to je prostredie. Potrebujeme hardvér. A keď prídem do nejakej spoločnosti a uzavriem zmluvu, hovorím, aby mi poskytli rovnaký hardvér ako na production. Pre každého z vašich majstrov potrebujem aspoň jeden takýto hardvér. Buď je to virtuálny stroj instance v Amazone alebo v Googli, alebo potrebujem presne taký istý hardvér. T. j. chcem reprodukovať prostredie. A do pojmu prostredie zahŕňame hlavnú verziu PostgreSQL.
- Druhá časť – to je objekt našich skúmaní. To je databáza. Tú je možné vytvoriť niekoľkými spôsobmi. Ukážem ako.
- Tretia časť – to je záťaž. To je najnáročnejší moment.
- A štvrtá časť je to, čo kontrolujeme, t. j. s čím budeme porovnávať. Predpokladajme, že môžeme v konfiguračnom súbore zmeniť jeden alebo niekoľko parametrov, alebo môžeme vytvoriť index a podobne.
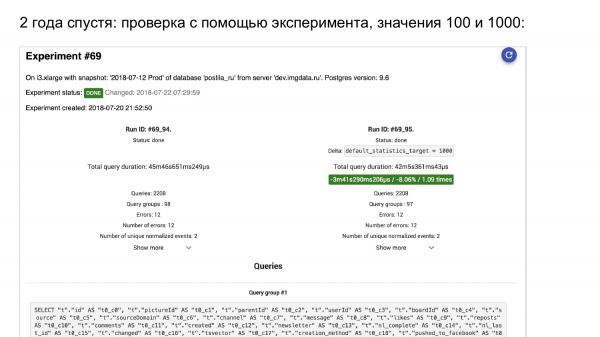
Spúšťame experiment. Tu je pg_stat_statements. Naľavo – to, čo bolo. Napravo – čo sa stalo.
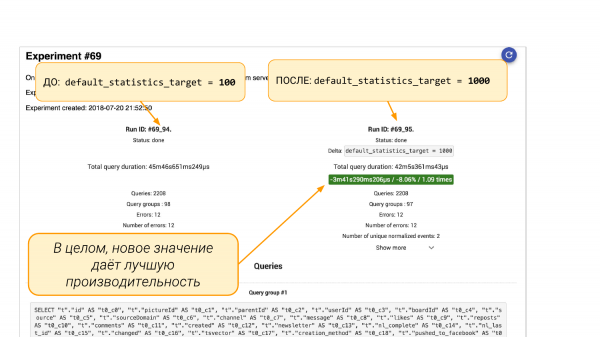
Naľavo default_statistics_target = 100, napravo = 1 000. Vidíme, že nám to pomohlo. O 8 % je to celkovo lepšie.
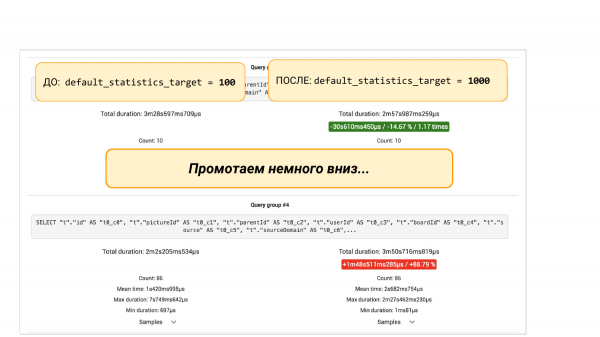
Ale ak posunieme nadol, uvidíme skupiny dopytov z pgBadger alebo pg_stat_statements. Tu sú dve možnosti. Uvidíme, že niektorý dopyt poklesol o 88 %. A tu už je inžiniersky prístup. Môžeme sa hĺbiť ďalej, pretože je zaujímavé, prečo poklesol. Musíme chápať, čo sa tam deje so štatistikami. Prečo viac bucketov v štatistikách vedie k horšiemu výsledku.
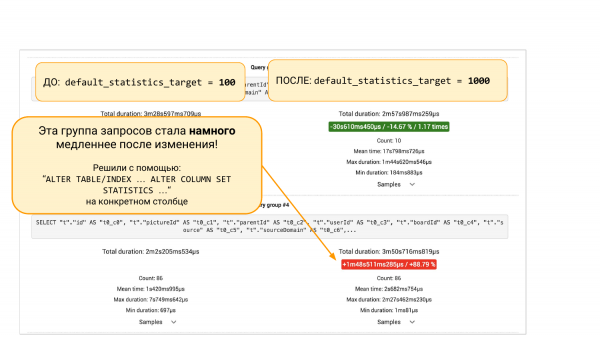
Ale môžeme sa aj neprehĺbiť, a robiť „ALTER TABLE … ALTER COLUMN“ a vrátiť mu späť 100 bucketov do štatistiky tohto stĺpca. A následne sa experimentom môžeme presvedčiť, že táto oprava pomohla. A to je inžiniersky prístup, ktorý nám pomáha vidieť celkový obraz a prijímať rozhodnutia na základe údajov, nie na základe intuície.
Niekoľko príkladov z iných oblastí. V testoch sú už mnoho rokov CI-testy. A žiaden projekt v zdravom rozume už nebude existovať bez automatických testov.
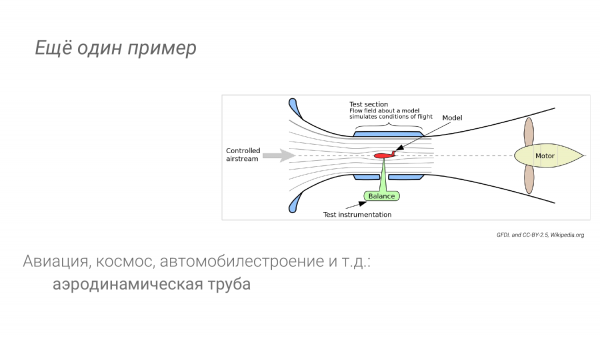
V iných oblastiach: v letectve, v automobilovom priemysle, keď testujeme aerodynamiku, máme tiež možnosť robiť experimenty. Okamžite niečo z návrhu nevypustíme do vesmíru ani nevyvedieme žiadne vozidlo na cestu. Napríklad máme aerodynamický tunel.
Z pozorovaní iných oblastí môžeme vyvodiť závery.
Po prvé, máme špeciálne prostredie. Je blízko produkcii, ale nie veľmi. Jeho najväčšou výhodou je, že by malo byť lacné, opakovateľné a maximálne automatizované. A mali by byť tiež špeciálne nástroje na podrobnú analýzu.
Pravdepodobne, keď sme spustili lietadlo a letíme, máme menej možností preskúmať každý milimeter povrchu krídla, než je to v aerodynamickom tuneli. Máme viac prostriedkov na diagnostiku. Môžeme si dovoliť pridať viac ťažkých vecí, ktoré si nemôžeme dovoliť pridať na lietadlo vo vzduchu. Rovnako je to aj s Postgresom. V niektorých prípadoch môžeme zapnúť úplné logovanie dotazov pri experimentoch. A to na produkcii nechceme robiť. Možno to aj zapneme pomocou auto_explain.
A ako som už povedal, vysoká úroveň automatizácie znamená, že sme stlačili tlačidlo a zopakovali to. Takto to má byť, aby bolo veľa experimentov, aby to bola na prúde.
Nancy CLI – základ "laboratória DB"
A tak sme vytvorili takú vec. T. j. o týchto myšlienkach som hovoril v júni, takmer pred rokom. A už máme v Open Source takzvanú Nancy CLI. To je základ na to, aby sme budovali laboratórium databáz.
– Je to v Open Source, na Gitlabe. Môžete povedať, môžete vyskúšať. Dal som tam link v snímkach. Na ňu môžete kliknúť a tam bude po všetkých parametroch.
Samozrejme, tam je ešte veľa vecí vo vývoji. Je tam množstvo nápadov. Ale toto je už to, čo aplikujeme takmer každý deň. A keď sa nám objaví myšlienka – a čo sa stane pri delete 40 000 000 riadkov, ak narazíme na IO, môžeme uskutočniť experiment a pozrieť sa, čo sa deje a potom sa pokúsiť to opraviť za pochodu. T. j. robíme experiment. Napríklad niečo upravíme a pozrieme sa, čo nakoniec vyjde. A robíme to nie na produkcii. To je podstata myšlienky.
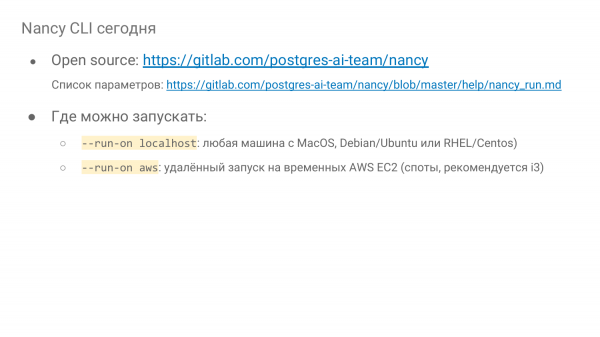
Kde to môže fungovať? Môže to fungovať lokálne, t. j. môžete to robiť kdekoľvek, môžete to dokonca spustiť na MacBooku. Potrebujete Docker, ideme. A všetko. Môžete to spustiť na nejakom instance na hardvéri alebo vo virtuálke, kdekoľvek.
Existuje tiež možnosť spúšťať vzdialene v Amazone v EC2 Instance, v spotových inštanciách. A to je naozaj skvelá možnosť. Napríklad včera sme realizovali viac ako 500 experimentov na i3 instance, od najmenšej až po i3-16-xlarge. A tých 500 experimentov nás stálo 64 dolárov. Každý trval 15 minút. T. j. vďaka použitým spotom je to naozaj lacné – zľava 70 %, platenie za sekundu v Amazone. Môžete robiť naozaj veľa. Môžete robiť reálny výskum.
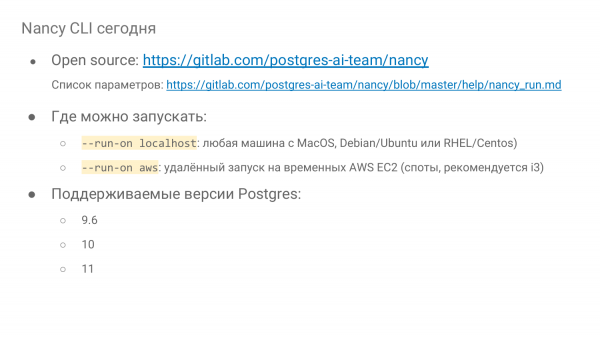
A tri hlavné verzie Postgres sú podporované. Nie je tak ťažké doladiť nejaké staré a aj novú 12. verziu.
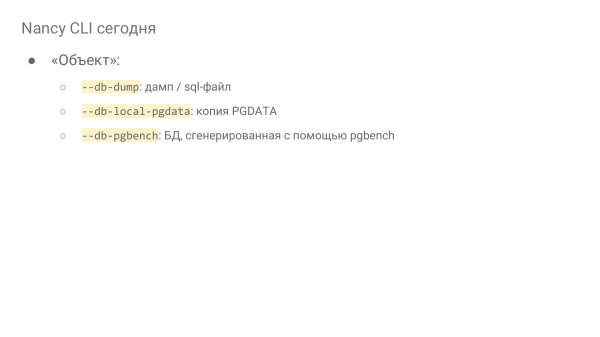
Objekt môžeme definovať tromi spôsobmi. A to sú:
- Dump/sql súbor.
- Hlavný spôsob je klon PGDATA adresára. Zvyčajne sa berie z backup servera. Ak máte normálne binárne backupy, odtiaľ môžete robiť klony. Ak máte cloud, potom sa o to postará za vás poskytovateľ cloudových služieb ako Amazon a Google. Toto je najdôležitejší spôsob pre klony reálneho produkčného prostredia. Týmto spôsobom sa práve rozvíjame.
- A posledný spôsob je vhodný pre výskum, keď máte záujem zistiť, ako v Postgres funguje nejaká vec. To je pgbench. Môžete generovať pomocou pgbench. Je to jednoducho jedna voľba „db-pgbench“. Povedzte mu, akú škálu. A všetko bude v cloude vygenerované, ako sa uvádza.
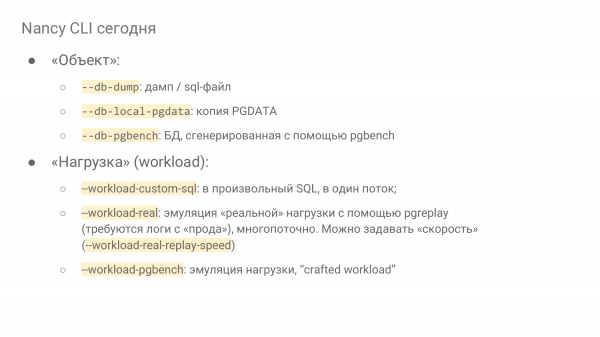
A záťaž:
- Záťaž môžeme vykonávať v jednom vlákne SQL. To je najprimitívnejší spôsob.
- Ale môžeme emulovať záťaž. A emulovať ju môžeme predovšetkým nasledujúcim spôsobom. Musíme zbierať všetky logy. A to je bolestivé. Ukážem vám, prečo. A pomocou pgreplay, ktorý je zabudovaný v Nancy, to prehrávame.
- Alebo iná varianta. Takzvaná remeselná záťaž, ktorú robíme s určitým množstvom úsilia. Analyzujúc našu aktuálnu záťaž na bojovom systéme, vyberáme top skupiny dopytov. A pomocou pgbench môžeme emulovať túto záťaž v laboratóriu.
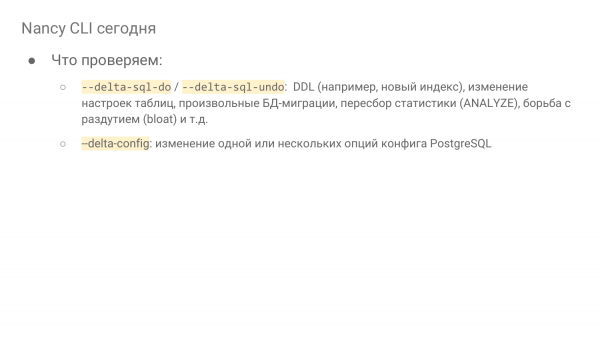
- Alebo musíme vykonať nejaký SQL, t. j. overujeme nejakú migráciu, vytvárame index, vykonávame ANALYZE. A sledujeme, čo bolo pred a po vyprázdnení. V podstate akýkoľvek SQL.
- Buď změníme jeden nebo více parametrů v konfiguračním souboru. Můžeme požádat, aby zkontrolovali například 100 hodnot na Amazonu pro naši terabajtovou databázi. A za několik hodin máte výsledek. Obvykle se terabajtová databáze rozjíždí několik hodin. Ale v návrhu je záplata, máme možnost série, tj. můžete na stejném serveru použít stejný pgdata a testovat. Postgres se restartuje, keše se vymažou. A můžete zkoušet zátěž.
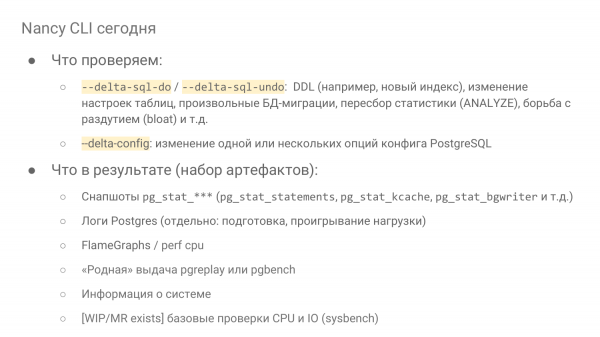
- Přijede adresář, ve kterém je spousta různých souborů, počínaje snapshoty pg.stat***. A tam je to nejzajímavější – pg_stat_statements, pg_stat_kcacke. To jsou dvě rozšíření, která analyzují dotazy. A pg_stat_bgwriter obsahuje nejen statistiky pgwriter, ale také informace o checkpointu a o tom, jak se backendy zbavují špinavých bufferů. A to všechno je zajímavé si prohlédnout. Například, když nastavujeme shared_buffers, je velmi zajímavé vidět, kolik kdo vyhnal.
- Také přicházejí logy Postgresu. Dva logy – log přípravy a log přehrávání zátěže.
- Relativně nová funkce – FlameGraphs.
- Také, pokud jste používali pgreplay nebo pgbench varianty přehrávání zátěže, zobrazí se jejich nativní výstup. A uvidíte latenci a TPS. Budete moci pochopit, jak to viděli.
- Informace o systému.
- Základní kontroly CPU a IO. To je více pro EC2 instance na Amazonu, když chcete ve streamu spustit 100 stejných instancí a tam provést 100 různých běhů, budete mít 10 000 experimentů. A musíte se ujistit, že se vám nedostala poškozená instance, kterou už někdo obtěžuje. Na tomto hardwaru jiní aktivně zůstávají a vy máte málo zdrojů. Takové výsledky je lepší vyloučit. A právě s pomocí sysbench od Alexeje Kopytova děláme několik krátkých kontrol, které přijdou a můžete je porovnat s ostatními, tj. pochopíte, jak se CPU chová a jak se IO chová.
Jaké jsou technické složitosti na příkladu různých společností?
Předpokládejme, že chceme reálně opakovat zátěž pomocí logů. Skvělý nápad, pokud je to na Open Source pgreplay napsáno. Používáme ho. Ale aby to fungovalo dobře, musíte zapnout úplné logování dotazů s parametry a časováním.
Existujú určité komplikácie, pokiaľ ide o duration a timestamp. Túto stránku úplne preskočíme. Hlavná otázka znie – môžete si to dovoliť alebo nie?
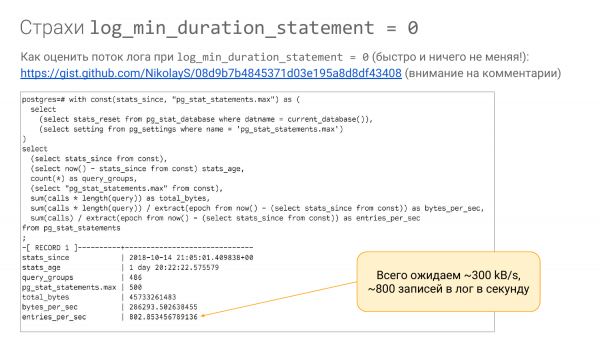
Problém je v tom, že to môže byť nedostupné. Musíte si najprv uvedomiť, aký tok sa bude zapisovať do logu. Ak máte pg_stat_statements, môžete pomocou tohto dotazu (odkaz bude k dispozícii v prezentácii) zistiť, koľko bajtov sa približne zapíše za sekundu.
Sledujeme dĺžku dotazu. Ignorujeme fakt, že tam nie sú parametre, ale vieme, aká je dĺžka dotazu a koľkokrát za sekundu bol vykonaný. Takto môžeme odhadnúť, koľko bajtov za sekundu. Môžeme sa pomýliť prípadu max. dvakrát, ale poradie určíme presne týmto spôsobom.
Vidíme, že tento dotaz sa vykonáva 802-krát za sekundu. A vidíme, že bytes_per_sec – 300 kB/s bude zapisované plus mínus. A zvyčajne si taký tok môžeme dovoliť.
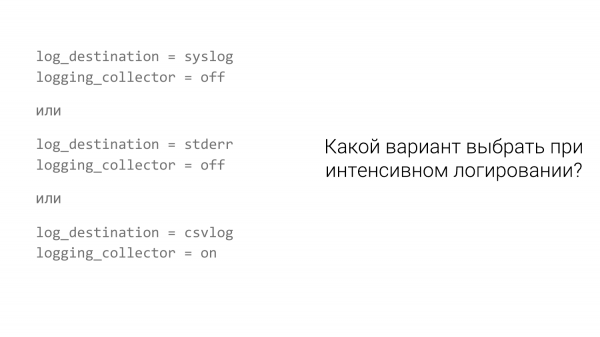
Ale! Problém je v tom, že existujú rôzne systémy logovania. A predvolene majú ľudia zvyčajne «syslog».
A ak máte syslog, môže to vyzerať takto. Vezmeme pgbench, zapneme logovanie dotazov a pozrieme sa, čo získame.
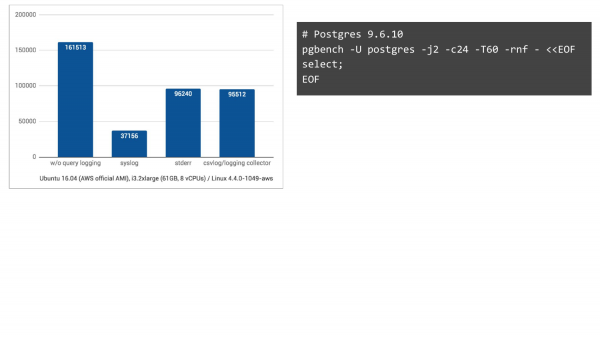
Bez logovania – to je stĺpec vľavo. Dosiahli sme 161 000 TPS. So syslogom – na Ubuntu 16.04 na Amazone máme 37 000 TPS. A ak zmeníme na dva iné spôsoby logovania, situácia sa výrazne zlepší. T. j. očakávali sme pokles, ale nie až taký.
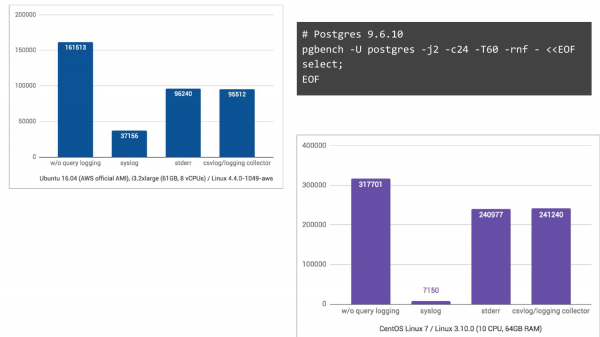
Na CentOS 7, kde sa zúčastňuje aj journald, prevádzajúci logy do binárneho formátu pre pohodlné vyhľadávanie atď., sme klesli na 44-násobne nižšiu TPS.
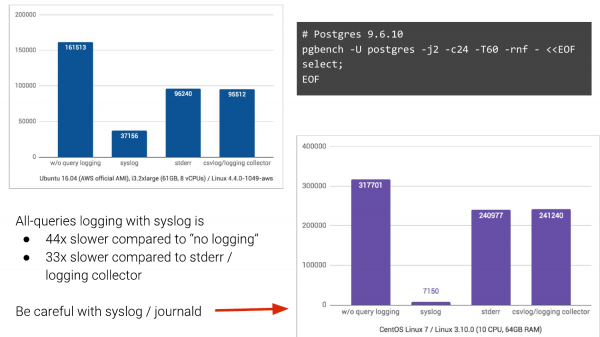
A to je niečo, s čím ľudia žijú. A často je to v spoločnostiach, najmä vo veľkých, veľmi ťažké zmeniť. Ak sa môžete od syslogu odkloniť, urobte to prosím.
- Odhadnite IOPS a zápisový tok.
- Skontrolujte svoj systém logovania.
- Ak je predpokladaná záťaž príliš vysoká, zvážte možnosti s vzorkovaním.
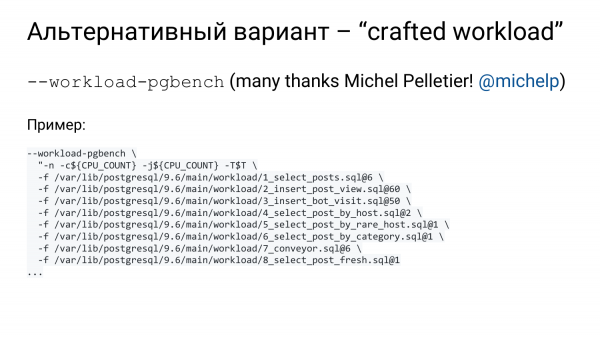
Máme pg_stat_statements. Ako som povedal, musí tam byť. A môžeme zobraziť každú skupinu dotazov špeciálnym spôsobom v súbore. A potom môžeme využiť veľmi užitočnú funkciu v pgbench – možnosť dodať niekoľko súborov pomocou možnosti «-f».
Chápe veľa "-f". A pomocou "@" na konci môžeme povedať, aká časť by mala byť pre každý súbor. T. j. môžeme povedať, že toto sa má spustiť v 10 % prípadov a toto v 20 %. A to nás priblíži k tomu, čo vidíme v produkcii.
A ako zistíme, čo máme v produkcii? Aký podiel a čo ako? Tu trochu odbočíme. Máme ešte jeden produkt. . Je to tiež databáza s otvoreným zdrojovým kódom. A v súčasnosti ju aktívne rozvíjame.
Narodil sa z trochu iných dôvodov. Z dôvodov, že monitorovanie nestačí. T. j. prijdete, pozriete sa na databázu, pozriete sa na problémy, ktoré existujú. A zvyčajne vykonávate health_check. Ak ste skúsený DBA, robíte health_check. Pozreli ste sa na využitie indexov a pod. Ak máte OKmeter, je to výborné. Je to skvelé monitorovanie pre Postgres. OKmeter.io – prosím, nainštalujte ho, je to veľmi dobre urobené. Je to platené.
Ak ho nemáte, zvyčajne nemáte veľa možností. V monitorovaní zvyčajne máte CPU, IO a to s obmedzeniami, a to je všetko. A potrebujeme viac. Musíme vidieť, ako funguje autovacuum, ako funguje checkpoint, v IO musíme oddeliť checkpoint od bgwriter a od backendov a pod.
Problém je v tom, keď pomáhate nejakej veľkej spoločnosti, nemôžu rýchlo niečo zaviesť. Nemôžu rýchlo kúpiť OKmeter. Možno ho kúpia o pol roka. Nemôžu rýchlo nainštalovať nejaké balíčky.
A napadlo nám, že potrebujeme taký špeciálny nástroj, ktorý nevyžaduje nič na inštaláciu, t. j. nemusíte na produkciu inštalovať vôbec nič. Nainštalujete si ho na svoj notebook, alebo na server na pozorovanie, odkiaľ ho budete spúšťať. A bude analyzovať veľa vecí: operačný systém, súborový systém a samotný Postgres, vykonávajúc nejaké ľahké požiadavky, ktoré môžete spustiť priamo na produkcii a nič nezlyhá.
Nazvali sme ho Postgres-checkup. Ak by sme hovorili medicínsky, je to pravidelná kontrola zdravia. Ak by sme hovorili automobilovou terminológiou, je to ako technická kontrola. Robíte technickú kontrolu vašemu autu každých pol roka alebo roka, v závislosti od značky. A robíte aj technickú kontrolu pre svoju databázu? T. j. vykonávate hĺbkový výskum pravidelne? Je to potrebné robiť. Ak robíte zálohy, robte aj checkup, to je rovnako dôležité.
A máme taký nástroj. Začal sa aktívne rozvíjať len pred tromi mesiacmi. Je ešte mladý, ale už tam toho veľa je.
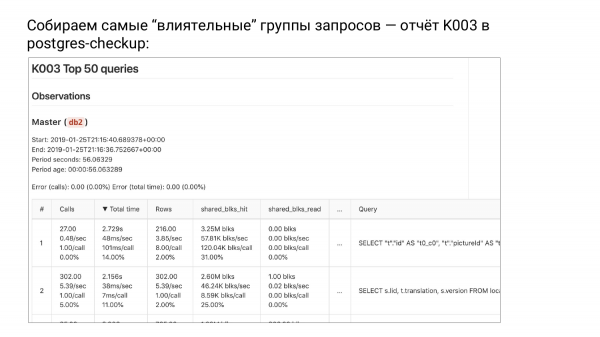
Zbierame najvplyvnejšie skupiny dopytov – správa K003 v Postgres-checkup
A tam je skupina správ K. Doteraz sú tri správy. A existuje taká správa K003. Tam je vrchol z pg_stat_statements, zoradený podľa total_time.
Keď zoradíme skupiny dopytov podľa total_time, na vrchu vidíme skupinu, ktorá najviac zaťažuje našu sústavu, t. j. spotrebuje najviac zdrojov. Prečo ich nazývam skupinami dopytov? Pretože sme vyhodili parametre. Už to nie sú dopyty, ale skupiny dopytov, t. j. sú abstrahované.
A ak budeme optimalizovať zhora nadol, uľahčíme naše zdroje a odložíme okamih, kedy budeme musieť urobiť upgrade. To je veľmi dobrý spôsob, ako ušetriť peniaze.
Možno to nie je najlepší spôsob, pokiaľ ide o starostlivosť o používateľov, pretože možno nevidíme zriedkavé, ale veľmi nepríjemné prípady, keď človek čakal 15 sekúnd. V súhrne sú tak zriedkavé, že ich nevidíme, ale zaoberáme sa zdrojmi.
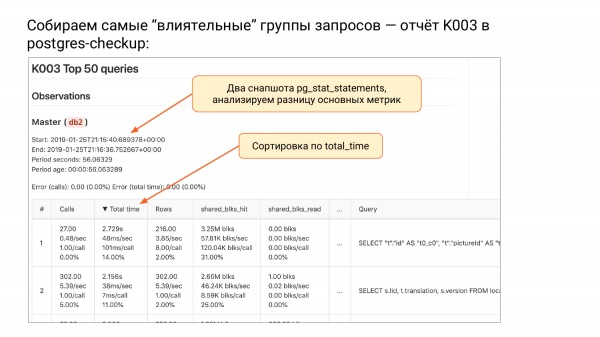
Čo sa stalo v tejto tabuľke? Urobili sme dve snímky. Postgres_checkup vám vypočíta delta pre každú metódu: podľa total-time, calls, rows, shared_blks_read a pod. Všetko, delta vypočítal. U pg_stat_statements je veľký problém v tom, že si nepamätá, kedy bol reset. Ak pg_stat_database si pamätá, tak pg_stat_statements si nepamätá. Vidíte, že tam je číslo 1 000 000, ale odkiaľ sme to počítali, nevieme.
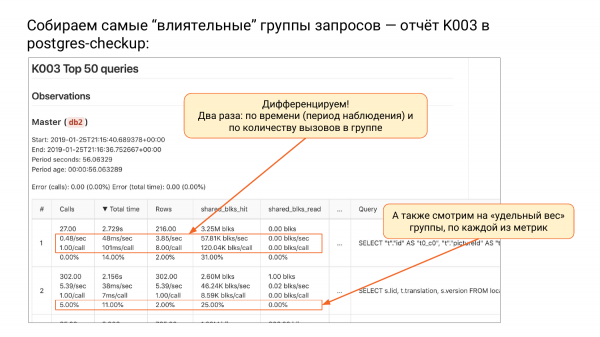
A tu vieme, máme dve snímky. Vieme, že delta bola v tomto prípade 56 sekúnd. Veľmi malý interval. Podľa total_time zoradené. A potom môžeme diferencovať, t. j. všetky metriky delíme na duration. Ak každú metriku rozdelíme na duration, dostaneme počet volaní za sekundu.
Ďalej total_time per second – to je moja obľúbená metrika. Meria sa v sekundách, za sekundu, t. j. koľko sekúnd potrebovala naša sústava na vykonanie tejto skupiny dopytov za sekundu. Ak tam vidíte viac ako sekundu za sekundu, znamená to, že ste potrebovali viac ako jedno jadro. To je veľmi dobrá metrika. Môžete pochopiť, že tomuto chlapíkovi, napríklad, potrebujete minimálne tri jadrá.
Tu je naše know-how, takéto som nikde nevidel. Upozorňujem – je to veľmi jednoduchá vec – sekunda za sekundu. Niekedy, keď je CPU na 100 %, tak pol hodiny za sekundu, t. j. ste 30 minút zaberali len týmto dopytom.
Ďalej vidíme riadky za sekundu. Vieme, koľko riadkov za sekundu bolo vrátených.
A ďalej je tiež zaujímavá vec. Koľko sme shared_buffers prečítali za sekundu z samotného shared_buffers. Hity už boli tam, a riadky sme vzali z cache operačného systému, alebo z disku. Prvá možnosť je rýchla, a druhá môže byť rýchla, ale môže byť aj pomalá, to závisí od situácie.
A druhý spôsob diferenciácie – delíme počet požiadaviek v tejto skupine. V druhej kolónke vždy bude jedna požiadavka delená na požiadavku. A potom je zaujímavé – koľko milisekúnd bolo v tejto požiadavke. Vieme, ako sa táto požiadavka správne správa. Na každú požiadavku bolo potrebných 101 milisekúnd. Toto je tradičná metrika, ktorú potrebujeme na porozumenie.
Koľko riadkov každá požiadavka v priemere vrátila. Vidíme, že táto skupina vracia 8. Koľko v priemere sa vzalo a prečítalo z cache. Vidíme, že všetko je pekne vyrovnané v cache. Samé hity pre prvú skupinu.
A štvrtý podriadok v každom riadku – to je koľko percent z celkového počtu. Máme volania. Predpokladajme, že je to 1 000 000. A môžeme pochopiť, aký príspevok táto skupina vkladá. Vidíme, že v tomto prípade prvá skupina prispieva menej ako 0,01 %. T. j. je taká pomalá, že ju nevidíme v celkovom obraze. A druhá skupina – 5 % z volaní. T. j. 5 % zo všetkých volaní je druhá skupina.
Podľa total_time je to tiež zaujímavé. Na prvú skupinu požiadaviek sme minuli 14 % celkového času práce. A na druhú – 11 % atď.
Do detailov sa nebudem hlboko ponárať, ale sú tam nuansy. Hore vypisujeme chybu, pretože keď porovnávame, snímky môžu byť posunuté, t. j. niektoré požiadavky môžu vypadnúť a v druhom už nemusia byť prítomné, a niektoré nové môžu vzniknúť. A my tam počítame chybu. Ak vidíte 0, tak je to dobré. To znamená, že žiadne chyby nie sú. Ak je ukazovateľ chyby až 20 %, je to v poriadku.
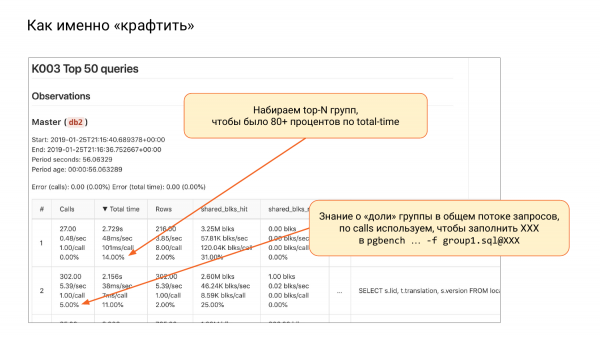
Potom sa opäť vraciame k našej téme. Musíme vytvoriť workload. Ideme zhora nadol, kým nenazbierame 80 % alebo 90 %. Zvyčajne je to 10-20 skupín. A pripravujeme súbory pre pgbench. Tam používame random. Niekedy to, bohužiaľ, nefunguje. A v Postgres 12 bude viac možností, ako tento prístup využiť.
A takto získavame 80-90 % z celkového času. Čo ďalej vložiť za „@“? Pozeráme sa na volania, sledujeme, koľko percent a chápeme, že tu by sme mali mať toľko percent. Z týchto percent môžeme pochopiť, ako vyvážiť každý z súborov. Potom používame pgbench a môžeme pokračovať v práci.
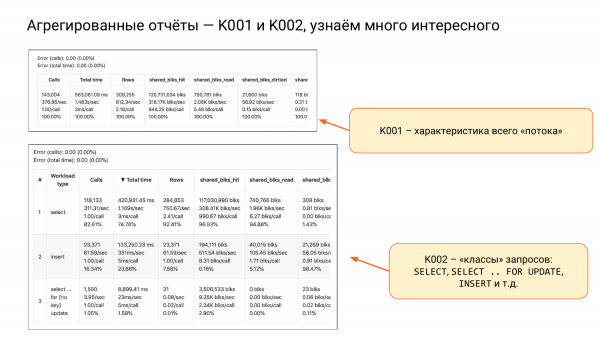
Máme aj K001 a K002.
K001 – to je jedna veľká línia so štyrmi podriadkami. Je to charakteristika celej našej záťaže. Sledujte druhý stĺpec a druhú podriadku. Vidíme, že asi 1,5 sekundy za sekundu, t. j. ak budú dve jadrá, bude to dobré. Bude to asi s 75 % zaťažením. A takto to bude fungovať. Ak budeme mať 10 jadier, budeme úplne v pokoji. Takto môžeme hodnotiť zdroje.
K002 – nazývam to triedy požiadaviek, t. j. SELECT, INSERT, UPDATE, DELETE. A osobitne SELECT FOR UPDATE, pretože zablokuje.
A tu môžeme vyvodiť záver, že bežné čítacie SELECTy – 82 % zo všetkých volaní, ale pritom – 74 % z celkového času. T. j. sa často volajú, ale spotrebovávajú menej zdrojov.
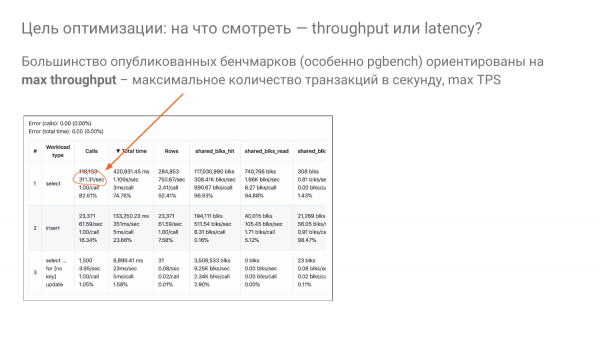
A vraciame sa k otázke: „Ako správne nastaviť shared_buffers?“. Pozorujem, že väčšina benchmarkov je založená na myšlienke – pozrime sa, aký throughput dosiahneme, t. j. aká bude priepustnosť. Meria sa obvykle v TPS alebo QPS.
A snažíme sa vyžmýkať z mašiny čo najviac transakcií za sekundu pomocou parametrov ladenia. Tu je presne 311 za sekundu pre select.
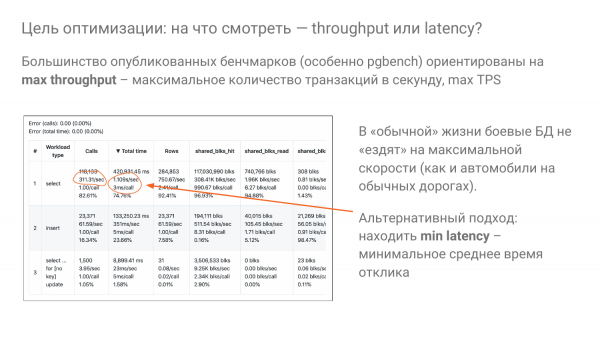
Ale nikto nechodí do práce a späť domov autom na plný výkon. To je hlúpe. Rovnako je to aj s databázami. Nemali by sme jazdiť na plný výkon, nikto to ani nerobí. Nikto nežije v produkcii s 100% CPU. Hoci možno niekto áno, nie je to dobré.
Idea je taká, že obvykle jazdíme pri 20 % našich možností, ideálne nie viac ako 50 %. A snažíme sa optimalizovať odozvu pre našich používateľov predovšetkým. T. j. naše ovládače by mali byť nastavené tak, aby minimalizovali latenciu pri 20 % rýchlosti, podmienečne. Toto je myšlienka, ktorú sa snažíme využiť aj v našich experimentoch.
A na záver odporúčania:
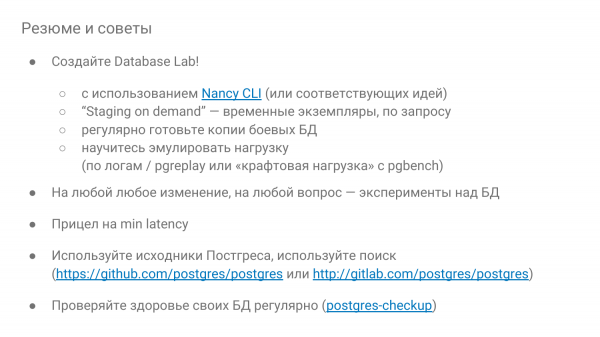
- Určite vytvorte Database Lab.
- Ak je to možné, robte na požiadanie, aby sa rozvíjalo na nejaký čas – hrali sa a potom zahodili. Ak máte cloud, je to samozrejmé, t. j. majte veľa stálych.
- Buďte zvedaví. A pokud něco není v pořádku, prověřte to experimenty, jak se to chová. Nancy lze použít k vlastnímu učení, abyste prověřili, jak databáze funguje.
- A mířte na minimální dobu odezvy.
- A nebojte se zdrojových kódů Postgres. Když pracujete se zdrojovými kódy, musíte znát angličtinu. Je tam spousta komentářů, všechno je vysvětleno.
- A pravidelně kontrolujte zdraví databáze, alespoň jednou za tři měsíce ručně nebo podle Postgres-checkup.
Otázky
Děkuji moc! To je velmi zajímavá věc.
Dva kusy.
Ano, dva kusy. Jenže jsem úplně nepochopil. Když pracujeme s Nancy, můžeme ladit pouze jeden parametr nebo celou skupinu?
Máme delta-config parametr. Můžete tam najednou upravit kolik chcete. Ale musíte chápat, že když měníte hodně věcí, můžete dojít k chybným závěrům.
Ano. Proč se ptám? Protože je obtížné provádět experimenty, když máte pouze jeden parametr. Ten upravíte, podíváte se, jak to funguje. Nastavíte ho. Pak začnete s dalším.
Můžete ladit více parametrů najednou, ale samozřejmě to závisí na situaci. Ale je lepší testovat jednu myšlenku. Včera jsme měli nápad. Měli jsme velmi podobnou situaci. Byly dva konfigurace. A nemohli jsme pochopit, proč je tak velký rozdíl. A objevila se myšlenka, že potřebujeme použít dichotomii, abychom postupně porozuměli a našli, v čem je rozdíl. Můžeme ihned udělat polovinu parametrů stejných, pak čtvrtinu atd. Všechno je flexibilní.
A ještě je tu otázka. Projekt je mladý, vyvíjí se. Je už dokumentace připravena, je podrobné popis?
Odkazoval jsem se na popis parametrů. To je. Ale zatím moc věcí ještě není. Hledám podobně smýšlející lidi. A nacházím je, když vystupuji. To je velmi super. Někdo už se mnou pracuje, někdo pomohl a něco udělal. A pokud vás toto téma zajímá, dejte prosím zpětnou vazbu – co chybí.
Až uděláme laboratoř, možná budu mít zpětnou vazbu. Uvidíme. Děkuji!
Dobrý den! Děkuji za přednášku! Viděl jsem, že je podpora pro Amazon. Plánuje se podpora GSP?
Dobrý dotaz. Začali jsme s tím. A zatím jsme to pozastavili, protože chceme šetřit. T. j. je zde podpora prostřednictvím běhu na localhostu. Můžete si vytvořit instanci a pracovat lokálně. Mimochodem, tak to děláme. V Getlab to dělám takto, tam na GSP. Ale zatím nevidíme smysl v této orkestraci, protože Google nemá levné spoty. Existují ??? instance, ale mají omezení. Za prvé, vždy mají pouze slevu 70 % a nelze si s cenou hrát. U spotů zvyšujeme cenu o 5-10 %, abychom snížili pravděpodobnost, že vás vyřadí. T. j. u spotů šetříte, ale kdykoliv vás mohou vzít. Pokud nastavíte cenu o něco vyšší než ostatní, později vás vyřadí. U Google je úplně jiná specifikace. A je zde ještě velmi nepříjemné omezení – žijí pouze 24 hodin. A někdy chceme experiment provozovat 5 dní. Ale na spotech to udělat lze, spoty někdy žijí měsíce.
Dobrý den! Děkuji za prezentaci! Zmínili jste se o checkupu. Jak vypočítáváte chyby stat_statements?
Velmi dobrý dotaz. Mohu to podrobně ukázat a vysvětlit. Stručně – sledujeme, jak se pohybovala skupina dotazů: kolik jich selhalo a kolik nových se objevilo. A pak sledujeme dvě metriky: total_time a calls, proto existují dvě chyby. A díváme se, jaký je příspěvek selhaných skupin. Existují dvě podskupiny: odchozí a příchozí. Zkoumáme, jaký mají příspěvek do celkového obrazu.
Nebojíte se, že se tam během času mezi snapshoty znovu roztočí dvakrát nebo třikrát?
T. j. znovu se zaregistrovali nebo jak?
Například, tento dotaz byl jednou již vyřazen, pak se vrátil a znovu byl vyřazen, a pak se vrátil znovu a znovu byl vyřazen. A co jste tady spočítali, a kde je to všechno?
Dobrý dotaz, je třeba se podívat.
Já jsem něco podobného dělal. Samozřejmě jednodušeji, dělal jsem to sám. Ale musel jsem to resetovat, udělat reset stat_statements a orientovat se v okamžiku snapshotu, že tam je méně určitého podílu, že se stejně nedostalo k maximu, kolik stat_statements může nashromáždit. A orientuji se, že pravděpodobně nic nebylo vyřazeno.
Ano-ano.
Ale jak jinak udělat spolehlivě, to vůbec nechápu.
Bohužel si přesně nepamatuji – zda tam používáme text dotazu nebo queryid s pg_stat_statements a na to se orientujeme. Pokud se orientujeme na queryid, pak srovnáváme srovnatelné věci.
Nie, môže sa prekrývať niekoľkokrát medzi snapshotmi a vrátiť sa späť.
S týmto id?
Áno.
Toto preskúmame. Dobrá otázka. Musíme to preskúmať. Ale zatiaľ to, čo vidíme, je buď 0 napísané...
Toto je síce zriedkavý prípad, ale bolo to pre mňa šokujúce, keď som sa dozvedel, že stat_statements tam môže prekrývať.
V Pg_stat_statements môže byť veľa vecí. Stretli sme sa s tým, že ak máte track_utility = on, tak sa aj vaše sety sledujú.
Áno, samozrejme.
A ak máte Java Hibernate, ktorý je náhodný, tak sa tam začína zamykať hash-tablica. A keď len vypnete veľmi zaťaženú aplikáciu, máte 50-100 skupín. A je to celkom stabilné. Jeden zo spôsobov, ako s tým bojovať, je zvýšiť pg_stat_statements.max.
Áno, ale musíte vedieť, o koľko. A nejakým spôsobom to musíte sledovať. Ja to tak robím. T. j. mám pg_stat_statements.max. A sledujem, že v momente snapshotu som nedosiahol 70 %. Dobre, znamená to, že sme nič nestratili. Robíme reset. A opäť zbierame. Ak je v nasledujúcom snapshotu menej ako 70, znamená to, že pravdepodobne sme znovu nič nestratili.
Áno. Predvolene to teraz je 5 000. A mnohým z toho stačí.
Zvyčajne - áno.
Video:
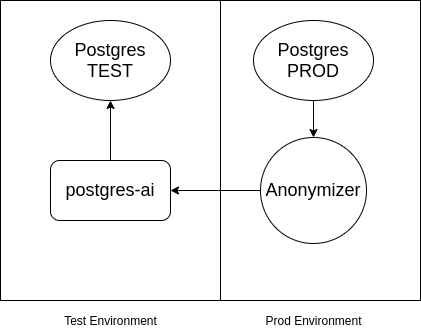
P.S. Od seba dodám, že ak sú v Postgres citlivé dáta a nemajú preniknúť do testovacieho prostredia, je možné využiť . Schéma je približne takáto:
Zdroj: habr.com
