

Nahrával som na Github .
Je to jednoduchá hash tabuľka pre GPU, schopná spracovať stovky miliónov vložení za sekundu. Na mojom notebooku s NVIDIA GTX 1060 kód vloží 64 miliónov náhodne generovaných párov kľúč-hodnota zhruba za 210 ms a odstráni 32 miliónov párov zhruba za 64 ms.
To znamená, že rýchlosť na notebooku je približne 300 miliónov vložení/s a 500 miliónov odstránení/s.
Tabuľka je napísaná v CUDA, hoci tú istú metodológiu je možné aplikovať aj na HLSL alebo GLSL. Implementácia má niekoľko obmedzení, ktoré zabezpečujú vysoký výkon na grafickej karte:
- Spracovávané sú iba 32-bitové kľúče a rovnaké hodnoty.
- Hash tabuľka má pevnú veľkosť.
- A táto veľkosť musí byť mocninou dvoch.
Pre kľúče a hodnoty je potrebné si rezervovať jednoduchý oddeľovací marker (v uvedenom kóde je to 0xffffffff).
Hash tabuľka bez zámkov
V hash tabuľke sa používa otvorené adresovanie s , teda je to jednoducho pole párov kľúč-hodnota, ktoré sa uchováva v pamäti a má vynikajúci výkon cache. To sa nedá povedať o reťazení (chaining), ktoré predpokladá hľadanie ukazovateľa v prepojenom zozname. Hash tabuľka je jednoduchým poľa, ktoré uchováva prvky KeyValue:
struct KeyValue
{
    uint32_t key;
    uint32_t value;
};
Veľkosť tabuľky je mocninou dvoch, a nie prvočíslom, pretože na aplikáciu pow2/AND masky stačí jedna rýchla inštrukcia, zatiaľ čo operátor modulu pracuje podstatne pomalšie. To je dôležité v prípade lineárneho sondovania, pretože pri lineárnom hľadaní tabuľkou musí byť index slotu obalený do každého slotu. A v dôsledku toho sa pridáva cena operácie modulo v každom slote.
Tabuľka uchováva iba kľúč a hodnotu pre každý prvok, nie hash kľúča. Keďže tabuľka uchováva len 32-bitové kľúče, hash sa počíta veľmi rýchlo. V uvedenom kóde sa používa hash Murmur3, ktorý vykonáva len niekoľko posunov, XOR-ov a násobení.
V hash-tabuli sa používa metodika ochrany pred blokáciami, ktorá nezávisí od poradia uloženia v pamäti. Aj keď niektoré zápisové operácie porušujú poradie iných takýchto operácií, hash-tabula si aj tak zachová správny stav. O tom sa budeme rozprávať nižšie. Metodika skvele funguje s grafickými kartami, na ktorých sú súčasne spracovávané tisíce vlákien.
Kľúče a hodnoty v hash-tabuli sú inicializované prázdnymi.
Kód je možné modifikovať, aby mohol spracovávať aj 64-bitové kľúče a hodnoty. Pre kľúče sú potrebné atómové operácie čítania, zápisu a porovnávania s výmenou (compare-and-swap). A pre hodnoty sú potrebné atómové operácie čítania a zápisu. Našťastie, v CUDA sú operácie čítania-zápisu pre 32- a 64-bitové hodnoty atómové, pokiaľ sú prirodzene vyrovnané (pozri ), a moderné grafické karty podporujú 64-bitové atómové operácie porovnávania s výmenou. Samozrejme, pri prechode na 64 bitov sa výkon mierne zníži.
Stav hash-tabule
Každý pár kľúč-hodnota v hash-tabuli môže mať jeden z štyroch stavov:
- Kľúč a hodnota sú prázdne. V tomto stave sa hash-tabula inicializuje.
- Kľúč bol zapísaný, ale hodnota ešte nie. Ak iný vykonávací vláknový proces v tomto momente číta údaje, potom vráti prázdnu hodnotu. To je normálne, to isté by sa stalo, ak by iný vykonávací vláknový proces pracoval o niečo skôr, a hovoríme o konkurenčnej štruktúre dát.
- Zápisy sú kľúč aj hodnota.
- Hodnota je dostupná pre iné vykonávacie vláknové procesy, ale kľúč ešte nie. To sa môže stať, pretože model programovania v CUDA predpokladá slabo usporiadaný model pamäte. Je to normálne, v akomkoľvek prípade je kľúč stále prázdny, aj keď hodnota už nie je.
Dôležitý detail spočíva v tom, že akonáhle bol kľúč zapísaný do slotu, už sa nepohne — aj keď sa kľúč odstráni, o tom sa budeme rozprávať nižšie.
Kód hash-tabule funguje aj so slabo usporiadanými modelmi pamäte, v ktorých nie je známe poradie čítaní a zápisov do pamäte. Keď budeme preberať vkladanie, vyhľadávanie a odstraňovanie v hash-tabuli, nezabudnite, že každý pár kľúč-hodnota sa nachádza v jednom z štyroch vyššie opísaných stavov.
Vkladanie do hash-tabule
CUDA funkcia, ktorá vkladá do hash tabuľky páry kľúč-hodnota, vyzerá takto:
void gpu_hashtable_insert(KeyValue* hashtable, uint32_t key, uint32_t value) {
    uint32_t slot = hash(key);

    while (true) {
        uint32_t prev = atomicCAS(&hashtable[slot].key, kEmpty, key);
        if (prev == kEmpty || prev == key) {
            hashtable[slot].value = value;
            break;
        }
        slot = (slot + 1) & (kHashTableCapacity-1);
    }
}
Pri vkladaní kľúča kód iteruje cez pole hash tabuľky, začínajúc od hash vloženého kľúča. V každom slote poľa sa vykonáva atómová operácia porovnania s výmenou, pri ktorej sa kľúč v tomto slote porovnáva s prázdnym. Ak sa zistí nezhoda, kľúč v slote sa aktualizuje na vložený kľúč, a potom sa vráti pôvodný kľúč slotu. Ak bol tento pôvodný kľúč prázdny alebo zodpovedal vloženému kľúču, znamená to, že kód našiel vhodný slot na vloženie a do slotu vloží hodnotu.
Ak existuje v jednom volaní jadra gpu_hashtable_insert() je niekoľko prvkov s rovnakým kľúčom, potom akákoľvek z ich hodnôt môže byť zapísaná do slota kľúča. To sa považuje za normálne: jedna z operácií zápisu kľúč-hodnota počas volania bude úspešná, ale pretože sa to všetko deje paralelne v rámci viacerých vykonávacích vlákien, nemôžeme predpovedať, ktorá operácia zápisu do pamäte bude posledná.
Hľadanie v hash tabuľke
Kód na hľadanie kľúčov:
uint32_t gpu_hashtable_lookup(KeyValue* hashtable, uint32_t key) {
        uint32_t slot = hash(key);

        while (true) {
            if (hashtable[slot].key == key) {
                return hashtable[slot].value;
            }
            if (hashtable[slot].key == kEmpty) {
                return kEmpty;
            }
            slot = (slot + 1) & (kHashTableCapacity - 1);
        }
}
Aby sme našli hodnotu kľúča uloženého v tabuľke, iterujeme cez pole začínajúce od hashu hľadaného kľúča. V každom slote kontrolujeme, či je kľúč ten, ktorý hľadáme, a ak áno, vrátime jeho hodnotu. Takisto kontrolujeme, či je kľúč prázdny, a ak áno, prerušíme hľadanie.
Ak sa nám nepodarí nájsť kľúč, kód vráti prázdnu hodnotu.
Všetky tieto operácie hľadania môžu prebiehať súbežne pri vkladaní a mazaniach. Každý pár v tabuľke bude mať pre vlákno jeden z štyroch vyššie opísaných stavov.
Vymazanie v hash tabuľke
Kód na mazanie kľúčov:
void gpu_hashtable_delete(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        if (hashtable[slot].key == key)
        {
            hashtable[slot].value = kEmpty;
            return;
        }
        if (hashtable[slot].key == kEmpty)
        {
            return;
        }
        slot = (slot + 1) & (kHashTableCapacity - 1);
    }
}
Odstránenie kľúča sa vykonáva nezvyčajne: kľúč nechávame v tabuľke a označujeme jeho hodnotu (nie samotný kľúč) za prázdnu. Tento kód je veľmi podobný lookup(), s výnimkou toho, že pri nájdení zhody podľa kľúča nastaví jeho hodnotu na prázdnu.
Ako bolo uvedené vyššie, akonáhle je kľúč zapísaný do slotu, už sa nepohybuje. Aj pri odstránení prvku z tabuľky kľúč zostáva na svojom mieste, jeho hodnota sa jednoducho stáva prázdnou. To znamená, že nemusíme používať atómovú operáciu zápisu do slotu, pretože nezáleží na tom, či je aktuálna hodnota prázdna alebo nie — aj tak sa stane prázdnou.
Zmena veľkosti hash tabuľky
Zmeniť veľkosť hash tabuľky možno vytvorením väčšej tabuľky a vložením do nej neprázdnych prvkov zo starej tabuľky. Túto funkcionalitu som nerealizoval, pretože som chcel udržať kód jednoduchý. Navyše, v CUDA programoch sa priraďovanie pamäte často robí v hostiteľskom kóde, nie v CUDA jadre.
V článku popisuje, ako meniť takú dátovú štruktúru chránenú pred zablokovaním.
Konkurencia
Vo vyššie uvedených fragmentoch kódu funkcie gpu_hashtable_insert(), _lookup() a _delete() spracovávajú po jednom páre kľúč-hodnota za raz. A nižšie gpu_hashtable_insert(), _lookup() a _delete() spracovávajú pole párov paralelne, každý pár v samostatnom vlákne GPU:
// CPU code to invoke the CUDA kernel on the GPU
uint32_t threadblocksize = 1024;
uint32_t gridsize = (numkvs + threadblocksize - 1) / threadblocksize;
gpu_hashtable_insert_kernel<<<gridsize, threadblocksize>>>(hashtable, kvs, numkvs);

// GPU code to process numkvs key/values in parallel
void gpu_hashtable_insert_kernel(KeyValue* hashtable, const KeyValue* kvs, unsigned int numkvs)
{
    unsigned int threadid = blockIdx.x*blockDim.x + threadIdx.x;
    if (threadid < numkvs)
    {
        gpu_hashtable_insert(hashtable, kvs[threadid].key, kvs[threadid].value);
    }
}
Hash tabuľka s ochranou pred zablokovaním podporuje konkurenčné zápisy, vyhľadávanie a odstraňovanie. Keďže páry kľúč-hodnota sú vždy v jednom z štyroch stavov a kľúče sa nepohybujú, tabuľka zaručuje správnosť aj pri súbežnom vykonávaní operácií rôznych typov.
Avšak ak spracovávame balík vložení a odstránení súbežne a ak vo vstupe párov sú duplikované kľúče, nebudeme môcť predpovedať, ktoré páry "vyhrajú" — budú zapísané do hash tabuľky ako posledné. Predpokladajme, že sme spustili kód vloženia s vstupným poľom párov A/0 B/1 A/2 C/3 A/4. Keď sa kód dokončí, páry B/1 a C/3 garantovane budú prítomné v tabuľke, ale zároveň sa v nej môže nachádzať akákoľvek z párov A/0, A/2 alebo A/4To je môže byť problém, alebo nemusí — všetko závisí od použitia. Môžete vopred vedieť, že v vstupe nie sú duplicitné kľúče, alebo vám môže byť jedno, aká hodnota bola posledne zapísaná.
Ak je to pre vás problém, musíte rozdeliť duplicitné páry do rôznych systémových CUDA volaní. V CUDA je akákoľvek operácia s volaním jadra vždy ukončená pred ďalším volaním jadra (aspoň v rámci jedného vlákna. V rôznych vláknach jadra sa vykonávajú paralelne). Ak v uvedenom príklade zavoláte jedno jadro s A/0 B/1 A/2 C/3, a druhé s A/4, potom kľúč A dostane hodnotu 4.
Teraz sa rozprávajme o tom, či by funkcie lookup() a delete() mali používať jednoduchý (plain) alebo premenný (volatile) ukazovateľ na pole párov v hašovacej tabuľke. tvrdí, že:
Kompilátor môže podľa svojho uváženia optimalizovať operácie čítania a písania do globálnej alebo zdieľanej pamäte … Tieto optimalizácie je možné vypnúť pomocou kľúčového slova
volatile: … akýkoľvek odkaz na túto premennú sa kompiluje na skutočnú inštrukciu čítania alebo písania do pamäte.
Úvahy o správnosti nevyžadujú použitie volatile. Ak vykonávajúce vlákno používa cachovanú hodnotu z predchádzajúcej operácie čítania, znamená to, že bude používať mierne zastarané informácie. Napriek tomu sú však tieto informácie z platného stavu hašovacej tabuľky v určenom okamihu volania jadra. Ak potrebujete používať najčerstvejšie informácie, môžete použiť ukazovateľ volatile, ale potom sa mierne zníži výkon: podľa mojich testov sa pri odstraňovaní 32 miliónov prvkov rýchlosť znížila z 500 miliónov odstránení/sec na 450 miliónov odstránení/sec.
Výkon
V teste na vloženie 64 miliónov prvkov a odstránenie 32 miliónov z nich neexistuje súťaž medzi std::unordered_map a hašovacou tabuľkou pre GPU:
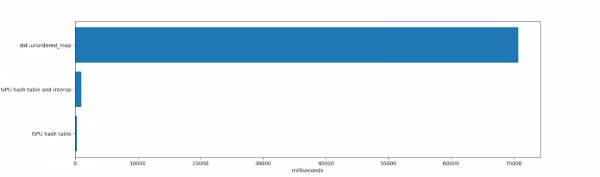
std::unordered_map strávila 70 691 ms na vloženie a odstránenie prvkov s následným uvoľnením unordered_map (uvoľnenie miliónov prvkov zaberie veľa času, pretože sa vo vnútri unordered_map vykonávajú mnohé alokácie pamäte). Úprimne, pri std:unordered_map úplne iné obmedzenia. Ide o jeden CPU-vykonávací tok, ktorý podporuje kľúče a hodnoty akýchkoľvek veľkostí, dobre funguje pri vysokých koeficientoch využitia a vykazuje stabilný výkon po mnohých odstráneniach.
Trvanie práce hash tabuľky pre GPU a interprocess komunikáciu bolo 984 ms. To zahŕňa čas strávený na umiestnenie tabuľky do pamäte a jej odstránenie (jednorazové pridelenie 1 GB pamäte, čo v CUDA trvá určitý čas), vkladanie a odstraňovanie prvkov, ako aj iterovanie cez ne. Tiež sa zohľadnili všetky kopírovania do pamäte a z pamäte grafickej karty.
Práca samotnej hash tabuľky trvala 271 ms. To zahŕňa čas, ktorý grafická karta strávila na vkladaní a odstraňovaní prvkov, a nezohľadňuje čas na kopírovanie do pamäte a iterovanie po vzniknutej tabuľke. Ak GPU-tabula existuje dlhú dobu, alebo ak je hash tabuľka celá v pamäti grafickej karty (napríklad pre vytvorenie hash tabuľky, ktorá bude použitá iným GPU-kódom, a nie centrálnym procesorom), potom je výsledok testovania relevantný.
Hash tabuľka pre grafickú kartu preukazuje vysoký výkon vďaka veľkej priepustnosti a aktívnemu paralelizovaniu.
Nevýhody
Architektúra hash tabuľky má niekoľko problémov, na ktoré sa treba zamerať:
- K lineárnemu zondovaniu zasahuje klastrovanie, kvôli ktorému sú kľúče v tabuľke umiestnené do značnej miery neoptimálne.
- Kľúče nie sú odstraňované pomocou funkcie
vymazaťa časom zaneprázdňujú tabuľku.
V dôsledku toho môže výkon hash tabuľky postupne klesať, najmä ak existuje dlhú dobu a vykonáva sa v nej množstvo vkladov a odstraňovaní. Jedným zo spôsobov, ako zmierniť tieto nevýhody, je prehashovanie do novej tabuľky s dostatočne nízkym koeficientom využitia a filtrovanie odstránených kľúčov pri prehashovaní.
Na ilustráciu opísaných problémov používam vyššie uvedený kód na vytvorenie tabuľky s 128 miliónmi prvkov, cyklicky budem vkladať 4 milióny prvkov, kým nevyplním 124 miliónov slotov (koeficient využitia približne 0,96). Tu sú výsledky, každý riadok je volanie CUDA jadra s vložením 4 miliónov nových prvkov do jednej hash tabuľky:
Koeficient využitia
Dĺžka vloženia 4 194 304 prvkov
0,00
11,608448 ms (361,314798 milióna kľúčov/sek.)
0,03
11,751424 ms (356,918799 milióna kľúčov/sek.)
0,06
11,942592 ms (351,205515 milióna kľúčov/sek.)
0,09
12,081120 ms (347,178429 milióna kľúčov/sek.)
0,12
12,242560 ms (342,600233 milióna kľúčov/sek.)
0,16
12,396448 ms (338,347235 milióna kľúčov/sek.)
0,19
12,533024 ms (334,660176 milióna kľúčov/sek.)
0,22
12,703328 ms (330,173626 milióna kľúčov/sek.)
0,25
12,884512 ms (325,530693 milióna kľúčov/sek.)
0,28
13,033472 ms (321,810182 milióna kľúčov/sek.)
0,31
13,239296 ms (316,807174 milióna kľúčov/sek.)
0,34
13,392448 ms (313,184256 milióna kľúčov/sek.)
0,37
13,624000 ms (307,861434 milióna kľúčov/sek.)
0,41
13,875520 ms (302,280855 milióna kľúčov/sek.)
0,44
14,126528 ms (296,909756 milióna kľúčov/sek.)
0,47
14,399328 ms (291,284699 milióna kľúčov/sek.)
0,50
14,690304 ms (285,515123 milióna kľúčov/sek.)
0,53
15,039136 ms (278,892623 milióna kľúčov/sek.)
0,56
15,478656 ms (270,973402 milióna kľúčov/sek.)
0,59
15,985664 ms (262,379092 milióna kľúčov/sek.)
0,62
16,668673 ms (251,627968 milióna kľúčov/sek.)
0,66
17,587200 ms (238,486174 milióna kľúčov/sek.)
0,69
18,690048 ms (224,413765 milióna kľúčov/sek.)
0,72
20,278816 ms (206,831789 milióna kľúčov/sek.)
0,75
22,545408 ms (186,038058 milióna kľúčov/sek.)
0,78
26,053312 ms (160,989275 milióna kľúčov/sek.)
0,81
31,895008 ms (131,503463 milióna kľúčov/sek.)
0,84
42,103294 ms (99,619378 milióna kľúčov/sek.)
0,87
61,849056 ms (67,815164 milióna kľúčov/sek.)
0,90
105,695999 ms (39,682713 milióna kľúčov/sek.)
0,94
240,204636 ms (17,461378 milióna kľúčov/sek.)
S rastúcou mierou využitia sa výkon znižuje. To je nežiadúce vo väčšine prípadoch. Ak aplikácia vkladá prvky do tabuľky a potom ich odmieta (napríklad pri počítaní slov v knihe), nie je to problém. Avšak, ak aplikácia používa dlhodobú hashovaciu tabuľku (napríklad v grafickom editore na uchovávanie neprazdných častí obrázkov, keď používateľ často vkladá a odstraňuje informácie), takéto správanie môže spôsobovať problémy.
A zmieril som hĺbku sondovania hashovacej tabuľky po 64 miliónoch vložení (mierka využitia 0,5). Priemerná hĺbka bola 0,4774, takže väčšina kľúčov sa nachádzala buď na najlepších možných slotov, alebo v jednom slote od najlepšej pozície. Maximálna hĺbka sondovania bola 60.
Potom som zmieril hĺbku sondovania v tabuľke s 124 miliónmi vložení (mierka využitia 0,97). Priemerná hĺbka už dosiahla 10,1757, maximálna — 6474 (!!). Výkon lineárneho sondovania sa výrazne zhoršuje pri vysokých mierach využitia.
Najlepšie je u tejto hash tabuľky udržiavať nízky koeficient využitia. Ale tým zvyšujeme výkon na úkor spotreby pamäte. Našťastie, v prípade 32-bitových kľúčov a hodnôt to môže byť ospravedlniteľné. Ak by sme v uvedenom príklade v tabuľke s 128 miliónmi prvkami udržali koeficient využitia 0,25, mohli by sme do nej umiestniť maximálne 32 miliónov prvkov, zatiaľ čo ďalších 96 miliónov slotov by sa stratilo — po 8 bajtoch na každý pár, 768 MB stratenej pamäte.
Všimnite si, že hovoríme o strate pamäte grafickej karty, ktorá je cennejším zdrojom ako systémová pamäť. Hoci väčšina moderných desktopových grafických kariet podporujúcich CUDA má minimálne 4 GB pamäte (v čase písania tohto článku má NVIDIA 2080 Ti 11 GB), stále by nebolo múdre takúto kapacitu strácať.
Neskôr sa podrobnejšie venovam vytváraniu hash tabuliek pre grafické karty, ktoré nemajú problémy s hĺbkou nahliadania, ako aj spôsobom opätovného využitia odstránených slotov.
Meranie hĺbky nahliadania
Aby sme určili hĺbku nahliadania kľúča, môžeme extrahovať hash kľúča (jeho ideálny index v tabuľke) z jeho skutočného tabuľkového indexu:
// get_key_index() -> index of key in hash table
uint32_t probelength = (get_key_index(key) - hash(key)) & (hashtablecapacity-1);
Vďaka mágii dvoch binárnych čísel v doplnkovom kóde a faktu, že kapacita hash tabuľky je rovná dvojnásobku, tento prístup bude fungovať aj vtedy, keď sa index kľúča prenesie na začiatok tabuľky. Zoberme kľúč, ktorý sa hashoval na 1, ale bol vložený do slotu 3. Potom pre tabuľku s kapacitou 4 dostaneme (3 — 1) & 3, čo je ekvivalentné 2.
Záver
Ak máte otázky alebo komentáre, napíšte mi na alebo otvorte novú tému v.
Tento kód bol napísaný pod inšpiráciou z vynikajúcich článkov:
V budúcnosti plánujem pokračovať v písaní o realizáciách hash tabuliek pre grafické karty a analyzovať ich výkon. Mám v pláne reťazenie, Robin Hood hashing a cuckoo hashing s použitím atomových operácií v dátových štruktúrach, ktoré sú vhodné pre grafické karty.
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish