

Balík tidyr je súčasťou jedného z najpopulárnejších knižníc v jazyku R — tidyverse.
Hlavným účelom balíka je previesť dáta do upraveného formátu.
Na Habré už existuje venovaná tomuto balíku, ale je z roku 2015. Chcem sa venovať najaktuálnejším zmenám, o ktorých pred niekoľkými dňami informoval jeho autor Hadley Wickham.
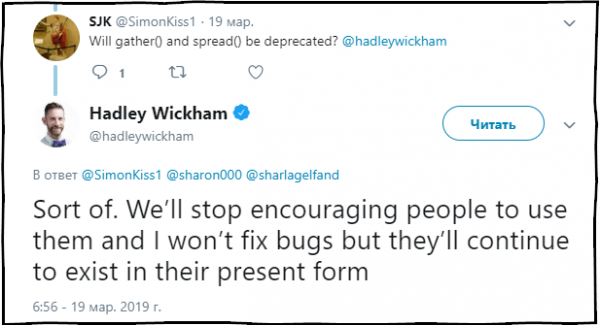
SJK: Budú funkcie gather() a spread() považované za zastarané?
Hadley Wickham: V určitom zmysle. Nebudeme odporúčať používanie týchto funkcií a opravovať chyby v nich, no stále budú prítomné v balíku v súčasnom stave.
Obsah
Ak vás zaujíma analýza dát, mohli by vás zaujímať moje a kanály. Väčšina obsahu je zameraná na jazyk R.
Koncepcia TidyData
Cieľ tidyr — pomôcť vám upraviť dáta do takzvaného upraveného formátu. Upravené dáta sú dáta, kde:
- Každá premenná je v stĺpci.
- Každé pozorovanie je riadkom.
- Každá hodnota je bunkou.
S dátami, ktoré sú upravené na tidy data, sa oveľa jednoduchšie a pohodlnejšie pracuje pri analýze.
Hlavné funkcie zahrnuté v balíku tidyr
tidyr obsahuje množstvo funkcií určených na transformáciu tabuliek:
fill()— vyplnenie chýbajúcich hodnôt v stĺpci predchádzajúcimi hodnotami;separate()— rozdelí jedno pole na niekoľko cez oddeľovač;unite()— vykonáva operáciu zlúčenia niekoľkých polí do jedného, čo je opačné k funkciiseparate();pivot_longer()— funkcia, ktorá transformuje dáta z širokého formátu do dlhého;pivot_wider()— funkcia, ktorá transformuje dáta z dlhého formátu do širokého. Operácia je opačná tej, ktorú vykonáva funkciapivot_longer().gather()zastaralá — funkcia, ktorá transformuje dáta z širokého formátu do dlhého;spread()zastaralá — funkcia, ktorá transformuje dáta z dlhého formátu do širokého. Operácia je opačná tej, ktorú vykonáva funkciagather().
Nová koncepcia transformácie dát z širokého formátu na dlhý a naopak
Predtým sa na tento typ transformácie používali funkcie gather() a spread(). Po rokoch existencie týchto funkcií sa ukázalo, že pre väčšinu používateľov, vrátane autora balíka, názvy týchto funkcií a ich argumentov boli dosť nejasné a spôsobili ťažkosti pri ich vyhľadávaní a pochopení toho, ktorá z týchto funkcií prevádza dátový rámec zo širokého do dlhého formátu a naopak.
V súvislosti s tým do tidyr boli pridané dve nové, dôležité funkcie, ktoré sú určené na transformáciu dátových rámcov.
Nové funkcie pivot_longer() a pivot_wider() boli vytvorené pod vplyvom niektorých funkcií z balíka cdata, vytvoreného Johnom Mountom a Ninou Zoomeľ.
Inštalácia najaktuálnejšej verzie tidyr 0.8.3.9000
Na inštaláciu novej, najaktuálnejšej verzie balíka tidyr 0.8.3.9000, v ktorej sú k dispozícii nové funkcie, použite nasledujúci kód.
devtools::install_github("tidyverse/tidyr")
V čase písania tohto článku sú tieto funkcie dostupné iba v dev verzii balíka na GitHub.
Prechod na nové funkcie
V skutočnosti nie je ťažké previesť staré skripty na prácu s novými funkciami, na väčšie pochopenie vezmem príklad z dokumentácie starých funkcií a ukážem, ako sa tieto operácie vykonávajú pomocou nových pivot_*() funkcií.
Transformácia širokého formátu na dlhý.
Príklad kódu z dokumentácie funkcie gather
# example
library(dplyr)
stocks <- data.frame(
  time = as.Date('2009-01-01') + 0:9,
  X = rnorm(10, 0, 1),
  Y = rnorm(10, 0, 2),
  Z = rnorm(10, 0, 4)
)

# old
stocks_gather <- stocks %>% gather(key   = stock,
                                   value = price,
                                   -time)

# new
stocks_long   <- stocks %>% pivot_longer(cols      = -time,
                                       names_to  = "stock",
                                       values_to = "price")
Transformácia dlhého formátu na široký.
Príklad kódu z dokumentácie funkcie spread
# old
stocks_spread <- stocks_gather %>% spread(key = stock,
                                          value = price)

# new
stock_wide    <- stocks_long %>% pivot_wider(names_from  = "stock",
                                            values_from = "price")
Keďže v uvedených vyššie príkladoch práce s pivot_longer() a pivot_wider(), v pôvodnej tabuľke stocks nie sú stĺpce uvedené v argumentoch names_to a values_to ich názvy je potrebné uvádzať v úvodzovkách.
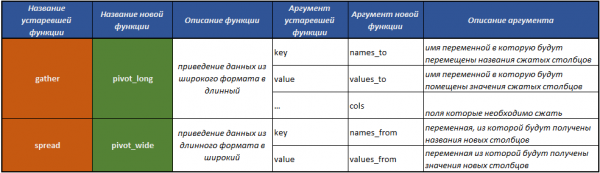
Tabuľka, s pomocou ktorej vám najjednoduchšie pomôže pochopiť, ako prejsť na novú koncepciu tidyr.
Poznámka od autora
Celý nasledujúci text je adaptívny, povedal by som voľný preklad z oficiálnej stránky knižnice tidyverse.
Jednoduchý príklad transformácie dát z širokého formátu do dlhého
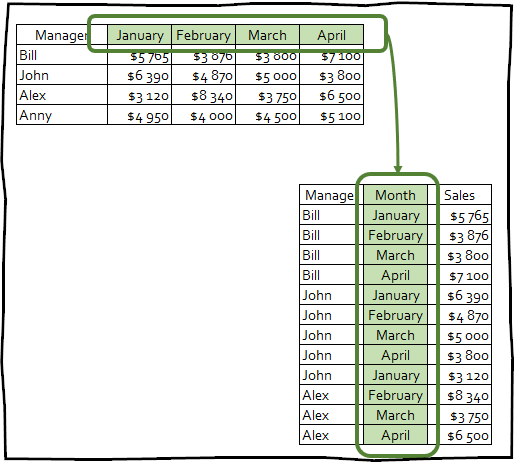
pivot_longer () — robí dátové sady dlhšie, zmenšuje počet stĺpcov a zvyšuje počet riadkov.
Na vykonanie príkladov, ktoré sú uvedené v článku, je najprv potrebné pripojiť potrebné balíky:
library(tidyr)
library(dplyr)
library(readr)
Predpokladajme, že máme tabuľku s výsledkami prieskumu, v ktorom (okrem iného) sa pýtali ľudí na ich náboženstvo a ročný príjem:
#> # A tibble: 18 x 11
#>    religion `<$10k` `$10-20k` `$20-30k` `$30-40k` `$40-50k` `$50-75k`
#>    <chr>      <dbl>     <dbl>     <dbl>     <dbl>     <dbl>     <dbl>
#>  1 Agnostic      27        34        60        81        76       137
#>  2 Atheist       12        27        37        52        35        70
#>  3 Buddhist      27        21        30        34        33        58
#>  4 Catholic     418       617       732       670       638      1116
#>  5 Don’t k…      15        14        15        11        10        35
#>  6 Evangel…     575       869      1064       982       881      1486
#>  7 Hindu          1         9         7         9        11        34
#>  8 Histori…     228       244       236       238       197       223
#>  9 Jehovah…      20        27        24        24        21        30
#> 10 Jewish        19        19        25        25        30        95
#> # … with 8 more rows, and 4 more variables: `$75-100k` <dbl>,
#> #   `$100-150k` <dbl>, `>150k` <dbl>, `Don't know/refused` <dbl>
Táto tabuľka obsahuje údaje o náboženstve respondentov v riadkoch, a úroveň príjmu je rozdelená podľa názvov stĺpcov. Počet respondentov z každej kategórie je uložený v hodnotách buniek na prieseku náboženstva a úrovne príjmu. Na to, aby sa tabuľka upravila do správneho, presného formátu, stačí použiť pivot_longer():
pew %>%
  pivot_longer(cols = -religion, names_to = "income", values_to = "count")
pew %>%
pivot_longer(cols = -religion, names_to = "income", values_to = "count")
#> # A tibble: 180 x 3
#> religion income count
#>
#> 1 Agnostic 2 Agnostic $10-20k 34
#> 3 Agnostic $20-30k 60
#> 4 Agnostic $30-40k 81
#> 5 Agnostic $40-50k 76
#> 6 Agnostic $50-75k 137
#> 7 Agnostic $75-100k 122
#> 8 Agnostic $100-150k 109
#> 9 Agnostic >150k 84
#> 10 Agnostic Don't know/refused 96
#> # … s 170 ďalšími riadkamiArgumenty funkcie pivot_longer()
- Prvý argument cols, opisuje, ktoré stĺpce je potrebné zlúčiť. V tomto prípade všetky stĺpce okrem time.
- Argument names_to dáva názov premennej, ktorá bude vytvorená z názvov stĺpcov, ktoré sme zlúčili.
- values_to dáva názov premennej, ktorá bude vytvorená z údajov uložených v hodnotách buniek zlúčených stĺpcov.
Špecifikácie
Toto je nová funkcia balíka tidyr, ktorá predtým nebola dostupná pri práci s zastaranými funkciami.
Špecifikácia je rámec údajov, kde každý riadok zodpovedá jednému stĺpcu v novom výstupnom dátovom rámci a dvom špeciálnym stĺpcom, ktoré začínajú s:
- .name obsahuje pôvodný názov stĺpca.
- .value obsahuje názov stĺpca, do ktorého budú vstupovať hodnoty buniek.
Ostatné stĺpce špecifikácie odrážajú to, ako bude v novom stĺpci zobrazený názov zlučovaných stĺpcov z .name.
Špecifikácia popisuje metadáta uložené v názve stĺpca, s jedným riadkom pre každý stĺpec a jedným stĺpcom pre každú premennú, ktorá je zlúčená s názvom stĺpca. Možno sa takéto definovanie zdá zložité, ale po preštudovaní niekoľkých príkladov to bude omnoho jasnejšie.
Zmyslom špecifikácie je, že môžete extrahovať, meniť a definovať nové metadáta pre transformovaný dátový rámec.
Na prácu so špecifikáciami pri transformácii tabuľky z širokého formátu do dlhého slúži funkcia pivot_longer_spec().
Ako táto funkcia funguje, berie akýkoľvek dátový rámec a formuje jeho metadáta spôsobom popísaným vyššie.
Pre príklad si zoberme súbor údajov who, ktorý je dodávaný spolu s balíkom. tidyrTento súbor údajov obsahuje informácie poskytované medzinárodnou zdravotníckou organizáciou o výskyte tuberkulózy.
who
#> # A tibble: 7,240 x 60
#>    country iso2  iso3   year new_sp_m014 new_sp_m1524 new_sp_m2534
#>        & &
#>  1 Afghan… AF    AFG    1980          NA           NA           NA
#>  2 Afghan… AF    AFG    1981          NA           NA           NA
#>  3 Afghan… AF    AFG    1982          NA           NA           NA
#>  4 Afghan… AF    AFG    1983          NA           NA           NA
#>  5 Afghan… AF    AFG    1984          NA           NA           NA
#>  6 Afghan… AF    AFG    1985          NA           NA           NA
#>  7 Afghan… AF    AFG    1986          NA           NA           NA
#>  8 Afghan… AF    AFG    1987          NA           NA           NA
#>  9 Afghan… AF    AFG    1988          NA           NA           NA
#> 10 Afghan… AF    AFG    1989          NA           NA           NA
#> # … with 7,230 more rows, and 53 more variables
Vytvoríme jeho špecifikáciu.
spec %
  pivot_longer_spec(new_sp_m014:newrel_f65, values_to = "count")
#> # A tibble: 56 x 3
#> .name .value name
#> <chr> <chr> <chr>
#> 1 new_sp_m014 count new_sp_m014
#> 2 new_sp_m1524 count new_sp_m1524
#> 3 new_sp_m2534 count new_sp_m2534
#> 4 new_sp_m3544 count new_sp_m3544
#> 5 new_sp_m4554 count new_sp_m4554
#> 6 new_sp_m5564 count new_sp_m5564
#> 7 new_sp_m65 count new_sp_m65
#> 8 new_sp_f014 count new_sp_f014
#> 9 new_sp_f1524 count new_sp_f1524
#> 10 new_sp_f2534 count new_sp_f2534
#> # … with 46 more rowsPolia country, iso2, iso3 už sú premenné. Našou úlohou je prevrátiť stĺpce s new_sp_m014 o newrel_f65.
V názvoch týchto stĺpcov sú uložené nasledujúce informácie:
- Prefix
new_naznačuje, že stĺpec obsahuje údaje o nových prípadoch ochorenia tuberkulózou, aktuálny dátový rámec obsahuje informácie iba o nových ochoreniach, preto tento prefix v aktuálnom kontexte nemá žiaden význam. sp/rel/sp/epopisuje spôsob diagnostiky ochorenia.m/fpohlavie pacienta.014/1524/2535/3544/4554/65vek pacienta.
Tento stĺpec môžeme rozdeliť pomocou funkcie extract(), pomocou regulárneho výrazu.
spec %
        extract(name, c("diagnosis", "gender", "age"), "new_?(.*)_(.)(.*)")
#> # A tibble: 56 x 5
#> .name .value diagnosis gender age
#> <chr> <chr> <chr> <chr> <chr>
#> 1 new_sp_m014 count sp m 014
#> 2 new_sp_m1524 count sp m 1524
#> 3 new_sp_m2534 count sp m 2534
#> 4 new_sp_m3544 count sp m 3544
#> 5 new_sp_m4554 count sp m 4554
#> 6 new_sp_m5564 count sp m 5564
#> 7 new_sp_m65 count sp m 65
#> 8 new_sp_f014 count sp f 014
#> 9 new_sp_f1524 count sp f 1524
#> 10 new_sp_f2534 count sp f 2534
#> # … with 46 more rowsVšimnite si, že stĺpec .name musí zostať nezmenený, pretože to je náš index v názvoch stĺpcov pôvodného súboru údajov.
Pohlavie a vek (stĺpce gender a age) majú fixné a známe hodnoty, preto je odporúčané previesť tieto stĺpce na faktory:
spec %
            mutate(
              gender = factor(gender, levels = c("f", "m")),
              age = factor(age, levels = unique(age), ordered = TRUE)
            )
Nakoniec, aby sme mohli aplikovať našu vytvorenú špecifikáciu na pôvodný dátový rámec who musíme použiť argument spec v funkcii pivot_longer().
who %>% pivot_longer(spec = spec)
#> # A tibble: 405,440 x 8
#>    country     iso2  iso3   year diagnosis gender age   count
#>    <chr>       <chr> <chr> <int> <chr>     <fct>  <ord> <int>
#>  1 Afghanistan AF    AFG    1980 sp        m      014      NA
#>  2 Afghanistan AF    AFG    1980 sp        m      1524     NA
#>  3 Afghanistan AF    AFG    1980 sp        m      2534     NA
#>  4 Afghanistan AF    AFG    1980 sp        m      3544     NA
#>  5 Afghanistan AF    AFG    1980 sp        m      4554     NA
#>  6 Afghanistan AF    AFG    1980 sp        m      5564     NA
#>  7 Afghanistan AF    AFG    1980 sp        m      65       NA
#>  8 Afghanistan AF    AFG    1980 sp        f      014      NA
#>  9 Afghanistan AF    AFG    1980 sp        f      1524     NA
#> 10 Afghanistan AF    AFG    1980 sp        f      2534     NA
#> # … with 405,430 more rows
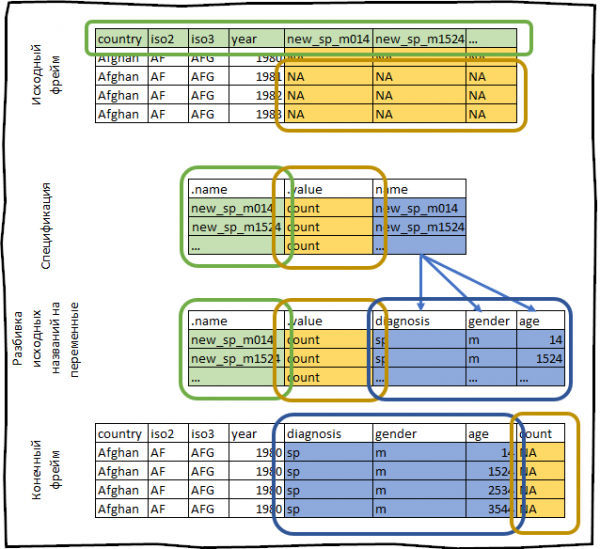
Všetko, čo sme práve urobili, môžeme schematicky znázorniť nasledovne:
Špecifikácia s použitím viacerých hodnôt (.value)
V uvedenom príklade je stĺpec špecifikácie .value obsahoval iba jednu hodnotu, v drvivej väčšine prípadov to tak aj býva.
Ale občas môže nastať situácia, keď je potrebné zlúčiť hodnoty z stĺpcov s rôznymi typmi údajov. Pomocou zastaranej funkcie spread() by to bolo celkom zložité.
Nižšie uvedený príklad je prevzatý z k balíku data.table.
Poďme si vytvoriť tréningový dátový rámec.
family <- tibble::tribble(
  ~family,  ~dob_child1,  ~dob_child2, ~gender_child1, ~gender_child2,
       1L, "1998-11-26", "2000-01-29",             1L,             2L,
       2L, "1996-06-22",           NA,             2L,             NA,
       3L, "2002-07-11", "2004-04-05",             2L,             2L,
       4L, "2004-10-10", "2009-08-27",             1L,             1L,
       5L, "2000-12-05", "2005-02-28",             2L,             1L,
)
family % mutate_at(vars(starts_with("dob")), parse_date)
#> # A tibble: 5 x 5
#> family dob_child1 dob_child2 gender_child1 gender_child2
#> <int> <date> <date> <int> <int>
#> 1 1 1998-11-26 2000-01-29 1 2
#> 2 2 1996-06-22 NA 2 NA
#> 3 3 2002-07-11 2004-04-05 2 2
#> 4 4 2004-10-10 2009-08-27 1 1
#> 5 5 2000-12-05 2005-02-28 2 1Vytvorený dátový rámec v každom riadku obsahuje údaje o deťoch jednej rodiny. V rodinách môže byť jedno alebo dve deti. Pre každé dieťa sú poskytnuté údaje o dátume narodenia a pohlaví, pričom údaje pre každé dieťa sú v samostatných stĺpcoch, našou úlohou je uviesť tieto údaje do správneho formátu pre analýzu.
Všimnite si, že máme dve premenné s informáciami o každom dieťati: jeho pohlavie a dátum narodenia (stĺpce s prefixom dob obsahujú dátum narodenia, stĺpce s prefixom gender obsahujú pohlavie dieťaťa). V očakávanom výsledku by mali byť v samostatných stĺpcoch. Môžeme to dosiahnuť generovaním špecifikácie, v ktorej stĺpec .value bude mať dve rôzne hodnoty.
spec %
  pivot_longer_spec(-family) %>%
  separate(col = name, into = c(".value", "child"))%>%
  mutate(child = parse_number(child))
#> # A tibble: 4 x 3
#>   .name         .value child
#>   <chr>         <chr>  <dbl>
#> 1 dob_child1    dob        1
#> 2 dob_child2    dob        2
#> 3 gender_child1 gender     1
#> 4 gender_child2 gender     2
Takže si poďme podrobne vysvetliť kroky, ktoré sú vykonané v uvedenom kóde.
pivot_longer_spec(-family)— vytvára špecifikáciu, ktorá zúži všetky existujúce stĺpce okrem stĺpca family.separate(col = name, into = c(".value", "child"))— rozdeľuje stĺpec .name, ktorý obsahuje názvy pôvodných polí, podľa podčiarkovníka a zapisuje získané hodnoty do stĺpcov .value a child.mutate(child = parse_number(child))— prevádza hodnoty poľa child z textového na číselný typ dát.
Teraz môžeme aplikovať získanú špecifikáciu na pôvodný dátový rámec a usporiadať tabuľku do požadovanej podoby.
family %>%
    pivot_longer(spec = spec, na.rm = T)
#> # A tibble: 9 x 4
#> family child dob gender
#> <int> <dbl> <date> <int>
#> 1 1 1 1998-11-26 1
#> 2 1 2 2000-01-29 2
#> 3 2 1 1996-06-22 2
#> 4 3 1 2002-07-11 2
#> 5 3 2 2004-04-05 2
#> 6 4 1 2004-10-10 1
#> 7 4 2 2009-08-27 1
#> 8 5 1 2000-12-05 2
#> 9 5 2 2005-02-28 1Používame argument na.rm = TRUE, pretože súčasná forma údajov núti vytvárať nadbytočné riadky pre neexistujúce pozorovania. Pretože rodina 2 má len jedno dieťa, na.rm = TRUE zaručuje, že rodina 2 bude mať jeden riadok vo výstupných údajoch.
Transformácia dátových rámcov z dlhého formátu na široký
pivot_wider() — je inverznou transformáciou, ktorá naopak zvyšuje počet stĺpcov dátového rámca znížením počtu riadkov.
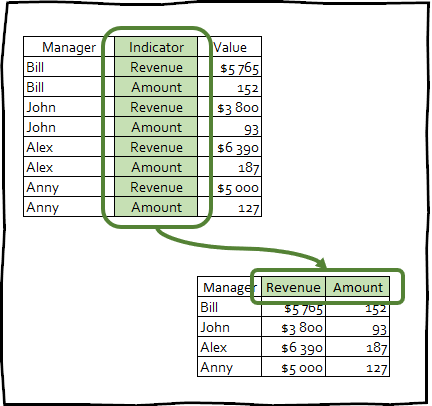
Takýto typ transformácie sa veľmi zriedka používa na usporiadanie údajov do prehľadnej formy, avšak tento prístup môže byť užitočný pri vytváraní súhrnných tabuliek na použitie v prezentáciách alebo pri integrácii s inými nástrojmi.
Skutočne, funkcie pivot_longer() a pivot_wider() sú vzájomne symetrické a vykonávajú opačné činnosti, t.j: df %>% pivot_longer(spec = spec) %>% pivot_wider(spec = spec) a df %>% pivot_wider(spec = spec) %>% pivot_longer(spec = spec) vráti pôvodný df.
Najjednoduchší príklad prevodu tabuľky na široký formát
Na demonštráciu fungovania funkcie pivot_wider() budeme používať súbor údajov fish_encounters, ktorý uchováva informácie o tom, ako rôzne stanice zaznamenávajú pohyb rýb v rieke.
#> # A tibble: 114 x 3
#>    fish  station  seen
#>    <fct> <fct>   <int>
#>  1 4842  Release     1
#>  2 4842  I80_1       1
#>  3 4842  Lisbon      1
#>  4 4842  Rstr        1
#>  5 4842  Base_TD     1
#>  6 4842  BCE         1
#>  7 4842  BCW         1
#>  8 4842  BCE2        1
#>  9 4842  BCW2        1
#> 10 4842  MAE         1
#> # … with 104 more rows
V väčšine prípadov bude táto tabuľka informatívnejšia a praktickejšia na používanie, ak sa informácie z každej stanice predstavia v samostatnom stĺpci.
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
#> # A tibble: 19 x 12
#>    fish  Release I80_1 Lisbon  Rstr Base_TD   BCE   BCW  BCE2  BCW2   MAE
#>        &        & & & & & &
#>  1 4842        1     1      1     1       1     1     1     1     1     1
#>  2 4843        1     1      1     1       1     1     1     1     1     1
#>  3 4844        1     1      1     1       1     1     1     1     1     1
#>  4 4845        1     1      1     1       1    NA    NA    NA    NA    NA
#>  5 4847        1     1      1    NA      NA    NA    NA    NA    NA    NA
#>  6 4848        1     1      1     1      NA    NA    NA    NA    NA    NA
#>  7 4849        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#>  8 4850        1     1     NA     1       1     1     1    NA    NA    NA
#>  9 4851        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#> 10 4854        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#>  # … with 9 more rows, and 1 more variable: MAW
Tento súbor údajov zaznamenáva informácie len v tých prípadoch, keď bola ryba zistená stanicou, t.j. ak nebola žiadna ryba zaznamenaná nejakou stanicou, tieto údaje v tabuľke nebudú. To znamená, že výstupné údaje budú vyplnené hodnotou NA.
Avšak v tomto prípade vieme, že absencia záznamu znamená, že ryba nebola zaznamenaná, takže môžeme použiť argument values_fill v funkcii pivot_wider() a vyplniť tieto chýbajúce hodnoty nulami:
fish_encounters %>% pivot_wider(
  names_from = station,
  values_from = seen,
  values_fill = list(seen = 0)
)
#> # A tibble: 19 x 12
#> fish Release I80_1 Lisbon Rstr Base_TD BCE BCW BCE2 BCW2 MAE
#> <fct> <int> <int> <int> <int> <int> <int> <int> <int> <int> <int>
#> 1 4842 1 1 1 1 1 1 1 1 1 1
#> 2 4843 1 1 1 1 1 1 1 1 1 1
#> 3 4844 1 1 1 1 1 1 1 1 1 1
#> 4 4845 1 1 1 1 1 0 0 0 0 0
#> 5 4847 1 1 1 0 0 0 0 0 0 0
#> 6 4848 1 1 1 1 0 0 0 0 0 0
#> 7 4849 1 1 0 0 0 0 0 0 0 0
#> 8 4850 1 1 0 1 1 1 1 0 0 0
#> 9 4851 1 1 0 0 0 0 0 0 0 0
#> 10 4854 1 1 0 0 0 0 0 0 0 0
#> # … with 9 more rows, and 1 more variable: MAW <int>Generovanie názvu stĺpca z viacerých pôvodných premenných
Predstavte si, že máme tabuľku, ktorá obsahuje kombináciu produktu, krajiny a roka. Na vygenerovanie testovacieho dátového rámca môžeme vykonať nasledujúci kód:
df %
  filter((product == "A" & country == "AI") | product == "B") %>%
  mutate(value = rnorm(nrow(.)))
#> # A tibble: 45 x 4
#> product country year value
#> <chr> <chr> <int> <dbl>
#> 1 A AI 2000 -2.05
#> 2 A AI 2001 -0.676
#> 3 A AI 2002 1.60
#> 4 A AI 2003 -0.353
#> 5 A AI 2004 -0.00530
#> 6 A AI 2005 0.442
#> 7 A AI 2006 -0.610
#> 8 A AI 2007 -2.77
#> 9 A AI 2008 0.899
#> 10 A AI 2009 -0.106
#> # … with 35 more rowsNašou úlohou je rozšíriť dátový rámec tak, aby jeden stĺpec obsahoval údaje pre každú kombináciu produktu a krajiny. Na to stačí zadať do argumentu names_from vektor, ktorý obsahuje názvy spájaných polí.
df %>% pivot_wider(names_from = c(product, country),
                 values_from = "value")
#> # A tibble: 15 x 4
#> year A_AI B_AI B_EI
#> <int> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 0.607 1.20
#> 2 2001 -0.676 1.65 -0.114
#> 3 2002 1.60 -0.0245 0.501
#> 4 2003 -0.353 1.30 -0.459
#> 5 2004 -0.00530 0.921 -0.0589
#> 6 2005 0.442 -1.55 0.594
#> 7 2006 -0.610 0.380 -1.28
#> 8 2007 -2.77 0.830 0.637
#> 9 2008 0.899 0.0175 -1.30
#> 10 2009 -0.106 -0.195 1.03
#> # … with 5 more rowsMôžete tiež aplikovať špecifikácie na funkciu pivot_wider(). Ale pri podaní do pivot_wider() špecifikácia vykonáva transformáciu, ktorá je opačná pivot_longer(): vytvárajú sa stĺpce, uvedené v .name, s použitím hodnôt z .value a iných stĺpcov.
Pre tento dátový súbor môžete vygenerovať vlastnú špecifikáciu, ak chcete, aby každá možná kombinácia krajiny a produktu mala vlastný stĺpec, a nie len tie, ktoré sa nachádzajú v dátach:
spec %
  expand(product, country, .value = "value") %>%
  unite(".name", product, country, remove = FALSE)
#> # A tibble: 4 x 4
#> .name product country .value
#> <chr> <chr> <chr> <chr>
#> 1 A_AI A AI value
#> 2 A_EI A EI value
#> 3 B_AI B AI value
#> 4 B_EI B EI valuedf %>% pivot_wider(spec = spec) %>% head()#> # A tibble: 6 x 5
#> year A_AI A_EI B_AI B_EI
#> <int> <dbl> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 NA 0.607 1.20
#> 2 2001 -0.676 NA 1.65 -0.114
#> 3 2002 1.60 NA -0.0245 0.501
#> 4 2003 -0.353 NA 1.30 -0.459
#> 5 2004 -0.00530 NA 0.921 -0.0589
#> 6 2005 0.442 NA -1.55 0.594Niekoľko pokročilých príkladov práce s novou koncepciou tidyr
Upravenie dát na príklade súboru o príjmoch a nájme v USA
Dátový súbor us_rent_income obsahuje informácie o priemernom príjme a nájomnom za každý štát v USA za rok 2017 (dátový súbor je dostupný v balíku tidycensus).
us_rent_income
#> # A tibble: 104 x 5
#>    GEOID NAME       variable estimate   moe
#>
#>  1 01    Alabama    income      24476   136
#>  2 01    Alabama    rent          747     3
#>  3 02    Alaska     income      32940   508
#>  4 02    Alaska     rent         1200    13
#>  5 04    Arizona    income      27517   148
#>  6 04    Arizona    rent          972     4
#>  7 05    Arkansas   income      23789   165
#>  8 05    Arkansas   rent          709     5
#>  9 06    California income      29454   109
#> 10 06    California rent         1358     3
#> # … s 94 ďalšími riadkami
V podobe, v ktorej sú uložené údaje v datasete, us_rent_income je s nimi mimoriadne nepohodlné pracovať, preto by sme chceli vytvoriť dátový súbor so stĺpcami: rent, rent_moe, come, income_moe. Existuje mnoho spôsobov, ako vytvoriť túto špecifikáciu, ale dôležité je, že potrebujeme vygenerovať každú kombináciu hodnôt premennej a estimate/moe, a potom vygenerovať názov stĺpca.
  spec %
    expand(variable, .value = c("estimate", "moe")) %>%
    mutate(
      .name = paste0(variable, ifelse(.value == "moe", "_moe", ""))
    )
#> # A tibble: 4 x 3
#> variable .value .name
#> <chr> <chr> <chr>
#> 1 income estimate income
#> 2 income moe income_moe
#> 3 rent estimate rent
#> 4 rent moe rent_moePoskytnutie tejto špecifikácie pivot_wider() nám dáva výsledok, ktorý hľadáme:
us_rent_income %>% pivot_wider(spec = spec)
#> # A tibble: 52 x 6
#>    GEOID NAME                 income income_moe  rent rent_moe
#>    <chr> <chr>                 <dbl>      <dbl> <dbl>    <dbl>
#>  1 01    Alabama               24476        136   747        3
#>  2 02    Alaska                32940        508  1200       13
#>  3 04    Arizona               27517        148   972        4
#>  4 05    Arkansas              23789        165   709        5
#>  5 06    California            29454        109  1358        3
#>  6 08    Colorado              32401        109  1125        5
#>  7 09    Connecticut           35326        195  1123        5
#>  8 10    Delaware              31560        247  1076       10
#>  9 11    District of Columbia  43198        681  1424       17
#> 10 12    Florida               25952         70  1077        3
#> # … with 42 more rows
Svetová banka
Niekedy si vyžaduje prevod súboru údajov do požadovanej formy niekoľko krokov.
Datasety world_bank_pop obsahuje údaje Svetovej banky o populácii každej krajiny v období od roku 2000 do roku 2018.
#> # A tibble: 1,056 x 20
#>    country indicator `2000` `2001` `2002` `2003`  `2004`  `2005`   `2006`
#>    <chr>   <chr>      <dbl>  <dbl>  <dbl>  <dbl>   <dbl>   <dbl>    <dbl>
#>  1 ABW     SP.URB.T… 4.24e4 4.30e4 4.37e4 4.42e4 4.47e+4 4.49e+4  4.49e+4
#>  2 ABW     SP.URB.G… 1.18e0 1.41e0 1.43e0 1.31e0 9.51e-1 4.91e-1 -1.78e-2
#>  3 ABW     SP.POP.T… 9.09e4 9.29e4 9.50e4 9.70e4 9.87e+4 1.00e+5  1.01e+5
#>  4 ABW     SP.POP.G… 2.06e0 2.23e0 2.23e0 2.11e0 1.76e+0 1.30e+0  7.98e-1
#>  5 AFG     SP.URB.T… 4.44e6 4.65e6 4.89e6 5.16e6 5.43e+6 5.69e+6  5.93e+6
#>  6 AFG     SP.URB.G… 3.91e0 4.66e0 5.13e0 5.23e0 5.12e+0 4.77e+0  4.12e+0
#>  7 AFG     SP.POP.T… 2.01e7 2.10e7 2.20e7 2.31e7 2.41e+7 2.51e+7  2.59e+7
#>  8 AFG     SP.POP.G… 3.49e0 4.25e0 4.72e0 4.82e0 4.47e+0 3.87e+0  3.23e+0
#>  9 AGO     SP.URB.T… 8.23e6 8.71e6 9.22e6 9.77e6 1.03e+7 1.09e+7  1.15e+7
#> 10 AGO     SP.URB.G… 5.44e0 5.59e0 5.70e0 5.76e0 5.75e+0 5.69e+0  4.92e+0
#> # … with 1,046 more rows, and 11 more variables: `2007` <dbl>,
#> #   `2008` <dbl>, `2009` <dbl>, `2010` <dbl>, `2011` <dbl>, `2012` <dbl>,
#> #   `2013` <dbl>, `2014` <dbl>, `2015` <dbl>, `2016` <dbl>, `2017` <dbl>
Našim cieľom je vytvoriť usporiadaný súbor údajov, kde je každá premenná v samostatnom stĺpci. Zatiaľ nie je jasné, aké presne kroky sú potrebné, ale začneme s najzjavnejším problémom: rok je rozdelený do viacerých stĺpcov.
Na to, aby sme to opravili, je potrebné použiť funkciu pivot_longer().
pop2 %
  pivot_longer(`2000`:`2017`, names_to = "year")
#> # A tibble: 19,008 x 4
#> country indicator year value
#> <chr> <chr> <chr> <dbl>
#> 1 ABW SP.URB.TOTL 2000 42444
#> 2 ABW SP.URB.TOTL 2001 43048
#> 3 ABW SP.URB.TOTL 2002 43670
#> 4 ABW SP.URB.TOTL 2003 44246
#> 5 ABW SP.URB.TOTL 2004 44669
#> 6 ABW SP.URB.TOTL 2005 44889
#> 7 ABW SP.URB.TOTL 2006 44881
#> 8 ABW SP.URB.TOTL 2007 44686
#> 9 ABW SP.URB.TOTL 2008 44375
#> 10 ABW SP.URB.TOTL 2009 44052
#> # … with 18,998 more rowsĎalším krokom je zvážiť premennú indicator.
pop2 %>% count(indicator)
#> # A tibble: 4 x 2
#>   indicator       n
#>   <chr>       <int>
#> 1 SP.POP.GROW  4752
#> 2 SP.POP.TOTL  4752
#> 3 SP.URB.GROW  4752
#> 4 SP.URB.TOTL  4752
Kde SP.POP.GROW — prírastok populácie, SP.POP.TOTL — celkový počet obyvateľov, a SP.URB. * to je to isté, ale iba pre mestskú oblasť. Rozdelme tieto hodnoty na dve premenne: area — lokalita (total alebo urban) a premennú obsahujúcu skutočné údaje (population alebo growth):
pop3 %
  separate(indicator, c(NA, "area", "variable"))
#> # A tibble: 19,008 x 5
#> country area variable year value
#> <chr> <chr> <chr> <chr> <dbl>
#> 1 ABW URB TOTL 2000 42444
#> 2 ABW URB TOTL 2001 43048
#> 3 ABW URB TOTL 2002 43670
#> 4 ABW URB TOTL 2003 44246
#> 5 ABW URB TOTL 2004 44669
#> 6 ABW URB TOTL 2005 44889
#> 7 ABW URB TOTL 2006 44881
#> 8 ABW URB TOTL 2007 44686
#> 9 ABW URB TOTL 2008 44375
#> 10 ABW URB TOTL 2009 44052
#> # … with 18,998 more rowsTeraz nám zostáva iba rozdeliť premennú variable na dva stĺpce:
pop3 %>%
  pivot_wider(names_from = variable, values_from = value)
#> # A tibble: 9,504 x 5
#> country area year TOTL GROW
#> <chr> <chr> <chr> <dbl> <dbl>
#> 1 ABW URB 2000 42444 1.18
#> 2 ABW URB 2001 43048 1.41
#> 3 ABW URB 2002 43670 1.43
#> 4 ABW URB 2003 44246 1.31
#> 5 ABW URB 2004 44669 0.951
#> 6 ABW URB 2005 44889 0.491
#> 7 ABW URB 2006 44881 -0.0178
#> 8 ABW URB 2007 44686 -0.435
#> 9 ABW URB 2008 44375 -0.698
#> 10 ABW URB 2009 44052 -0.731
#> # … with 9,494 more rowsKontaktný zoznam
Posledný príklad, predstavte si, že máte zoznam kontaktov, ktorý ste skopírovali a vložili z webovej stránky:
contacts <- tribble(
  ~field, ~value,
  "name", "Jiena McLellan",
  "company", "Toyota",
  "name", "John Smith",
  "company", "google",
  "email", "john@google.com",
  "name", "Huxley Ratcliffe"
)
Pri prevode tohto zoznamu do tabuľkového formátu je to dosť zložité, pretože neexistuje premenná, ktorá by identifikovala, ktoré údaje patria ktorému kontaktu. Môžeme to opraviť tým, že si všimneme, že údaje pre každý nový kontakt začínajú menom ("name"), a preto môžeme vytvoriť unikátny identifikátor a zvyšovať ho o jednotku vždy, keď sa v stĺpci field objaví hodnota "name":
contacts %
  mutate(
    person_id = cumsum(field == "name")
  )
contacts
#> # A tibble: 6 x 3
#> field value person_id
#> <chr> <chr> <int>
#> 1 name Jiena McLellan 1
#> 2 company Toyota 1
#> 3 name John Smith 2
#> 4 company google 2
#> 5 email john@google.com 2
#> 6 name Huxley Ratcliffe 3Teraz, keď máme unikátny identifikátor pre každý kontakt, môžeme otočiť pole a hodnotu do stĺpcov:
contacts %>%
  pivot_wider(names_from = field, values_from = value)
#> # A tibble: 3 x 4
#> person_id name company email
#> <int> <chr> <chr> <chr>
#> 1 1 Jiena McLellan Toyota <NA>
#> 2 2 John Smith google john@google.com
#> 3 3 Huxley Ratcliffe <NA> <NA>Záver
Osobne si myslím, že nová koncepcia tidyr je naozaj intuitívne pochopiteľnejšia a výrazne prevyšuje funkčnosť zastaraných funkcií spread() a gather(). Dúfam, že tento článok vám pomohol pochopiť pivot_longer() a pivot_wider().
Zdroj: habr.com
