

Preklad článku bol pripravený v predstihu pred začiatkom kurzu
Distribuované učenie na viacerých výkonných výpočtových inštanciách môže skrátiť čas učenia moderných hlbokých neurónových sietí na veľkom objeme dát z niekoľkých týždňov na hodiny alebo dokonca minúty, čo robí túto techniku učenia prevažujúcou z hľadiska praktického využitia hlbokého učenia. Používatelia by mali chápať, ako zdieľať a synchronizovať dáta na viacerých inštanciách, čo má zásadný vplyv na efektivitu škálovania. Okrem toho musia používatelia vedieť, ako nasadiť na viacerých inštanciách učebný skript, ktorý funguje na jednej inštancii.
V tomto článku sa budeme zaoberať rýchlym a jednoduchým spôsobom distribučného učenia s použitím otvorenej knižnice na hlboké učenie Apache MXNet a rámca pre distribuované učenie Horovod. Jasne ukážeme výhody rámca Horovod z hľadiska výkonu a predvedieme, ako napísať učebný skript MXNet tak, aby fungoval distribuovane s Horovodom.
Čo je Apache MXNet
je otvorený rámec na hlboké učenie, ktorý sa používa na vytváranie, učenie a nasadzovanie hlbokých neurónových sietí. MXNet abstrahuje zložitosti spojené s implementáciou neurónových sietí, má vysoký výkon a škálovateľnosť a ponúka API pre populárne programovacie jazyky ako , , , , , , a ďalších.
Distribuované učenie v MXNet so serverom parametrov
používa prístup servera parametrov. Používa sadu serverov parametrov na zhromažďovanie gradientov z každého pracovníka, vykonávanie agregácie a posielanie aktualizovaných gradientov späť pracovníkom pre ďalšiu iteráciu optimalizácie. Určenie správneho pomeru serverov k pracovníkom je zárukou efektívneho škálovania. Ak je server parametrov len jeden, môže sa stať úzkym hrdlom pri vykonávaní výpočtov. Naopak, ak je použitých príliš veľa serverov, môže byť spojenie „mnoho-k-mnohým“ preťažené všetkými sieťovými pripojeniami.
Čo je Horovod
– otvorený rámec distribuovaného hlbokého učenia vyvinutý spoločnosťou Uber. Využíva efektívne technológie interakcie medzi viacerými GPU a uzlami ako NVIDIA Collective Communications Library (NCCL) a Message Passing Interface (MPI) na rozdelenie a agregáciu parametrov modelu medzi workrami. Optimalizuje využitie šírky pásma siete a dobre sa škáluje pri práci s modelmi hlbokých neurónových sietí. V súčasnosti podporuje niekoľko populárnych rámcov strojového učenia, a to , Tensorflow, Keras a PyTorch.
Integrácia MXNet a Horovod
MXNet sa integruje s Horovod prostredníctvom API distribuovaného učenia, ktorý je definovaný v Horovod. V Horovod sú komunikačné API horovod.broadcast(), horovod.allgather() a horovod.allreduce() implementované pomocou asynchrónnych spätných volaní enginu MXNet, ako súčasť jeho grafu úloh. Týmto spôsobom sa dátové závislosti medzi komunikáciou a výpočtami ľahko spracúvajú enginom MXNet, aby sa predišlo stratám výkonu spôsobeným synchronizáciou. Objekt distributed optimizer, definovaný v Horovod horovod.DistributedOptimizer rozšiřuje Optimizer v MXNet tak, aby vyžadoval príslušné API Horovod na distribučné aktualizácie parametrov. Všetky tieto detaily implementácie sú transparentné pre koncových používateľov.
Rýchly štart
Môžete rýchlo začať trénovať malú konvolučnú neurónovú sieť na dátovom súbore MNIST pomocou MXNet a Horovod na vašom MacBooku.
Na začiatok nainštalujte mxnet a horovod z PyPI:
pip install mxnet
pip install horovod
Poznámka: Ak sa vám pri pip install horovodobjaví chyba, možno budete musieť pridať premennú MACOSX_DEPLOYMENT_TARGET=10.vv, kde vv – je to verzia vášho operačného systému MacOS, napríklad pre MacOSX Sierra budete musieť napísať MACOSX_DEPLOYMENT_TARGET=10.12 pip install horovod
Potom nainštalujte OpenMPI .
Nakoniec si stiahnite testovací skript mxnet_mnist.py a vykonajte nasledujúce príkazy v termináli MacBooku v pracovnom adresári:
mpirun -np 2 -H localhost:2 -bind-to none -map-by slot python mxnet_mnist.pyTakto spustíte učenie na dvoch jadrách vášho procesora. Na výstupe bude nasledujúce:
INFO:root:Epoch[0] Batch [0-50] Speed: 2248.71 samples/sec      accuracy=0.583640
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.89 samples/sec      accuracy=0.882812
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.39 samples/sec      accuracy=0.870000
Demonštrácia výkonu
Pri trénovaní modelu ResNet50-v1 na dátovom súbore ImageNet na 64 GPU s ôsmymi inštanciami p3.16xlarge Na cloudovom AWS sme dosiahli priepustnosť učenia 45000 obrázkov/s (t.j. počet natrénovaných vzoriek za sekundu) s EC2, z ktorých každý obsahuje 8 GPU NVIDIA Tesla V100. Učenie sa ukončilo za 44 minút po 90 epochách s najlepšou presnosťou 75,7%.
Porovnali sme to s distribuovaným učením MXNet, ktoré používa prístup serverov parametrov pri 8, 16, 32 a 64 GPU so serverom s jedným parametrom a pomerom serverov k pracovníkom 1:1 a 2:1. Výsledok môžete vidieť na Obrázku 1 nižšie. Na osi y vľavo stĺpce odrážajú počet obrázkov na učenie za sekundu, zatiaľ čo čiary odrážajú efektivitu škálovania (t.j. pomer skutočnej priepustnosti k ideálnej) na osi y vpravo. Ako vidíte, výber počtu serverov ovplyvňuje efektivitu škálovania. Ak je server parametrov jediný, efektivita škálovania klesá na 38% pri 64 GPU. Pre dosiahnutie rovnakej efektivity škálovania ako s Horovodom je potrebné zdvojnásobiť počet serverov v pomere k počtu pracovníkov.
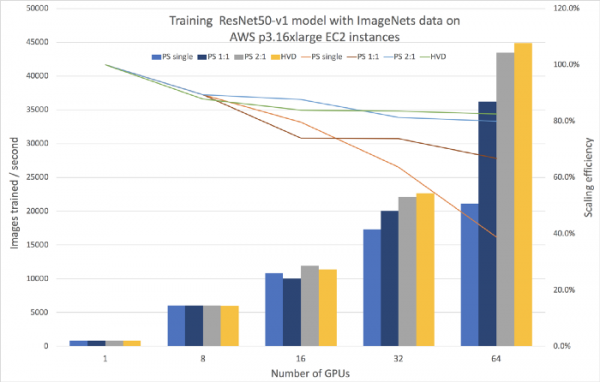
Obrázok 1. Porovnanie distribuovaného učenia pomocou MXNet s Horovodom a so serverom parametrov
V Tabuľke 1 nižšie sme porovnali konečné náklady na inštanciu pri realizácii experimentov na 64 GPU. Použitie MXNet spolu s Horovodom zaisťuje najlepšiu priepustnosť pri najnižších nákladoch.
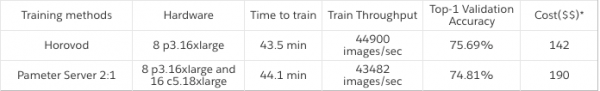
Tabuľka 1. Porovnanie nákladov medzi Horovodom a serverom parametrov s pomerom serverov k pracovníkom 2:1.
Kroky na reprodukciu
V nasledujúcich krokoch vám ukážeme, ako reprodukovať výsledok distribuovaného učenia pomocou MXNet a Horovodu. Pre viac informácií o distribuovanom učení s MXNet si prečítajte .
Krok 1
Vytvorte klastra homogénnych inštancií s MXNet verzie 1.4.0 alebo vyššej a Horovod verzie 0.16.0 alebo vyššej, aby ste mohli využiť distribuované učenie. Taktiež budete musieť nainštalovať knižnice pre učenie na GPU. Pre naše inštancie sme zvolili Ubuntu 16.04 Linux, s ovládačom GPU 396.44, CUDA 9.2, knižnicou cuDNN 7.2.1, komunikačnými prostriedkami NCCL 2.2.13 a OpenMPI 3.1.1. Môžete tiež použiť , kde sú tieto knižnice už predinštalované.
Krok 2
Pridajte do svojho tréningového skriptu MXNet možnosť pracovať s API Horovod. Nižšie uvedený skript na základe MXNet Gluon API môžete použiť ako jednoduchú šablónu. Riadky vyznačené tučne sú potrebné v prípade, že už máte zodpovedajúci tréningový skript. Tu je niekoľko kritických zmien, ktoré je potrebné vykonať pre školenie s Horovod:
- Nastavte kontext podľa lokálneho rangu Horovod (riadok 8), aby ste chápali, že školenie prebieha na správnom grafickom procesore.
- Odovzdajte počiatočné parametre od jedného pracovníka ku všetkým (riadok 18), aby ste sa uistili, že všetci pracovníci začínajú s rovnakými počiatočnými parametrami.
- Vytvorte Horovod DistributedOptimizer (riadok 25), aby ste mohli parametre aktualizovať rozdeleným spôsobom.
Aby ste získali kompletný skript, pozrite sa na príklady Horovod-MXNet a .
1  import mxnet as mx
2  import horovod.mxnet as hvd
3
4  # Horovod: inicializujte Horovod
5  hvd.init()
6
7  # Horovod: priradte GPU na použitie k lokálnemu rangu
8  context = mx.gpu(hvd.local_rank())
9
10 # Vytvorte model
11 model = ...
12
13 # Inicializujte parametre
14 model.initialize(initializer, ctx=context)
15 params = model.collect_params()
16
17 # Horovod: vysielajte parametre
18 hvd.broadcast_parameters(params, root_rank=0)
19
20 # Vytvorte optimalizátor
21 optimizer_params = ...
22 opt = mx.optimizer.create('sgd', **optimizer_params)
23
24 # Horovod: zabalte optimalizátor do DistributedOptimizer
25 opt = hvd.DistributedOptimizer(opt)
26
27 # Vytvorte trénera a funkciu straty
28 trainer = mx.gluon.Trainer(params, opt, kvstore=None)
29 loss_fn = ...
30
31 # Trénujte model
32 for epoch in range(num_epoch):
33    ...
Krok 3
Prihláste sa do jedného z pracovníkov na spustenie distribuovaného školenia pomocou direktívy MPI. V tomto príklade sa distribuované školenie spúšťa na štyroch inštanciách s 4 GPU v každom, a celkovo s 16 GPU v klastri. Bude sa používať optimalizátor stochastického gradientného zostupu (SGD) s nasledujúcimi hyperparametrami:
- mini-batch size: 256
- learning rate: 0.1
- momentum: 0.9
- weight decay: 0.0001
S rastom od jedného GPU po 64 GPU sme lineárne škálovali rýchlosť učenia v súlade s počtom GPU (od 0,1 pre 1 GPU po 6,4 pre 64 GPU), pričom počet obrázkov na jeden GPU zostal 256 (od dávky 256 obrázkov pre 1 GPU po 16 384 pre 64 GPU). Parametre weight decay a momentum sa menili v závislosti od zvýšenia počtu GPU. Použili sme zmiešanú presnosť učenia s typom dát float16 pri priamom prechode a float32 pre gradienty, aby sme urýchlili výpočty float16, ktoré podporujú GPU NVIDIA Tesla.
$ mpirun -np 16
    -H server1:4,server2:4,server3:4,server4:4
    -bind-to none -map-by slot
    -mca pml ob1 -mca btl ^openib
    python mxnet_imagenet_resnet50.py
Záver
V tomto článku sa zaoberáme škálovateľným prístupom k distribuovanému tréningu modelu pomocou Apache MXNet a Horovod. Preukázali sme efektívnosť škálovania a hospodársku efektívnosť v porovnaní s prístupom využívajúcim server parametrov na datasete ImageNet, na ktorom bol trénovaný model ResNet50-v1. Taktiež sme reflektovali kroky, pomocou ktorých môžete zmeniť už existujúci skript na spustenie tréningu na viacerých inštanciách pomocou Horovod.
Ak práve začínate pracovať s MXNet a hlbokým učením, prejdite na stránku inštalácie , aby ste najprv zostavili MXNet. Taktiež veľmi odporúčame prečítať si článok , aby ste sa dostali do praxe.
Ak už ste pracovali s MXNet a chcete vyskúšať distribuované učenie s Horovod, potom sa pozrite na , zostavte ho s MXNet a riaďte sa príkladom alebo .
*cena sa vypočítava na základe AWS pre inštancie EC2
Zistiť viac o kurze
Zdroj: habr.com
