

CAP-teória je kľúčovým konceptom teórie distribuovaných systémov. Samozrejme, diskusie okolo nej neutíchajú: ani definície nie sú kanonické a prísne dôkazy chýbajú… Napriek tomu, pevne stojac na pozíciách ľudského zdravého rozumu™, intuitívne chápeme, že teória je pravdivá.
Jedna vec však nie je zrejmá, a to význam písmena „P“. Keď sa klaster rozdelí, rozhoduje sa, či neodpovedať, kým nebude dosiahnutý kvórum, alebo poskytnúť dostupné dáta. V závislosti od výsledkov tohto výberu sa systém klasifikuje buď ako CP, alebo ako AP. Cassandra, napríklad, sa môže správať rôzne, a to nielen na základe nastavení klastrov, ale aj na základe parametrov každého konkrétneho dopytu. Ale ak systém nie je „P“ a rozdelil sa, čo potom?
Odpoveď na túto otázku je trochu prekvapujúca: CA-klaster sa nemôže rozdeliť.
Čo je to za klaster, ktorý sa nemôže rozdeliť?
Neodmysliteľným atribútom takého klastera je spoločný systém ukladania dát. V drvivej väčšine prípadov to znamená pripojenie cez SAN, čo obmedzuje použitie CA-rychlých riešení len na veľké podniky, ktoré si môžu dovoliť SAN-infrastruktúru. Aby niekoľko serverov mohlo pracovať s tými istými dátami, potrebný je klastrový súborový systém. Takéto súborové systémy sú dostupné v portfóliách HPE (CFS), Veritas (VxCFS) a IBM (GPFS).
Oracle RAC
Možnosť Real Application Cluster sa prvýkrát objavila v roku 2001 v release Oracle 9i. V takom klasteri pracuje niekoľko inštancií servera s jednou a tou istou databázou.
Oracle môže pracovať ako so klastrovým súborovým systémom, tak aj s vlastným riešením – ASM, Automatic Storage Management.
Každá inštancia vedie svoj žurnál. Transakcia sa vykonáva a zaznamenáva jednou inštanciou. V prípade zlyhania inštancie si jeden z prežívajúcich uzlov klastera (inštancií) prečíta jeho žurnál a obnoví stratené dáta – týmto sa zabezpečuje dostupnosť.
Všetky inštancie udržiavajú svoj vlastný cache a tie isté stránky (bloky) môžu byť súčasne v cache viacerých inštancií. Viac toho, ak nejaká stránka je potrebná jednej inštancii a je v cache inej inštancie, môže ju získať od „suseda“ pomocou mechanizmu cache fusion namiesto čítania z disku.
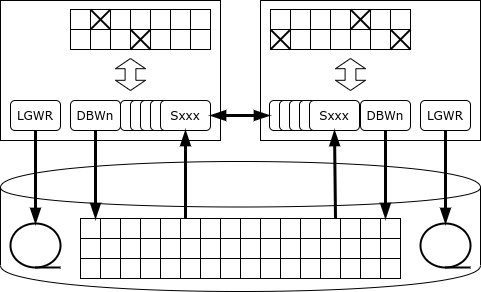
Čo sa však stane, ak bude jednej z inštancií potrebné zmeniť údaje?
Špecifickosť Oracle spočíva v tom, že nemá vyhradenú službu blokovania: ak chce server zablokovať riadok, záznam o blokovaní sa umiestni priamo na tú stránku pamäte, kde sa nachádza blokovaný riadok. Vďaka tomuto prístupu je Oracle lídrom v produktivite medzi monolitickými databázami: služba blokovania sa nikdy nestáva úzkym hrdlom. No v klastrovéj konfigurácii môže takáto architektúra viesť k intenzívnej sietovej komunikácii a vzájomnému blokovaniu.
Akonáhle je záznam zablokovaný, inštancia upozorní všetky ostatné inštancie, že stránka, na ktorej sa nachádza tento záznam, bola obsadená v monopolnom režime. Ak bude inej inštancii potrebné zmeniť záznam na tej istej stránke, musí čakať, kým nebudú zmeny na stránke potvrdené, t. j. informácia o zmene nebude zapísaná do denníka na disku (medzitým môže transakcia pokračovať). Môže sa stať aj to, že stránku bude postupne meniť niekoľko inštancií, a potom pri zápise stránky na disk bude potrebné zistiť, u koho sa nachádza aktuálna verzia tejto stránky.
Náhodné aktualizácie tých istých stránok cez rôzne uzly RAC vedú k dramatickému poklesu výkonu databázy – až do takej miery, že výkon klastrov môže byť nižší, než výkon jediného inštancie.
Správne používanie Oracle RAC spočíva vo fyzickom rozdelení údajov (napríklad pomocou mechanizmu sekciovaných tabuliek) a prístupu k jednotlivým sadám sekcií cez vyhradený uzol. Hlavným účelom RAC sa stalo nie horizontálne škálovanie, ale zabezpečenie odolnosti voči poruchám.
Ak uzol prestane odpovedať na heartbeat, uzol, ktorý to prvý zistí, spustí procedúru hlasovania na disku. Ak sa ani tu chýbajúci uzol neoznačí, jeden z uzlov preberá povinnosti na obnovenie údajov:
- „zmrazí“ všetky stránky, ktoré sa nachádzali v cache chýbajúceho uzla;
- číta denníky (redo) chýbajúceho uzla a opätovne aplikuje zmeny, ktoré sú zaznamenané v týchto denníkoch, pričom kontroluje, či nie sú u iných uzlov novšie verzie menených stránok;
- vracia nedokončené transakcie.
Aby sa zjednodušilo prepínanie medzi uzlami, v Oracle existuje pojem služby – virtuálny inštancie. Inštancia môže obsluhovať niekoľko služieb a služba sa môže presúvať medzi uzlami. Inštancia aplikácie, ktorá obsluhuje určitú časť databázy (napríklad skupinu zákazníkov), pracuje s jednou službou, a služba, ktorá zodpovedá za túto časť databázy, sa pri výpadku uzla presúva na iný uzol.
IBM Pure Data Systems for Transactions
Klastrové riešenie pre DBMS sa objavilo v portfóliu Modrého Giganta v roku 2009. Ideologicky je pokračovaním klastrovej architektúry Parallel Sysplex, postavenej na "bežnom" hardvéri. V roku 2009 bol uvedený produkt DB2 pureScale, ktorý predstavuje súpravu softvéru, a v roku 2012 IBM ponúka programovo-hardware balík (appliance) nazvaný Pure Data Systems for Transactions. Neda sa zamieňať s Pure Data Systems for Analytics, ktorá nie je nič iné ako premenovaný Netezza.
Architektúra pureScale na prvý pohľad pripomína Oracle RAC: rovnako sú niekoľko uzlov pripojených k spoločnému systému ukladania dát a na každom uzle beží svoj vlastný inštancia DBMS so svojimi pamäťovými oblasťami a žurnálmi transakcií. Ale na rozdiel od Oracle má DB2 vyhradenú službu zámkov, reprezentovanú súborom procesov db2LLM*. V klastrovej konfigurácii je táto služba presunutá na samostatný uzol, ktorý v Parallel Sysplex nazývame coupling facility (CF), a v Pure Data – PowerHA.
PowerHA poskytuje nasledujúce služby:
- manažér zámkov;
- globálny vyrovnávací pamäť;
- oblasť medzi procesov komunikácií.
Na prenos dát medzi PowerHA a uzlami databázy a späť sa používa vzdialený prístup k pamäti, preto musí klastrové prepojenie podporovať protokol RDMA. PureScale môže používať ako Infiniband, tak aj RDMA over Ethernet.
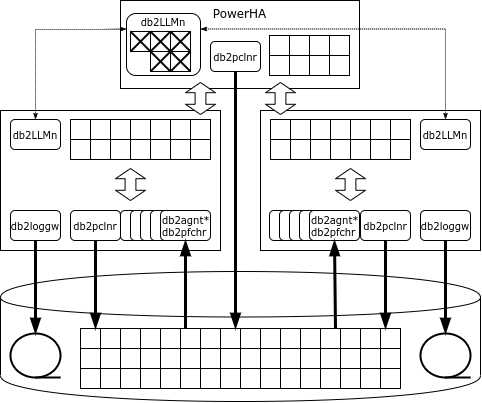
Ak uzlu potrebná stránka nie je v cache, uzol žiada stránku z globálnej cache, a iba v prípade, že ani tam nie je, si ju prečíta z disku. Na rozdiel od Oracle, požiadavok ide iba do PowerHA, a nie na susedné uzly.
Ak sa inštancia chystá zmeniť riadok, zablokuje ho v exkluzívnom režime a stránku, na ktorej sa riadok nachádza, v zdieľanom režime. Všetky blokácie sú registrované v globálnom správci blokácií. Po ukončení transakcie uzol pošle správu správcu blokácií, ktorý skopíruje zmenenú stránku do globálneho cache, zruší blokácie a invaliduje zmenenú stránku v cache iných uzlov.
Ak je stránka, na ktorej sa nachádza menený riadok, už zablokovaná, správca blokácií prečíta zmenenú stránku z pamäte uzla, ktorý vykonal zmeny, zruší blokáciu, invaliduje zmenenú stránku v cache iných uzlov a vydá blokáciu stránky uzlu, ktorý ju požiadal.
Prípadne zmenené stránky môžu byť zapísané na disk buď z bežného uzla, alebo pomocou PowerHA (castout).
Pri zlyhaní jedného z uzlov pureScale je obnova obmedzená len na tie transakcie, ktoré v čase zlyhania ešte neboli dokončené: stránky, ktoré tento uzol zmenil v dokončených transakciách, sú v globálnom cache na PowerHA. Uzol sa reštartuje s obmedzenou konfiguráciou na jednom zo serverov klastre, vracia nezakompletizované transakcie a uvoľňuje blokácie.
PowerHA funguje na dvoch serveroch a hlavný uzol synchronne replikátoruje svoj stav. Pri zlyhaní hlavného uzla PowerHA klaster pokračuje v práci s rezervným uzlom.
Samozrejme, ak sa na sadu dát pristupuje cez jeden uzol, celkový výkon klastre bude vyšší. PureScale dokonca môže zistiť, že určitá oblasť dát je spracovávaná jedným uzlom, a všetky blokácie súvisiace s touto oblasťou budú spracované uzlom lokálne bez komunikácie s PowerHA. Ale ak sa aplikácia pokúsi pristúpiť k týmto dátam cez iný uzol, centralizované spracovanie blokácií sa obnoví.
Interné testy IBM na záťaži pozostávajúcej z 90% čítania a 10% zápisu, čo veľmi pripomína reálnu priemyselnú záťaž, ukazujú takmer lineárne škálovanie až do 128 uzlov. Podmienky testovania, žiaľ, nie sú zverejnené.
HPE NonStop SQL
Vo vlastní high-availability platformu má vo svojom portfóliu aj Hewlett-Packard Enterprise. Ide o platformu NonStop, ktorá bola uvedená na trh v roku 1976 firmou Tandem Computers. V roku 1997 bola táto spoločnosť prevzatá firmou Compaq, ktorá sa v roku 2002 zlúčila s Hewlett-Packard.
NonStop sa používa na budovanie kritických aplikácií – napríklad HLR alebo spracovanie bankových kariet. Platforma sa dodáva ako hardvérovo-softvérový komplex (appliance), ktorý zahŕňa výpočtové uzly, systémy ukladania dát a komunikačné zariadenia. Sieť ServerNet (v moderných systémoch – Infiniband) slúži na výmenu medzi uzlami aj na prístup k systému ukladania dát.
Vo vnútorných verziách systému sa používali proprietárne procesory, ktoré boli synchronizované navzájom: všetky operácie sa vykonávali synchronne viacerými procesormi a keď sa jeden z procesorov pokazil, vypol sa, zatiaľ čo druhý pokračoval v práci. Neskôr systém prešiel na bežné procesory (najprv MIPS, potom Itanium a napokon x86) a na synchronizáciu sa začali používať iné mechanizmy:
- správy: každý systémový proces má svojho duplikátu – „tiene“, ktorému aktívny proces periodicky posiela správy o svojom stave; pri zlyhaní hlavného procesu začne tienenie pracovať od bodu určeného poslednou správou;
- hlasovanie: systém ukladania dát má špeciálnu hardvérovú súčiastku, ktorá prijíma niekoľko identických požiadaviek a vykonáva ich len v prípade, ak sa požiadavky zhodujú; namiesto fyzickej synchronizácie pracujú procesory asynchrónne a výsledky ich práce sa porovnávajú len v okamihoch vstupu/výstupu.
Od roku 1987 na platforme NonStop funguje relačná DBMS – najprv SQL/MP, neskôr SQL/MX.
Celá databáza sa delí na časti, pričom každú časť spravuje svoj proces Data Access Manager (DAM). Ten zabezpečuje zápis dát, cacheovanie a mechanizmus zámkov. Spracovaním dát sa zaoberajú procesy vykonávatelia (Executor Server Process), ktoré fungujú na tých istých uzloch ako príslušní manažéri dát. Plánovač SQL/MX rozdeľuje úlohy medzi vykonávateľov a spája výsledky. Pri nutnosti vykonať zosúladené zmeny sa používa protokol s dvojfázovou záväznosťou zabezpečený knižnicou TMF (Transaction Management Facility).
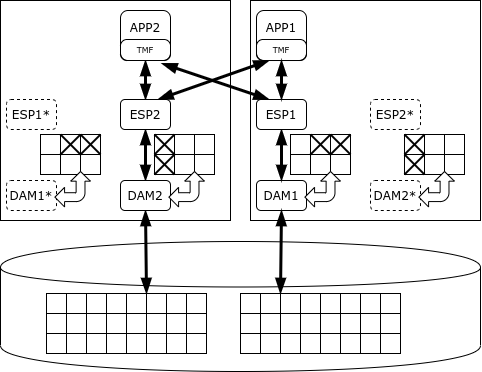
NonStop SQL dokáže prioritizovať procesy tak, aby dlhé analytické dotazy nebránili vykonaniu transakcií. Jej určením je spracovanie krátkych transakcií, nie analytika. Výrobca zaručuje dostupnosť klastru NonStop na úrovni piatich „deviatok“, čo znamená, že prestoje predstavujú iba 5 minút ročne.
SAP HANA
Prvá stabilná verzia DBMS HANA (1.0) bola vydaná v novembri 2010 a balík SAP ERP prešiel na HANA od mája 2013. Platforma je založená na zakúpených technológiách: TREX Search Engine (vyhľadávanie v stĺpcových úložiskách), DBMS P*TIME a MAX DB.
Samo slovo „HANA“ je akronym, High performance ANalytical Appliance. Tento DBMS sa dodáva vo forme kódu, ktorý môže fungovať na akýchkoľvek serveroch x86, avšak priemyselné inštalácie sú povolené iba na certifikovanom hardvéri. Existujú riešenia HP, Lenovo, Cisco, Dell, Fujitsu, Hitachi, NEC. Niektoré konfigurácie Lenovo dokonca umožňujú prevádzku bez SAN – úlohu zdieľaného úložiska plní klaster GPFS na lokálnych diskoch.
Na rozdiel od vyššie uvedených platforiem je HANA DBMS v pamäti, to znamená, že primárny obraz dát sa uchováva v operačnej pamäti a na disk sa ukladajú iba záznamy a periodické snímky – na obnovenie v prípade havárie.
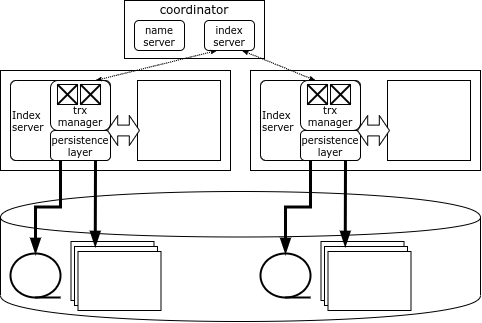
Každý uzol klastra HANA zodpovedá za svoju časť dát, pričom mapa dát sa uchováva v špeciálnom komponente – Name Server, umiestnenom na koordinátorovom uzle. Dáta medzi uzlami sa neduplikuje. Informácie o zámkoch sa tiež uchovávajú na každom uzle, ale systém obsahuje globálny detektor vzájomných zámkov.
Klient HANA pri pripojení k clusteru načíta jeho topológiu a následne sa môže priamo obrátiť na akýkoľvek uzol v závislosti od toho, aké dáta potrebuje. Ak transakcia zasahuje do dát jediného uzla, môže byť vykonaná týmto uzlom lokálne, ale ak sa menia dáta niekoľkých uzlov, uzol-iniciátor sa obracia na uzol-koordinátor, ktorý otvára a koordinuje distribučnú transakciu a potvrdzuje ju pomocou optimalizovaného protokolu dvojfázového potvrdenia.
Uzol-koordinátor je duplikovaný, takže v prípade výpadku koordinátora okamžite začne pracovať záložný uzol. Ak však zlyhá uzol s dátami, jediný spôsob, ako získať prístup k jeho dátam, je reštartovať uzol. Zvyčajne v klastroch HANA udržiavajú záložný (spare) server, aby čo najrýchlejšie reštartovali na ňom stratený uzol.
Zdroj: habr.com
