

Ahojte, Habráci. Ako sme už písali, tento mesiac OTUS spúšťa hneď dva kurzy o strojovom učení, a to a . V súvislosti s tým pokračujeme v zdieľaní užitočného materiálu.
Cieľom tohto článku je porozprávať o našich prvých skúsenostiach s použitím .
Začneme prehľadom s jeho sledovacím serverom a zaznamenáme všetky iterácie výskumu. Potom sa podelíme o skúsenosti s prepojením Sparku s MLflow pomocou UDF.
Kontext
My v používa strojové učenie a umelú inteligenciu, aby ľuďom umožnila starať sa o ich zdravie a pohodu. Preto sú modely strojového učenia základom produktov spracovania údajov, ktoré vyvíjame, a práve preto nás zaujala MLflow — platforma s otvoreným zdrojovým kódom, ktorá pokrýva všetky aspekty životného cyklu strojového učenia.
MLflow
Hlavným cieľom MLflow je poskytnúť dodatočnú vrstvu nad strojovým učením, ktorá by umožnila odborníkom na spracovanie údajov pracovať prakticky s akoukoľvek knižnicou strojového učenia (, , , , a ), posúvajúc jej výkon na novú úroveň.
MLflow poskytuje tri komponenty:
- Sledovanie – zaznamenávanie a dotazy na experimenty: kód, údaje, konfiguráciu a výsledky. Sledovanie procesu vytvárania modelu je veľmi dôležité.
- Projects – Formát balenia na spustenie na akejkoľvek platforme (napríklad, )
- Modely – spoločný formát na odosielanie modelov do rôznych nástrojov nasadenia.
MLflow (v čase písania článku v alfa-verzii) je platforma s otvoreným zdrojovým kódom, ktorá umožňuje spravovať životný cyklus strojového učenia, vrátane experimentov, opätovného použitia a nasadenia.
Nastavenie MLflow
Na používanie MLflow je potrebné najprv nastaviť celé prostredie Python, na to využijeme (aby ste nainštalovali Python na Mac, pozrite sa ). Takto môžeme vytvoriť virtuálne prostredie, do ktorého nainštalujeme všetky potrebné knižnice na spustenie.
```
pyenv install 3.7.0
pyenv global 3.7.0 # Použiť Python 3.7
mkvirtualenv mlflow # Vytvoriť virtuálne prostredie s Python 3.7
workon mlflow
```
Nainštalujeme potrebné knižnice.
```
pip install mlflow==0.7.0
            Cython==0.29
            numpy==1.14.5
            pandas==0.23.4
            pyarrow==0.11.0
```
Poznámka: používať PyArrow na spustenie modelov ako UDF. Verzie PyArrow a Numpy bolo potrebné upraviť, pretože najnovšie verzie boli v konflikte medzi sebou.
Spúšťame Sledovanie UI
MLflow Tracking nám umožňuje zaznamenávať a dotazovať sa na experimenty pomocou Pythonu a API. Okrem toho môžeme určiť, kde uchovávať artefakty modelu (localhost, , , alebo ). Keďže v Alpha Health používame AWS, ako úložisko artefaktov bude S3.
# Running a Tracking Server
mlflow server
    --file-store /tmp/mlflow/fileStore
    --default-artifact-root s3://<bucket>/mlflow/artifacts/
    --host localhost
    --port 5000
MLflow odporúča používať trvalé súborové úložisko. Súborové úložisko je miesto, kde server uchováva metadata spustení a experimentov. Pri spustení servera sa uistite, že ukazuje na trvalé súborové úložisko. Pre tento experiment sa jednoducho využijeme /tmp.
Majte na pamäti, že ak chceme použiť server mlflow na spúšťanie starých experimentov, musia byť prítomné v súborovom úložisku. Avšak aj bez toho by sme ich mohli použiť v UDF, pretože potrebujeme len cestu k modelu.
Poznámka: Uistite sa, že Tracking UI a klient modelu majú prístup k umiestneniu artefaktu. To znamená, že bez ohľadu na to, že Tracking UI sa nachádza v instance EC2, pri lokálnom spustení MLflow musí mať stroj priame pripojenie k S3 na zápis modelov artefaktov.
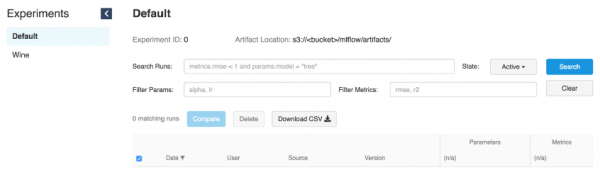
Tracking UI uchováva artefakty v S3 buckete
Spustenie modelov
Akonáhle bude Tracking server funkčný, môžete začať trénovať modely.
Ako príklad použijeme modifikáciu wine z príkladu MLflow v .
MLFLOW_TRACKING_URI=http://localhost:5000 python wine_quality.py
  --alpha 0.9
  --l1_ratio 0.5
  --wine_file ./data/winequality-red.csv
Ako sme už spomenuli, MLflow umožňuje zaznamenávať parametre, metriky a artefakty modelov, aby sme mohli sledovať, ako sa vyvíjajú počas iterácií. Táto funkcia je mimoriadne užitočná, pretože tak môžeme reprodukovať najlepší model, obrátiť sa na Tracking server alebo pochopiť, ktorý kód vykonal potrebnú iteráciu pomocou logov git hash commitov.
with mlflow.start_run():

    ... model ...

    mlflow.log_param("source", wine_path)
    mlflow.log_param("alpha", alpha)
    mlflow.log_param("l1_ratio", l1_ratio)

    mlflow.log_metric("rmse", rmse)
    mlflow.log_metric("r2", r2)
    mlflow.log_metric("mae", mae)

    mlflow.set_tag('domain', 'wine')
    mlflow.set_tag('predict', 'quality')
mlflow.sklearn.log_model(lr, "model") 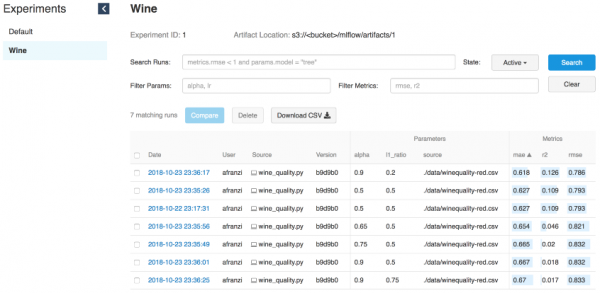
Iterácie vína
Serverová časť pre model
Sledovací server MLflow spuštěný příkazem “mlflow server” má REST API pro sledování spuštění a zápis dat do místního souborového systému. Můžete specifikovat adresu sledovacího serveru pomocí proměnné prostředí „MLFLOW_TRACKING_URI“ a sledovací API MLflow se automaticky spojí se sledovacím serverem na této adrese, aby vytvořilo/našlo informace o spuštění, metriky logů atd.
Zdroj:
K zajištění modelu serverem potřebujeme spuštěný sledovací server (viz rozhraní spuštění) a ID spuštění modelu.
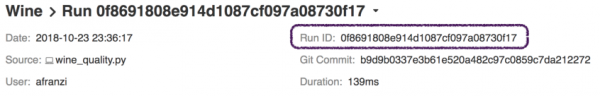
ID spuštění
# Serve a sklearn model through 127.0.0.0:5005
MLFLOW_TRACKING_URI=http://0.0.0.0:5000 mlflow sklearn serve
  --port 5005
  --run_id 0f8691808e914d1087cf097a08730f17
  --model-path model
Pro správu modelů pomocí funkce MLflow serve potřebujeme přístup k sledovacímu UI, abychom mohli získat informace o modelu jednoduchým uvedením --run_id.
Jakmile se model spojí se sledovacím serverem, můžeme získat novou koncovou adresu modelu.
# Query Tracking Server Endpoint
curl -X POST
  http://127.0.0.1:5005/invocations
  -H 'Content-Type: application/json'
  -d '[
	{
		"fixed acidity": 3.42,
		"volatile acidity": 1.66,
		"citric acid": 0.48,
		"residual sugar": 4.2,
		"chloridessssss": 0.229,
		"free sulfur dsioxide": 19,
		"total sulfur dioxide": 25,
		"density": 1.98,
		"pH": 5.33,
		"sulphates": 4.39,
		"alcohol": 10.8
	}
]'

> {"predictions": [5.825055635303461]}
Spuštění modelů ze Spark
Ačkoli je sledovací server dostatečně výkonný pro služby modelů v reálném čase, jejich trénink a použití funkce serve (zdroj: ), použití Spark (dávkové nebo streaming) je ještě mocnější řešení díky distribuované architektuře.
Představte si, že jste právě provedli trénink v offline režimu a pak použili výstupní model na všech vašich datech. To je místo, kde se Spark a MLflow ukážou v nejlepším světle.
Instalujeme PySpark + Jupyter + Spark
Zdroj:
Abychom ukázali, jak aplikujeme modely MLflow na datové rámce Spark, musíme nastavit spolupráci Jupyter notebooků s PySpark.
Začněte instalací nejnovější stabilní verze :
cd ~/Downloads/
tar -xzf spark-2.4.3-bin-hadoop2.7.tgz
mv ~/Downloads/spark-2.4.3-bin-hadoop2.7 ~/
ln -s ~/spark-2.4.3-bin-hadoop2.7 ~/spark̀
Nainstalujte PySpark a Jupyter do virtuálního prostředí:
pip install pyspark jupyterNastavte proměnné prostředí:
export SPARK_HOME=~/spark
export PATH=$SPARK_HOME/bin:$PATH
export PYSPARK_DRIVER_PYTHON=jupyter
export PYSPARK_DRIVER_PYTHON_OPTS="notebook --notebook-dir=${HOME}/Projects/notebooks"
Definováním notebook-dir, budeme moci uchovávat naše notebooky ve vybrané složce.
Spouštíme Jupyter z PySpark
Protože jsme byli schopni nastavit Jupiter jako ovladač PySpark, nyní můžeme spustit Jupyter notebook v kontextu PySpark.
(mlflow) afranzi:~$ pyspark
[I 19:05:01.572 NotebookApp] sparkmagic extension enabled!
[I 19:05:01.573 NotebookApp] Serving notebooks from local directory: /Users/afranzi/Projects/notebooks
[I 19:05:01.573 NotebookApp] The Jupyter Notebook is running at:
[I 19:05:01.573 NotebookApp] http://localhost:8888/?token=c06252daa6a12cfdd33c1d2e96c8d3b19d90e9f6fc171745
[I 19:05:01.573 NotebookApp] Use Control-C to stop this server and shut down all kernels (twice to skip confirmation).
[C 19:05:01.574 NotebookApp]

    Copy/paste this URL into your browser when you connect for the first time,
    to login with a token:
http://localhost:8888/?token=c06252daa6a12cfdd33c1d2e96c8d3b19d90e9f6fc171745 
Ako bolo uvedené vyššie, MLflow poskytuje funkciu zaznamenávania artefaktov modelu do S3. Akonáhle máme vybraný model, máme možnosť importovať ho ako UDF pomocou modulu mlflow.pyfunc.
import mlflow.pyfunc

model_path = 's3:///mlflow/artifacts/1/0f8691808e914d1087cf097a08730f17/artifacts/model'
wine_path = '/Users/afranzi/Projects/data/winequality-red.csv'
wine_udf = mlflow.pyfunc.spark_udf(spark, model_path)

df = spark.read.format("csv").option("header", "true").option('delimiter', ';').load(wine_path)
columns = [ "fixed acidity", "volatile acidity", "citric acid",
            "residual sugar", "chlorides", "free sulfur dioxide",
            "total sulfur dioxide", "density", "pH",
            "sulphates", "alcohol"
          ]

df.withColumn('prediction', wine_udf(*columns)).show(100, False) 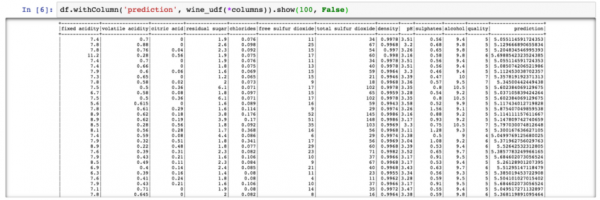
PySpark – Výstup predpovede kvality vína
Doteraz sme hovorili o tom, ako používať PySpark s MLflow, spúšťaním predpovedania kvality vína na celom dátovom súbore vína. Ale čo robiť, ak potrebujeme používať moduly Python MLflow z Scala Spark?
Otestovali sme to a zdielali Spark kontext medzi Scalou a Pythonom. To znamená, že sme zaregistrovali MLflow UDF v Pythone a použili ho zo Scaly (áno, možno to nie je najlepšie riešenie, ale čo máme).
Scala Spark + MLflow
Pre tento príklad pridáme do existujúceho Jupyter.
Inštalujeme Spark + Toree + Jupyter
pip install toree
jupyter toree install --spark_home=${SPARK_HOME} --sys-prefix
jupyter kernelspec list
```
```
Available kernels:
  apache_toree_scala    /Users/afranzi/.virtualenvs/mlflow/share/jupyter/kernels/apache_toree_scala
  python3               /Users/afranzi/.virtualenvs/mlflow/share/jupyter/kernels/python3
```
Ako vidno z priloženého notebooku, UDF sa používa v kombinácii Spark a PySpark. Dúfame, že táto časť bude užitočná tým, ktorí majú radi Scalu a chcú nasadiť modely strojového učenia v produkcii.
import org.apache.spark.sql.functions.col
import org.apache.spark.sql.types.StructType
import org.apache.spark.sql.{Column, DataFrame}
import scala.util.matching.Regex

val FirstAtRe: Regex = "^_".r
val AliasRe: Regex = "[\s_.:@]+".r

def getFieldAlias(field_name: String): String = {
    FirstAtRe.replaceAllIn(AliasRe.replaceAllIn(field_name, "_"), "")
}

def selectFieldsNormalized(columns: List[String])(df: DataFrame): DataFrame = {
    val fieldsToSelect: List[Column] = columns.map(field =>
        col(field).as(getFieldAlias(field))
    )
    df.select(fieldsToSelect: _*)
}

def normalizeSchema(df: DataFrame): DataFrame = {
    val schema = df.columns.toList
    df.transform(selectFieldsNormalized(schema))
}

FirstAtRe = ^_
AliasRe = [s_.:@]+

getFieldAlias: (field_name: String)String
selectFieldsNormalized: (columns: List[String])(df: org.apache.spark.sql.DataFrame)org.apache.spark.sql.DataFrame
normalizeSchema: (df: org.apache.spark.sql.DataFrame)org.apache.spark.sql.DataFrame
Out[1]:
[s_.:@]+
In [2]:
val winePath = "~\/Research\/mlflow-workshop\/examples\/wine_quality\/data\/winequality-red.csv"
val modelPath = "\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model"

winePath = ~\/Research\/mlflow-workshop\/examples\/wine_quality\/data\/winequality-red.csv
modelPath = \/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model
Out[2]:
\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model
In [3]:
val df = spark.read
              .format("csv")
              .option("header", "true")
              .option("delimiter", ";")
              .load(winePath)
              .transform(normalizeSchema)

df = [fixed_acidity: string, volatile_acidity: string ... 10 more fields]
Out[3]:
[fixed_acidity: string, volatile_acidity: string ... 10 more fields]
In [4]:
%%PySpark
import mlflow
from mlflow import pyfunc

model_path = "\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model"
wine_quality_udf = mlflow.pyfunc.spark_udf(spark, model_path)

spark.udf.register("wineQuality", wine_quality_udf)
Out[4]:
<function spark_udf.<locals>.predict at 0x1116a98c8>
In [6]:
df.createOrReplaceTempView("wines")
In [10]:
%%SQL
SELECT
    quality,
    wineQuality(
        fixed_acidity,
        volatile_acidity,
        citric_acid,
        residual_sugar,
        chlorides,
        free_sulfur_dioxide,
        total_sulfur_dioxide,
        density,
        pH,
        sulphates,
        alcohol
    ) AS prediction
FROM wines
LIMIT 10
Out[10]:
+-------+------------------+
|quality|        prediction|
+-------+------------------+
|      5| 5.576883967129615|
|      5|  5.50664776916154|
|      5| 5.525504822954496|
|      6| 5.504311247097457|
|      5| 5.576883967129615|
|      5|5.5556903912725755|
|      5| 5.467882654744997|
|      7| 5.710602976324739|
|      7| 5.657319539336507|
|      5| 5.345098606538708|
+-------+------------------+

In [17]:
spark.catalog.listFunctions.filter('name like "%wineQuality%").show(20, false)

+-----------+--------+-----------+---------+-----------+
|name       |database|description|className|isTemporary|
+-----------+--------+-----------+---------+-----------+
|wineQuality|null    |null       |null     |true       |
+-----------+--------+-----------+---------+-----------+
Nasledujúce kroky
Napriek tomu, že v čase písania článku je MLflow v alfa verzii, vyzerá veľmi sľubne. Iba možnosť spúšťať niekoľko rámcov strojového učenia a využívať ich z jedného koncového bodu posúva odporúčacie systémy na vyššiu úroveň.
Navyše, MLflow približuje dátových inžinierov a odborníkov na dáta, vytvárajúc medzi nimi spoločnú vrstvu.
Po tomto výskume MLflow sme si istí, že pôjdeme ďalej a budeme ho používať pre naše Spark pipeline a v odporúčacích systémoch.
Bolo by dobré synchronizovať úložisko súborov s databázou, namiesto súborového systému. Takto by sme mali získať niekoľko koncových bodov, ktoré môžu používať to isté úložisko súborov. Napríklad použiť niekoľko inštancií a s rovnakým Glue metastore.
Na záver chcem povedať ďakujem komunite MLFlow za to, že robíte našu prácu s dátami zaujímavejšou.
Ak si hráte s MLflow, neváhajte nám napísať a povedať, ako ho používate, najmä ak ho používate v produkcii.
Dozvedieť sa viac o kurzoch:
Čítať ďalej:
Zdroj: habr.com
