

Pred niekoľkými mesiacmi — verejný na PostgreSQL.
Za uplynulé obdobie ste ho už využili viac ako 6000-krát, ale jedna z užitočných funkcií mohla zostať nepovšimnutá — štrukturálne podnety, ktoré vyzerajú približne takto:
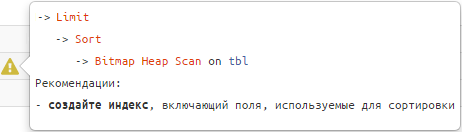
Venujte im pozornosť a vaše dotazy „sa stanú hladké a hodvábne“. 🙂
Ale ak to myslíme vážne, mnohé situácie, ktoré robia dotaz pomalým a „hltnúť“ zdroje, sú typické a môžu byť rozpoznané podľa štruktúry a údajov plánu..
V tomto prípade by sa každý vývojár nemusel snažiť nájsť optimálne riešenie sám, opierajúc sa výlučne o svoje skúsenosti — môžeme mu naznačiť, čo sa deje, aký môže byť dôvod a ako sa dá prísť k riešeniu. Čo sme aj urobili.
Pozrime sa podrobnejšie na tieto prípady — ako sú definované a k akým odporúčaniam vedú.
Pre lepšie pochopenie témy si najprv môžete vypočuť príslušný blok z , a potom prejsť k podrobnej analýze každého príkladu:
#1: индексная «недосортировка»
Keď nastane
Zobraziť poslednú faktúru pre klienta „OOO Kolokolčik“.
Ako rozpoznať
-> Limit
   -> Sort
      -> Index [Only] Scan [Backward] | Bitmap Heap Scan
Odporúčania
Používaný index rozšíriť o polia na triedenie.
Príklad:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "faktov"
, (random() * 1000)::integer fk_cli; -- 1K rôznych externých kľúčov

CREATE INDEX ON tbl(fk_cli); -- index pre foreign key

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 1 -- výber podľa konkrétneho vzťahu
ORDER BY
  pk DESC -- chceme len jednu "poslednú" zaznamenanie
LIMIT 1; 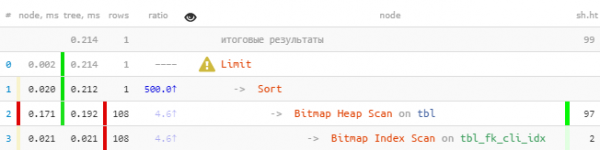
Ihneď si môžete všimnúť, že podľa indexu bolo načítaných viac ako 100 záznamov, ktoré sa potom všetky triedili, a nakoniec bol ponechaný len jeden.
Oprava:
DROP INDEX tbl_fk_cli_idx;
CREATE INDEX ON tbl(fk_cli, pk DESC); -- pridali sme kľúč triedenia
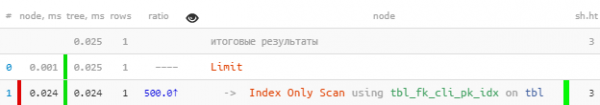
Aj na takej primitívnej analýze — 8,5-krát rýchlejšie a 33-krát menej čítaní. Efekt bude tým zrejmejší, čím viac máte „faktov“ pre každú hodnotu fk.
Povšimnem si, že takýto index bude fungovať ako „predreťazcovaný“ rovnako dobre pre iné dotazy s fk, kde triedenia podľa pk nebolo a nie je (viac sa o tom môžete dočítať ). Vrátane toho, zabezpečí aj normálnu podporu explicitného foreign key pre toto pole.
#2: пересечение индексов (BitmapAnd)
Keď nastane
Zobraziť všetky zmluvy klienta „OOO Kolokolčik“, uzavreté v mene „NAO Lyutik“.
Ako rozpoznať
-> BitmapAnd
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Odporúčania
Vytvoriť zložený index podľa polí z oboch zdrojových alebo rozšíriť jeden z existujúcich políami z druhého.
Príklad:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "faktov"
, (random() *  100)::integer fk_org  -- 100 rôznych externých kľúčov
, (random() * 1000)::integer fk_cli; -- 1K rôznych externých kľúčov

CREATE INDEX ON tbl(fk_org); -- index pre foreign key
CREATE INDEX ON tbl(fk_cli); -- index pre foreign key

SELECT
  *
FROM
  tbl
WHERE
(fk_org, fk_cli) = (1, 999); -- výber podľa konkrétneho páru 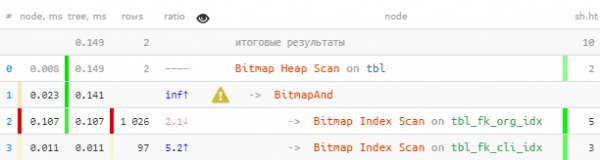
Oprava:
DROP INDEX tbl_fk_org_idx;
CREATE INDEX ON tbl(fk_org, fk_cli);
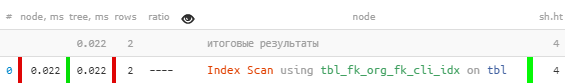
Tu je zisk menší, pretože Bitmap Heap Scan je dostatočne účinný sám o sebe. Ale predsa 7-krát rýchlejšie a 2.5-krát menej čítaní.
#3: объединение индексов (BitmapOr)
Keď nastane
Zobraziť prvých 20 najstarších „svojich“ alebo nenaznačených žiadostí na spracovanie, pričom svoje majú prednosť.
Ako rozpoznať
-> BitmapOr
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Odporúčania
Použiť UNION [ALL] pre zlúčenie poddotazov pre každý z OR-blokov podmienok.
Príklad:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "faktov"
, CASE
    WHEN random() < 1::real/16 THEN NULL -- s pravdepodobnosťou 1:16 záznam "remíza"
    ELSE (random() * 100)::integer -- 100 rôznych externých kľúčov
  END fk_own;

CREATE INDEX ON tbl(fk_own, pk); -- index s "takmer vhodným" triedením

SELECT
  *
FROM
  tbl
WHERE
  fk_own = 1 OR -- svoj
  fk_own IS NULL -- ... alebo "remízy"
ORDER BY
  pk
, (fk_own = 1) DESC -- najprv "svoje"
LIMIT 20;
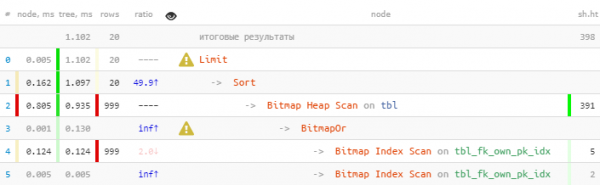
Oprava:
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own = 1 -- najprv "svoje" 20
  ORDER BY
    pk
  LIMIT 20
)
UNION ALL
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own IS NULL -- potom "remízy" 20
  ORDER BY
    pk
  LIMIT 20
)
LIMIT 20; -- ale celkom - 20, viac netreba 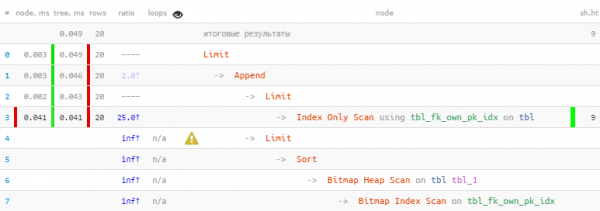
Využili sme to, že všetkých 20 potrebných záznamov bolo získaných už v prvom bloku, preto druhý, s nákladnejším Bitmap Heap Scan, sa ani nevykonával - nakoniec 22-krát rýchlejšie, 44-krát menej čítaní!
Podrobnejšie rozprávanie o tejto optimalizácii na konkrétnych príkladoch si môžete prečítať v článkoch a .
Generický variant usporiadaného výberu podľa niekoľkých kľúčov (a nielen podľa páru const/NULL) je predložené v článku .
#4: читаем много лишнего
Keď nastane
Spravidla sa vyskytuje pri snahe „pridať ešte jeden filter“ k už existujúcemu dotazu.
„A nemáte niečo podobné, ale s perleťovými gombíkmi?» film "Briliantová ruka"
Napríklad, modifikovaním úlohy vyššie, zobraziť prvých 20 najstarších „kritických“ žiadostí na spracovanie, bez ohľadu na ich určenie.
Ako rozpoznať
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && 5 × rows 80% prečítaného
   && cykly × RRbF > 100 -- a zároveň viac ako 100 záznamov celkovo
Odporúčania
Vytvoriť [viac] špecializovaný index s WHERE podmienkou alebo zahrnúť do indexu ďalšie polia.
Ak je podmienka filtrovania «stá Tnu» pre vaše úlohy — teda nepredpokladá rozšírenie zoznamu hodnôt v budúcnosti — je lepšie použiť WHERE index. Do tejto kategórie dobre zapadajú rôzne boolean/enum-statusy.
Ak sa však podmienka filtrovania môže prijímať rôzne hodnoty, je lepšie rozšíriť index o tieto polia — ako v prípade BitmapAnd vyššie.
Príklad:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk -- 100K "faktov"
, CASE
    WHEN random() < 1::real/16 THEN NULL
    ELSE (random() * 100)::integer -- 100 rôznych externých kľúčov
  END fk_own
, (random() < 1::real/50) critical; -- 1:50, že žiadosť "kritická"

CREATE INDEX ON tbl(pk);
CREATE INDEX ON tbl(fk_own, pk);

SELECT
  *
FROM
  tbl
WHERE
  critical
ORDER BY
  pk
LIMIT 20; 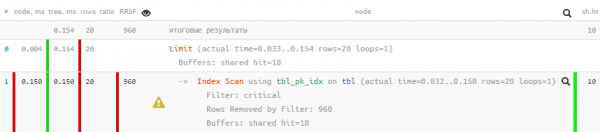
Oprava:
CREATE INDEX ON tbl(pk)
  WHERE critical; -- pridali sme "stá Tnu" podmienku filtrovania
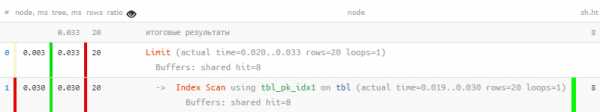
Ako vidíme, filtrovanie z plánu úplne zmizlo, a dopyt sa stal 5-krát rýchlejším.
#5: разреженная таблица
Keď nastane
Rôzne pokusy vytvoriť vlastný front na spracovanie úloh, keď veľké množstvo aktualizácií/odstránení záznamov v tabuľke vedie k situácii s množstvom «mŕtvych» záznamov.
Ako rozpoznať
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && cykly × (rows + RRbF)  64
Odporúčania
Pravidelne manuálne vykonávať VACUUM [FULL] alebo dosiahnuť primeranú frekvenciu spracovania pomocou jemného nastavenia jeho parametrov, vrátane .
Vo väčšine prípadov sú podobné problémy spôsobené zlým zostavením dopytov pri výzvach z obchodnej logiky, ako boli posúdené v .
Ale je potrebné chápať, že aj VACUUM FULL nemusí vždy pomôcť. Pre takéto prípady stojí za to oboznámiť sa s algoritmom z článku .
#6: чтение с «середины» индекса
Keď nastane
Vyzerá to, že sme prečítali trochu, a všetko podľa indexu, a nikoho zbytočného nefiltrovali — a predsa bolo prečítané podstatne viac strán, než by sme chceli.
Ako rozpoznať
-> Index [Only] Scan [Backward]
   && cykly × (rows + RRbF)  64
Odporúčania
Dôkladne sa pozrieť na štruktúru použitého indexu a kľúčové polia určené v dotaze — pravdepodobne, časť indexu nie je určená. Pravdepodobne budete musieť vytvoriť podobný index, ale bez prefixových polí alebo .
Príklad:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "faktov"
, (random() *  100)::integer fk_org  -- 100 rôznych vonkajších kľúčov
, (random() * 1000)::integer fk_cli; -- 1K rôznych vonkajších kľúčov

CREATE INDEX ON tbl(fk_org, fk_cli); -- všetko takmer ako v #2
-- len tento samostatný index pre fk_cli sme už považovali za zbytočný a odstránili sme ho

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 999 -- a fk_org nie je určené, hoci je skôr v indexe
LIMIT 20; 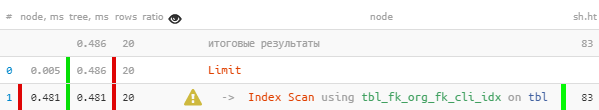
Na prvý pohľad to vyzerá dobre, dokonca aj podľa indexu, ale je to podozrivé — na každú z 20 prečítaných záznamov sa muselo načítať 4 stránky dát, 32KB na záznam — nie je to priveľa? A meno indexu tbl_fk_org_fk_cli_idx navádza na zamyslenie.
Oprava:
CREATE INDEX ON tbl(fk_cli); 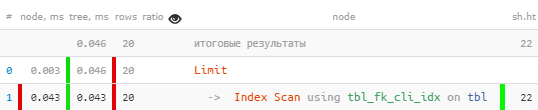
Zrazu — 10-krát rýchlejšie a 4-krát menej na čítanie!
Iné príklady neefektívneho využitia indexov môžete vidieť v článku .
#7: CTE × CTE
Keď nastane
V dotaze sme zapísali „tučné“ CTE z rôznych tabuliek a potom sme sa rozhodli urobiť medzi nimi JOIN.
Tento prípad je relevantný pre verzie pod v12 alebo dotazy s WITH MATERIALIZED.
Ako rozpoznať
-> CTE Scan
   && slučky > 10
   && slučky × (riadky + RRbF) > 10000
      -- príliš veľký karteziánsky súčin CTE
Odporúčania
Dôkladne analyzovať dotaz — a ? Если все-таки да, то aplikovať „slovníkovanie“ v hstore/json podľa modelu opísaného v .
#8: swap на диск (temp written)
Keď nastane
Jednorázové spracovanie (triedenie alebo unikalizácia) veľkého množstva záznamov sa nezmestí do vyhradené pamäte na to.
Ako rozpoznať
-> *
   && temp written > 0
Odporúčania
Ak použitá operačná pamäť mierne presahuje stanovenú hodnotu parametra , je možné ju upraviť. Môžete to urobiť naraz v konfiguračnom súbore pre všetkých, alebo cez SET [LOCAL] pre konkrétny dotaz/ transakciu.
Príklad:
SHOW work_mem;
-- "16MB"

SELECT
  random()
FROM
  generate_series(1, 1000000)
ORDER BY
1; 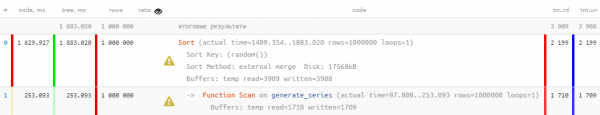
Oprava:
SET work_mem = '128MB'; -- pred vykonaním dotazu 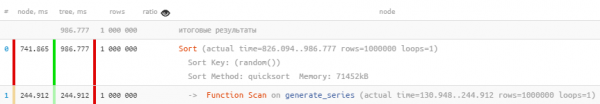
Z pochopiteľných dôvodov, ak sa používa iba pamäť a nie disk, tak sa dotaz vykonáva oveľa rýchlejšie. Taktiež sa znižuje časť záťaže z HDD.
Ale treba si uvedomiť, že prideliť veľa pamäte vždy tiež nie je možné — jednoducho to nebude stačiť pre všetkých.
#9: неактуальная статистика
Keď nastane
Do databázy sme nahrali veľa hneď, ale nestihli sme prebehnúť ANALYZE.
Ako rozpoznať
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && pomer >> 10
Odporúčania
Nakoniec vyhodnotiť ANALYZE.
Podrobnejšie o tejto situácii je uvedené v .
#10: «что-то пошло не так»
Keď nastane
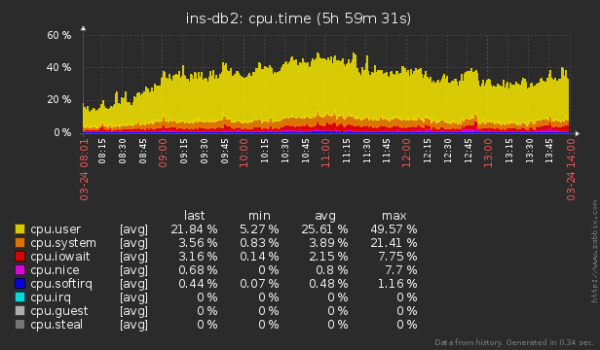
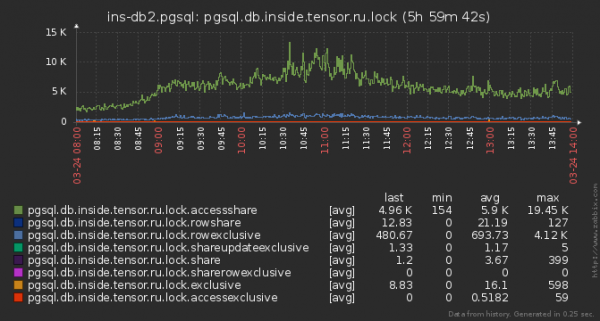
Došlo k čakaniu na uzamknutie, ktoré uložil konkurujúci dotaz, alebo nebolo dostatok hardvérových zdrojov CPU/hypervízora.
Ako rozpoznať
-> *
   && (shared hit / 8K) + (shared read / 1K) < time / 1000
      -- RAM hit = 64MB/s, HDD read = 8MB/s
   && time > 100ms -- čítali sme málo, ale príliš dlho
Odporúčania
Použite externý systém na monitorovanie serverov na prítomnosť uzamknutí alebo neštandardnej spotreby zdrojov. O našej organizácii tohto procesu pre stovky serverov sme už hovorili a .
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish