

Dnes vám poviem príbeh. Príbeh evolúcie výpočtovej techniky a vzniku vzdialených pracovísk od dávnych čias až po súčasnosť.
Rozvoj IT
Hlavný odkaz z histórie IT je...
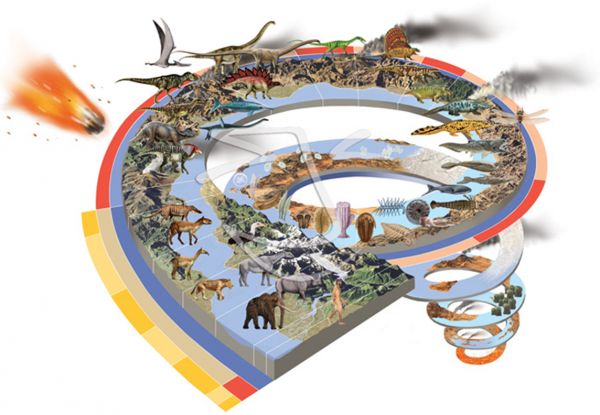
Samozrejme, že IT sa vyvíja špirálovito. Tieto isté riešenia a koncepty, ktoré boli pred desiatkami rokov zamietnuté, získavajú nový zmysel a úspešne fungujú za nových podmienok, pri nových úlohách a na nových kapacitách. V tomto sa IT nijako nelíši od iných oblastí ľudskej znalosti a histórie Zeme ako celku.
Kedysi dávno, keď boli počítače veľké
„Myslím, že na svete existuje trh približne pre päť počítačov“, povedal šéf IBM Thomas Watson v roku 1943.
Raná počítačová technika bola obrovská. Nie, nesprávne, raná technika bola obrovská, cyklopská. Celý výpočtový stroj zaberá plochu porovnateľnú so športovou halou a stál úplne nerealistické peniaze. Ako príklad súčiastok môžeme uviesť modul operačnej pamäte na feritových prstencoch (1964).
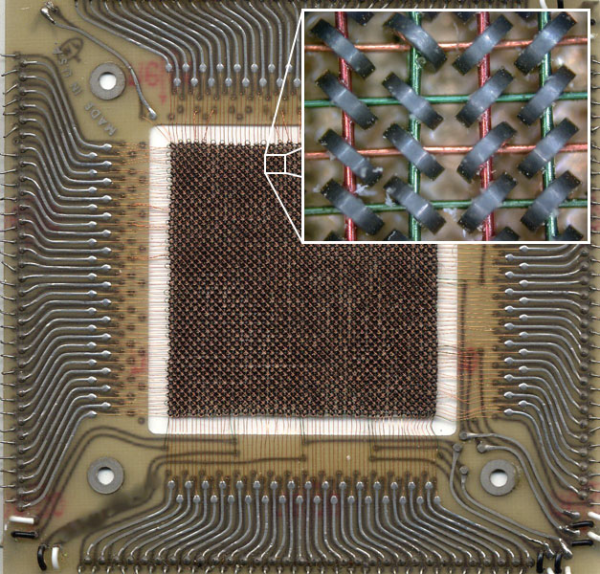
Tento modul má rozmer 11 cm * 11 cm a kapacitu 512 bajtov (4096 bitov). Skriňa, úplne zaplnená týmito modulmi, sotva mala kapacitu dnešnej už starodávnej disketovej jednotky 3,5” (1.44 MB = 2950 modulov), pričom spotrebovala výrazné množstvo elektrickej energie a zahrievala sa ako parný stroj.
Práve s obrovskými rozmermi súvisí aj anglický názov ladeniu programového kódu — “debugging”. Jedna z prvých programátoriek v histórii, Grace Hopper (áno, áno, žena), dôstojníčka námorných síl, urobila v roku 1945 zápis do denníka svojich činností po vyšetrovaní poruchy v programe.
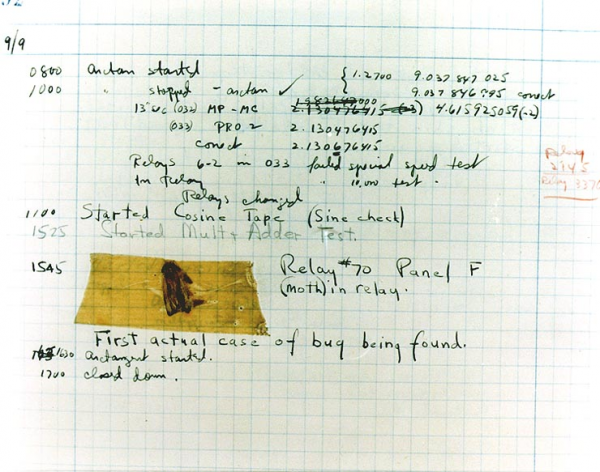
Keďže moth (moth) je v bežnom prípade bug (chyba), všetky ďalšie problémy a opatrenia na ich riešenie personál hlásil nadriadeným ako “debugging” (doslovne odstraňovanie chýb), tak sa názov pre závady programov a chyby v kóde napevno usadil ako bug, a ladenie sa stalo debagovaním.
S rozvojom elektroniky a najmä polovodičovej elektroniky sa fyzické rozmery strojov začali zmenšovať, zatiaľ čo výpočtový výkon naopak rástol. Ale aj v tomto prípade nebolo možné dať každému osobný počítač.
„Nie je dôvod, prečo by niekto chcel mať počítač doma“ — Ken Olsen, zakladateľ DEC, 1977.
V 70. rokoch sa objavuje termín mini-počítač. Pamätám si, že keď som prvýkrát prečítal tento termín pred mnohými rokmi, predstavil som si niečo ako netbook, takmer vreckový počítač. Nemohol som byť ďalej od pravdy.
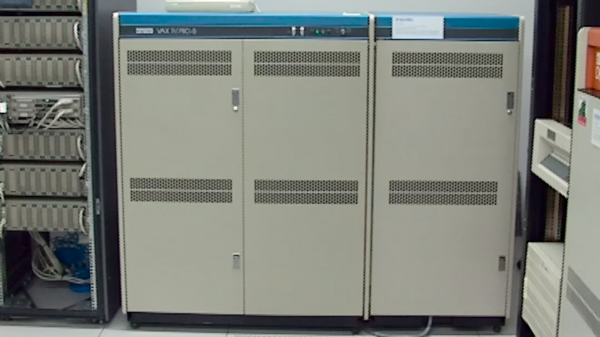
Mini — je len v porovnaní s obrovskými strojovými halami, ale stále ide o niekoľko skríň so zariadením v hodnote stoviek tisíc a miliónov dolárov. Avšak výpočtová kapacita už vzrástla natoľko, že nebola vždy vyťažená na 100 %, a pritom sa počítače začali stávať dostupnými študentom a učiteľom univerzít.
A vtedy prišiel ON!
Mnohí sa nezamýšľajú nad latinskými koreňmi v anglickom jazyku, ale práve on nám priniesol vzdialený prístup, aký poznáme dnes. Terminus (lat.) — koniec, hranica, cieľ. Cieľom Terminátora T800 bolo ukončiť život Johna Connora. Takisto vieme, že dopravné stanice, na ktorých sa vykonáva nastupovanie a vystupovanie cestujúcich alebo nakládka a vykládka tovaru, sa nazývajú terminály — konečné ciele trás.
Podľa toho sa objavila koncepcia terminálového prístupu a môžete vidieť najznámejší terminál na svete, ktorý žije aj v našich srdciach.
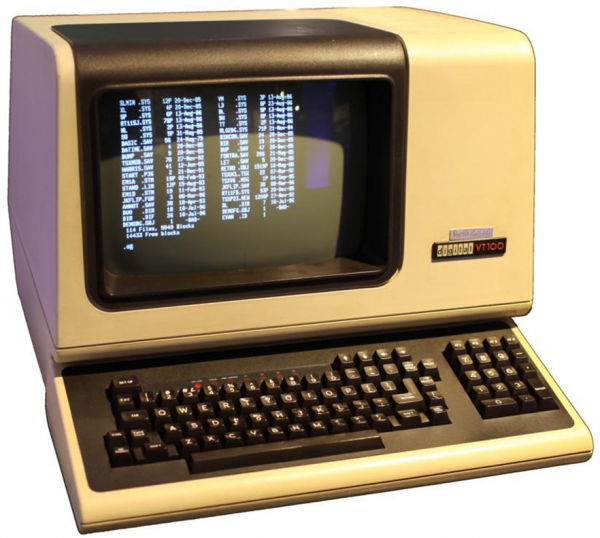
DEC VT100 sa nazýva terminál, pretože ukončuje informačnú linku. Má vlastne nulovú výpočtovú kapacitu a jeho jedinou úlohou je zobraziť informácie prijaté z veľkého stroja a prenášať na stroj vstup z klávesnice. A hoci VT100 fyzicky dávno zomreli, stále ich plne využívame.
Naše dni
„Naše dni“ by som začal od začiatku 80. rokov, od momentu objavenia prvých dostupných širokej verejnosti procesorov so značnou výpočtovou kapacitou. Tradične sa považuje, že hlavným procesorom tejto éry sa stal Intel 8088 (rodina x86) ako zakladateľ víťaznej architektúry. Aký je teda zásadný rozdiel s koncepciou 70. rokov?
Prvýkrát sa objavuje tendencia presunúť spracovanie informácií z centra na perifériu. Rôzne úlohy nevyžadujú šialené (v porovnaní s slabým x86) výkony mainframe alebo aj mini počítača. Intel nezaháľa, v 90. rokoch uvádza rodinu Pentium, ktorá sa stáva skutočne prvým masovým domácim počítačom v Rusku. Tieto procesory sú už schopné veľa, nielen napísať list — ale aj multimédiá a pracovať s malými databázami. V skutočnosti pre malé podniky, kompletná potreba serverov prakticky odpadá — všetko sa dá vykonávať na periférii, na klientských strojoch. S každým rokom sú procesory mocnejšie a rozdiel medzi servermi a osobnými počítačmi je čoraz menší z hľadiska výpočtovej sily, často zostáva len v rezervovaní napájania, podpore horúcej výmeny a špeciálnych skříňach na montáž do stojanov.
Ak porovnáme súčasné klientské procesory s "vtipnými" ťažkými servermi z 90. rokov od spoločnosti Intel a superpočítačmi z minulosti, tak by sme sa cítili trochu nepohodlne.
Poďme sa pozrieť na starého pána, ktorý je takmer mojím rovesníkom. Cray X-MP/24 z roku 1984.
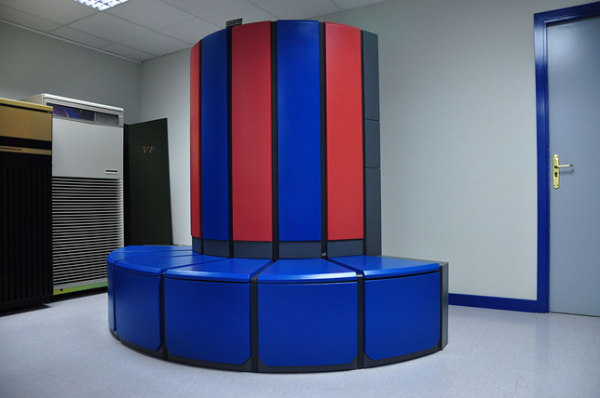
Tento stroj sa nachádzal v top superpočítačoch roku 1984, mal 2 procesory s 105 MHz s maximálnym výpočtovým výkonom 400 MFlops (miliónov operácií s plávajúcou desatinnou čiarkou). Konkrétne ten stroj, ktorý je zobrazený na fotografii, stál v laboratóriu kryptografie NSA USA a zaoberal sa lámaním kódov. Ak prevedieme 15 miliónov dolárov z roku 1984 na doláre roku 2020, tak cena predstavuje 37,4 milióna, alebo 93 500 dolárov / MFlops.
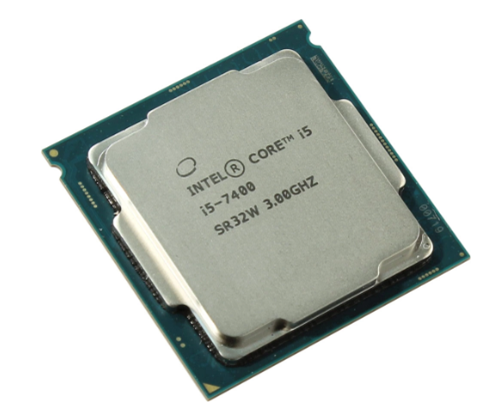
V stroji, na ktorom píšem tieto riadky, je procesor Core i5-7400 z roku 2017, ktorý nie je už nový, a aj v roku svojho vydania bol najslabším 4-jadrovým zo všetkých desktopových procesorov strednej úrovne. 4 jadra s základnou frekvenciou 3.0 GHz (3.5 s Turbo Boost) a zdvojenie vlákien HyperThreading poskytujú od 19 do 47 GFlops výkonu pri rôznych testoch pri cene 16 tisíc rubľov za procesor. Ak by sme poskladali stroj úplne, jeho cena by mohla byť prijatá ako 750 dolárov (podľa cien a kurzu k 1. marcu 2020).
Nakoniec dosahujeme prevahu celkom priemerného desktopového procesora dneška o 50-120 krát nad superpočítačom z top10 dosiahnuteľnej minulosti, pričom pokles jednotkových nákladov na MFlops sa stáva celkom ohromujúcim 93500 / 25 = 3700 krát.
Prečo sú nám ešte stále potrebné servery a centralizácia výpočtov pri takýchto výkonoch na periférii — to je skutočne nejasné!
Spätný skok — špirála urobila obrat
Bezdiskové stanice
Prvým signálom, že presun výpočtov na perifériu nebude konečný, bolo zavedenie technológie bezdiskových pracovných staníc. Pri veľkom rozložení pracovných staníc na území podniku, a najmä v znečistených miestnostiach, sa veľmi ostro vynára otázka správy a podpory týchto staníc.
Objavuje sa pojem "korridorový čas" — ten percentuálny čas, kedy je zamestnanec technickej podpory v chodbe, na ceste k zamestnancovi s problémom. Tento čas je platený, ale úplne neproduktivný. Nie malú úlohu, najmä v znečistených priestoroch, zohrávali výpadky pevných diskov. Poďme z pracovnej stanice odstrániť disk, a všetko ostatné vybavíme cez sieť, vrátane spustenia. Sieťový adaptér dostáva okrem adresy od DHCP servera aj dodatočné informácie — adresu TFTP servera (zjednodušený súborový servis) a názov spúšťacieho obrazu, ktorý načíta do operačnej pamäte a štartuje stroj.
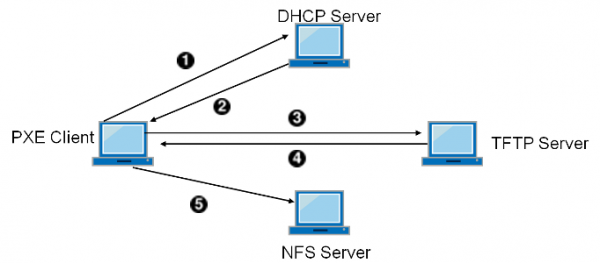
Okrem menšieho počtu porúch a zníženia korridorového času, teraz nie je potrebné dolaďovať stroj na mieste, ale jednoducho priniesť nový a vziať starý na diagnostiku na vybavené pracovné miesto. Ale to nie je všetko!
Bezdisková stanica sa stáva oveľa bezpečnejšou — ak by náhodou niekto vnikol do miestnosti a odniesol všetky počítače, to sú len straty zariadenia. Žiadne dáta sa neuchovávajú na bezdiskových staniciach.
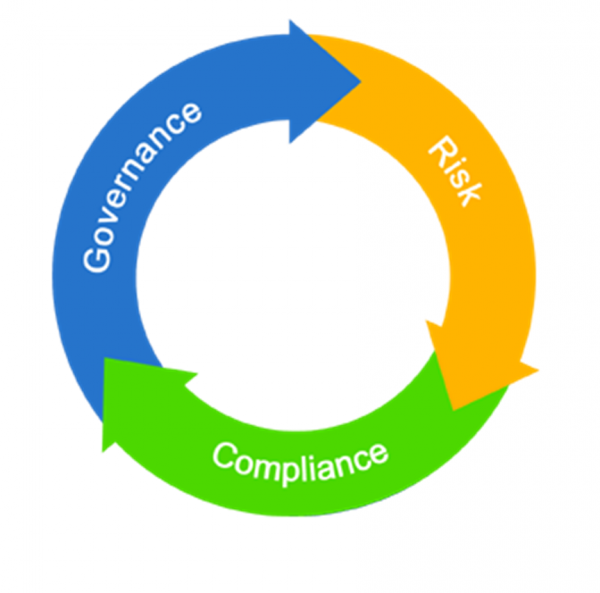
Zapamätajme si tento okamih, informačná bezpečnosť hrá čoraz väčšiu úlohu po "bezstarostnom detstve" informačných technológií. A v IT sa čoraz viac vmiešavajú desivé a dôležité 3 písmená — GRC (Governance, Risk, Compliance), alebo po slovensky "Riadenosť, Riziko, Zhoda".
Terminálne servery
Masívne rozšírenie čoraz výkonejších osobných počítačov na perifériách predbehlo vývoj verejných sietí. Klasické aplikácie typu klient-server z 90. rokov a začiatku 00. rokov nefungovali veľmi dobre cez tenký kanál, ak výmena údajov dosiahla akékoľvek významné hodnoty. Toto bolo obzvlášť ťažké pre vzdialené kancelárie, ktoré sa pripájali cez modem a telefónnu linku, ktorá navyše občas zamŕzala alebo sa prerušovala. A...
Špirála sa otočila a opäť sme sa dostali do terminálového režimu s konceptom terminálových serverov.
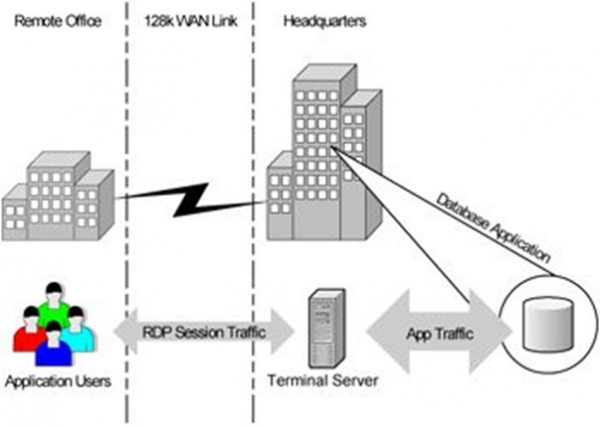
V skutočnosti sme sa vrátili do 70. rokov s ich nulovými klientmi a centralizáciou výpočtovej moci. Veľmi rýchlo sa stalo jasným, že okrem čisto ekonomickej stránky s intervalmi terminálny prístup poskytuje obrovské možnosti organizácie bezpečného vonkajšieho prístupu, vrátane možnosti práce z domu pre zamestnancov, alebo veľmi obmedzeného a kontrolovaného prístupu kontraktorom z nedôveryhodných sietí a nedôveryhodných/neovládateľných zariadení.
Avšak terminálové servery, aj so všetkými svojimi výhodami a progresívnosťou, mali aj množstvo nevýhod — nízka flexibilita, problém s hlučným susedom, striktné serverové Windows atď.
Zrodenie pr Proto VDI
Pravda je, že na začiatku a v polovici 00. rokov už na scénu vstupoval priemyselný virtualizačný x86. A niekto jednoducho vyslovil myšlienku, ktorá visela vo vzduchu: čo keby sme namiesto centralizácie všetkých klientov na serverových terminálových farmách dali každému jeho osobnú virtuálnu mašinu s klientským Windows a dokonca administrátorským prístupom?
Zrieknutie sa „hrubých“ klientov
Popri virtualizácii relácií a operačných systémov sa vyvíjal aj prístup, ktorý sa zameriaval na zjednodušenie funkcie klienta na úrovni aplikácie.
Logika za tým bola dosť jednoduchá, pretože osobné notebooky neboli ešte u všetkých, internet tiež nebol dostupný pre každého a mnohí sa mohli pripojiť len z internetových kaviarní s veľmi obmedzenými, jemne povedané, právami. V skutočnosti bolo všetko, čo sa dalo spustiť — prehliadač. Prehliadač sa stal neodmysliteľným atribútom operačného systému, internet pevne vstupoval do nášho života.
Inými slovami, paralelne prebiehal trend presunu logiky z klienta do centra vo forme webových aplikácií, na prístup k ktorým bol potrebný iba ten najjednoduchší klient, internet a prehliadač.
A my sme sa ocitli nie len tam, kde sme začínali — s nulovými klientmi a centrálnymi servermi. Dostali sme sa tam niekoľkými nezávislými cestami.
Virtual Desktop Infrastructure
Broker
V roku 2007, líder trhu priemyselnej virtualizácie, VMware, vydal svoju prvú verziu produktu VDM (Virtual Desktop Manager), ktorý sa stal de facto prvým v práve sa formujúcom trhu virtuálnych desktopov. Samozrejme, na odpoveď od lídra terminálnych serverov Citrix sme nemuseli dlho čakať a v roku 2008, s akvizíciou XenSource, sa objavuje XenDesktop. Bezpochyby existovali aj iní výrobcovia so svojimi ponukami, ale nebudeme sa príliš hlboko zaoberať históriou a odbočovať od konceptu.
A stále sa tento koncept zachováva. Kľúčovou súčasťou VDI je broker pripojení.
Presne to je srdce infraštruktúry virtuálnych desktopov.
Broker zodpovedá za najdôležitejšie procesy fungovania VDI:
- Určuje dostupné zdroje pre pripojeného klienta (stroje/sesie);
- Vyvažuje podľa potreby klientov v skupinách strojov/sesí;
- Nastavuje klienta na vybraný zdroj.
Dnes môže byť klientom (terminálom) pre VDI prakticky čokoľvek, čo má obrazovku — notebook, smartfón, tablet, kiosk, tenký alebo nulový klient. A odpovedajúcou časťou, tou, ktorá vykonáva produktívnu záťaž — je relácia terminálneho servera, fyzický stroj, virtuálny stroj. Moderné zrelé produkty VDI sú úzko integrované s virtuálnou infraštruktúrou a samostatne ju spravujú v automatickom režime, nasadzujúce alebo naopak odstraňujúce už nepotrebné virtuálne stroje.
Trochu bokom, ale pre niektorých klientov mimoriadne dôležitou technológiou VDI, je podpora hardvérovej akcelerácie 3D grafiky pre prácu projektantov alebo dizajnérov.
Protokol
Druhou mimoriadne dôležitou súčasťou zrelého riešenia VDI je protokol prístupu k virtuálnym zdrojom. Ak ide o prácu v rámci firemnej lokálnej siete s vynikajúcou spoľahlivou sieťou 1 Gbps a oneskorením 1 ms, môžete brať prakticky akýkoľvek a vôbec nad tým nerozmýšľať.
Pri pripojení na neregulovanú sieť je potrebné uvažovať, keďže kvalita tejto siete môže byť úplne rôzna, od rýchlostí desiatok kilobitov až po nepravidelné oneskorenia. Pre organizovanie skutočnej práce na diaľku, z víkendových domov, z domova, z letísk a reštaurácií, sú preto kľúčové.
Termínové servery vs klientské VM
Keď sa objavilo VDI, zdalo sa, že s terminálnymi servermi je koniec. Aký je ich dôvod, ak má každý svoju osobnú VM?
Avšak z pohľadu čistej ekonomiky sa ukázalo, že pre typické masové pracovné miesta, ktoré sú si navzájom podobné, zatiaľ nie je nič efektívnejšie ako terminálne servery z hľadiska ceny / relácie. Napriek svojim výhodám prístup „1 používateľ = 1 VM“ spotrebováva podstatne viac zdrojov na virtuálny hardvér a plnohodnotný OS, čo zhoršuje ekonomiku na typických pracovných miestach.
V prípade pracovných miest top manažérov, atypických a zaťažených pracovných miest, kde je potrebné mať vysoké práva (až po administrátora), má výhodu vyhradená VM na používateľa. V rámci tejto VM je možné individuálne prideľovať zdroje, poskytovať práva akékoľvek úrovne a vyvažovať VM medzi hostiteľmi virtualizácie pri vysokých záťažiach.
VDI a ekonomika
Roky počúvam tú istú otázku - prečo nie je VDI lacnejšie ako rozdávať všetkým notebooky? A roky odpovedám na tú istú otázku: v prípade bežných kancelárskych zamestnancov nie je VDI lacnejšie, ak berieme do úvahy čisto náklady na vybavenie. Notebooky, to sa nedá ignorovať, zlacňujú, ale servery, úložné systémy a systémový softvér stoja dosť značné peniaze. Ak nastal čas na modernizáciu vášho vybavenia a snažíte sa ušetriť cez VDI - nie, neušetríte.
Už som spomínal strašidelné tri písmená GRC - VDI je o GRC. Ide o riadenie rizík, o bezpečnosť a pohodlie kontrolovaného prístupu k údajom. A to všetko zvyčajne vyžaduje značné investície na zavedenie do rôznorodého hardvéru. S pomocou VDI sa kontrola zjednodušuje, bezpečnosť sa zvyšuje a vlasy sú mäkké a hodvábne.
Riešenia HPE pre prácu na diaľku
Diaľkové a cloudové riadenie
iLO
Spoločnosť HPE nie je žiadnym nováčikom v oblasti vzdialeného riadenia serverovej infraštruktúry. V marci oslávila legendárna technológia iLO (Integrated Lights Out) už 18 rokov. Keď si spomínam na svoje administrátorské časy v 00. rokoch, nemohol som sa otáčať za iným. Primárna montáž do rackov a pripojenie káblov — to bolo všetko, čo bolo potrebné spraviť v hlučnom a chladnom dátovom centre. Všetok ostatný čas konfigurácia, vrátane inštalácie operačného systému, sa mohla robiť z pracovného miesta so zameraním na dva monitory a šálku horúcej kávy. A to bolo pred 13 rokmi!
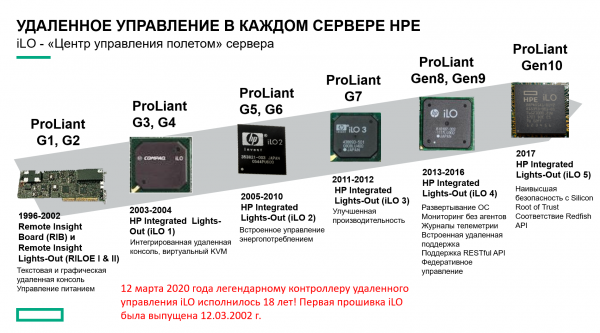
Dnes sú servery HPE oprávnene nepopierateľným mnohoročným štandardom kvality — a nepochybne dôležitú rolu v tom zohráva zlatý štandard systému vzdialeného riadenia — iLO.
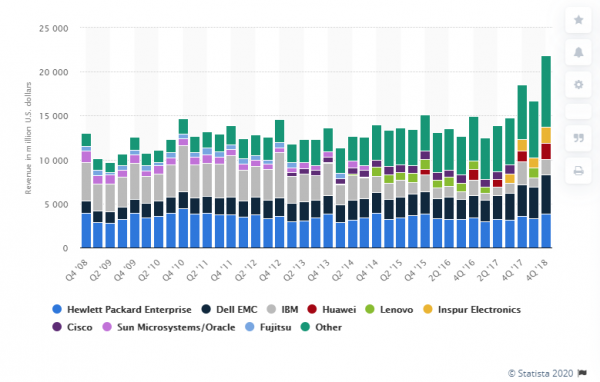
Chcem osobitne vyzdvihnúť akcie HPE v zachovaní kontroly ľudstva nad koronavírusom. , že do konca roku 2020 (minimálne) bude licencia iLO Advanced dostupná všetkým zdarma.
Infosight
Ak máte viac ako 10 serverov v infraštruktúre a administrátor sa nenudí, určite bude skvelým doplnkom k štandardným monitorovacím nástrojom cloudový systém HPE Infosight založený na umelej inteligencii. Systém nielenže monitoruje stav a vytvára grafy, ale aj samočinne odporúča ďalšie kroky na základe aktuálnej situácie a trendov.
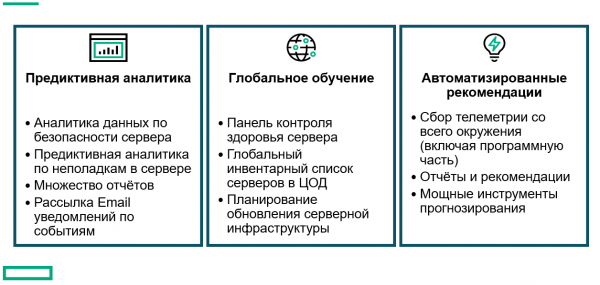
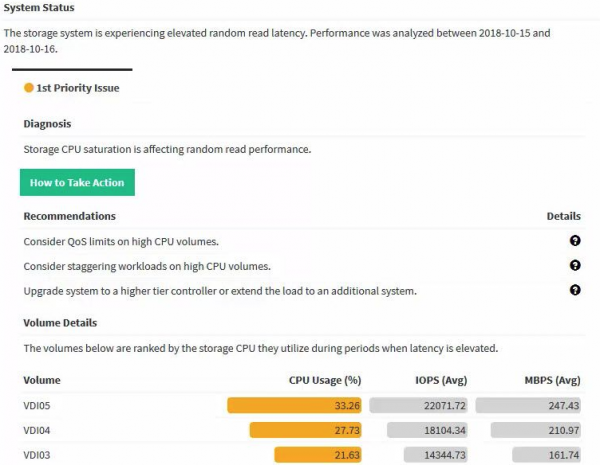
Buď inteligentný, , vyskúšaj Infosight!
OneView
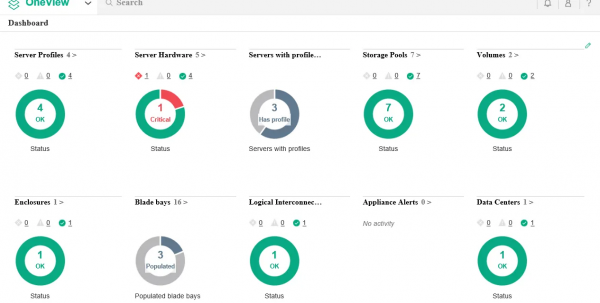
Nakoniec, ale nie menej dôležite, chcem vyzdvihnúť HPE OneView — celý produktový portfóliou s obrovskými možnosťami monitorovania a riadenia celej infraštruktúry. A to všetko bez toho, aby ste sa museli zdvihnúť od pracovného stola, ktorý môžete mať aj na chate v súčasnosti.
Úložné systémy tiež nie sú na zahodenie!
Samozrejme, všetky úložné systémy sú vzdialene riadené a monitorované — tak to bolo už pred mnohými rokmi. Preto sa dnes chcem porozprávať o niečom inom, konkrétne o metro-klastroch.
Metro-klastre nie sú úplnou novinkou na trhu, ale práve preto, že sa tak dlho nepopulárne — prejavuje sa to inertnosťou myslenia a prvotnými dojmami. Samozrejme, pred 10 rokmi už existovali, ale stáli ako liatinový most. Roky, ktoré prešli od prvých metro-klastrov, zmenili priemysel a dostupnosť technológie pre širokú verejnosť.
Pamätám si projekty, kde sme špeciálne rozdelili časti úložiska — zvlášť pre mimoriadne kritické služby do metroklastrov, zvlášť na synchronnú replikáciu (oveľa lacnejšie).
Fakticky, v roku 2020 vás metroklauster nestojí nič, ak dokážete zorganizovať dve lokality a kanály. A kanály pre synchronnú replikáciu sú presne tie isté, aké sú potrebné pre metroklastre. Licencovanie softvéru už dávno prebieha v balíčkoch — a synchronná replikácia ide hneď spolu s metroklaustrom, a jediné, čo zatiaľ zachováva život jednosmernej replikácie — je potreba organizovať rozšírenú L2 sieť. A to, L2 over L3 sa už rozmohlo po krajine.
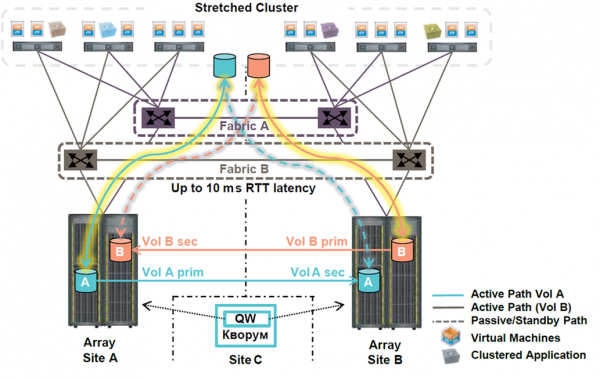
Aký je teda principiálny rozdiel medzi synchronnou replikáciou a metroklaustrom z pohľadu vzdialenej práce?
Všetko je veľmi jednoduché. Metroklauster pracuje sám, automaticky, neustále, prakticky okamžite.
Ako vyzerá proces prehazovania záťaže na synchronnej replikácii na infraštruktúre aspoň so stovkami VM?
- Prichádza signál o havárii.
- Zmenšujúca sa zmena analyzuje situáciu — môžeme smelo počítať od 10 do 30 minút len na prijatie signálu a prijatie rozhodnutia.
- V prípade nedostatku oprávnení u pohotovostných inžinierov na samostatný štart prehodenia — ešte ďalších 30 minút na kontaktovanie osoby, ktorá má oprávnenia, a formálne potvrdenie začiatku prehodenia.
- Stlačenie Veľkej Červenej Tlačidla.
- 10-15 minút na časové oneskorenia a prepájanie objemov, registrovanie VM.
- 30 minút na zmenu IP adresovania — optimistický odhad.
- A nakoniec štart VM a spustenie produktívnych služieb.
Celkovo RTO (čas na obnovenie obchodných procesov) môžeme smelo odhadovať na 4 hodiny.
Porovnajme to so situáciou na metroklaustere.
- Úložisko chápe, že spojenie s ramenom metroklaustra je stratene — 15-30 sekúnd.
- Hosti virtualizácie chápu, že prvé dátové centrum je stratene — 15-30 sekúnd (súčasne s p. 1).
- Automatické reštartovanie od polovice do tretiny VM v druhom dátovom centre — 10-15 minút do načítania služieb.
- Približne v tejto dobe pohotovostná zmena chápe, čo sa stalo.
Celkovo: RTO = 0 pre jednotlivé služby, 10-15 minút vo všeobecnosti.
Prečo je reštart iba od polovice do tretiny VM? Pozrite sa, v čom je problém:
- Robíte to inteligentne a zapínate automatické vyvažovanie VM. V priemere sa v jednom z datacentier vykonáva iba polovica VM. Celý zmysel metroklastera spočíva v minimalizácii výpadkov, a teda vo vašom záujme je minimalizovať aj počet VM vystavených riziku.
- Časť služieb možno klastrovať na úrovni aplikácie, rozmiestniť ich na rôzne VM. Tieto párové VM sú teda zabezpečené buď pribitím klincami, alebo poprípade pripojením šnúrkou k rôznym datacentrom, aby služba nemusela čakať na reštart VM v prípade poruchy.
Pri dobre postavenej infraštruktúre s rozloženými metroklastrami pracujú obchodní používatelia s minimálnymi oneskoreniami z ktoréhokoľvek miesta, aj v prípade poruchy na úrovni datacentra. V najhoršom prípade oneskorenie dosiahne čas na jednu šálku kávy.
A samozrejme, metroklastre fungujú skvele ako s odchádzajúcim HPE 3Par, tak aj s novými Primera!
Infrastruktúra vzdialených pracovných miest
Terminálne servery
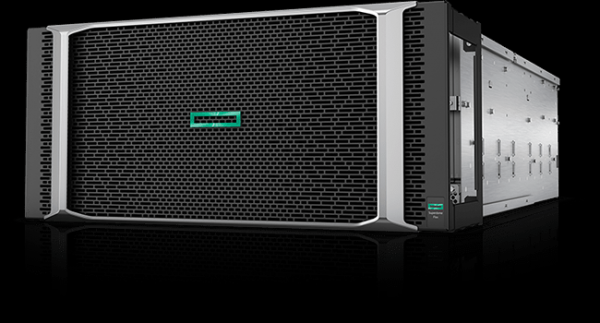
Pre terminálové servery netreba vymýšľať nič nové, už mnoho rokov HPE dodáva jedny z najlepších serverov na svete pre ne. Nadčasová klasika — DL360 (1U) alebo DL380 (2U) alebo pre fanúšikov AMD — DL385. Samozrejme, sú k dispozícii aj blade servery, ako klasické C7000, tak aj nová flexibilná platforma Synergy.
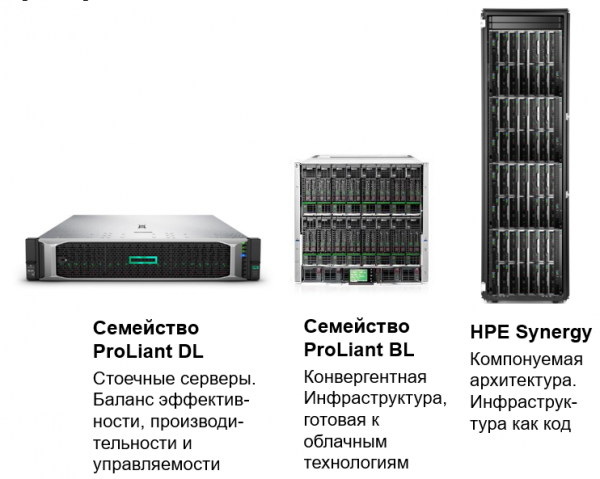
Pre každý vkus, pre každú farbu, maximum relácií na server!
„Klasický“ VDI + HPE Simplivity
V tomto prípade pod pojmom „klasický VDI“ myslím koncept 1 používateľ = 1 VM s klientským Windows. A samozrejme, niet bližšieho a príbuznejšieho VDI zaťaženia pre hyperkonvergované systémy, obzvlášť s deduplikáciou a kompresiou.
Tu môže HPE ponúknuť buď svoju vlastnú hyperkonvergovanú platformu Simplivity, alebo servery / certifikované uzly pod riešenia partnerov, ako napríklad VSAN Ready Nodes pre vytvorenie VDI na infraštruktúre VMware VSAN.
Poďme sa pozrieť bližšie na vlastné riešenie Simplivity. Na prvé miesto, ako nám jemne naznačuje názov, je postavená jednoduchosť (angl. simple — jednoduchý). Jednoduchosť nasadenia, jednoduchosť správy, jednoduchosť škálovania.
Hyperkonvergentné systémy sú dnes jednou z najhorúcejších tém v IT, pričom počet dodávateľov rôznej úrovne je približne 40. Podľa magického štvorca Gartner sa spoločnosť HPE nachádza v prvej päťke globálne a patrí do štvorca lídrov – tí chápu, kam sa priemysel vyvíja, a dokážu toto porozumenie preniesť do hardvéru.
Architektúra Simplivity je klasický hyperkonvergentný systém s kontrolnými virtuálnymi strojmi, čo znamená, že môže podporovať rôzne hypervízory, na rozdiel od integrovaných v hypervízore systémov. A naozaj, ku aprílu 2020 sú podporované VMware vSphere a Microsoft Hyper-V, a ohlásené plány na podporu KVM. Kľúčovým rysom Simplivity od jej uvedenia na trh bolo hardvérové urýchlenie kompresie a deduplikácie pomocou špeciálnej akceleračnej karty.
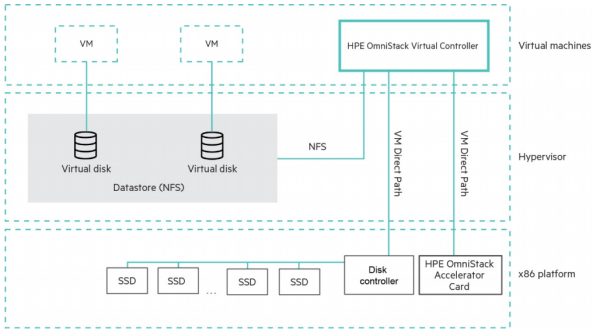
Je potrebné poznamenať, že kompresia s deduplikáciou sú globálne a neustále zapnuté, takže to nie je voliteľná funkcia, ale architektúra riešenia.
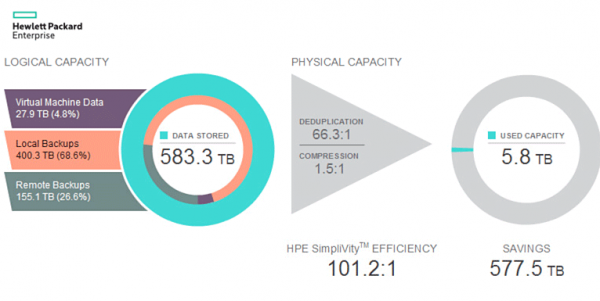
HPE samozrejme trochu preháňa, keď tvrdí efektivitu 100:1, počítajúc to zvláštnym spôsobom, ale efektivita využitia priestoru je naozaj veľmi vysoká. Číslo 100:1 je však príliš pekné. Poďme sa pozrieť na to, ako je Simplivity technicky realizovaná, aby ukázala takéto čísla.
Snapshot. Snímky (snapshoty) sú 100 % správne implementované ako RoW (Redirect-on-Write), takže sa dejú okamžite a neznižujú výkon. Na rozdiel od niektorých iných systémov. Prečo potrebujeme lokálne snapshoty bez trestov? Veľmi jednoducho, na zníženie RPO zo 24 hodín (priemerné RPO pre zálohovanie) na desiatky alebo dokonca jednotky minút.
Backup. Snapshot od zálohy sa líši iba tým, ako ho vníma systém správy virtuálnych strojov. Ak sa pri odstránení stroja odstráni aj všetko ostatné – znamená to, že to bol snapshot. Ak zostalo – znamená to záloha. Týmto spôsobom môže byť akýkoľvek snapshot považovaný za úplnú zálohu, ak je označený v systéme a nie je odstránený.
Samozrejme, mnohí namietnú – akáto je to záloha, keď sa uchováva na tej istej systéme? A tu je veľmi jednoduchá odpoveď vo forme protik otázky: povedzte, máme formálny model hrozieb, ktorý stanovuje pravidlá uchovávania zálohy? Toto je absolútna čestná záloha proti odstráneniu súboru vo VM, je to záloha proti odstráneniu samotnej VM. V prípade potreby uchovávania zálohy výhradne na samostatnom systéme máte na výber: replikáciu tohto snapshotu na druhý klaster Simplivity alebo na HPE StoreOnce.
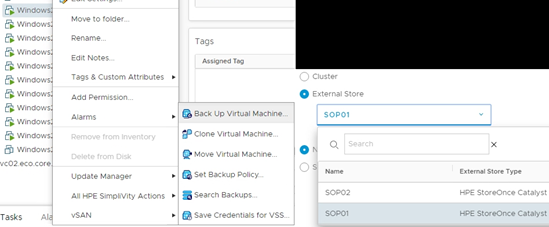
A presne tu sa ukazuje, že takáto architektúra je jednoducho ideálna pre akýkoľvek typ VDI. Veď VDI sú stovky alebo dokonca tisíce veľmi podobných strojov s rovnakým operačným systémom, s týmito istými aplikáciami. Globálna deduplifikácia to všetko spracuje a skomprimuje ani nie 100:1, ale niekde lepšie. Rozvinúť 1000 VM z jedného šablóny? Vôbec nie je problém, tieto stroje sa budú dlhšie registrovať vo vCenter, než sa klonovať.
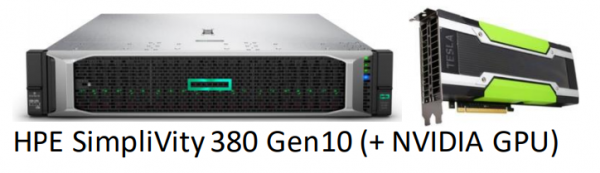
Špeciálne pre používateľov s osobitnými požiadavkami na výkon a pre tých, ktorí potrebujú 3D akcelerátory, bola vytvorená séria Simplivity G.
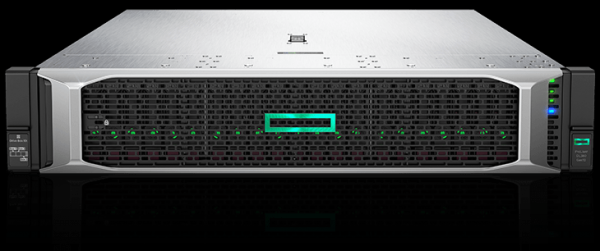
V tejto sérii sa nepoužíva hardvérový akcelerátor deduplifikácie, a preto je znížený počet diskov na uzol, aby sa kontrolér mohol spracovať programovo. Vďaka tomu sa uvoľnia sloty PCIe pre akékoľvek iné akcelerátory. Rovnako bol zdvojnásobený objem dostupnej pamäte na uzol na 3 TB pre najnáročnejšie záťaže.
Simplivity je ideálna pre organizáciu geograficky rozdelených VDI infraštruktúr s replikáciou dát do centrálneho DC.
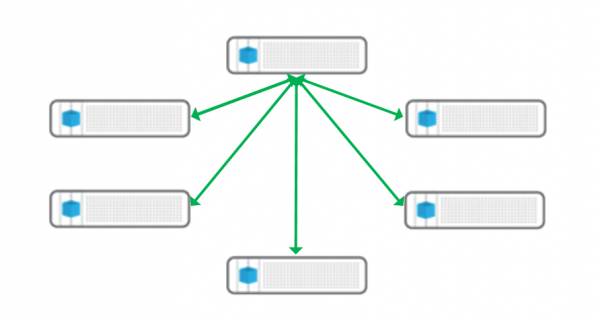
Takáto architektúra VDI (a vlastne nielen VDI) je obzvlášť zaujímavá v podmienkach ruských reálií — obrovské vzdialenosti (a teda latencie) a ďaleko nie ideálne kanály. Vytvárajú sa regionálne centrá (a to aj len 1-2 uzly Simplivity vo veľmi vzdialených kanceláriách), kde sa pripájajú miestni používatelia cez rýchle kanály, zachováva sa plná kontrola a správa zo stredu, a do centra sa replikuje len nepatrné množstvo už skutočných, cenných, nie odpadových dát.
Samozrejme, Simplivity sa plne integruje s OneView a InfoSight.
Tenké a nulové klienty
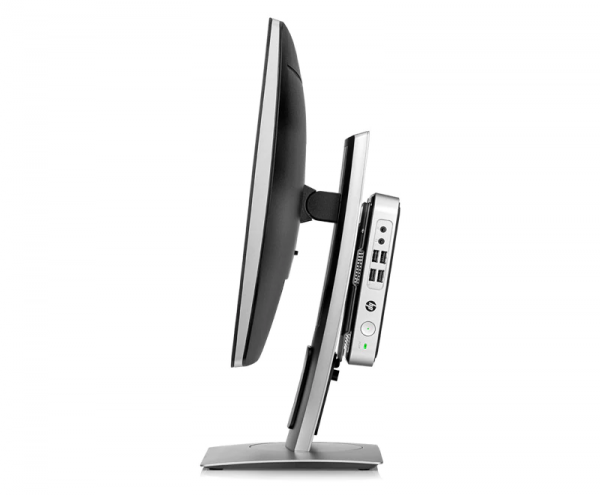
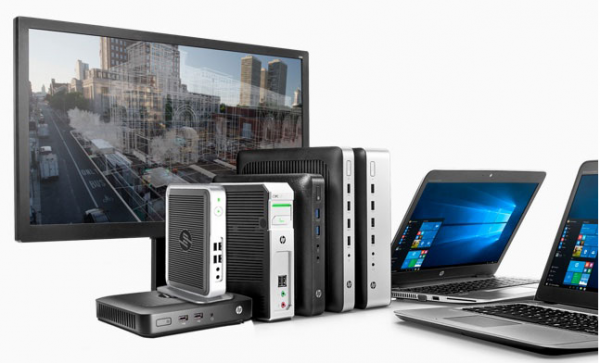
Tenké klienty sú špecializované riešenia navrhnuté výhradne na použitie ako terminály. Keďže na klienta prakticky nie je žiadna záťaž okrem udržovania kanála a dekódovania videa, takmer vždy obsahuje procesor s pasívnym chladením, malý spúšťací disk len na naštartovanie špeciálneho zabudovaného operačného systému, a v podstate je to všetko. Je takmer nemožné, aby sa pokazil, a kradnúť z neho je zbytočné. Cena je nízka a žiadne údaje sa v ňom neukladajú.
Existuje osobitná kategória tenkých klientov, takzvané nulové klienty. Ich hlavným rozdielom od tenkých klientov je absencia aj zabudovaného operačného systému všeobecného účelu, a práca výlučne s mikrčipom s firmware-om. Často obsahujú špeciálne hardvérové akcelerátory na dekódovanie videostreamu v terminálových protokoloch, ako PCoIP alebo HDX.
Napriek rozdeleniu veľkého „Hewlett-Packard“ na jednotlivé HPE a HP, nemožno nespomenúť tenké klienty vyrobené HP.
Výber je široký, podľa vkusu a potrieb — až po viaceré monitory na pracovných miestach s hardvérovým zrýchlením videostreamu.
Služba HPE pre vašu vzdialenú prácu
A na poslednom mieste, ale nie menej dôležitom, chcem spomenúť službu HPE. Bolo by príliš dlhé vymenovávať všetky úrovne služby HPE a jej možnosti, ale minimálne je tu jedno veľmi dôležité ponúknutie v kontexte vzdialenej práce. A to konkrétne — servisný inžinier od HPE/autorizovaného servisného strediska. Pokračujete v práci na diaľku z vášho obľúbeného vidieka, počúvajúc bzukot včiel, zatiaľ čo do vašich serverov prichádza technik od HPE a mení disky alebo nefunkčný napájací blok.
HPE CallHome
V súčasných podmienkach, za obmedzenia pohybu, sa funkcia Call Home stáva aktuálnejšou ako kedykoľvek predtým. Akýkoľvek systém HPE s touto funkciou môže sám oznámiť technickú alebo softvérovú poruchu do podporného centra HPE. A je veľmi pravdepodobné, že náhradný diel a/alebo servisný inžinier prídu k vám ešte predtým, ako si všimnete poruchy a problémy s produktívnymi službami.
Osobne túto funkciu dôrazne odporúčam zapnúť.
Zdroj: habr.com
