

Volám sa Sergej, som zo spoločnosti ITSumma a chcem vám povedať, ako pristupujeme k zálohovaniu v Kubernetes. V poslednej dobe sa veľmi intenzívne zaoberám poradenskou prácou pri zavádzaní rôznych devops riešení pre rôzne tímy a konkrétne sa zameriavam na projekty využívajúce K8s. Na konferencii Uptime day 4, ktorá bola zameraná na zálohovanie v zložitých architektúrach, som vystúpil s prednáškou o zálohovaní „kocky“, a tu je jej voľný prehľad. Len vás vopred upozorním, že to nie je priama príručka k akcii, ale skôr súhrn zamyslení na danú tému.
V zásade je monitoring a zálohovanie dvoma základnými nástrojmi na zvýšenie odolnosti akéhokoľvek projektu. Ale veď v kubere sa všetko vyvažuje samo, poviete si, všetko sa škáluje samo, a ak sa niečo stane, samo sa to obnoví… Teda pri prvotnom povrchnom skúmaní témy internet odpovedal na otázku, ako sa kto prístupuje k zálohovaniu K8s: „a načo?“ Mnohí si myslia, že kuber je akási magická vec, ktorá zbavuje všetkých infraštrukturálnych problémov a zabezpečuje, že projekt nikdy nepadne. Ale… svet nie je to, čím sa zdá.
Ako sme voči procesu zálohovania predtým pristupovali? Mali sme identické prostredia na umiestnenie – či už to boli virtuálne stroje alebo fyzické servery, na ktoré sme aplikovali tri základné praktiky:
- synchronizácia kódu a statiky
- synchronizácia konfigurácií
- replikácia databáz
A voilà: kedykoľvek prepneme na záložné prostredie, všetci sú šťastní, zdvihneme sa a rozídeme.
Čo nám ponúkajú na zvýšenie trvalej dostupnosti našej aplikácie Kubernetes? Prvá vec, o ktorej hovorí neoficiálna dokumentácia, je nasadiť veľa strojov, vytvoriť veľa masterov – ich počet by mal spĺňať podmienky dosiahnutia kvóra v rámci klastra, a aby na každom z masterov bežal etcd, API, MC, scheduler… A, zdá sa, všetko sa zdá byť skvelé: ak vypadne niekoľko pracovných uzlov alebo masterov, náš klaster sa prebalansuje a aplikácia bude pokračovať v činnosti. Znie to ako čarodejníctvo! Ale často sa náš klaster nachádza v rámci jedného dátového centra a to môže vyvolať určité otázky. Čo ak príde bagrista a vykopá kábel, udrie blesk, nastane celosvetová povodeň? Všetko sa pokazí, náš klaster už neexistuje. Ako sa priblížiť k zálohovaniu s ohľadom na túto stránku problému?
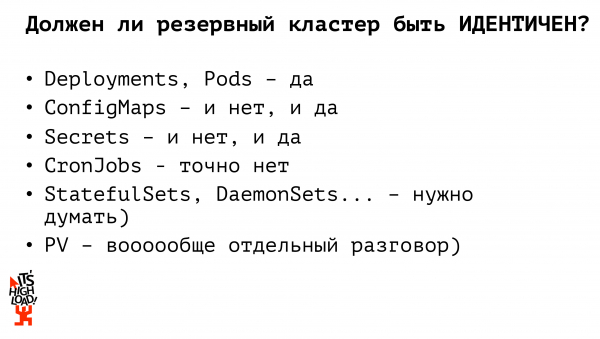
Predovšetkým by ste mali mať ďalší klaster v horúcej zálohe, teda klaster, na ktorý sa môžete kedykoľvek prepnuť. Z pohľadu Kubernetes musia byť infraštruktúry úplne identické. Teda ak existujú nejaké nestandardné pluginy na prácu so súborovým systémom, vlastné riešenia pre ingress, musia byť úplne identické na vašich dvoch (alebo troch, alebo desiatich, tu už záleží na tom, koľko peňazí a síl máte) klastroch. Je potrebné jasne definovať dva súbory aplikácií (deploymentov, statefulsetov, daemonsetov, cronjobov atď.): ktoré z nich môžu pracovať na zálohe nepretržite, a ktoré by bolo lepšie nespúšťať, kým nenastane bezprostredné prepnúť.
Má byť náš záložný klaster úplne identický s naším produkčným klastrom? Nie. Ak sme skôr pri práci s monolitnými projektmi, so železnou infraštruktúrou udržiavali prakticky úplne identické prostredie, tak v rámci Kubernetes to považujem za nepotrebné. Poďme sa pozrieť, prečo.
Napríklad, začneme s základnými entitami Kubernetes — deployments — ktoré by mali byť identické. Musia byť spustené aplikácie, ktoré v ktoromkoľvek momente môžu prebrať spracovanie prevádzky a umožniť nášmu projektu pokračovať v živote. Ak hovoríme o konfiguračných súboroch, treba si uvedomiť, či by mali byť identické alebo nie. Teda, ak sme inteligentní ľudia, ktorí neužívajú žiadne zakázané látky a nemáme databázu v K8s, v našich configmaps by mali byť nastavenia prístupu k produkčnej databáze (proces rezervácie je postavený osobitne). Zodpovedne na zabezpečenie prístupov k záložnej databáze musíme mať osobitný konfiguračný súbor (configmap). Rovnako tak pracujeme aj so secrets: heslami na prístup k databáze, API kľúčmi; v ktoromkoľvek momente môže fungovať buď produkčný secret, alebo záložný. Takže už máme dve entity Kubernetes, ktorých záložné verzie by nemali byť identické s produkčnými. Ďalšia entita, na ktorej sa treba zastaviť, je cronjob. Cronjoby na zálohe v žiadnom prípade nesmú byť identické so sadou cronjobov produkčného clustera! Ak spúšťame záložný cluster so všetkými cronjobami zapnutými — napríklad, ľudia u vás dostanú dve maily naraz namiesto jedného. Alebo nejaká synchronizácia údajov s externými zdrojmi sa bude vykonávať dvakrát, čo znamená, že začneme trpieť, plakať, kričať a nadávať.
A ako nám navrhujú zorganizovať záložný cluster ľudia z internetu? Druhá najpopulárnejšia odpoveď po "a na čo?" — použitie Kubernetes Federation.
Čo to je? Je to, povedzme, veľký meta-klaster. Ak si predstavíme architektúru kuber — kde máme mastera a niekoľko uzlov, — tak z pohľadu federácie máme tiež mastera a niekoľko uzlov, len každá uzol je samostatný klaster. To znamená, že pracujeme s tými istými entitami, s tými istými primitívami ako s jedným kuberom, len namiesto našich fyzických strojov používame celé klastre. V rámci federácie prebieha úplná synchronizácia federatívnych zdrojov od rodičov k potomkom. Napríklad, ak sme spustili nejaký deployment cez federáciu — nasadí sa na každý náš dcérsky klaster. Ak vezmeme akýkoľvek configmap, tajomstvo, rozložíme ho na federácii — rozšíri sa do všetkých našich dcérskych klastrov; pritom federácia umožňuje prispôsobiť naše zdroje na deťoch. To znamená, že sme vzali nejaký configmap, nasadili ho cez federáciu a potom, ak potrebujeme niečo upraviť na konkrétnych klastroch, ideme upravovať na jednotlivom klastre a táto zmena sa už nikam nebude synchronizovať.
Kubernetes Federation je nástroj, ktorý existuje len nedávno a nepodporuje všetky zdroje, ktoré poskytuje samotný K8s: v čase vydania jednej z prvých verzií dokumentácie sa uvádzalo, že podporuje len config-mapy, deployment pre replica-set a ingress. Tajomstvá neboli podporované, práca s volume tiež nebola podporovaná. Príliš obmedzený súbor funkcií. Zvlášť ak sa radi bavíme — napríklad prostredníctvom custom resource definition prenášať naše vlastné zdroje do Kubernetes, do federácie ich už nedostaneme. Inými slovami... veľmi podobné pravde, ale núti nás to občas si vystreliť do nohy. Na druhej strane, federácia umožňuje flexibilne spravovať náš replica-set. Napríklad, ak chceme, aby bolo spustených 10 replik našej aplikácie, federácia toto číslo automaticky rozdelí proporčne medzi počet klastrov. A to všetko je možné ešte aj konfigurovať! Môžeme určiť, že na produkčnom klastri treba udržiavať 6 replik našej aplikácie, zatiaľ čo na záložnom klastri, pre úsporu zdrojov alebo pre vlastné zábavy — len 4 repliky našej aplikácie. To je tiež dosť pohodlné. Ale s federáciou musíme používať nejaké nové riešenia, niečo nasadzovať za pochodu, nútiť seba trochu viac premýšľať...
Môžeme pristúpiť k procesu rezervovania Kubernetes nejako jednoduchšie? Aké nástroje máme vlastne k dispozícii?
Predovšetkým máme vždy nejaký ci/cd systém, to znamená, že manuálne nechodíme, nepíšeme na serveroch create/apply. Systém generuje yaml súbory pre naše kontajnery.
Po druhé, máme niekoľko klastrov; máme buď jedno, alebo viac (ak sme inteligentní) registry, ktoré sme tiež vzali a rezervovali. A máme úžasný nástroj kubectl, ktorý môže pracovať s viacerými klastrami súčasne.
Podľa môjho názoru je najjednoduchším a najpresnejším riešením na vytvorenie záložného klasteru primitívny paralelný deploy. Existuje nejaký pipeline v ci/cd systéme; najprv zostavíme naše kontajnery, otestujeme ich a potom nasadíme aplikácie cez kubectl na niekoľko nezávislých klastrov. Môžeme vykonávať súčasné nasadenia na viac klastrov. Rovnako sa na tejto úrovni riešia aj dodávky konfigurácií. Môžeme vopred určiť súbor konfigurácií pre náš produktový klaster, súbor konfigurácií pre záložný klaster a na úrovni ci/cd systému nasadiť produkčné prostredie do produkčného klasteru, záložné prostredie — do záložného klasteru. V porovnaní s federáciou nemusíme chodiť na každý podklaster a niečo predefinovať po určení federatívneho zdroja. Urobili sme to vopred. Akí sme skvelí.
Ale... je... predtým som napísal, že je tu „koreň všetkých zloduchov“, ale v skutočnosti sú tu dva. Po prvé, súborový systém. Existuje nejaký PV, alebo používame externé úložisko. Ak uchovávame súbory v rámci klasteru, musíme sa riadiť starými praktikami z čias hardvérovej infraštruktúry: napríklad synchronizovať lsyncom. Alebo akýmkoľvek iným nástrojom, ktorý máte radi. Rozširujeme všetko na iné stroje a žijeme.
Po druhé, a to, pravdupovediac, je ešte dôležitejší bod — databáza. Ak sme múdri ľudia a nedržíme databázu v kube, proces zálohovania dát funguje podľa tej istej starej schémy — master-slave replikácia, potom prepneme, replikáciu dobehne a budeme žiť dobre. Ale ak budeme držať našu DB v rámci klasteru, existuje veľa hotových riešení na organizáciu tej istej master-slave repliky, veľa riešení na zdvíhanie DB vo vnútri kube.
O zálohovaní databáz už bolo prečítaných milión prednášok, napísaných milión článkov, nič nové tu vlastne nie je. V skratke, nasledovať svoje sny, žiť ako chcete, vymýšľať si nejaké komplikované obstrukcie, ale určite premýšľať o tom, ako to celé budete zálohovať.
A teraz o tom, ako bude prebiehať prechod na záložnú lokalitu v prípade požiaru. Po prvé, paralelne nasadzujeme stateless aplikácie. Nepôsobia na obchodnú logiku našich aplikácií, nášho projektu, môžeme neustále mať dve sady spustených aplikácií a tie môžu začať prijímať prenos. Je veľmi dôležité pri prechode na záložnú lokalitu nevyhnutne skontrolovať — je potrebné predefinovať konfigurácie? Napríklad máme produkčný cluster Kubernetes, máme záložný cluster Kubernetes, máme externú databázu master, máme záložnú databázu master. Máme štyri možnosti, ako môžu tieto aplikácie v produkcii začať medzi sebou interagovať. Môže sa preniesť databáza, a tak sa môže stať, že musíme v produkčnom clustri prepnúť prenos na novú databázu, alebo môže zlyhať cluster — a presunuli sme sa na záložnú lokalitu, ale pokračujeme v práci s produkčnou databázou, a tretí variant, keď zlyhal to aj to, a prepneme obe aplikácie, predefinujeme našu konfiguráciu, aby nové aplikácie už pracovali s novou databázou.
Aké závery môžeme z toho všetkého urobiť?
Prvý záver: so zálohou sa žije dobre. Ale je to drahé. Ideálne by sme nemali mať iba jednu zálohu. Ideálne by sme mali mať viacero záloh. Po prvé, záloha by mala byť minimálne na inom dátovom centre, a po druhé, minimálne u iného poskytovateľa. Často sa stalo — a na mojej praxi to bolo. Projekty nemôžem, žiaľ, pomenovať, presne keď došlo k požiaru v dátovom centre... A ja hovorím: prechádzame na zálohu! A záložné servery boli v tej istej skrini...
Alebo si predstavte, že Amazon bol zakázaný v Rusku (a niečo také sa stalo). A všetko: aký má význam, že na inom Amazone máme našu zálohu? Táto je tiež nedostupná. Takže opakujem: držme zálohu minimálne v inom dátovom centre, a ideálne — u iného poskytovateľa.
Druhý výstup: ak máte v kuber aplikáciu, ktorá komunikuje s nejakými externými zdrojmi (to môže byť databáza alebo nejaké externé api), určite ju definujte ako službu s externým Endpointom, aby ste pri prepnutí nemuseli znovu nasadzovať 15 vašich aplikácií, ktoré sa pripojujú k tej istej databáze. Definujte databázu ako samostatnú službu, pripojte sa k nej, akoby bola vo vašom klastri: ak sa vám databáza pokazí, zmeníte IP na jednom mieste a budete pokračovať v šťastnom živote.
A nakoniec: ‘kubík’ mám rád, rovnako ako experimenty s ním. A tiež rád zdieľam výsledky týchto experimentov a svoj osobný zážitok. Preto som zaznamenal sériu webinárov o K8s, vítam vás na pre podrobnosti.
Zdroj: habr.com
