

Filozofické úvodné slovo
Ako je známe, existujú iba dva spôsoby riešenia úloh:
- Metóda analýzy alebo metóda dedukcie, alebo z všeobecného na konkrétne.
- Metóda syntézy alebo metóda indukcie, alebo z konkrétneho na všeobecné.
Na riešenie problému „zlepšiť výkon databázy“ to môže vyzerať nasledovne.
Analýza — rozoberáme problém na jednotlivé časti a snažíme sa tým zlepšiť výkon databázy ako celku.
V praxi analýza vyzerá približne takto:
- Vzniká problém (incident výkonu)
- Zbierame štatistické informácie o stave databázy
- Hľadáme úzke miesta(bottlenecks)
- Riešime problémy s úzkymi miestami
Úzke miesta databázy — infraštruktúra (CPU, pamäť, disky, sieť, OS), nastavenia(postgresql.conf), dotazy:
Infrastruktúra: možnosti vplyvu a zmien pre inžiniera — takmer nulové.
Nastavenia databázy: možnosti na zmeny sú o niečo väčšie ako v predchádzajúcom prípade, ale zvyčajne sú stále dosť zložité, najmä v cloude.
Dotazy na databázu: jediná oblasť pre manévrovanie.
Syntéza — zlepšujeme výkon jednotlivých častí, očakávajúc, že výsledkom bude zlepšenie výkonu databázy.
Lyričké úvodné slovo alebo na čo je toto všetko dobré
Ako prebieha proces riešenia incidentov výkonu, ak výkon databázy nie je monitorovaný:
Zákazník - „máme všetko zle, pomaly, urobte nám to dobre“
Inžinier - „zle, to ako?“
Zákazník – „takto teraz (pred hodinou, včera, pri poslednej zakázke), pomaly“
Inžinier – „a kedy to bolo dobre?“
Zákazník – „pred týždňom (dvoma týždňami) to bolo celkom dobré.“ (To sa podarilo)
Zákazník – „a ja si nepamätám, kedy to bolo dobre, ale teraz je to zlé “(Bežná odpoveď)
Vo výsledku dostaneme klasický obraz:
Kto je vinný a čo robiť?
Na prvú časť otázky je najľahšie odpovedať — vinný je vždy inžinier DBA.
Na druhú časť odpovedať tiež nie je príliš ťažké — je potrebné implementovať systém monitorovania výkonu databázy.
Objavuje sa prvá otázka — čo monitorovať?
Cesta 1. Budeme monitorovať VŠETKO
Zaťaženie CPU, počet operácií diskového čítania/zápisu, veľkosť pridelené pamäte, a ešte megatón rôznych čítačov, ktoré môže poskytnúť akýkoľvek trochu funkčný monitorovací systém.
Výsledkom je množstvo grafov, súhrnných tabuliek a neustále upozornenia na e-mail, čo vedie k 100% zamestnanosti inžiniera riešením množstva rovnakých tiketov, pričom obvykle so štandardnou formuláciou — „Dočasný problém. Nie je potrebná žiadna akcia“. Ale všetci sú zamestnaní a vždy je čo ukázať zákazníkovi — práca je v plnom prúde.
Cesta 2. Monitorovať iba to, čo je potrebné, a to, čo nie je potrebné, nemusíme monitorovať.
Môžeme monitorovať trochu inak — iba entity a udalosti:
- Na ktoré inžinier DBA môže mať vplyv.
- Pre ktoré existuje algoritmus akcií pri vzniku udalosti alebo zmene entity.
Z tohto predpokladu a s ohľadom na „Filozofické úvodné slovo“, aby sa predišlo pravidelnému opakovaniu „Lyričké úvodné slovo alebo na čo je toto všetko dobré“, je rozumné monitorovať výkon jednotlivých dopytov na optimalizáciu a analýzu, čo by malo nakoniec viesť k zlepšeniu rýchlosti celej databázy.
Ale aby sme zlepšili náročný dopyt, ktorý ovplyvňuje celkový výkon databázy, musíme ho najprv nájsť.
Týmto vznikajú dve vzájomne prepojené otázky:
- aký dopyt sa považuje za náročný
- ako hľadať náročné dopyty.
Je zrejmé, že náročný dopyt je dopyt, ktorý využíva veľa zdrojov OS na získanie výsledku.
Prejdime k druhej otázke — ako hľadať a následne monitorovať náročné dopyty?
Aké možnosti pre monitorovanie dopytov sú v PostgreSQL?
V porovnaní s Oracle je možností menej, ale aj tak je možné niečo robiť.
PG_STAT_STATEMENTS
Na vyhľadávanie a monitorovanie náročných dopytov v PostgreSQL slúži štandardné rozšírenie pg_stat_statements.
Po inštalácii rozšírenia sa v cieľovej databáze objaví rovnomenný pohľad, ktorý je potrebné použiť na účely monitorovania.
Cieľové stĺpce pg_stat_statements na vytvorenie systému monitorovania:
- queryid Interný hash kód vypočítaný podľa stromu rozboru operátora.
- max_time Maximálny čas strávený na operátore v milisekundách.
Zhromaždením a použitím štatistiky podľa týchto dvoch stĺpcov je možné vybudovať monitorovací systém.
Ako sa používa pg_stat_statements na monitorovanie výkonu PostgreSQL.
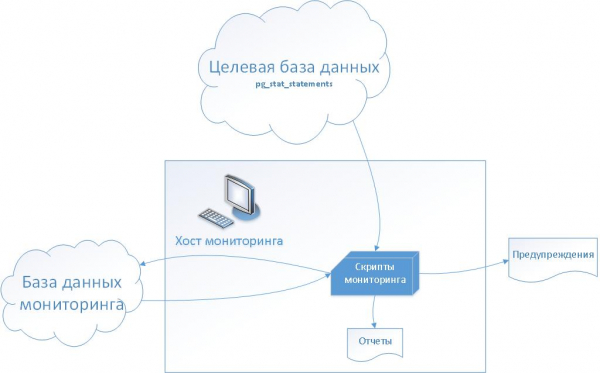
Na monitorovanie výkonu dopytov sa používa:
Na strane cieľovej databázy — pohľad pg_stat_statements.
Z pohľadu servera a databázy monitorovania — súbor bash skriptov a servisných tabuliek.
1. etapa — zber štatistických údajov
Na monitorovacom hostingu sa pravidelne spúšťa skript cez cron, ktorý kopíruje obsah pohľadu pg_stat_statements z cieľovej databázy do tabuľky pg_stat_history v databáze monitorovania.
Týmto spôsobom sa vytvára história vykonávania jednotlivých dopytov, ktorá sa dá využiť na vytváranie správ o výkonnosti a nastavenie metrík.
2. etapa — nastavenie metrík výkonnosti
Na základe zozbieraných údajov vyberáme dopyty, ktorých vykonávanie je pre klienta (aplikáciu) najkritickejšie/na najdôležitejšie. Po dohode so zákazníkom nastavujeme hodnoty metrík výkonnosti pomocou polí queryid a max_time.
Výsledok — začiatok monitorovania výkonnosti
- Monitorovací skript pri spustení kontroluje nakonfigurované metriky výkonnosti, porovnáva hodnotu max_time metriky s hodnotou z pohľadu pg_stat_statements v cieľovej databáze.
- Ak hodnota v cieľovej databáze presahuje hodnotu metriky, vygeneruje sa upozornenie (incident v systéme tiketov)
Ďalšia možnosť 1
História plánov vykonávania dopytov
Na neskoršie riešenie incidentov výkonnosti je veľmi dobré mať históriu zmien plánov vykonávania dopytov.
Na uchovávanie histórie sa používa servisná tabuľka log_query. Tabuľka sa plní pri analýze nahraného log súboru PostgreSQL. Keďže v log súbore, na rozdiel od pohľadu pg_stat_statements, sa nachádza kompletný text s hodnotami parametrov vykonávania a nie normalizovaný text, je možné uchovávať nielen čas a trvanie dopytov, ale aj plány vykonávania v aktuálnom čase.
Ďalšia možnosť 2
Proces nepretržitého zlepšovania výkonnosti
Monitorovanie jednotlivých dopytov vo všeobecnosti nie je určené na riešenie úlohy nepretržitého zlepšovania výkonnosti databázy ako celku, pretože kontroluje a rieši otázky výkonnosti len pre jednotlivé dopyty. Môže sa však rozšíriť metóda a nastaviť monitorovanie dopytov pre všetky databázy.
Na to je potrebné zaviesť ďalšie metriky výkonnosti:
- V posledných dňoch
- Za základné obdobie
Skript vyberá dotazy z pohľadu pg_stat_statements v cieľovej databáze a porovnáva hodnotu max_time s priemernou hodnotou max_time, v prvom prípade za posledné dni alebo za vybraný časový úsek (baseline), v druhom prípade.
Takže v prípade degradácie výkonnosti pre akýkoľvek dotaz bude varovanie automaticky vytvorené bez ručnej analýzy správ.
A čo má spoločné so syntézou?
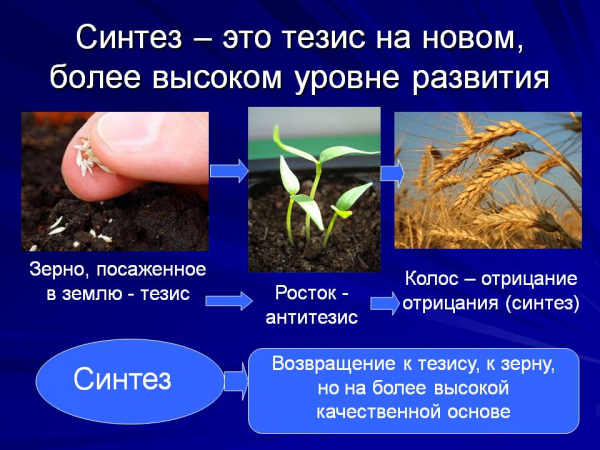
V opísanom prístupe, ako naznačuje metóda syntézy — zlepšením jednotlivých častí systému zlepšujeme systém ako celok.
- Dotaz vykonávaný databázou – téza
- Upravený dotaz – antitéza
- Zmena stavu systému — syntéza
Rozvoj systému
- Rozšírenie zhromažďovanej štatistiky pridaním histórie pre systémové zobrazenie pg_stat_activity
- Rozšírenie zhromažďovanej štatistiky pridaním histórie pre štatistiky jednotlivých tabuliek zapojených do dotazov
- Integrácia so systémom monitorovania v cloude AWS
- A ešte, niečo môžeme vymyslieť…
Zdroj: habr.com
