

4-6 septembra v Petrohrade, v konferenčnej sále Selectel sa uskutoční trojdňový .
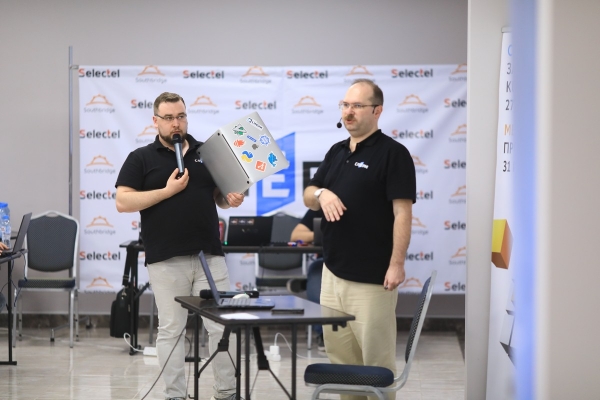
Program sme vytvorili s myšlienkou, že teoretické práce o DevOps, ako aj manuály k nástrojom, si môže každý prečítať sám. Zaujímavé sú len skúsenosti a prax: vysvetlenie, ako to robiť a ako to robiť nemáme, a rozprávanie o tom, ako to robíme my.
V každej spoločnosti, u každého administrátora alebo vývojára je iná úroveň DevOps. Niektorí nesprávne používajú Git, iní zavádzajú SRE. Kurz je organizovaný tak, aby si každý našiel niečo relevantné, čo môže zaviesť tu a teraz.
Začneme s Gitom, potom sa pozrieme na vývoj aplikácií, interakciu kódu a infraštruktúry, vytvoríme CI/CD, popíšeme infraštruktúru ako kód (IaC), otestujeme výsledné riešenie, nastavíme monitoring, zhromaždíme a preskúmame logy, a nakoniec prejdeme k SRE: premeníme spoľahlivosť na merateľný a riadený proces.
Git
V súčasnosti Git nepoužíva len ten, kto si včera kúpil svoj prvý laptop. Je to triviálny a všeobecne rozšírený nástroj a napriek tomu sa často stretávame s jeho nesprávnym použitím: od núteného pushu do masteru až po kopírovanie súborov z Gitu na server cez Ctrl-C, Ctrl-V.
Povedieme o tom, ako sa to nemá robiť, ako sa to má robiť, ako to robí Southbridge.
Prejdeme praxou: základy Gitu, tímová práca.
Téma č. 1: Základy práce s Git
- Základné príkazy git init, commit, add, diff, log, status, pull, push
- Git flow, vetvy a tagy, stratégie merge
- Práca s viacerými vzdialenými repo
Téma č. 2: Tímová práca s Git
- GitHub flow
- Fork, remote, pull request
- Konflikty, releasy, ešte raz o Gitflow a iných flow vzťahujúcich sa na tímy
Materiál je organizovaný tak, aby administrátori a vývojári mohli okamžite zaviesť všetky praktiky do práce.
Z pohľadu DevOps správna práca s Git usporadúva a automatizuje procesy vývoja a administrácie, eliminuje rad opakujúcich sa problémov, zvyšuje pracovnú produktivitu.
DevOps vývojár
Pozrieme sa na DevOps očami vývojára: spúšťame lokálne prostredie, píšeme aplikáciu, nastavujeme jej monitoring a logovanie, lokálne ju testujeme, organizujeme uloženie premenných/šíriek a service discovery, pozrieme sa na tracing (opentracing).
Téma č. 3: Práca s aplikáciou z pohľadu vývoja
- Nastavenie lokálneho prostredia: praktické odporúčania
- Píšeme mikroslužbu v Pythonu (včetně testů)
- Použití docker-compose v vývoji
Téma č. 4: Interakce kódu a infrastruktury
- Praxe práce s konfiguracemi
Na konci vývojáři uvidí, jak by měl kód odesílat logy, jak jej testovat a jak jej dále ladit. Správci pochopí potřeby vývojářů: jaké chyby v kódu vznikají, jak uspořádat testování pro vývojáře a jak testovat projekt sami.
V této fázi se řeší hlavní úkol DevOps: vytváří se vzájemné porozumění a spolupráce mezi devs a ops. To je klíčový krok k přechodu od přehazování úkolů k odpovědnému interakci.
Výsledkem je zvýšení rychlosti a kvality práce.
CI/CD
Moderní automatizace zahrnuje CI/CD. Začneme tím, že se podíváme na ruční automatizaci: makefile, git hooky, skripty. Probereme, kdy jsou tyto nástroje ještě relevantní a kdy je lepší je nepoužívat.
Poté se zaměříme na nejlepší praktiky moderního CI na příkladu Gitlabu.
Téma č. 5: CI/CD úvod do automatizace
- Úvod do automatizace
- Nástroje (bash, make, gradle)
- Použití git hooků pro automatizaci procesů
- Strojní výrobní linky a jejich aplikace v IT
- Příklad výstavby "společného" pipeline
- Moderní software pro CI/CD: Drone CI, BitBucket Pipelines, Travis atd.
Téma č. 6: CI/CD: Práce s Gitlabem
- Gitlab CI — obecné informace
- Gitlab Runner, jejich typy a použití
- Gitlab CI, specifika konfigurace, nejlepší praktiky
- Fáze Gitlab CI
- Proměnné Gitlab CI
- Sestavení, testování, nasazení
- Kontrola a omezení provádění: only, when
- Práce s artefakty
- Šablony uvnitř .gitlab-ci.yml, opětovné použití akcí na různých místech pipeline
- Include — sekce
- Centralizované řízení gitlab-ci.yml (jediný soubor a automatické push do ostatních repozitářů)
Spolupráce správců a vývojářů dosahuje nové úrovně: správce píše šablonu CI, kterou vývojáři upravují, aby vytvářeli svůj CI nezávisle na správci.
Snižuje se závislost vývojářů na správcích, zmenšuje se množství manuální práce a mizí problém "jediného člověka, který ví, jak pracovat s makefilem". Nasazení probíhá spolehlivě a rychle.
IaC
Tému Infrastructure as Code na príklade Terraform predstaví administrátor cloudu Selectel Alexej Stepanenko. Ukáže, ako rýchlo a automatizovane nasadiť a škálovať servery, ako automaticky balíčkovať obrazy, ako používať šablóny konfigurácie na okamžité získanie nastavených strojov.
Človek, ktorý vytvoril tisíce IaC riešení, povie, ako to robiť správne a ako to robiť nesprávne.
Riešenie pre cloud Selectel s minimálnymi úpravami je vhodné pre cloudy Google a Amazon.
Zamestnanec Southbridge Nikolaj Mesropjan na príklade Ansible ukáže, ako bez downtime nasadiť fungujúcu aplikáciu a overiť jej funkčnosť.
Ak manipulatívne upravujete infraštruktúru (nastavujete servery, podľa potreby inštalujete knižnice, balíky), pri pokuse o vytvorenie kópie prostredia si budete musieť pamätať a reprodukovať všetky svoje kroky. Táto úloha si môže ľahko vyžiadať 3-5 dní. Práca s infraštruktúrou ako s kódom zaručuje, že máte aktuálny popis prostredia, ktorý je možné nasadiť za minúty.
Nikolaj porozpráva, ako písať playbooky, aké chyby sa vyskytujú, prečo niekedy playbooky fungujú pomaly alebo inak, ako sa očakávalo. Je to výsledok mnohých rokov používania IaC v Southbridge.
Téma č. 7: Infrastructure as Code
- IaC: prístup k infraštruktúre ako kódu
- Cloudoví poskytovatelia ako dodávatelia infraštruktúry
- Nástroje na inicializáciu systémov, zostavenie obrazov (packer)
- IaC na príklade Terraform
- Ukladanie konfigurácií, spolupráca, automatizácia aplikácií
- Praxa vytvárania Ansible playbookov
- Idempotentnosť, deklaratívnosť
- IaC na príklade Ansible
- Database as a Code / Odolnosť PostgreSQL
Infraštruktúra nadobúda deklaratívnosť a idempotentnosť.
Administrátor sa učí spravovať zložitú infraštruktúru: rýchlo vytvárať nové prostredia, udržiavať jednotnosť všetkých prostredí, vidieť históriu zmien, čo je kritické, keď na projekte pracuje niekoľko tímov.
Developer sa môže naučiť infraštruktúru a samostatne si vytvárať prostredia.
Bonus sekcie — vytvorenie a nastavenie odolného klastrovaného systému databáz PostgreSQL. Poskytneme hotový playbook, ktorý používame v Southbridge, vy nasadíte klaster na vzdelávacom prostredí a môžete toto riešenie využiť aj vo svojej firme.
Testovanie infraštruktúry a monitorovanie.
Automatizácia umožňuje rozšíriť chybu na tisíc serverov. Pri každej zmene je potrebné testovanie. Na druhej strane, manuálne testovanie zaberá toľko času, že znižuje výhody automatizácie na minimum.
Predvedieme v praxi, ako písať testovanie rolí. V dôsledku toho budete schopní písať testy pre svoju spoločnosť. Už si nemusíte pamätať vykonané nastavenia, popíšete ich v testoch a automaticky overíte, že všetky predchádzajúce riešenia a obchádzky sú na svojom mieste.
Následne sa naučíme automaticky pridávať do monitorovania všetky nové servery. Osobitne preskúmame monitorovanie infraštruktúry a aplikácií. Predvedieme zlé a dobré praktiky.
Téma č. 8: Testovanie infraštruktúry
- Testovanie a kontinuálna integrácia s Molecule a Gitlab CI
- Použitie Vagrantu
Téma č. 9: Monitorovanie infraštruktúry s Prometheus
- Načo je potrebné monitorovanie
- Typy monitorovania
- Upozornenia v monitorovacom systéme
- Ako vybudovať zdravý monitorovací systém
- Čitateľné upozornenia pre všetkých
- Health Check: na čo si dávať pozor
- Automatizácia na základe údajov z monitorovania
Nesprávne fungujúce monitorovanie je absencia monitorovania. Podniku je jedno, že hlavná stránka internetového obchodu je dostupná, ak platobný formulár zobrazuje chybu.
Na nastavení monitorovania a riešení problémov sa vývojári a administrátori podieľajú rovnako. Tradične sú úlohy monitorovania na administrátoroch. Náš kurz ukáže vývojárom, akú rolu hrajú pri vytváraní efektívneho monitorovania. Administrátori získajú najlepšie praktiky od Southbridge. V dôsledku toho rýchlo klesne počet strát spôsobených výpadkami a oneskoreniami webovej stránky alebo aplikácie.
Bonus sekcie: automatizácia na základe monitorovania. Napríklad monitorovanie hlási, že na web prišla záťaž, a škálovanie webových serverov sa spúšťa automaticky.
Logovanie
Hlavná chyba pri práci s logmi je, že administrátori a vývojári ich sledujú priamo na serveroch. Ak máte viac ako jeden server, trvá to dlho. Je to nesekurové: vývojár sa dostane na server, kde by nemal byť.
DevOps si vyžaduje centralizované zhromažďovanie, spracovanie a analýzu logov.
Téma č. 10: Logovanie aplikácie s ELK
- Hlavné aplikácie a funkcie elastic (vyhľadávanie, úložisko, možnosti škálovania, flexibilita nastavenia)
- Prehľad kibana (hlavné funkcie, jazyk dotazov, správa dashboardov, vytváranie grafov)
- Prehľad produktov na báze elastic a ich aplikácia
- Zbierame metriky v APM (trasovanie aplikácií)
- Ďalšie: Prehľad nového produktu — SIEM
Implentácia tohto prístupu urobí z logov jednoduchý a zrozumiteľný nástroj na analýzu, nastavenie a ladenie aplikácií a infraštruktúry.
SRE
A dostávame sa k téme, ktorej sa Southbridge len obzerá a kvôli ktorej ostatní rečníci chcú ostať na posledný deň Slérma. Sme radi, že ju bude čítať Ivan Kruglov z Booking.com.
Projekt žije v reálnom svete, kde spoľahlivosť nikdy nie je absolútna a každé rozhodnutie niečo stojí.
Čo je SLA vo vzťahu ku komplexnému projektu? Povedzme, ako hodnotiť, že stránka je dostupná, ale obrázky sa načítavajú so oneskorením. Aké sú metriky SLA, kde ich merať, ako ich merať?
Ako nastaviť SLA? Ako ich dodržať?
Téma č. 11: SRE
Definícia SLA, SLO, Error Budget a ďalšie strašné výrazy zo sveta SRE
SRE: Prax monitorovania SLI a SLO
SRE: Prax aplikácie Error Budget
SRE: Správa prerušenia a prevádzkovej záťaže (apigateway, service mesh, circuit breakers)
Biznis chce SRE. Aspoň na najjednoduchšej úrovni: zobrať zálohový server alebo ho obnoviť zo zálohy? Jedna databáza alebo cluster? Nainštalovať ochranu pred DDoS preventívne alebo až v čase útoku?
Riaditeľ nebude spokojný s rozprávaním, že „stránka funguje“, keď mu volá klient a hlási, že objednávkový formulár sa neotvára.
Preto je pre DevOps inžiniera dôležité aspoň povrchne rozumieť SRE, aby adekvátne komunikoval s biznisom o jeho potrebách.
Záver
Za čas administrátori a vývojári sa naučia:
— správne pracovať s Git;
— organizovať lokálny vývoj;
— nastavovať (administrátori) a používať (vývojári) CI/CD;
— pracovať s infraštruktúrou ako s kódom;
— testovať infraštruktúru;
— monitorovať infraštruktúru a aplikáciu;
— nastavovať logovanie;
— rozumieť, a v ideálnom prípade — používať SRE.
Pre pozorných čitateľov — s promokódom habrapost zľava 15%.
Na všetkých bodoch pripravujeme prax a nástroje. Takže každý účastník po návrate zo Slyermu bude schopný posunúť svoju spoločnosť na vyššiu úroveň DevOps.
Pre podniky to znamená zníženie nákladov na administráciu a vývoj, zníženie prestojov, zvýšenie spoľahlivosti, rýchlejšie dodanie funkcií a odstraňovanie chýb.
Zdroj: habr.com
