

V Badoo neustále monitorujeme nové technológie a posudzujeme, či ich stojí za to zaviesť do nášho systému. Chceme sa s komunitou podeliť o jedno z takýchto výskumov, ktoré je venované Loki – systému na agregáciu logov.
Loki je riešenie na uchovávanie a prezeranie logov, navyše tento stack poskytuje flexibilný systém na analýzu a odosielanie dát do Prometheus. V máji vyšla ďalšia aktualizácia, ktorú aktívne propagujú tvorcovia. Zaujímalo nás, čo všetko Loki dokáže, aké možnosti ponúka a do akej miery môže byť alternatívou k ELK – stacku, ktorý aktuálne používame.
Čo je Loki
Grafana Loki je súbor komponentov pre kompletný systém práce s logmi. Na rozdiel od iných podobných systémov je Loki založený na myšlienke indexovať iba metaúdaje logov – etikety (rovnako ako v Prometheus), pričom samotné logy sa komprimujú vedľa do samostatných kusov.
,
Predtým, ako prejdeme k popisu toho, čo je možné robiť pomocou Loki, chcem objasniť, čo sa myslí pod „myšlienkou indexovať iba metaúdaje“. Porovnajme prístup Loki a prístup k indexovaniu v tradičných riešeniach, ako je Elasticsearch, na príklade riadku z logu nginx:
172.19.0.4 - - [01/Jun/2020:12:05:03 +0000] "GET /purchase?user_id=75146478&item_id=34234 HTTP/1.1" 500 8102 "-" "Stub_Bot/3.0" "0.001"Tradičné systémy analyzujú riadok ako celok, vrátane polí s množstvom unikátnych hodnôt user_id a item_id, a ukladajú všetko do veľkých indexov. Výhodou takéhoto prístupu je, že môžete rýchlo vykonávať zložité dotazy, pretože takmer všetky dáta sú v indexe. Avšak to si vyžaduje, aby index bol veľký, čo vedie k nárokom na pamäť. Nakoniec je fulltextový index logov porovnateľný veľkosťou s logmi samotnými. Aby ste mohli rýchlo vyhľadávať, musí byť index načítaný do pamäte. A čím viac logov je, tým rýchlejšie index rastie a tým viac pamäte spotrebováva.
Prístup Loki vyžaduje, aby sa zo zdroja získali iba nevyhnutné údaje, ktorých počet je malý. Takto získavame malý index a môžeme hľadať údaje, filtrovať ich podľa času a indexovaných polí a potom skenovať zvyšok pomocou regulárnych výrazov alebo vyhľadávaním podreťazca. Proces sa nezdá byť najrýchlejší, ale Loki rozdeľuje dotazy na niekoľko častí a vykonáva ich paralelne, spracovávajúc veľké množstvo údajov za krátky čas. Počet shardov a paralelných dotazov v nich sa dá konfigurovať; takto množstvo údajov, ktoré možno spracovať za jednotku času, lineárne závisí od množstva poskytnutých zdrojov.
Tento kompromis medzi veľkým rýchlym indexom a malým indexom s paralelným úplným prehľadávaním umožňuje Loki kontrolovať náklady systému. Ten sa dá flexibilne nastaviť a rozšíriť podľa potrieb.
Loki stack pozostáva z troch komponentov: Promtail, Loki, Grafana. Promtail zhromažďuje logy, spracováva ich a posiela do Loki. Loki ich uchováva. A Grafana vie žiadať údaje z Loki a zobrazuje ich. V skutočnosti sa Loki môže použiť nielen na uchovávanie logov a vyhľadávanie v nich. Celý stack poskytuje veľké možnosti spracovania a analýzy prichádzajúcich údajov pomocou prístupu Prometheus.
Popis procesu inštalácie sa dá nájsť .
Vyhľadávanie v logoch
Vyhľadávanie v logoch sa dá uskutočniť v špeciálnom rozhraní Grafana — Explorer. Na dotazy sa používa jazyk LogQL, ktorý je veľmi podobný PromQL používanému v Prometheovi. V princípe sa dá považovať za distribuovaný grep.
Rozhranie vyhľadávania vyzerá takto:
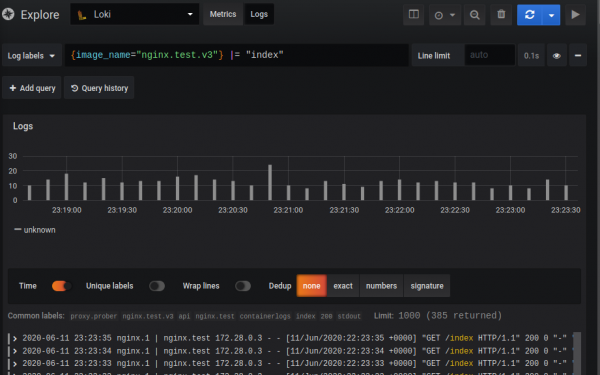
Samotný dotaz pozostáva z dvoch častí: selector a filter. Selector je vyhľadávanie podľa indexovaných metadát (štítkov), ktoré sú priradené logom, a filter je vyhľadávací reťazec alebo regex, pomocou ktorého sa filtrujú záznamy určené selektorom. V uvedenom príklade: V zložených zátvorkách je selektor, všetko po ňom — filter.
{image_name="nginx.promtail.test"} |= "index"Z dôvodu fungovania Loki nie je možné robiť dotazy bez selektora, ale štítky môžu byť akokoľvek široké.
Selektor je key-value hodnoty vo zložených zátvorkách. Môžete kombinovať selektory a nastavovať rôzne podmienky vyhľadávania, pričom používate operátory =, != alebo regulárne výrazy:
{instance=~"kafka-[23]",name!="kafka-dev"}
// Nájde logy s označením instance, ktoré majú hodnoty kafka-2, kafka-3, a vylúči dev
Filter je text alebo regulárny výraz, ktorý vyfiltruje všetky dáta získané selektorom.
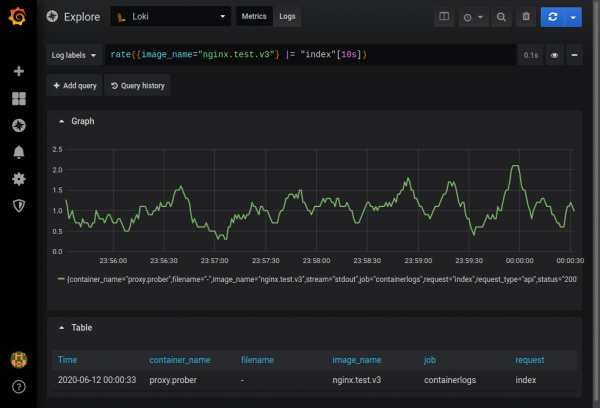
Existuje možnosť získať ad-hoc grafy z prijatých dát v režime metrics. Napríklad je možné zistiť frekvenciu výskytu v logoch nginx záznamu obsahujúceho reťazec index:
Úplný popis možností nájdete v dokumentácii .
Parsing logov
Existuje niekoľko spôsobov, ako zhromaždiť logy:
- Pomocou Promtail, štandardnej zložky v stacku na zhromažďovanie logov.
- Priamo z docker kontajnera pomocou
- Použiť Fluentd alebo Fluent Bit, ktoré dokážu zasielať dáta do Loki. Na rozdiel od Promtail majú pripravené parsery takmer pre akýkoľvek typ logu a zvládajú aj multiline logy.
Zvyčajne sa na parsing používa Promtail. Robí tri veci:
- Nájde zdroje dát.
- Pripája k nim označenia.
- Zasiela dáta do Loki.
V súčasnosti môže Promtail čítať logy z lokálnych súborov a zo systemd journal. Musí byť nainštalovaný na každom počítači, z ktorého sa zhromažďujú logy.
Existuje integrácia s Kubernetes: Promtail automaticky cez Kubernetes REST API zisťuje stav klastra a zhromažďuje logy z nody, služby alebo podu, pričom okamžite pripojuje označenia na základe metadát z Kubernetes (názov podu, názov súboru a pod.).
Označenia je tiež možné pripojiť na základe dát z logu pomocou Pipeline. Pipeline Promtail môže pozostávať zo štyroch typov etáp. Podrobnejšie — v , tu zároveň poznamenám niektoré nuansy.
- Parsing stages. Toto je etapa RegEx a JSON. V tomto štádiu vyťažujeme dáta z logov do tzv. extracted map. Dáta je možné vyťažovať z JSON jednoducho kopírovaním potrebných polí do extracted map, alebo prostredníctvom regulárnych výrazov (RegEx), kde sa v extracted map „mapujú“ named groups. Extracted map predstavuje key-value úložisko, kde key je názov poľa a value je jeho hodnota z logov.
- Transform stages. Táto etapa má dve možnosti: transform, kde zadávame pravidlá transformácie, a source — zdroj dát na transformáciu z extracted map. Ak v extracted map také pole nie je, bude vytvorené. Takto je možné vytvárať označenia, ktoré nie sú založené na extracted map. V tomto štádiu môžeme manipulovať s dátami v extracted map, pričom používame dosť výkonný . Okrem toho je potrebné pamätať na to, že extracted map sa úplne načíta počas spracovania, čo umožňuje napríklad kontrolovať hodnotu v nej: “{{if .tag}tag value exists{end}}”. Šablóna podporuje podmienky, cykly a niektoré funkcie pre reťazce, ako Replace a Trim.
- Fázy akcie. V tejto fáze môžete niečo urobiť s vytiahnutými dátami:
- Vytvoriť štítok z extracted data, ktorý bude indexovaný v Loki.
- Zmeniť alebo nastaviť čas udalosti z logu.
- Zmeniť dáta (text logu), ktoré pôjdu do Loki.
- Vytvoriť metriky.
- Fázy filtrovania. Fáza match, v ktorej môžete buď odoslať do /dev/null záznamy, ktoré nepotrebujeme, alebo ich nasmerovať na ďalšie spracovanie.
Ukážem na príklade spracovania bežných nginx logov, ako možno spracovávať logy pomocou Promtail.
Na testovanie zoberieme modifikovaný obraz nginx jwilder/nginx-proxy:alpine ako nginx-proxy a malého démona, ktorý vie sám seba pýtať cez HTTP. Démone sú priradené rôzne koncové body, na ktoré môže dávať odpovede rôznej veľkosti, s rôznymi HTTP statusmi a rôznymi oneskoreniami.
Logy budeme zbierať z Docker kontajnerov, ktoré nájdeme na ceste /var/lib/docker/containers// -json.log
V docker-compose.yml nastavíme Promtail a špecifikujeme cestu k konfigurácii:
promtail:
  image: grafana/promtail:1.4.1
 // ...
 volumes:
   - /var/lib/docker/containers:/var/lib/docker/containers:ro
   - promtail-data:/var/lib/promtail/positions
   - ${PWD}/promtail/docker.yml:/etc/promtail/promtail.yml
 command:
   - '-config.file=/etc/promtail/promtail.yml'
 // ...
Pridávame do promtail.yml cestu k logom (v konfigurácii je možnosť "docker", ktorá robí to isté jedným riadkom, ale nebolo by to také prehľadné):
scrape_configs:
 - job_name: containers

   static_configs:
       labels:
         job: containerlogs
         __path__: /var/lib/docker/containers/*/*log  # len pre linux
Po zapnutí takejto konfigurácie sa do Loki dostanú logy zo všetkých kontajnerov. Aby sme tomu predišli, zmeníme konfiguráciu testovacieho nginx v docker-compose.yml – pridáme logovanie pole tag:
proxy:
 image: nginx.test.v3
//…
 logging:
   driver: "json-file"
   options:
     tag: "{{.ImageName}}|{{.Name}}"
Upravíme promtail.yml a nastavíme Pipeline. Na vstup prichádzajú logy nasledujúcej podoby:
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] \"GET /api/index HTTP/1.1\" 200 0 \"-\" \"Stub_Bot/0.1\" \"0.096\"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.66740443Z"}
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] \"GET /200 HTTP/1.1\" 200 0 \"-\" \"Stub_Bot/0.1\" \"0.000\"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.702925272Z"}
Fáza pipeline:
 - json:
     expressions:
       stream: stream
       attrs: attrs
       tag: attrs.tag
Extrahujeme z prichádzajúceho JSON poľa stream, attrs, attrs.tag (ak existujú) a ukladáme ich do extracted map.
 - regex:
     expression: ^(?P([^|]+))|(?P([^|]+))$
     source: "tag"
Ak sa podarilo uložiť pole tag do extracted map, extrahujeme pomocou regexu mená obrazov a kontajnerov.
 - labels:
     image_name:
     container_name:
Priraďujeme labely. Ak sa v extracted data nájdu kľúče image_name a container_name, ich hodnoty budú priradené k príslušným labelom.
 - match:
     selector: '{job="docker",container_name="",image_name=""}'
     action: drop
Zahadzujeme všetky logy, v ktorých neboli zistené nastavené labely image_name a container_name.
  - match:
     selector: '{image_name="nginx.promtail.test"}'
     stages:
       - json:
           expressions:
             row: log
Pre všetky logy, kde image_name je nginx.promtail.test, extrahujeme z pôvodného logu pole log a ukládame ho do extracted map pod kľúčom row.
  - regex:
         # potlačiť farby forego
         expression: .+nginx.+|.+[0m(?P[a-z_.-]+) +(?P.+)
         source: logrow
Čistíme vstupný reťazec pomocou regulárnych výrazov a vyťahujeme nginx virtuálny host a logový riadok nginx.
     - regex:
         source: nginxlog
         expression: ^(?P[w.]+) - (?P[^ ]*) [(?P[^ ]+).*] "(?P[^ ]*) (?P[^ ]*) (?P[^ ]*)" (?P[d]+) (?P[d]+) "(?P[^"]*)" "(?P[^"]*)"( "(?P[d.]+)")?
Parsujeme nginx log pomocou regulárnych výrazov.
    - regex:
           source: request_url
           expression: ^.+.(?Pjpg|jpeg|gif|png|ico|css|zip|tgz|gz|rar|bz2|pdf|txt|tar|wav|bmp|rtf|js|flv|swf|html|htm)$
     - regex:
           source: request_url
           expression: ^/photo/(?P[^/?.]+).*$
       - regex:
           source: request_url
           expression: ^/api/(?P[^/?.]+).*$
Analyzujeme request_url. Pomocou regexu určíme účel požiadavky: na statiku, fotky, API a nastavíme v extracted map príslušný kľúč.
       - template:
           source: request_type
           template: "{{if .photo}}photo{{else if .static_type}}static{{else if .api_request}}api{{else}}other{{end}}"
Pomocou podmienečných operátorov v Template kontrolujeme nastavené polia v extracted map a nastavujeme pre pole request_type potrebné hodnoty: photo, static, API. Priraďujeme other, ak sa to nepodarí. Teraz request_type obsahuje typ požiadavky.
       - labels:
           api_request:
           virtual_host:
           request_type:
           status:
Nastavujeme labely api_request, virtual_host, request_type a status (HTTP status) na základe toho, čo sa podarilo uložiť do extracted map.
       - output:
           source: nginx_log_row
Meníme output. Teraz do Loki odchádza vyčistený nginx log z extracted map.
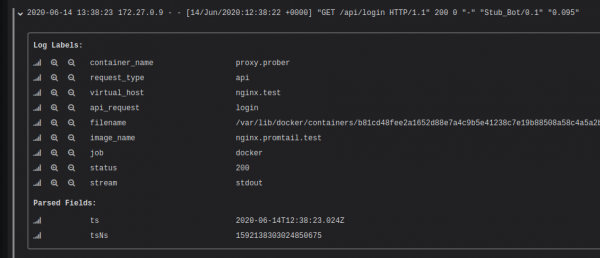
Po spustení uvedenej konfigurácie môžete vidieť, že každej položke boli priradené štítky na základe údajov z logu.
Je potrebné mať na pamäti, že extrahovanie značiek s veľkým počtom hodnôt (kardinalita) môže výrazne spomaliť prácu Loki. To znamená, že je nevhodné umiestňovať do indexu napríklad user_id. Viac o tom si prečítajte v článku „“. Ale to neznamená, že sa nedá vyhľadávať podľa user_id bez indexov. Je potrebné použiť filtre pri vyhľadávaní („grepovať“ údaje), pričom index tu slúži ako identifikátor toku.
Vizualizácia logov
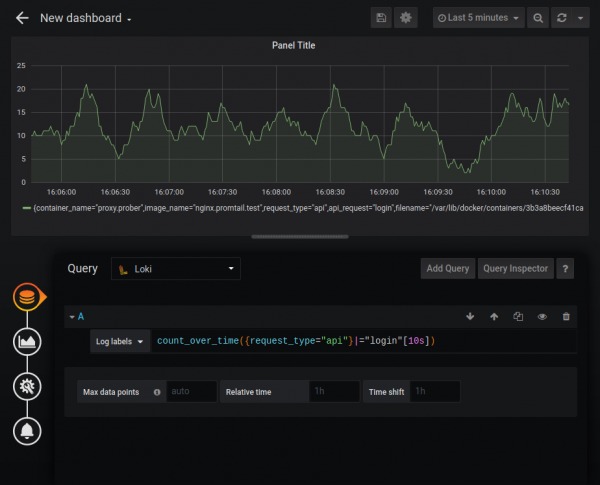
Loki môže fungovať ako zdroj dát pre grafy Grafana, používajúc LogQL. Podporujú sa nasledujúce funkcie:
- rate — počet záznamov za sekundu;
- count over time — počet záznamov v stanovenom rozsahu.
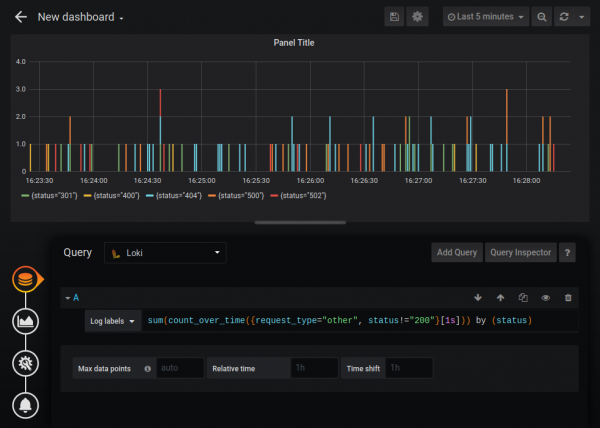
Okrem toho sú k dispozícii agregujúce funkcie Sum, Avg a ďalšie. Môžete zostaviť pomerne zložité grafy, napríklad graf počtu HTTP chýb:
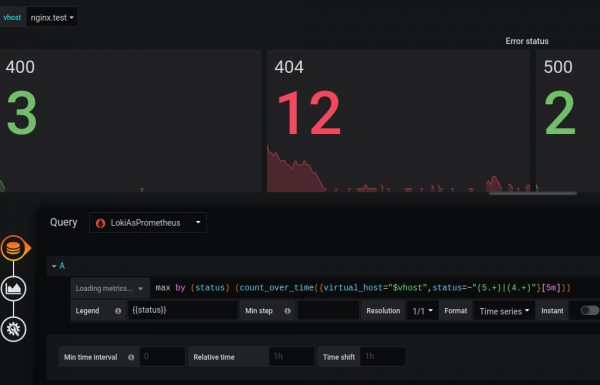
Štandardný data source Loki je funkčne obmedzený v porovnaní s data source Prometheus (napríklad nie je možné zmeniť legendu), ale Loki je možné pripojiť ako zdroj s typom Prometheus. Nie som si istý, či je to zdokumentované správanie, ale podľa odpovede vývojárov „“, napríklad, to je celkom legitímne a Loki je plne kompatibilný s PromQL.
Pridávame Loki ako data source s typom Prometheus a dopisujeme URL /loki:

A môžeme robiť grafy tak, ako by sme pracovali s metrikami z Prometheus:
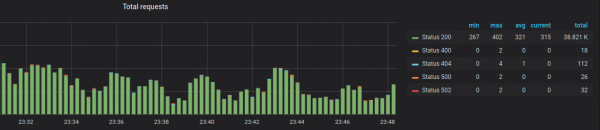
Myslím, že rozdiel vo funkčnosti je dočasný a vývojári to v budúcnosti opravia.
Metódy
V Loki je dostupná možnosť extrahovania číselných metrik z logov a odosielanie ich do Prometheus. Napríklad v logu nginx sa nachádza počet bajtov v odpovedi, ako aj, pri určitej modifikácii štandardného formátu logu, aj čas v sekundách, ktorý bol potrebný na odpoveď. Tieto údaje je možné extrahovať a odoslať do Prometheus.
Pridávame ešte jednu sekciu do promtail.yml:
- match:
   selector: '{request_type="api"}'
   stages:
     - metrics:
         http_nginx_response_time:
           type: Histogram
           description: "čas odpovede ms"
           source: response_time
           config:
             buckets: [0.010,0.050,0.100,0.200,0.500,1.0]
- match:
   selector: '{request_type=~"static|photo"}'
   stages:
     - metrics:
         http_nginx_response_bytes_sum:
           type: Counter
           description: "súčet bajtov odpovede"
           source: bytes_out
           config:
             action: add
         http_nginx_response_bytes_count:
           type: Counter
           description: "počet bajtov odpovede"
           source: bytes_out
           config:
             action: inc
Toto nastavenie umožňuje definovať a aktualizovať metriky na základe údajov z extracted map. Tieto metriky nie sú zasielané do Loki — objavujú sa v Promtail /metrics endpoint. Prometheus musí byť nakonfigurovaný tak, aby prijímal údaje generované v tejto fáze. V uvedenom príklade so request_type="api" zhromažďujeme histogramovú metriku. S týmto typom metrík je pohodlné získať percentily. Pre statické súbory a fotografie zhromažďujeme súčet bajtov a počet riadkov, v ktorých sme získali bajty, aby sme vypočítali priemernú hodnotu.
Podrobnejšie informácie o metrikách si prečítajte .
Otvárame port na Promtail:
promtail:
     image: grafana/promtail:1.4.1
     container_name: monitoring.promtail
     expose:
       - 9080
     ports:
       - "9080:9080"
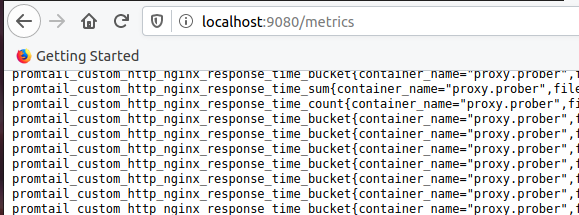
Ubezpečujeme sa, že metriky s prefixom promtail_custom sa objavili:
Nastavujeme Prometheus. Pridávame job promtail:
- job_name: 'promtail'
 scrape_interval: 10s
 static_configs:
   - targets: ['promtail:9080']
A nakreslíme graf:
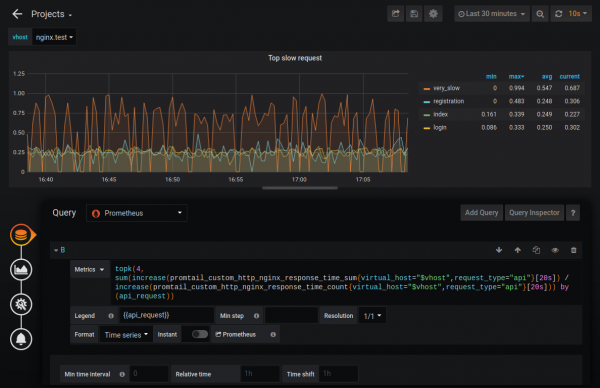
Takto môžeme zistiť napríklad štyri najpomalšie požiadavky. Na tieto metriky je možné tiež nastaviť monitoring.
Škálovanie
Loki môže byť v jedinom režime (single binary mode) alebo v shardovateľnom (horizontally-scalable mode). V druhom prípade môže ukladať údaje do cloudu, pričom chunk a index sú uložené oddelene. Vo verzii 1.5 bola implementovaná možnosť ukladať na jedno miesto, no zatiaľ sa neodporúča používať ju v produkcii.
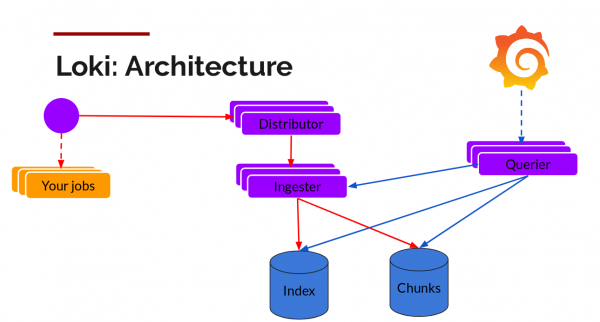
Chunky je možné ukladať do S3-kompatibilného úložiska, pre uloženie indexov je možné využiť horizontálne škálovateľné databázy: Cassandra, BigTable alebo DynamoDB. Iné časti Loki — Distributors (pre zápis) a Querier (pre dotazy) — sú stateless a tiež sa horizontálne škálujú.
Na konferencii DevOpsDays Vancouver 2019 jeden z účastníkov Callum Styan uviedol, že s Lokim jeho projekt má petabajty logov s indexom menej než 1% z celkovej veľkosti: “”.
Porovnanie Loki a ELK
Veľkosť indexu
Na testovanie veľkosti indexu som vzal logy z kontajnera nginx, pre ktorý bol nastavený pipeline uvedený vyššie. Súbor s logmi obsahoval 406 624 riadkov s celkovým objemom 109 MB. Logy sa generovali počas hodiny, približne 100 záznamov za sekundu.
Príklad dvoch riadkov z logu:
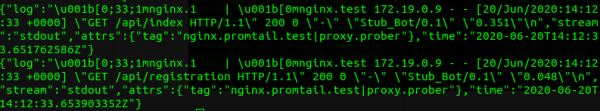
Pri indexácii ELK to dalo veľkosť indexu 30,3 MB:
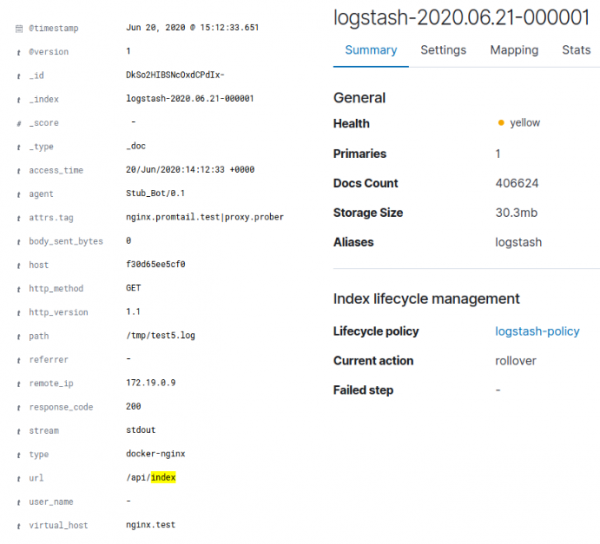
V prípade Loki to dalo približne 128 kB indexu a asi 3,8 MB dát v pravidlách. Je potrebné poznamenať, že log bol umelo generovaný a nemal veľkú rozmanitosť dát. Jednoduché gzip na pôvodnom dockerskom JSON logu s dátami dalo kompresiu 95,4 %, a s ohľadom na to, že do samotného Loki sa posielal iba vyčistený nginx log, tak zmrštenie na 4 MB je vysvetliteľné. Celkový počet jedinečných hodnôt pre štítky Loki bol 35, čo vysvetľuje malú veľkosť indexu. Pre ELK sa log tiež vyčistil. Takže Loki zmrštil pôvodné dáta o 96 %, zatiaľ čo ELK o 70 %.
Spotreba pamäte
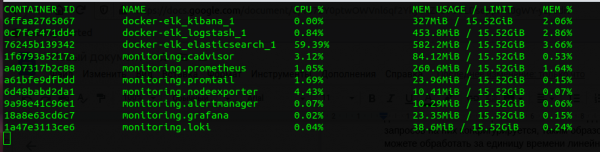
Ak porovnáme celý stack Prometheus a ELK, Loki "je" niekoľkonásobne menej. Je jasné, že služba naprogramovaná v Go spotrebuje menej ako služba na Java, a porovnanie veľkosti JVM Heap Elasticsearch a vyhradenej pamäte pre Loki nie je fér, ale aj tak stojí za zmienku, že Loki používa oveľa menej pamäte. Jeho výhoda v CPU nie je taká zrejmá, ale tiež existuje.
Rýchlosť
Loki rýchlejšie "konzumuje" logy. Rýchlosť závisí od mnohých faktorov — aké logy sú, ako rafinovane ich parsonujeme, sieť, disk atď. — ale je určite vyššia ako v ELK (v mojom teste asi dvakrát). Toto sa vysvetľuje tým, že Loki ukladá oveľa menej dát do indexu a samozrejme trávi menej času indexovaním. Pri rýchlosti vyhľadávania je situácia opačná: Loki citeľne spomaľuje pri dátach väčších ako niekoľko gigabajtov, zatiaľ čo ELK má rýchlosť vyhľadávania nezávislú od veľkosti dát.
Vyhľadávanie v logoch
Loki podstatne zaostáva za ELK pokiaľ ide o možnosti vyhľadávania v logoch. Grep s regulárnymi výrazmi je silná vec, ale zaostáva za plnohodnotnou databázou. Nedostatok range dopytov, agregácia iba na základe štítkov, nemožnosť vyhľadávať bez štítkov — to všetko nás obmedzuje v hľadaní zaujímavých informácií v Loki. To neznamená, že pomocou Loki nemožno nič nájsť, ale určuje spôsob práce s logmi, kde najprv nájdete problém na graficoch Prometheus a potom podľa týchto štítkov hľadáte, čo sa stalo v logoch.
Rozhranie
Prvýkrát, je to pekné (prepáčte, nemohol som sa zdržať). Grafana má príjemné používateľské rozhranie, ale Kibana je oveľa funkčnejšia.
Plusy a mínusy Loki
Medzi výhody patrí, že Loki sa integruje s Prometheus, a preto získavame metriky a alerty priamo z krabice. Je pohodlný na zber logov a ich uchovávanie z Kubernetes Pods, keďže má v sebe zdedené od Prometheus zisťovanie služieb a automaticky pridáva štítky.
Medzi nevýhody patrí slabá dokumentácia. Niektoré veci, ako napríklad vlastnosti a možnosti Promtail, som objavil iba počas štúdia kódu, našťastie je open-source. Ďalšou nevýhodou sú slabé možnosti parsovania. Napríklad, Loki nevie spracovávať multiline logy. Ďalšími nedostatkami sú, že Loki je relatívne mladá technológia (verzia 1.0 bola uvoľnená v novembri 2019).
Záver
Loki je na 100 % zaujímavá technológia, ktorá je vhodná pre malé a stredné projekty, umožňuje riešiť množstvo úloh agregovania logov, vyhľadávania v logoch, monitorovania a analýzy logov.
V Badoo nepoužívame Loki, pretože máme ELK stack, ktorý nám vyhovuje a s ktorým sme za mnohé roky vybudovali rôzne vlastné riešenia. Pre nás je problémom vyhľadávanie v logoch. S takmer 100 GB logov denne je pre nás dôležité vedieť nájsť všetko a o niečo viac a robiť to rýchlo. Na vytváranie grafov a monitorovanie používame iné riešenia, ktoré sú prispôsobené našim potrebám a sú medzi sebou integrované. Loki stack má značné výhody, ale neposkytne nám viac, než už máme, a jeho výhody určite neprekonajú náklady na migráciu.
Aj keď po prieskume bolo jasné, že nemôžeme používať Loki, dúfame, že tento príspevok vám pomôže pri výbere.
Repozitár s kódom použitým v článku sa nachádza .
Zdroj: habr.com
