

Štruktúrovanie nestruktúrovaných údajov pomocou GROK
Ak používate Elastic stack (ELK) a máte záujem o mapovanie používateľských denníkov Logstash na Elasticsearch, tento príspevok je pre vás.
Zostava ELK je skratka pre tri projekty s otvoreným zdrojom: Elasticsearch, Logstash a Kibana. Spoločne tvoria platformu na správu denníkov.
- Elasticsearch – je vyhľadávací a analytický systém.
- Logstash – je serverový spracovateľský pipeline, ktorý súčasne prijíma údaje z viacerých zdrojov, transformuje ich a potom ich odosiela do "skladu", napríklad Elasticsearch.
- Kibana umožňuje používateľom vizualizovať údaje prostredníctvom grafov a diagramov v Elasticsearch.
Beats sa objavil neskôr a je to ľahký agent na prenos údajov. Zavedenie Beats transformovalo ELK stack na Elastic stack, ale to nie je hlavné.
Tento článok je venovaný Grok, funkcii v Logstash, ktorá dokáže transformovať vaše denníky pred ich odoslaním do skladu. Pre naše účely sa budem zaoberať len spracovaním údajov z Logstash do Elasticsearch.
Grok je filter v Logstash, ktorý sa používa na rozobranie nestruktúrovaných údajov na niečo štruktúrované a dotazovateľné. Je založený na regulárnych výrazoch (regex) a používa textové šablóny na porovnávanie riadkov v denníkoch.
Ako uvidíme v nasledujúcich častiach, používanie Grok má veľký význam, pokiaľ ide o efektívne spravovanie denníkov.
Bez Grok sú vaše údaje denníka nestruktúrované.
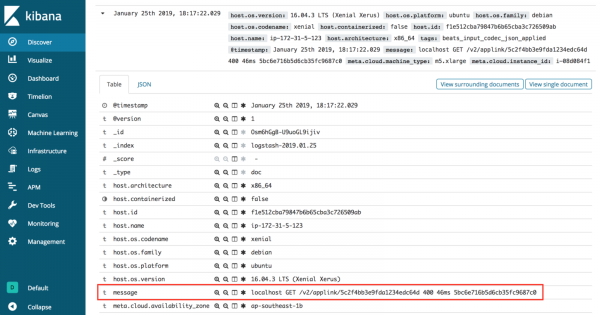
Bez Grok, keď sa denníky odosielajú z Logstash do Elasticsearch a vizualizujú v Kibana, zobrazujú sa iba ako hodnoty správ.
Získanie relevantných informácií v tejto situácii je obtiažne, pretože všetky údaje denníka sú uložené v jednom kľúči. Bolo by lepšie, keby boli denníkové správy lepšie organizované.
Nestruktúrované údaje z logov
localhost GET /v2/applink/5c2f4bb3e9fda1234edc64d 400 46ms 5bc6e716b5d6cb35fc9687c0Ak sa pozriete na surové údaje, uvidíte, že sa v skutočnosti skladajú z rôznych častí, z ktorých každá je oddelená medzerou.
Pre skúsenejších vývojárov pravdepodobne dokážete uhádnuť, čo znamená každá z týchto častí a že toto je denník správy z API. Zobrazenie každej položky je uvedené nižšie.
Štruktúrovaný pohľad našich údajov
- localhost == prostredie
- GET == metóda
- /v2/applink/5c2f4bb3e9fda1234edc64d == url
- 400 == stav_odpovede
- 46ms == čas_odpovede
- 5bc6e716b5d6cb35fc9687c0 == užívateľské_id
Ako vidíme v štruktúrovaných dátach, existuje poradie pre neštruktúrované záznamy. Ďalším krokom je programové spracovanie surových dát. Tu sa Grok ukazuje v najlepšom svetle.
Šablóny Grok
Logstash prichádza s viac ako 100 vstavanými šablónami na štruktúrovanie neštruktúrovaných dát. Určite by ste mali využiť túto výhodu, keď je to možné pre bežné systémové záznamy, ako sú apache, linux, haproxy, aws a tak ďalej.
Avšak, čo sa stane, keď máte používateľské záznamy, ako v uvedenom príklade? Musíte si vytvoriť vlastnú šablónu Grok.
Vlastné šablóny Grok
Musíte sa pokúsiť vytvoriť vlastnú šablónu Grok. Použil som
Grok Debugger a .
%{SYNTAX:SEMANTIC} Prvá vec, ktorú som sa pokúsil urobiť, bolo prejsť na kartu
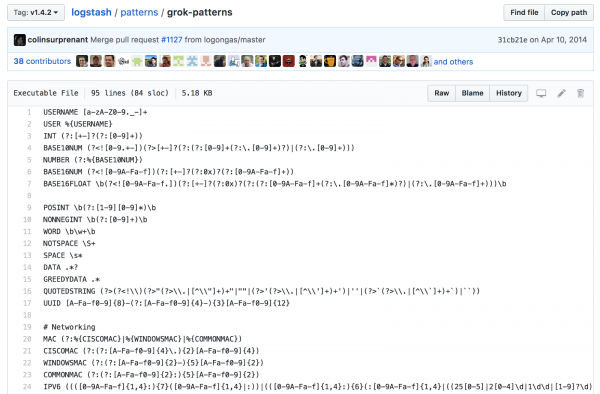
Discover v debuggere Grok. Myslel som si, že by bolo skvelé, ak by tento nástroj mohol automaticky generovať šablónu Grok, ale nebolo to príliš užitočné, pretože našiel iba dve zhody. Využívajúc tento objav, začal som vytvárať svoju vlastnú šablónu v debuggere Grok, pomocou syntaxu nájdeného na stránke Github Elastic.
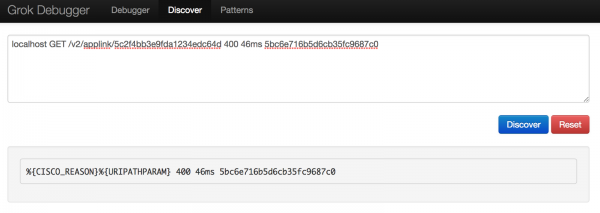
Hraním s rôznymi syntaktickými tvarmi som sa nakoniec podarilo štruktúrovať dáta záznamu tak, ako som chcel.
Odkaz na debugger Grok
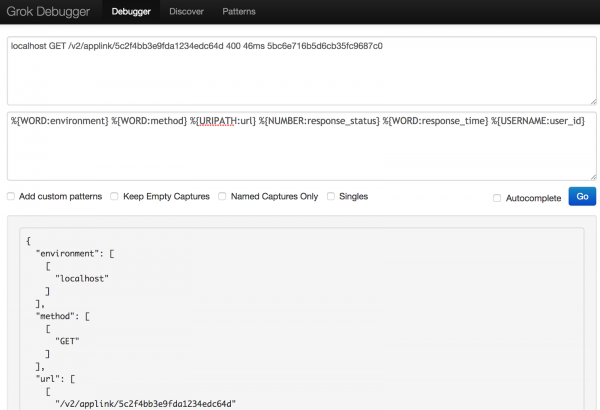
Zdrovy text:
Pattern:
localhost GET /v2/applink/5c2f4bb3e9fda1234edc64d 400 46ms 5bc6e716b5d6cb35fc9687c0%{WORD:environment} %{WORD:method} %{URIPATH:url} %{NUMBER:response_status} %{WORD:response_time} %{USERNAME:user_id}
To, čo sa na konci podarilo{ "environment": [ [ "localhost" ] ], "method": [ [ "GET" ] ], "url": [ [ "/v2/applink/5c2f4bb3e9fda1234edc64d" ] ], "response_status": [ [ "400" ] ], "BASE10NUM": [ [ "400" ] ], "response_time": [ [ "46ms" ] ], "user_id": [ [ "5bc6e716b5d6cb35fc9687c0" ] ] }
Majúc v rukách šablónu Grok a zmapované dáta, posledný krok je pridať ju do Logstash.Aktualizácia konfiguračného súboru Logstash.conf
Na serveri, na ktorom ste nainštalovali stack ELK, prejdite ku konfigurácii Logstash:
sudo vi /etc/logstash/conf.d/logstash.conf
Vložte zmeny.input { file { path => "/your_logs/*.log" } } filter{ grok { match => { "message" => "%{WORD:environment} %{WORD:method} %{URIPATH:url} %{NUMBER:response_status} %{WORD:response_time} %{USERNAME:user_id}"} } } output { elasticsearch { hosts => [ "localhost:9200" ] } }
input {
  file {
    path => "/your_logs/*.log"
  }
}
filter{
  grok {
    match => { "message" => "%{WORD:environment} %{WORD:method} %{URIPATH:url} %{NUMBER:response_status} %{WORD:response_time} %{USERNAME:user_id}"}
  }
}
output {
  elasticsearch {
    hosts => [ "localhost:9200" ]
  }
}
Po uložení zmien reštartujte Logstash a skontrolujte jeho stav, aby ste sa uistili, že stále funguje.
sudo service logstash restart
sudo service logstash status
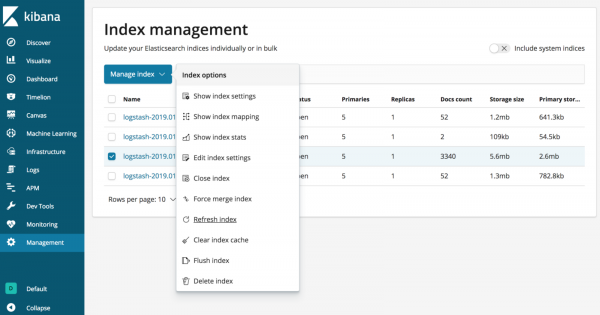
Nakoniec, aby ste sa uistili, že zmeny nadobudli účinnosť, nezabudnite aktualizovať index Elasticsearch pre Logstash v Kibane!
S Grok sú vaše dáta z logov štruktúrované!
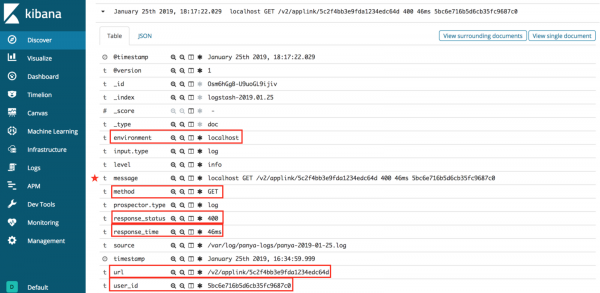
Ako vidíme na obrázku vyššie, Grok dokáže automaticky mapovať dáta protokolu na Elasticsearch. To uľahčuje správu protokolov a rýchle vyhľadávanie informácií. Namiesto toho, aby ste prehľadávali súbory protokolov kvôli ladení, môžete jednoducho filtrovať to, čo hľadáte, ako napríklad prostredie alebo url adresu.
Skúste dať Grok expressions šancu! Ak máte iný spôsob, ako to urobiť, alebo máte nejaké problémy s vyššie uvedenými príkladmi, jednoducho napíšte komentár nižšie, aby ste ma o tom informovali.
Ďakujem za čítanie — a, prosím, sledujte ma tu na Medium pre ďalšie zaujímavé články o softvérovom inžinierstve!
Zdroje
P.S
Telegramový kanál o
Zdroj: habr.com
