

Ahojte! Volám sa Kirill, som CTO v Adapty. Väčšina našej architektúry je na AWS a dnes vám ukážem, ako sme znížili náklady na servery trikrát vďaka využívaniu spotových inštancií v produkčnom prostredí a tiež, ako nastaviť ich automatické škálovanie. Najprv bude prehľad toho, ako to funguje, a potom podrobný návod na spustenie.
Čo sú to spotové inštancie?
inštancie sú servery iných používateľov AWS, ktoré práve teraz nevyužívajú, a predávajú ich s veľkou zľavou (Amazon píše až 90 %, z našich skúseností ~3x, variantné v závislosti od regiónu, AZ a typu inštancie). Ich hlavný rozdiel od bežných je, že sa môžu kedykoľvek vypnúť. Preto sme dlho považovali, že ich je v poriadku používať pre vývojové prostredia alebo pre úlohy na výpočet niečoho, pričom sa medzičasom uložia výsledky na S3 alebo do databáze, ale nie pre produkciu. Existujú externé riešenia, ktoré umožňujú používať spoty v produkcii, ale pre náš prípad je tam veľa obmedzení, a preto sme ich nezaviedli. Prístup opísaný v článku funguje úplne v rámci štandardných funkcií AWS, bez dodatočných skriptov, cronov a pod.
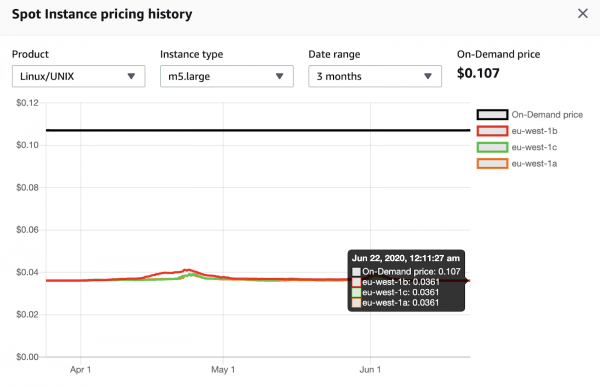
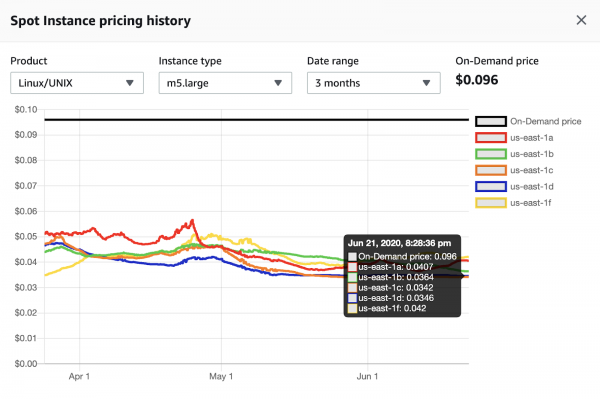
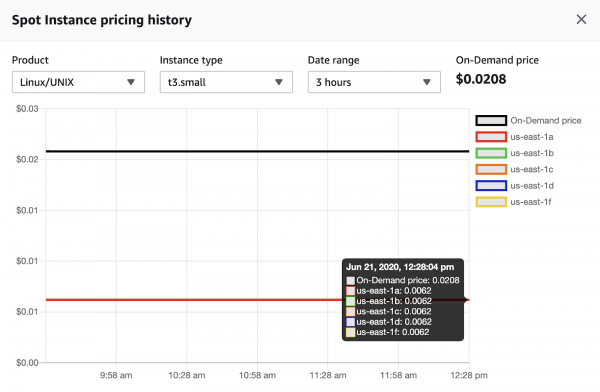
Ďalej prinášam niekoľko snímok obrazovky, ktoré ukazujú históriu cien spotových inštancií.
m5.large v regióne eu-west-1 (Írsko). Cena je prevažne stabilná počas 3 mesiacov, momentálne úspora 2.9x.
m5.large v regióne us-east-1 (Severná Virginia). Cena sa neustále mení počas 3 mesiacov, momentálne úspora od 2.3x do 2.8x v závislosti od dostupnostnej zóny.
t3.small v regióne us-east-1 (Severná Virginia). Cena je stabilná počas 3 mesiacov, momentálne úspora 3.4x.
Architektúra služby
Základná architektúra služby, o ktorej budeme hovoriť v rámci tohto článku, je znázornená na diagrame nižšie.
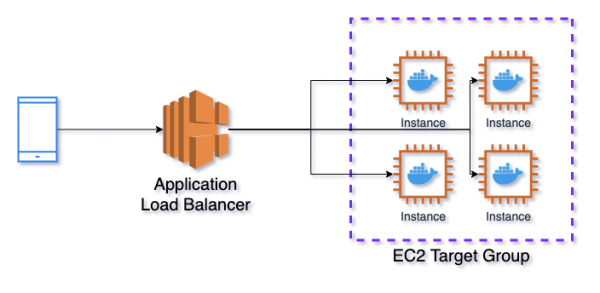
Application Load Balancer → EC2 Target Group → Elastic Container Service
Ako vyrovnávač zaťaženia sa používa Application Load Balancer (ALB), ktorý odosiela požiadavky do EC2 Target Group (TG). TG je zodpovedná za to, aby otvorila porty na inštanciách pre ALB a spojila ich s portami kontajnerov Elastic Container Service (ECS). ECS je ekvivalent Kubernetes v AWS, ktorý sa zaoberá správou Docker kontajnerov.
Na jednom inštanci môže byť niekoľko bežiacich kontajnerov s rovnakými portami, preto ich nemôžeme nastaviť pevne. ECS informuje TG, že spúšťa novú úlohu (v terminológii Kubernetes sa to nazýva pod), vykonáva kontrolu voľných portov na inštancii a priradí jeden z nich k spúšťanej úlohe. TG tiež pravidelne kontroluje, či je inštancia a API na nej funkčné pomocou health checku, a ak vidí nejaké problémy, prestane tam odosielať požiadavky.
EC2 Auto Scaling Groups + ECS Capacity Providers
Na uvedenej diagramu nie je zobrazená služba EC2 Auto Scaling Groups (ASG). Z názvu je jasné, že zodpovedá za škálovanie inštancií. Avšak do nedávna v AWS neexistovala vstavaná možnosť spravovať počet spustených strojov z ECS. ECS umožňoval škálovať počet úloh, napríklad na základe využitia CPU, RAM alebo počtu požiadaviek. Ak však úlohy vyčerpali všetky voľné inštancie, nové stroje sa automaticky nezvyšovali.
To sa zmenilo s príchodom ECS Capacity Providers (ECS CP). Teraz je možné každú službu v ECS prepojiť s ASG, a ak sa úlohy nezmestia na bežiacich inštanciách, nové sa spustia (ale v rámci nastavených limitov ASG). To funguje aj naopak, ak ECS CP vidí nečinné inštancie bez úloh, pošle ASG príkaz, aby ich vypnula. ECS CP má možnosť určiť cieľové percento zaťaženia inštancií, aby určité množstvo strojov bolo vždy voľné na rýchle škálovanie úloh, o tom poviem viac neskôr.
EC2 Launch Templates
Posledná služba, o ktorej poviem, predtým ako prejdeme k podrobnému popisu vytvorenia tejto infraštruktúry, sú EC2 Launch Templates. Umožňuje vytvoriť šablónu, na základe ktorej sa budú spúšťať všetky stroje, aby ste to nemuseli opakovať zakaždým od nuly. Tu si môžete vybrať typ spúšťanej mašiny, skupinu zabezpečenia, obraz disku a mnoho iných parametrov. Môžete tiež zadať používateľské údaje, ktoré budú nahrané na všetky spúšťané inštancie. V používateľských údajoch môžete spúšťať skripty, napríklad môžete upraviť obsah súboru .
Jedným z najdôležitejších parametrov konfigurácie v rámci tohto článku je =true. Ak je tento parametr povolený, keď ECS dostane signál o tom, že sa bere spottový inštanc, prevádza všetky úlohy, ktoré na ňom bežia, do stavu Draining. Žiadne nové úlohy nebudú priradené k tomuto inštancu, ak sú tu úlohy, ktoré sa práve chcú spustiť, budú zrušené. Žiadosti z vyrovnávacieho zariadenia tiež prestanú prichádzať. Oznámenie o odstránení inštancu prichádza 2 minúty pred skutočným udalosťou. Preto, ak váš servis nevykonáva úlohy dlhšie ako 2 minúty a nič na disk neukladá, môžete používať spottové inštancie bez straty dát.
Čo sa týka disku — AWS nedávno možnosť použiť Elastic File System (EFS) spolu s ECS, s touto schémou ani disk nie je prekážkou, ale to sme neskúšali, pretože v zásade disk nepotrebujeme na uchovávanie stavu. Po predvolenom nastavení po prijatí SIGINT (odoslané v momente prevodu úlohy do stavu Draining) budú všetky prebiehajúce úlohy zastavené za 30 sekúnd, aj keď sa nestihli dokončiť, tento čas je možné zmeniť pomocou parametra . Hlavné je, aby to nebolo nastavené na viac ako 2 minúty pre spottové stroje.
Vytvorenie služby
Prenikneme priamo k vytvoreniu popísanej služby. Počas procesu opíšem niekoľko užitočných bodov, ktoré neboli spomenuté vyššie. Všeobecne ide o krok za krokom návod, ale niektoré veľmi základné alebo naopak veľmi špecifické prípady nebudem zvažovať. Všetky činnosti sa vykonávajú vo vizuálnej konzole AWS, ale je možné ich reprodukovať programovo pomocou CloudFormation alebo Terraform. V Adapty používame Terraform.
Šablóna spustenia EC2
V tejto službe sa vytvára konfigurácia strojov, ktoré budú používané. Správa šablón sa deje v sekcii EC2 -> Instances -> Launch templates.
Obraz strojov Amazon (AMI) — uvádzame obraz disku, s ktorým budú spúšťané všetky inštancie. Pre ECS vo väčšine prípadov je dôležité použiť optimalizovaný obraz od Amazonu. Pravidelne sa aktualizuje a obsahuje všetko potrebné na prácu s ECS. Ak chcete zistiť aktuálne ID obrazu, navštívte stránku , vyberte používaný región a skopírujte AMI ID preň. Napríklad, pre región us-east-1 je aktuálne v čase písania článku ID — ami-00c7c1cf5bdc913ed. Toto ID je potrebné vložiť do bodu Určte vlastnú hodnotu.
Typ inštancie — vyberte typ inštancie. Zvoľte ten, ktorý najlepšie vyhovuje vašim potrebám.
Kľúčový pár (prihlásenie) — zadajte certifikát, pomocou ktorého sa môžete pripojiť k inštancii cez SSH, ak je to potrebné.
Nastavenia siete — zadajte parametre siete. Sieťová platforma vo väčšine prípadov by mala byť Virtual Private Cloud (VPC). Bezpečnostné skupiny — bezpečnostné skupiny pre vaše inštancie. Keďže budeme používať vyvažovač zaťaženia pred inštanciami, odporúčam uviesť sem skupinu, ktorá povoľuje prichádzajúce pripojenia len z vyvažovača. To znamená, že budete mať 2 bezpečnostné skupiny, jedna pre vyvažovač, ktorá povoľuje prichádzajúce (inbound) pripojenia zo všetkých adresov na portoch 80 (http) a 443 (https), a druhá pre stroje, ktorá povoľuje prichádzajúce pripojenia na akékoľvek porty zo skupiny vyvažovača. Odchádzajúce (outbound) pripojenia v oboch skupinách je potrebné otvoriť cez TCP protokol na všetky porty pre všetky adresy. Môžete obmedziť porty a adresy pre odchádzajúce pripojenia, ale potom musíte neustále monitorovať, že sa pokúšate pripojiť niekde na uzavretý port.
Úložisko (zväzky) — zadajte parametre diskov pre stroje. Veľkosť disku nemôže byť menšia ako tá, ktorá je zadaná v AMI, pre ECS optimalizované — 30 GiB.
Pokročilé podrobnosti — zadajte dodatočné parametre.
Možnosť nákupu — chceme kupovať sporadické inštancie. Chceme, ale túto možnosť tu nezaškrtneme, nastavíme to v Auto Scaling Group, tam je viac možností.
IAM profil inštancie — zadajte úlohu, s ktorou sa budú inštancie spúšťať. Aby inštancie fungovali v ECS, potrebujú práva, ktoré obvykle patria k úlohe ecsInstanceRole. V niektorých prípadoch môže byť vytvorená, ak nie, tak tu o tom, ako to urobiť. Po vytvorení ju uvádzate v šablóne.
Ďalej nasleduje veľa parametrov, vo väčšine prípadov môžete nechať predvolené hodnoty, ale každý z nich má zrozumiteľný popis. Vždy zapínam parametre EBS-optimized instance a T2/T3 Unlimited, ak sa používajú inštancie.
Údaje používateľa — zadajte používateľské údaje. Budeme upravovať súbor /etc/ecs/ecs.config, v ktorom je konfigurácia agenta ECS.
Príklad toho, ako môže vyzerať používateľský dátum:
#!/bin/bash
echo ECS_CLUSTER=DemoApiClusterProd >> /etc/ecs/ecs.config
echo ECS_ENABLE_SPOT_INSTANCE_DRAINING=true >> /etc/ecs/ecs.config
echo ECS_CONTAINER_STOP_TIMEOUT=1m >> /etc/ecs/ecs.config
echo ECS_ENGINE_AUTH_TYPE=docker >> /etc/ecs/ecs.config
echo "ECS_ENGINE_AUTH_DATA={"registry.gitlab.com":{"username":"username","password":"password"}}" >> /etc/ecs/ecs.config
ECS_CLUSTER=DemoApiClusterProd — parameter specifies that the instance belongs to a cluster with the specified name, meaning this cluster can host its tasks on this server. We haven't created a cluster yet, but we'll use this name when we do.
ECS_ENABLE_SPOT_INSTANCE_DRAINING=true — parameter indicates that upon receiving a shutdown signal for a spot instance, all tasks on it should be transitioned to a Draining status.
ECS_CONTAINER_STOP_TIMEOUT=1m — parameter indicates that after receiving the SIGINT signal, all tasks have 1 minute before they are terminated.
ECS_ENGINE_AUTH_TYPE=docker — parameter specifies that the docker schema is used as the authorization mechanism.
ECS_ENGINE_AUTH_DATA=... — connection parameters for a private container registry where your Docker images are stored. If it's public, no parameters need to be specified.
In this article, I will use a public image from Docker Hub, so no parameters need to be specified. ECS_ENGINE_AUTH_TYPE a ECS_ENGINE_AUTH_DATA are not needed.
Good to know: it is recommended to regularly update the AMI, since new versions update Docker, Linux, ECS agent, etc. To remember this, you can for the release of new versions. You can receive notifications via email and update manually, or you can write a Lambda function that will automatically create a new version of the Launch Template with the updated AMI.
EC2 Auto Scaling Group
The Auto Scaling Group is responsible for launching and scaling instances. Management of groups occurs in the EC2 -> Auto Scaling -> Auto Scaling Groups section.
Launch template — we select the template created in the previous step. We keep the default version.
Purchase options and instance types — we specify the instance types for the cluster. Adhere to launch template uses the instance type from the Launch Template. Combine purchase options and instance types allows flexible configuration of instance types. We will use it.
Optional On-Demand base — the number of regular, non-spot instances that will always run.
On-Demand percentage above base — the percentage ratio of regular and spot instances; 50-50 will distribute evenly, 20-80 means that for each regular instance, 4 spot instances will be launched. In this example, I will specify 50-50, but in reality, we most often do 20-80, and in some cases, 0-100.
Instance types — tu môžete uviesť ďalšie typy inštancií, ktoré sa budú používať v klastri. Nikdy sme ich nepoužívali, pretože tomu veľmi nerozumiem. Možno ide o limity pre konkrétne typy inštancií, ale tie sa jednoducho zvyšujú cez podporu. Ak poznáte použitie, rád si prečítam v komentároch)
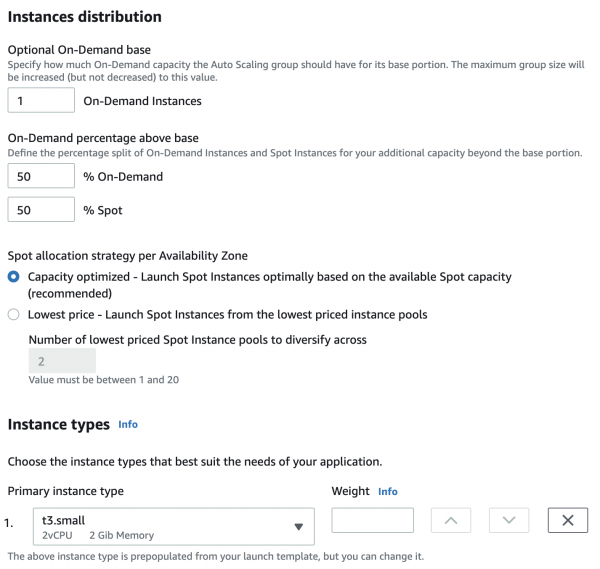
Sieť — nastavenia siete, vyberte VPC a podsiete pre stroje, vo väčšine prípadov je vhodné vybrať všetky dostupné podsiete.
Vyrovnávanie záťaže — nastavenia vyrovnávača zaťaženia, ale to urobíme zvlášť, tu nič nemeníme. Zdravotné kontroly taktiež bude nastavené neskôr.
Veľkosť skupiny — uvádzame limity na počet strojov v klastri a požadovaný počet strojov pri štarte. Počet strojov v klastri nikdy nebude menší ako minimálne uvedený a väčší ako maximálny, aj keď by sa podľa metrik malo realizovať škálovanie.
Politiky škálovania — parametre škálovania, ale budeme škálovať s ohľadom na spustené ECS úlohy, preto nastavíme škálovanie neskôr.
Ochrana inštancie pred zmenšením — ochrana inštancií pred odstránením pri znižovaní. Zapneme to, aby ASG neodstránil stroj, na ktorom sú aktívne úlohy. Ochranu možno vypnúť pre inštancie, na ktorých nie sú úlohy, ECS Capacity Provider.
Pridať značky — môžete uviesť značky pre inštancie (pre toto musí byť zaškrtnuté políčko Tag new instances). Odporúčam uviesť značku Name, tak všetky inštancie, ktoré sa spúšťajú v rámci skupiny, budú mať rovnaké názvy, takže ich bude pohodlné sledovať v konzole.
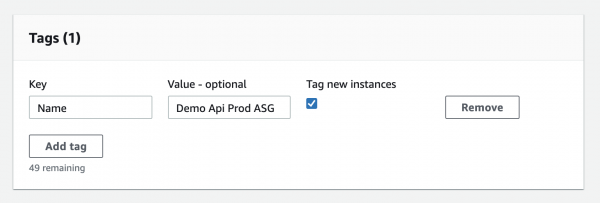
Po vytvorení skupiny ju otvorte a prejdite do sekcie Pokročilé konfigurácie, pretože počas vytvárania nie sú v konzole viditeľné všetky možnosti.
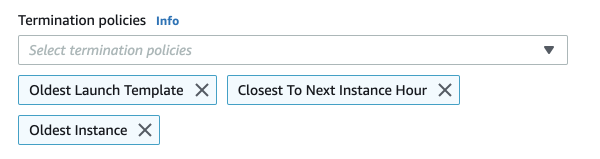
Politiky ukončenia — pravidlá, ktoré sa berú do úvahy pri odstraňovaní inštancií. Aplikujú sa v poradí. Zvyčajne používame také, ako na obrázku nižšie. Najprv sa odstraňujú inštancie s najstarším Launch Template (napríklad, ak sme aktualizovali AMI, vytvorila sa nová verzia, ale všetky inštancie sa stihli na ňu prepnúť). Potom sa vyberajú inštancie, ktoré sú najbližšie k nasledujúcej fakturačnej hodine. A ďalej sa vyberajú najstaršie podľa dátumu spustenia.
Good to know: na aktualizáciu všetkých strojov v klastri, je vhodné použiť Ak spojíte toto s funkciou Lambda z predchádzajúceho kroku, získate úplne automatizovaný systém aktualizácie inštancií. Pred aktualizáciou všetkých strojov je potrebné vypnúť ochranu proti zníženiu počtu inštancií pre všetky inštancie v skupine. Nie nastavenie v skupine, ale ochranu na samotných strojoch, čo sa robí na karte Správa inštancií.
Application Load Balancer a EC2 Target Group
Vyvážič sa vytvára v sekcii EC2 → Load Balancing → Load Balancers. Použijeme Application Load Balancer, porovnanie rôznych typov vyvážičov si môžete prečítať na .
Zosilňovače — má zmysel nastaviť porty 80 a 443 a vykonať presmerovanie z 80 na 443 pomocou pravidiel vyvážiča.
Zóny dostupnosti — vo väčšine prípadov vyberáme všetky zóny dostupnosti.
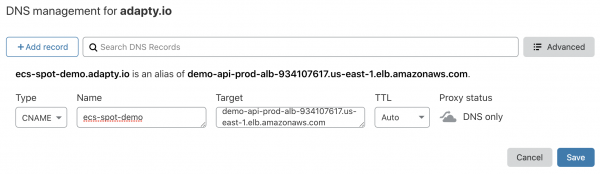
Nastaviť bezpečnostné nastavenia — tu sa uvádza SSL certifikát pre vyvážič, najpohodlnejšou možnosťou je v ACM. Rozdiely medzi politiky zabezpečenia si môžete prečítať v , môžete nechať vybrané predvolené ELBSecurityPolicy-2016-08. Po vytvorení vyvážiča uvidíte jeho Názov DNS, na ktorý je potrebné nastaviť CNAME pre vašu doménu. Napríklad, takto to vyzerá v Cloudflare.
Bezpečnostná skupina — vytvárame alebo vyberáme bezpečnostnú skupinu pre vyvážič, podrobnejšie o tom písal vyššie v sekcii EC2 Launch Template → Nastavenia siete.
Cieľová skupina — vytvárame skupinu, ktorá zodpovedá za smerovanie požiadaviek z vyvážiča na stroje a kontroluje ich dostupnosť, aby ich v prípade problémov nahradila. Typ cieľa musí byť Inštancia, Protokol a Port akékoľvek, ak používate HTTPS na komunikáciu medzi vyvážičom a inštanciami, potom musíte na nich nahrať certifikát. V rámci tohto príkladu to robiť nebudeme, jednoducho zostaneme pri porte 80.
Zdravotné kontroly — parametre kontroly funkčnosti služby. V reálnej službe by to mala byť samostatná požiadavka, ktorá realizuje dôležité časti obchodnej logiky, v rámci tohto príkladu ponechám nastavenia predvolene. Potom si môžete vybrať interval požiadaviek, časový limit, kódy úspešných odpovedí a ďalšie. V našom príklade uvedieme Kódy úspechu 200-399, pretože Docker obraz, ktorý sa bude používať, vracia kód 304.
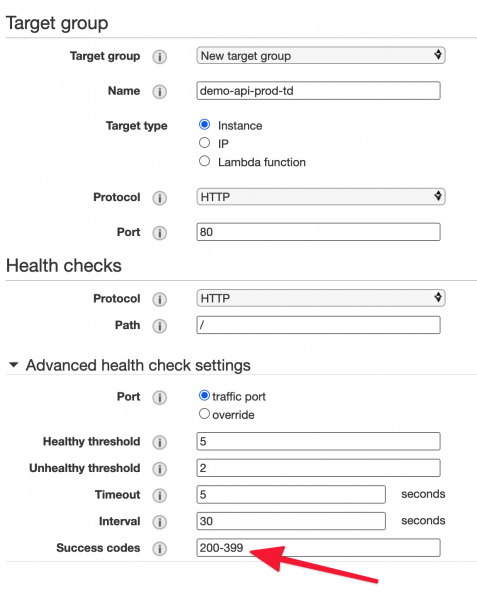
Zaregistrovať ciele — tu sa vyberajú stroje pre skupinu, ale v našom prípade sa touto činnosťou bude zaoberať ECS, takže tento krok jednoducho preskočíme.
Good to know: na úrovni vyvážiča môžete povoliť logy, ktoré budú ukladané do S3 v určitej . Odtia ich možno exportovať do externých služieb na analýzu, a tiež je možné vykonávať SQL dopyty priamo na údajoch v S3 pomocou . Je to praktické a funguje to bez akéhokoľvek dodatočného kódu. Odporúčam tiež nastaviť odstraňovanie logov z bucketu S3 po uplynutí stanoveného obdobia.
Definícia úlohy ECS
Na predchádzajúcich krokoch sme vytvorili všetko, čo sa týka infraštruktúry služby, teraz prechádzame k popisu kontajnerov, ktoré budeme spúšťať. Toto sa robí v časti ECS → Definície úloh.
Kompatibilita typu spustenia — vyberáme EC2.
IAM úloha vykonávania úlohy — vyberáme ecsTaskExecutionRole. S jej pomocou sa zapisujú logy, poskytuje prístup k tajným premenným a pod.
V časti Definície kontajnerov stlačíme Pridať kontajner.
Obrázok — odkaz na obraz s kódom projektu, v rámci tohto príkladu použijem verejný obraz z Docker Hub .
Limity pamäte — limity pamäte pre kontajner. Tvrdý limit — tvrdý limit, ak kontajner prekročí uvedenú hodnotu, vykoná sa príkaz docker kill, kontajner okamžite zomrie. Mäkký limit — mäkký limit, kontajner môže prekročiť uvedenú hodnotu, ale pri nasadzovaní úloh na stroje sa zohľadní tento parameter. Napríklad, ak má stroj 4 GiB RAM a mäkký limit kontajnera je 2048 MiB, na tomto stroji môžu byť maximálne 2 spustené úlohy s týmto kontajnerom. V skutočnosti je 4 GiB RAM o niečo menej ako 4096 MiB, čo môžete vidieť na karte ECS Instances v klastri. Mäkký limit nemôže byť väčší ako tvrdý limit. Je dôležité si uvedomiť, že ak má jedna úloha niekoľko kontajnerov, ich limity sa sčítajú.
Mapovanie portov — v Hostiteľský port uvádzame 0, to znamená, že port bude priradený dynamicky, jeho bude sledovať cieľová skupina. Port kontajnera — port, na ktorom beží vaša aplikácia, často sa zadáva v príkaze na vykonanie alebo priraďuje v kóde vašej aplikácie, Dockerfile atď. Pre náš príklad použijeme 3000, pretože je uvedený v používanom obraze.
Kontrola zdravia — parametre kontroly funkčnosti kontajnera, nezamieňajte s tými, ktoré sú nastavené v cieľovej skupine.
Prostredie — nastavenia prostredia. CPU jednotky — podobne ako obmedzenia pamäte, len ide o procesor. Každé jadro procesora predstavuje 1024 jednotiek, takže ak má server dvojjadrový procesor a na kontajneri je nastavená hodnota 512, potom môžu byť na jednom serveri spustené 4 úlohy s týmto kontajnerom. Jednotky CPU vždy zodpovedajú počtu jadier, nemôže ich byť o niečo menej, ako je to v prípade pamäte.
Príkaz — príkaz na spustenie služby vo vnútri kontajnera, všetky parametre sú uvedené čiarkou. Môže to byť gunicorn, npm atď. Ak nie je uvedené, bude použitá hodnota direktívy CMD z Dockerfile. Uvádzame npm,start.
Premenné prostredia — premenné prostredia kontajnera. Môžu to byť ako jednoduché textové údaje, tak aj tajné premenné z alebo .
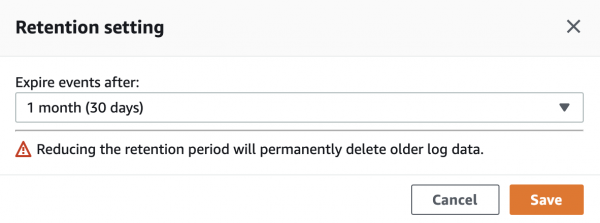
Ukladanie a logovanie — tu nastavíme logovanie v CloudWatch Logs (služba pre logy od AWS). Na to stačí zaškrtnúť možnosť Auto-configure CloudWatch Logs. Po vytvorení Task Definition sa automaticky vytvorí skupina logov v CloudWatch. Predvolene sa logy v nej uchovávajú neobmedzene, odporúčam zmeniť Retention period z Never Expire na požadovanú dobu. Toto sa robí v CloudWatch Log groups, je potrebné kliknúť na aktuálne obdobie a vybrať nové.
ECS Cluster a ECS Capacity Provider
Prejdeme do sekcie ECS → Clusters, aby sme vytvorili klastra. Ako šablónu vyberáme EC2 Linux + Networking.
Názov klastra — veľmi dôležité, tu vytvárame rovnaké meno, aké je uvedené v Launch Template v parametre ECS_CLUSTER, v našom prípade — DemoApiClusterProd. Zaškrtneme možnosť Create an empty cluster. Voliteľne môžeme zapnúť Container Insights, aby sme sledovali metriky služieb v CloudWatch. Ak ste všetko urobili správne, v sekcii ECS Instances uvidíte stroje, ktoré boli vytvorené v Auto Scaling group.
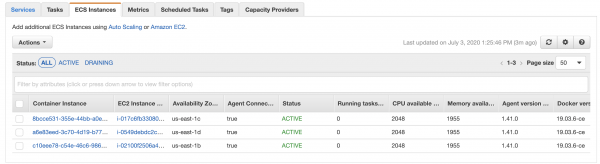
Prejdeme na kartu Capacity Providers a vytvoríme nový. Pripomínam, že je potrebný na riadenie vytvárania a vypínania strojov v závislosti od počtu bežiacich ECS úloh. Je dôležité poznamenať, že poskytovateľ môže byť priradený len k jednej skupine.
Auto Scaling group — vyberáme predtým vytvorenú skupinu.
Spravované škálovanie — zapneme, aby poskytovateľ mohol škálovať službu.
Cieľová kapacita % — aké percento zaťaženia strojov úlohami potrebujeme. Ak uvedieme 100 %, všetky stroje budú vždy zaťažené bežiacimi úlohami. Ak uvedieme 50 %, polovica strojov bude vždy voľná. V takom prípade, ak dôjde k prudkému nárastu záťaže, nové úlohy okamžite prejdú na voľné stroje, bez potreby čakať na rozšírenie inštancií.
Správa ochrany pred zrušením — zapnutím tohto parametra umožňujete poskytovateľovi odstrániť ochranu inštancií pred vymazaním. K tomu dôjde, ak na zariadení nie sú aktívne úlohy a umožňuje to percento cieľovej kapacity.
ECS Služba a nastavenie škálovania
Posledný krok :) Ak chcete vytvoriť službu, musíte prejsť do predtým vytvoreného klastra na kartu Služby.
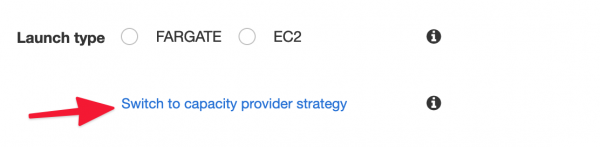
Typ spustenia — potrebujete kliknúť na Prepnúť na stratégiu poskytovateľa kapacity a vybrať predtým vytvoreného poskytovateľa.
Definícia úlohy — vyberáme predtým vytvorenú Definíciu úlohy a jej revíziu.
Meno služby — aby sme sa nezamieňali, vždy uvádzame to isté, ako Definícia úlohy.
Typ služby — vždy Replica.
Počet úloh — požadovaný počet aktívnych úloh v službe. Tento parameter riadi škálovanie, ale stále ho treba zadať.
Minimálne percento zdravých úloh a Maximálne percento — určujú správanie úloh pri nasadení. Predvolené hodnoty sú 100 a 200, hovoria o tom, že v momente nasadenia sa počet úloh zvýši na dvojnásobok a potom sa vráti na požadované. Ak máte 1 úlohu, min=0 a max=100, vtedy pri nasadení bude zrušená, a potom sa spustí nová, to znamená, že dôjde k prestoji. Ak funguje 1 úloha, min=50, max=150, tak nasadenie sa vôbec neuskutoční, pretože 1 úlohu nemožno rozdeliť na polovicu alebo zvýšiť o polovicu.
Typ nasadenia — nechávame Rolling update.
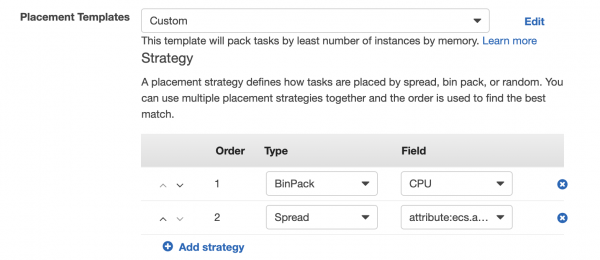
Šablóny umiestnenia — pravidlá umiestnenia úloh na strojoch. Predvolene je nastavené AZ Balanced Spread — to znamená, že každá nová úloha bude umiestnená na novú inštanciu, kým sa neaktualizujú stroje vo všetkých zónach dostupnosti. Zvyčajne nastavujeme BinPack — CPU a Spread — AZ, pri takejto politike sa úlohy umiestňujú maximálne blízko na jeden stroj podľa CPU. V prípade potreby vytvorenia nového stroja sa vytvorí v novej zóne dostupnosti.
Typ vyrovnávača záťaže — vyberáme Application Load Balancer.
IAM rola služby — vyberáme ecsServiceRole.
Meno vyrovnávača záťaže — vyberáme predtým vytvorený vyrovnávač.
Obdobie grace pre kontrolu stavu — prestávka pred vykonaním kontrol stavu po nasadení novej úlohy, zvyčajne nastavujeme 60 sekúnd.
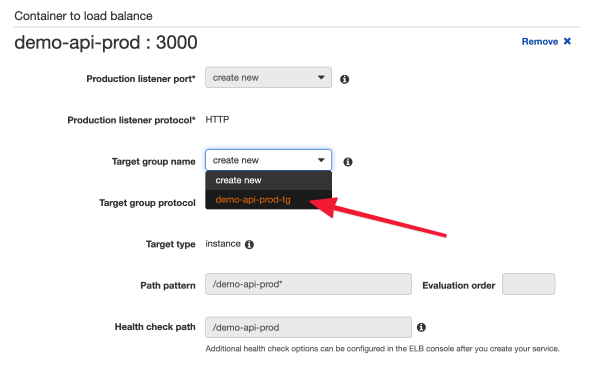
Kontajner na vyrovnávanie záťaže — v položke Názov cieľovej skupiny vyberáme predtým vytvorenú skupinu, a všetko sa automaticky vyplní.
Automatické škálovanie služby — parametre škálovania služby. Vyberáme Konfigurovať automatické škálovanie služby na úpravu požadovaného počtu vašej služby. Zadávame minimálne a maximálne počty úloh pri škálovaní.
IAM rola pre automatické škálovanie služby — vyberáme AWSServiceRoleForApplicationAutoScaling_ECSService.
Automatické politiky škálovania úloh — pravidlá pre škálovanie. Existujú 2 typy:
- Cieľové sledovanie — sledovanie cieľovej metriky (využitie CPU/RAM alebo počet požiadaviek na každý úloha). Napríklad, chceme, aby priemerné zaťaženie procesora bolo 85%, a keď presiahne túto hodnotu, nové úlohy sa budú pridávať, kým sa nedosiahne cieľová hodnota. Ak je zaťaženie nižšie, úlohy sa naopak odstránia, pokiaľ nie je zapnutá ochrana pred znižovaním škálovania (Vypnúť znižovanie škálovania).
- Krokové škálovanie — reakcia na náhodnú udalosť. Tu môžete nastaviť reakciu na akúkoľvek udalosť (CloudWatch Alarm), keď sa táto udalosť vyskytne, môžete pridať alebo odstrániť uvedené množstvo úloh, alebo určiť presný počet úloh.
Služba môže mať niekoľko pravidiel škálovania, čo môže byť užitočné, hlavné je sledovať, aby si navzájom nekolidovali.
Záver
Ak ste sa riadili pokynmi a použili rovnaký Docker obraz, vaša služba by mala vracať túto stránku.

- Vytvorili sme šablónu, podľa ktorej sa spúšťajú všetky stroje v službe. Taktiež sme sa naučili aktualizovať stroje pri zmene šablóny.
- Nastavili sme spracovanie signálu na zastavenie spotoch inštancie, takže do jednej minúty po jeho prijatí sú všetky pracujúce úlohy odstránené z stroja, čím sa nič nestráca a neprerušuje.
- Založili sme vyvažovač, aby sme rovnomerne rozložili záťaž medzi stroje.
- Vytvorili sme službu, ktorá funguje na spotoch inštanciách, a tým sa náklady na stroje skracujú približne trojnásobne.
- Nastavili sme automatické škálovanie oboma smermi, aby sme spracovali zvýšené zaťaženie, ale zároveň neplatili za nečinnosť.
- Používame Capacity Provider, aby aplikácia spravovala infraštruktúru (stroje) a nie naopak.
- Sme skvelí.
Ak máte predvídateľné výkyvy zaťaženia, napríklad, ak sa propagujete vo veľkej e-mailovej kampani, môžete nastaviť škálovanie podľa .
Taktiež je možné robiť škálovanie na základe údajov z rôznych častí vášho systému. Napríklad, máme funkciu užívateľom mobilnej aplikácie. Niekedy je kampaň rozoslaná viac ako 1M osobám. Po takejto rozosielke vždy dochádza k výraznému nárastu dopytu na API, pretože veľa používateľov sa naraz prihlasuje do aplikácie. Takže ak vidíme, že v rade na odoslanie propagačných push notifikácií je ich výrazne viac ako je štandard, môžeme okamžite spustiť niekoľko dodatočných strojov a úloh, aby sme sa pripravili na záťaž.
Budem rád, ak v komentároch poviete zaujímavé prípady použitia spotových inštancií a ECS alebo niečo o škálovaní.
Čoskoro budú články o tom, ako spracovávame tisíce analytických udalostí za sekundu na prevažne serverless st Stacku (s peniazmi) a ako prebieha nasadenie služieb pomocou GitLab CI a Terraform Cloud.
Sledujte nás, bude to zaujímavé!
Len registrovaní používatelia sa môžu zúčastniť prieskumu. , prosím.
Používate spot instances v produkcii?
22,2%Áno6
66,7%Nie18
11,1%Zistil som o nich z článku, plánujem ich použiť3
Hlasovalo 27 používateľov. Zdržalo sa 5 používateľov.
Zdroj: habr.com
