

Z času na čas vzniká úloha vyhľadávania súvisiacich údajov pomocou sady kľúčov, kým nedosiahneme požadovaný celkový počet záznamov.
Najreálnejším príkladom je dedukcia 20 najstarších úloh, uvedený na zozname zamestnancov (Napríklad v rámci jedného oddelenia). Pre rôzne manažérske dashboardy so stručnými súhrnami pracovných oblastí sa často vyžaduje podobná téma.
V tomto článku sa budeme zaoberať implementáciou „naivného“ riešenia tohto problému v PostgreSQL, „inteligentnejšieho“ a veľmi zložitého algoritmu. „slučka“ v SQL s podmienkou ukončenia na základe nájdených údajov, čo môže byť užitočné ako pre všeobecný vývoj, tak aj pre aplikáciu v iných podobných prípadoch.
Vezmime si testovaciu sadu údajov z Aby sa zabránilo „skákaniu“ výstupných záznamov z jedného časového okamihu do druhého, keď sa zoradené hodnoty zhodujú, Rozšírme predmetový index pridaním primárneho kľúčaVďaka tomu bude okamžite jedinečný a zaručí sa jasné poradie zoradenia:
CREATE INDEX ON task(owner_id, task_date, id);
-- а старый - удалим
DROP INDEX task_owner_id_task_date_idx;
Je to napísané tak, ako to znie.
Najprv si načrtneme najjednoduchšiu verziu požiadavky, pričom odovzdáme ID účinkujúcich. :
SELECT
  *
FROM
  task
WHERE
  owner_id = ANY('{1,2,4,8,16,32,64,128,256,512}'::integer[])
ORDER BY
  task_date, id
LIMIT 20; 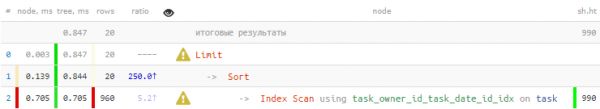
Je to trochu smutné - objednali sme si iba 20 platní a Index Scan nám ich vrátil 960 riadkov, ktoré potom bolo treba vyriešiť... Skúsme čítať menej.
zložiť + pole
Prvá úvaha, ktorá nám pomôže, je, či potrebujeme iba 20 zoradených záznamy, potom stačí prečítať maximálne 20 zoradených v rovnakom poradí pre každú kľúč. Našťastie, vhodný index (id_vlastníka, dátum_úlohy, id) máme.
Použime rovnaký mechanizmus extrakcie a „rozloženia do stĺpcov“. integrálny záznam v tabuľke, ako v Taktiež použijeme skladanie do poľa pomocou funkcie ARRAY():
WITH T AS (
  SELECT
    unnest(ARRAY(
      SELECT
        t
      FROM
        task t
      WHERE
        owner_id = unnest
      ORDER BY
        task_date, id
      LIMIT 20 -- ограничиваем тут...
    )) r
  FROM
    unnest('{1,2,4,8,16,32,64,128,256,512}'::integer[])
)
SELECT
  (r).*
FROM
  T
ORDER BY
  (r).task_date, (r).id
LIMIT 20; -- ... и тут - тоже 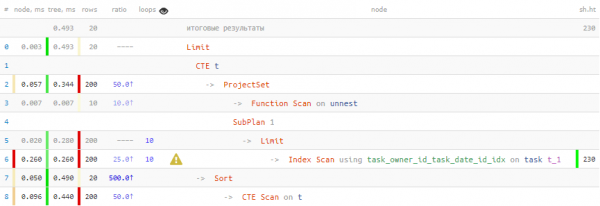
Och, to je oveľa lepšie! O 40 % rýchlejšie a 4.5-krát menej dát Musel som si to prečítať.
Materializácia tabuľkových záznamov pomocou CTEChcel by som upriamiť vašu pozornosť na skutočnosť, že v niektorých prípadoch Pokus o prácu s poľami záznamu ihneď po jeho vyhľadaní v poddotaze bez jeho „zabalenia“ do CTE môže viesť k „násobenie“ InitPlanu úmerné počtu týchto istých polí:
SELECT
  ((
    SELECT
      t
    FROM
      task t
    WHERE
      owner_id = 1
    ORDER BY
      task_date, id
    LIMIT 1
  ).*);
Result (cost=4.77..4.78 rows=1 width=16) (actual time=0.063..0.063 rows=1 loops=1)
Buffers: shared hit=16
InitPlan 1 (returns $0)
-> Limit (cost=0.42..1.19 rows=1 width=48) (actual time=0.031..0.032 rows=1 loops=1)
Buffers: shared hit=4
-> Index Scan using task_owner_id_task_date_id_idx on task t (cost=0.42..387.57 rows=500 width=48) (actual time=0.030..0.030 rows=1 loops=1)
Index Cond: (owner_id = 1)
Buffers: shared hit=4
InitPlan 2 (returns $1)
-> Limit (cost=0.42..1.19 rows=1 width=48) (actual time=0.008..0.009 rows=1 loops=1)
Buffers: shared hit=4
-> Index Scan using task_owner_id_task_date_id_idx on task t_1 (cost=0.42..387.57 rows=500 width=48) (actual time=0.008..0.008 rows=1 loops=1)
Index Cond: (owner_id = 1)
Buffers: shared hit=4
InitPlan 3 (returns $2)
-> Limit (cost=0.42..1.19 rows=1 width=48) (actual time=0.008..0.008 rows=1 loops=1)
Buffers: shared hit=4
-> Index Scan using task_owner_id_task_date_id_idx on task t_2 (cost=0.42..387.57 rows=500 width=48) (actual time=0.008..0.008 rows=1 loops=1)
Index Cond: (owner_id = 1)
Buffers: shared hit=4"
InitPlan 4 (returns $3)
-> Limit (cost=0.42..1.19 rows=1 width=48) (actual time=0.009..0.009 rows=1 loops=1)
Buffers: shared hit=4
-> Index Scan using task_owner_id_task_date_id_idx on task t_3 (cost=0.42..387.57 rows=500 width=48) (actual time=0.009..0.009 rows=1 loops=1)
Index Cond: (owner_id = 1)
Buffers: shared hit=4
Ten istý záznam bol „vyhľadaný“ 4-krát... Až do verzie PostgreSQL 11 sa toto správanie vyskytovalo pravidelne a riešením bolo „zabaliť“ ho do CTE, čo je v týchto verziách pre optimalizátor absolútny limit.
Rekurzívny akumulátor
V predchádzajúcej verzii sme čítali celkovo 200 riadkov kvôli potrebným 20. Už nie 960, ale ešte menej - je to možné?
Skúsme využiť vedomosti, ktoré potrebujeme celkom 20 záznamy. To znamená, že budeme iterovať iba čítanie údajov, kým nedosiahneme požadovaný počet.
Krok 1: Štartovací zoznam
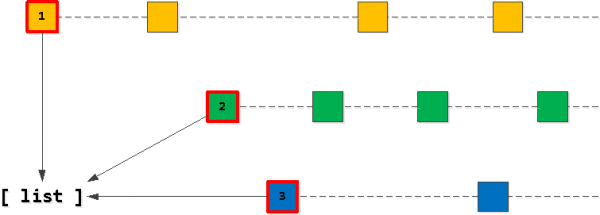
Náš „cieľový“ zoznam 20 záznamov by mal samozrejme začínať „prvými“ záznamami pre jeden z našich kľúčov owner_id. Najprv ich teda nájdeme. „úplne prvý“ pre každý z kľúčov a pridajte ho do zoznamu, zoradíme ho v požadovanom poradí - (dátum_úlohy, ID).
Krok 2: Nájdite „ďalšie“ záznamy
Ak teraz vezmeme prvý záznam z nášho zoznamu a začneme „krok“ ďalej v indexe so zachovaným kľúčom owner_id, potom všetky nájdené záznamy sú presne tie ďalšie vo výslednom výbere. Samozrejme, iba kým neprekročíme aplikovaný kľúč druhý záznam v zozname.
Ak sa ukáže, že sme „prekročili“ druhý záznam, potom posledný prečítaný záznam by mal byť pridaný do zoznamu namiesto prvého (s rovnakým owner_id), po ktorom zoznam znova zoradíme.
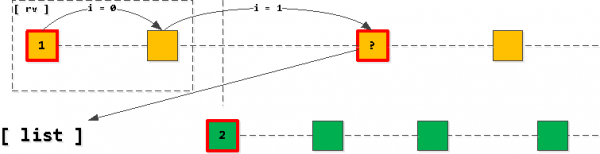
To znamená, že vždy skončíme s tým, že zoznam nemá viac ako jeden záznam pre každý z kľúčov (ak sa záznamy vyčerpajú a my sme ich „neprečiarkli“, prvý záznam jednoducho zmizne zo zoznamu a nič sa nepridá) a oni vždy zoradené vo vzostupnom poradí podľa kľúča aplikácie (dátum_úlohy, ID).
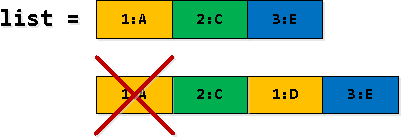
Krok 3: Filtrovanie a rozbaľovanie záznamov
V niektorých riadkoch nášho rekurzívneho výberu niektoré záznamy rv Duplicitné položky – najprv nájdeme položky ako „prekročenie hranice 2. položky v zozname“ a potom ich nahradíme ako prvú položku v zozname. Prvý výskyt je teda potrebné odfiltrovať.
Obávaná posledná otázka
WITH RECURSIVE T AS (
  -- #1 : заносим в список "первые" записи по каждому из ключей набора
  WITH wrap AS ( -- "материализуем" record'ы, чтобы обращение к полям не вызывало умножения InitPlan/SubPlan
    WITH T AS (
      SELECT
        (
          SELECT
            r
          FROM
            task r
          WHERE
            owner_id = unnest
          ORDER BY
            task_date, id
          LIMIT 1
        ) r
      FROM
        unnest('{1,2,4,8,16,32,64,128,256,512}'::integer[])
    )
    SELECT
      array_agg(r ORDER BY (r).task_date, (r).id) list -- сортируем список в нужном порядке
    FROM
      T
  )
  SELECT
    list
  , list[1] rv
  , FALSE not_cross
  , 0 size
  FROM
    wrap
UNION ALL
  -- #2 : вычитываем записи 1-го по порядку ключа, пока не перешагнем через запись 2-го
  SELECT
    CASE
      -- если ничего не найдено для ключа 1-й записи
      WHEN X._r IS NOT DISTINCT FROM NULL THEN
        T.list[2:] -- убираем ее из списка
      -- если мы НЕ пересекли прикладной ключ 2-й записи
      WHEN X.not_cross THEN
        T.list -- просто протягиваем тот же список без модификаций
      -- если в списке уже нет 2-й записи
      WHEN T.list[2] IS NULL THEN
        -- просто возвращаем пустой список
        '{}'
      -- пересортировываем словарь, убирая 1-ю запись и добавляя последнюю из найденных
      ELSE (
        SELECT
          coalesce(T.list[2] || array_agg(r ORDER BY (r).task_date, (r).id), '{}')
        FROM
          unnest(T.list[3:] || X._r) r
      )
    END
  , X._r
  , X.not_cross
  , T.size + X.not_cross::integer
  FROM
    T
  , LATERAL(
      WITH wrap AS ( -- "материализуем" record
        SELECT
          CASE
            -- если все-таки "перешагнули" через 2-ю запись
            WHEN NOT T.not_cross
              -- то нужная запись - первая из спписка
              THEN T.list[1]
            ELSE ( -- если не пересекли, то ключ остался как в предыдущей записи - отталкиваемся от нее
              SELECT
                _r
              FROM
                task _r
              WHERE
                owner_id = (rv).owner_id AND
                (task_date, id) > ((rv).task_date, (rv).id)
              ORDER BY
                task_date, id
              LIMIT 1
            )
          END _r
      )
      SELECT
        _r
      , CASE
          -- если 2-й записи уже нет в списке, но мы хоть что-то нашли
          WHEN list[2] IS NULL AND _r IS DISTINCT FROM NULL THEN
            TRUE
          ELSE -- ничего не нашли или "перешагнули"
            coalesce(((_r).task_date, (_r).id) < ((list[2]).task_date, (list[2]).id), FALSE)
        END not_cross
      FROM
        wrap
    ) X
  WHERE
    T.size < 20 AND -- ограничиваем тут количество
    T.list IS DISTINCT FROM '{}' -- или пока список не кончился
)
-- #3 : "разворачиваем" записи - порядок гарантирован по построению
SELECT
  (rv).*
FROM
  T
WHERE
not_cross; -- берем только "непересекающие" записи 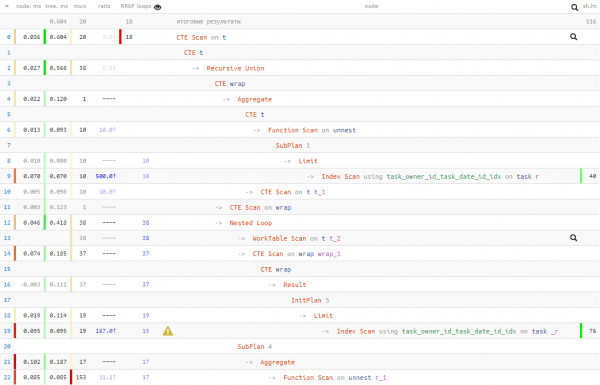
Teda my vymenil 50 % čítaní dát za 20 % času vykonávaniaTo znamená, že ak máte dôvod domnievať sa, že čítanie môže byť pomalé (napríklad údaje často nie sú vo vyrovnávacej pamäti a musia sa načítať z disku), potom táto metóda môže znížiť vašu závislosť od čítania.
V každom prípade bol čas vykonania lepší ako pri „naivnej“ prvej možnosti. Ale ktorú z týchto troch možností použijete, je len na vás.
Zdroj: hab.com
