

Úvod
V tomto článku sa podelím o známy Huffmanov algoritmus, ako aj o jeho využitie pri kompresii dát.
Na konci si napíšeme jednoduchý archiver. O tom už bolo , ale bez praktickej realizácie. Teoretický materiál tohto príspevku je prevzatý z hodiniek informatiky a z knihy Roberta Laforeho „Štruktúry dát a algoritmy v Jave“. Takže všetko pod kat!
Trochu úvah
V bežnom textovom súbore je jeden znak kódovaný 8 bitmi (kódovanie ASCII) alebo 16 (kódovanie Unicode). Následne sa budeme zaoberať kódovaním ASCII. Ako príklad si vezmeme reťazec s1 = "SUSIE SAYS IT IS EASYn". Celkovo v reťazci je 22 znakov, samozrejme vrátane medzier a znaku na novom riadku — 'n'. Súbor obsahujúci tento reťazec bude mať veľkosť 22*8 = 176 bitov. Hneď sa vynára otázka: je rozumné používať všetkých 8 bitov na kódovanie 1 znaku? Veď nepoužívame všetky znaky kódovania ASCII. Aj keby sme ich všetky použili, bolo by rozumnejšie dať najčastejšiemu znaku — S — najkratší možný kód a najraritnejšiemu znaku — T (alebo U, alebo ‘n’) — dať dlhší kód. O to ide v Huffmanovom algoritme: je potrebné nájsť optimálnu variantu kódovania, pri ktorej súbor bude mať minimálnu veľkosť. Je celkom normálne, že rôzne znaky budú mať rôznu dĺžku kódu — na tom je založený algoritmus.
Kódovanie
Prečo by sme znaku ‘S’ nemohli dať kód, napríklad, dĺžky 1 bit: 0 alebo 1. Nech je to 1. Potom druhému najčastejšiemu znaku — ‘ ‘(medzera) — dáme 0. Predstavte si, že ste začali dekódovať svoju správu — zakódovaný reťazec s1 — a vidíte, že kód začína s 1. Tak čo robiť: to je znak S, alebo je to nejaký iný znak, napríklad A? Preto sa vynára dôležité pravidlo:
Žiadny kód nesmie byť prefixom iného
Toto pravidlo je kľúčové v algoríme. Preto sa vytvorenie kódu začína s frekvenčnou tabuľkou, v ktorej je uvedená frekvencia (počet výskytov) každého znaku:
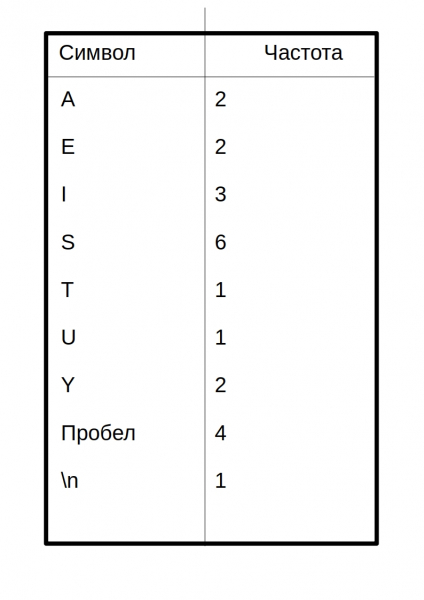 Znaky s najvyšším počtom výskytov by mali byť kódované najmenším možným počtom bitov. Uvediem príklad jednej z možných tabuliek kódov:
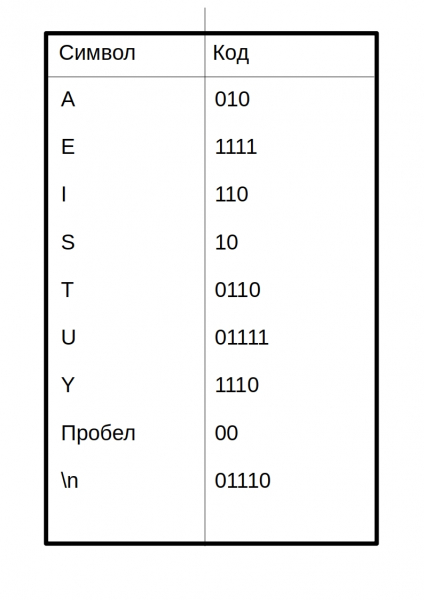 Takže zakódovaná správa bude vyzerať takto:
10 01111 10 110 1111 00 10 010 1110 10 00 110 0110 00 110 10 00 1111 010 10 1110 01110 Kód každého znaku som oddelil medzerou. V skutočne komprimovanom súbore takéto nebude!
Vyniká otázka: ako tento nováčik prišiel na to, ako vytvoriť kód na generovanie tabuľky kódov? O tom sa bude hovoriť nižšie.
Vytvorenie Huffmanovho stromu
Tu prichádzajú na pomoc binárne vyhľadávacie stromy. Nebojte sa, tu nebudú potrebné metódy vyhľadávania, vkladania a mazania. Tu je štruktúra stromu v jave:
public class Node {
    private int frekvencia;
    private char písmeno;
    private Node ľavýDieťa;
    private Node pravýDieťa;
    ...
}
class BinaryTree {
    private Node koreň;

    public BinaryTree() {
        koreň = new Node();
    }
    public BinaryTree(Node koreň) {
        this.koreň = koreň;
    }
    ...
}
Toto nie je kompletný kód, kompletný kód bude nižšie.
Tu je samotný algoritmus na vytvorenie stromu:
- Vytvorenie objektu Node pre každý symbol z správy (reťazec s1). V našom prípade bude 9 uzlov (objektov Node). Každý uzol sa skladá z dvoch dátových polí: symbol a frekvencia.
- Vytvoriť objekt Stromu (BinaryTree) pre každý uzol Node. Uzol sa stáva koreňom stromu.
- Vložiť tieto stromy do prioritnej fronty. Čím nižšia frekvencia, tým väčší priorita. Týmto spôsobom, pri vyberaní sa vždy vyberie strom s najnižšou frekvenciou.
Ďalej je potrebné opakovane vykonávať nasledujúce kroky:
- Vyberte dva stromy z prioritnej fronty a urobte z nich potomkov nového uzla (práve vytvoreného uzla bez písmena). Frekvencia nového uzla je rovná súčtu frekvencií dvoch stromov-potomkov.
- Pre tento uzol vytvorte strom s koreňom v danom uzle. Vložte tento strom späť do prioritnej fronty. (Keďže má strom novú frekvenciu, s najväčšou pravdepodobnosťou sa umiestni na nové miesto v fronte.)
- Pokračujte v vykonávaní krokov 1 a 2, kým v fronte nezostane len jeden strom — Huffmanov strom.
Pozrime sa na tento algoritmus na reťazci s1:
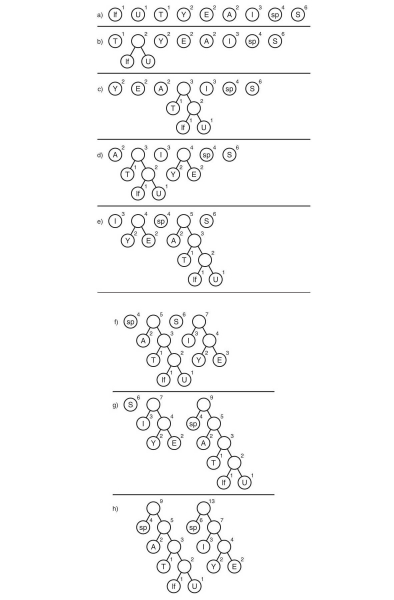
Tu symbol „lf“ (linefeed) označuje prechod na nový riadok, „sp“ (space) — to je medzera.
A čo ďalej?
Dostali sme Huffmanov strom. No dobre. A čo s ním robiť? Ani zadarmo ho nevezmú. A ďalej je potrebné sledovať všetky možné cesty od koreňa k listom stromu. Dohodneme sa označiť hranu 0, ak vedie k ľavému potomkovi a 1 — ak k pravému. Prísne vzaté, v týchto označeniach, kód symbolu — to je cesta od koreňa stromu k listu, ktorý obsahuje tento symbol.
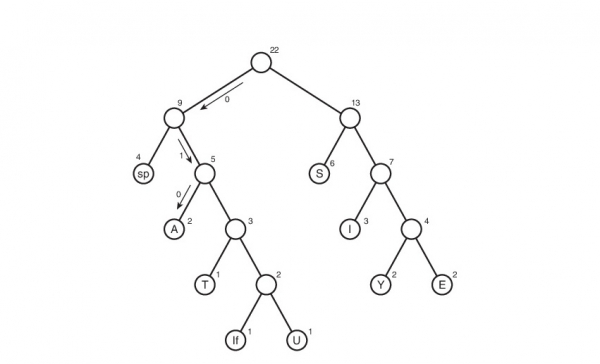
Takto vznikla tabuľka kódov. Všimnime si, že ak sa na túto tabuľku pozrieme, môžeme dospieť k záveru o "váhe" každého symbolu — to je dĺžka jeho kódu. Potom v skratenej podobe pôvodný súbor bude vážiť: 2 * 3 + 2 * 4 + 3 * 3 + 6 * 2 + 1 * 4 + 1 * 5 + 2 * 4 + 4 * 2 + 1 * 5 = 65 bitov. Spočiatku vážil 176 bitov. Preto sme ho znížili až o 176/65 = 2.7-krát! Ale to je utópia. Takýto koeficient sa pravdepodobne nedosiahne. Prečo? O tom budeme hovoriť trochu neskôr.
Dekódovanie
No, asi ostáva to najjednoduchšie — dekódovanie. Myslím, že mnohí z vás prišli na to, že jednoducho vytvoriť komprimovaný súbor bez akýchkoľvek náznakov, ako bol zakódovaný, nemožno — nebudeme ho môcť dekódovať! Áno, bolo ťažké si to uvedomiť, ale bude potrebné vytvoriť textový súbor table.txt s tabuľkou kompresie:
01110
 00
A010
E1111
I110
S10
T0110
U01111
Y1110
Záznam tabuľky vo forme ‘symbol’«kód symbolu». Prečo 01110 bez symbolu? V skutočnosti má symbol, len nástroje java, ktoré som použil pri výstupe do súboru, symbol prechodu na nový riadok — ‘n’ -konvertujú na prechod na nový riadok (ako hlúpo to znie). Preto prázdny riadok navrchu je symbol pre kód 01110. Pre kód 00 je symbolom medzera na začiatku riadku. Hneď poviem, že nášmu koeficientu hrozí zánik — tento spôsob uchovávania tabuľky môže byť najneracionálnejšou. Ale je jednoduchý na pochopenie a realizáciu. Rád si vypočujem vaše odporúčania v komentároch ohľadom optimalizácie.
S touto tabuľkou je veľmi jednoduché dekódovať. Pripomeňme si, akým pravidlom sme sa riadili pri vytváraní kódovania:
Žiadny kód nesmie byť prefixom iného
Tu zohráva uľahčujúcu úlohu. Čítame postupne bit za bitom a, ako náhle sa získaný reťazec d, pozostávajúci z prečítaných bitov, zhoduje s kódovaním zodpovedajúcim symbolu character, hneď vieme, že bol zakódovaný symbol character (a iba on!). Následne zapíšeme character do dekódovacieho reťazca (reťazec obsahujúci dekódovanú správu), resetujeme reťazec d a čítame ďalej zakódovaný súbor.
Implementácia
Prišiel čas ponížiť môj kód a napísať archiver. Nazvime ho Compressor.
Začneme od začiatku. Prvým krokom je napísať triedu Node:
public class Node {
    private int frekvencia; //frequence
    private char pismeno; //letter
    private Node lavýPotomok; //left child
    private Node pravýPotomok; //right child


    public Node(char pismeno, int frekvencia) { //konštruktor
        this.pismeno = pismeno;
        this.frekvencia = frekvencia;
    }

    public Node() {} //preťaženie konštruktora pre bezmenné uzly (pozri vyššie v sekcii o vytváraní Huffmanovho stromu)
    public void pridajPotomka(Node novyUzol) { //pridať potomka
        if (lavýPotomok == null) //ak je ľavý prázdny => pravý tiež => pridávame do ľavého
            lavýPotomok = novyUzol;
        else {
            if (lavýPotomok.getFrekvencia() <= novyUzol.getFrekvencia()) //v zásade, do ľavého potomka
                pravýPotomok = novyUzol; //stane sa ten, ktorý má nižšiu frekvenciu
            else {
                pravýPotomok = lavýPotomok;
                lavýPotomok = novyUzol;
            }
        }

        frekvencia += novyUzol.getFrekvencia(); //celková frekvencia
    }

    public Node getLavýPotomok() {
        return lavýPotomok;
    }

    public Node getPravýPotomok() {
        return pravýPotomok;
    }

    public int getFrekvencia() {
        return frekvencia;
    }

    public char getPismeno() {
        return pismeno;
    }

    public boolean jeList() { //kontrola na list
        return lavýPotomok == null && pravýPotomok == null;
    }
}
Teraz stromček:
class BinaryTree {
    private Node koren;

    public BinaryTree() {
        koren = new Node();
    }

    public BinaryTree(Node koren) {
        this.koren = koren;
    }

    public int getFrekvencia() {
        return koren.getFrekvencia();
    }

    public Node getKoren() {
        return koren;
    }
}
Prioritná fronta:
import java.util.ArrayList; //áno-ám, fronta bude na základe zoznamu

class PriorityQueue {
    private ArrayList data; //zoznam fronty
    private int nElem; //počet prvkov vo fronte

    public PriorityQueue() {
        data = new ArrayList();
        nElem = 0;
    }

    public void vložiť(BinaryTree novyStrom) { //vkladanie
        if (nElem == 0)
            data.add(novyStrom);
        else {
            for (int i = 0; i  novyStrom.getFrekvencia()) { //ak je frekvencia vkladaného stromu menšia
                    data.add(i, novyStrom); //ako frekvencia aktuálneho, posunieme všetky stromy na pozíciách napravo o 1 bunku
                    break; //potom umiestnime nový strom na pozíciu aktuálneho
                }
                if (i == nElem - 1)
                    data.add(novyStrom);
            }
        }
        nElem++; //zvýšime počet prvkov o 1
    }

    public BinaryTree odstrániť() { //odstránenie z fronty
        BinaryTree tmp = data.get(0); //kopírujeme odstraňovaný prvok
        data.remove(0); //vlastne, odstránime
        nElem--; //znížime počet prvkov o 1
        return tmp; //vraciame odstránený prvok (prvok s najnižšou frekvenciou)
    }
}
Trieda vytvárajúca Huffmanov strom:
verejná trieda HuffmanTree {
    súkromný konečný byte VEĽKOSŤ_KODOVACEJ_TABUĽKY = 127; // dĺžka kódovacej tabuľky
    súkromná String myString; // správa
    súkromná BinaryTree huffmanTree; // strom Huffmana
    súkromné int[] freqArray; // frekvenčná tabuľka
    súkromná String[] encodingArray; // kódovacia tabuľka

    // ----------------konstruktér----------------------
    verejná HuffmanTree(String newString) {
        myString = newString;

        freqArray = new int[VEĽKOSŤ_KODOVACEJ_TABUĽKY];
        fillFrequenceArray();

        huffmanTree = getHuffmanTree();

        encodingArray = new String[VEĽKOSŤ_KODOVACEJ_TABUĽKY];
        fillEncodingArray(huffmanTree.getRoot(), "", "");
    }

    // --------------------frekvenčná tabuľka------------------------
    súkromná void fillFrequenceArray() {
        pre (int i = 0; i < myString.length(); i++) {
            freqArray[(int)myString.charAt(i)]++;
        }
    }

    verejný int[] getFrequenceArray() {
        návrat freqArray;
    }

    // ------------------------vytvorenie stromu Huffmana------------------
    súkromná BinaryTree getHuffmanTree() {
        PriorityQueue pq = new PriorityQueue();
        // algoritmus popísaný vyššie
        pre (int i = 0; i < VEĽKOSŤ_KODOVACEJ_TABUĽKY; i++) {
            ak (freqArray[i] != 0) { // ak symbol existuje v reťazci
                Node newNode = new Node((char) i, freqArray[i]); // teda vytvoriť pre neho Node
                BinaryTree newTree = new BinaryTree(newNode); // a pre Node vytvoriť BinaryTree
                pq.insert(newTree); // vložiť do fronty
            }
        }

        kým (pravda) {
            BinaryTree tree1 = pq.remove(); // extrahovať z fronty prvý strom.

            skúšať {
                BinaryTree tree2 = pq.remove(); // extrahovať z fronty druhý strom

                Node newNode = new Node(); // vytvoriť nový Node
                newNode.addChild(tree1.getRoot()); // spraviť jeho potomkami dve extrahované stromy
                newNode.addChild(tree2.getRoot());

                pq.insert(new BinaryTree(newNode));
            } catch (IndexOutOfBoundsException e) { // zostal len jeden strom vo fronte
                návrat tree1;
            }
        }
    }

    verejný BinaryTree getTree() {
        návrat huffmanTree;
    }

    // -------------------kódovacia tabuľka------------------
    void fillEncodingArray(Node node, String codeBefore, String direction) { // vyplniť kódovaciu tabuľku
        ak (node.isLeaf()) {
            encodingArray[(int)node.getLetter()] = codeBefore + direction;
        } inak {
            fillEncodingArray(node.getLeftChild(), codeBefore + direction, "0");
            fillEncodingArray(node.getRightChild(), codeBefore + direction, "1");
        }
    }

    String[] getEncodingArray() {
        návrat encodingArray;
    }

    verejná void displayEncodingArray() { // na ladenie
        fillEncodingArray(huffmanTree.getRoot(), "", "");

        System.out.println("======================Kódovacia tabuľka====================");
        pre (int i = 0; i < VEĽKOSŤ_KODOVACEJ_TABUĽKY; i++) {
            ak (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            }
        }
        System.out.println("========================================================");
    }
    // -----------------------------------------------------
    String getOriginalString() {
        návrat myString;
    }
}
Trieda, ktorá kóduje/dekóduje:
public class HuffmanOperator {
    private final byte ENCODING_TABLE_SIZE = 127; // dĺžka tabuľky
    private HuffmanTree mainHuffmanTree; // Huffmanovo strom (používa sa iba na kompresiu)
    private String myString; // pôvodná správa
    private int[] freqArray; // frekvenčná tabuľka
    private String[] encodingArray; // kódovacia tabuľka
    private double ratio; // koeficient kompresie


    public HuffmanOperator(HuffmanTree MainHuffmanTree) { // na kompresiu
        this.mainHuffmanTree = MainHuffmanTree;

        myString = mainHuffmanTree.getOriginalString();

        encodingArray = mainHuffmanTree.getEncodingArray();

        freqArray = mainHuffmanTree.getFrequenceArray();
    }

    public HuffmanOperator() {} // na extrakciu;

    // ---------------------------------------kompresia-----------------------------------------------------------
    private String getCompressedString() {
        String compressed = "";
        String intermidiate = ""; // medzistrecha (bez prídavných núl)
        // System.out.println("=============================Kompresia=======================");
        // displayEncodingArray();
        for (int i = 0; i
        // musíme pridať nuly na koniec (môže byť 1, žiadny rozdiel)
        byte counter = 0; // počet pridaných núl na konci (bajtu úplne stačí: 0 <= counter < 8 < 127)
        for (int length = intermidiate.length(), delta = 8 - length % 8;
        		counter < delta; counter++) { // delta - počet pridaných núl
            intermidiate += "0";
        }

        // pripojiť počet pridaných núl v binárnom vyjadrení a medzistrecha
        compressed = String.format("%8s", Integer.toBinaryString(counter & 0xff)).replace(" ", "0") + intermidiate;

        // idealizovaný koeficient
        setCompressionRatio();
        // System.out.println("===============================================================");
        return compressed;
    }

    private void setCompressionRatio() { // vypočítať idealizovaný koeficient
        double sumA = 0, sumB = 0; // A - pôvodný súčet
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {
                sumA += 8 * freqArray[i];
                sumB += encodingArray[i].length() * freqArray[i];
            }
        }
        ratio = sumA / sumB;
    }

    public byte[] getBytedMsg() { // finálna kompresia
        StringBuilder compressedString = new StringBuilder(getCompressedString());
        byte[] compressedBytes = new byte[compressedString.length() / 8];
        for (int i = 0; i < compressedBytes.length; i++) {
                compressedBytes[i] = (byte) Integer.parseInt(compressedString.substring(i * 8, (i + 1) * 8), 2);
        }
        return compressedBytes;
    }
    // ---------------------------------------konec kompresie----------------------------------------------------------------
    // ------------------------------------------------------------extrakcia-----------------------------------------------------
    public String extract(String compressed, String[] newEncodingArray) {
        String decompressed = "";
        String current = "";
        String delta = "";
        encodingArray = newEncodingArray;

        // displayEncodingArray();
        // získať počet vložených núl
        for (int i = 0; i < 8; i++)
        	delta += compressed.charAt(i);
        int ADDED_ZEROES = Integer.parseInt(delta, 2);

        for (int i = 8, l = compressed.length() - ADDED_ZEROES; i < l; i++) {
            // i = 8, pretože prvým bajtom je počet vložených núl
            current += compressed.charAt(i);
            for (int j = 0; j < ENCODING_TABLE_SIZE; j++) {
                if (current.equals(encodingArray[j])) { // ak sa zhoduje
                    decompressed += (char)j; // tak pridáme element
                    current = ""; // a nulujeme aktuálny reťazec
                }
            }
        }

        return decompressed;
    }

    public String getEncodingTable() {
        String enc = "";
        for (int i = 0; i < encodingArray.length; i++) {
            if (freqArray[i] != 0)
                enc += (char)i + encodingArray[i] + 'n';
        }
        return enc;
    }

    public double getCompressionRatio() {
        return ratio;
    }


    public void displayEncodingArray() { // na ladenie
        System.out.println("======================Kódovacia tabuľka====================");
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            // if (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            // }
        }
        System.out.println("========================================================");
    }
    }
Trieda, ktorá uľahčuje zápis do súboru:
import java.io.File;
import java.io.PrintWriter;
import java.io.FileNotFoundException;
import java.io.FileOutputStream;
import java.io.IOException;
import java.io.Closeable;

public class FileOutputHelper implements Closeable {
    private File outputFile;
    private FileOutputStream fileOutputStream;

    public FileOutputHelper(File file) throws FileNotFoundException {
        outputFile = file;
        fileOutputStream = new FileOutputStream(outputFile);
    }

    public void writeByte(byte msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeBytes(byte[] msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeString(String msg) {
    	try (PrintWriter pw = new PrintWriter(outputFile)) {
    		pw.write(msg);
    	} catch (FileNotFoundException e) {
    		System.out.println("Nesprávna cesta, alebo taký súbor neexistuje!");
    	}
    }

    @Override
    public void close() throws IOException {
        fileOutputStream.close();
    }

    public void finalize() throws IOException {
        close();
    }
}
Trieda, ktorá uľahčuje čítanie zo súboru:
import java.io.FileInputStream;
import java.io.EOFException;
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.io.Closeable;
import java.io.File;
import java.io.IOException;

public class FileInputHelper implements Closeable {
	private FileInputStream fileInputStream;
	private BufferedReader fileBufferedReader;

	public FileInputHelper(File file) throws IOException {
		fileInputStream = new FileInputStream(file);
		fileBufferedReader = new BufferedReader(new InputStreamReader(fileInputStream));
	}


    public byte readByte() throws IOException {
    	int cur = fileInputStream.read();
    	if (cur == -1) //ak súbor skončil
    		throw new EOFException();
    	return (byte)cur;
    }

    public String readLine() throws IOException {
    	return fileBufferedReader.readLine();
    }

    @Override
    public void close() throws IOException{
    	fileInputStream.close();
    }
}
A hlavná trieda:
import java.io.File;
import java.nio.charset.MalformedInputException;
import java.io.FileNotFoundException;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.NoSuchFileException;
import java.nio.file.Paths;
import java.util.List;
import java.io.EOFException;
public class Main {
	private static final byte ENCODING_TABLE_SIZE = 127;

    public static void main(String[] args) throws IOException {
        try { //definujeme pokyn pomocí argumentů příkazové řádky
            if (args[0].equals("--compress") || args[0].equals("-c"))
                compress(args[1]);
            else if ((args[0].equals("--extract") || args[0].equals("-x"))
            		&& (args[2].equals("--table") || args[2].equals("-t"))) {
            	extract(args[1], args[3]);
            }
            else
                throw new IllegalArgumentException();
        } catch (ArrayIndexOutOfBoundsException | IllegalArgumentException e) {
            System.out.println("Neplatný formát vstupních argumentů");
            System.out.println("Přečtěte si Readme.txt");
            e.printStackTrace();
        }
    }

	public static void compress(String stringPath) throws IOException {
        List stringList;
        File inputFile = new File(stringPath);
        String s = "";
        File compressedFile, table;

        try {
            stringList = Files.readAllLines(Paths.get(inputFile.getAbsolutePath()));
        } catch (NoSuchFileException e) {
            System.out.println("Neplatná cesta, nebo takový soubor neexistuje!");
            return;
        } catch (MalformedInputException e) {
        	System.out.println("Aktuální kódování souboru není podporováno");
        	return;
        }

        for (String item : stringList) {
            s += item;
            s += 'n';
        }

        HuffmanOperator operator = new HuffmanOperator(new HuffmanTree(s));

        compressedFile = new File(inputFile.getAbsolutePath() + ".cpr");
        compressedFile.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(compressedFile)) {
        	fo.writeBytes(operator.getBytedMsg());
        }
        //vytvořit soubor s tabulkou kódování:

        table = new File(inputFile.getAbsolutePath() + ".table.txt");
        table.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(table)) {
        	fo.writeString(operator.getEncodingTable());
        }

        System.out.println("Cesta k zkomprimovanému souboru: " + compressedFile.getAbsolutePath());
        System.out.println("Cesta k tabulce kódování " + table.getAbsolutePath());
        System.out.println("Bez tabulky nebude možné soubor extrahovat!");

        double idealRatio = Math.round(operator.getCompressionRatio() * 100) / (double) 100; //ideální poměr
        double realRatio = Math.round((double) inputFile.length()
        		/ ((double) compressedFile.length() + (double) table.length()) * 100) / (double)100; //skutečný poměr

        System.out.println("Ideální poměr komprese je " + idealRatio);
        System.out.println("Poměr komprese včetně tabulky kódování " + realRatio);
    }

    public static void extract(String filePath, String tablePath) throws FileNotFoundException, IOException {
        HuffmanOperator operator = new HuffmanOperator();
        File compressedFile = new File(filePath),
        	 tableFile = new File(tablePath),
        	 extractedFile = new File(filePath + ".xtr");
        String compressed = "";
        String[] encodingArray = new String[ENCODING_TABLE_SIZE];
        //přečíst zkomprimovaný soubor
        //!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!zkontrolovat zde:
        try (FileInputHelper fi = new FileInputHelper(compressedFile)) {
        	byte b;
        	while (true) {
        		b = fi.readByte(); //metoda vrací EOFException
        		compressed += String.format("%8s", Integer.toBinaryString(b & 0xff)).replace(" ", "0");
        	}
        } catch (EOFException e) {

        }

        //--------------------

        //přečíst tabulku kódování:
        try (FileInputHelper fi = new FileInputHelper(tableFile)) {
        	fi.readLine(); //přeskočit první prázdný řádek
        	encodingArray[(byte)'n'] = fi.readLine(); //přečíst kód pro 'n'
        	while (true) {
        		String s = fi.readLine();
        		if (s == null)
        			throw new EOFException();
        		encodingArray[(byte)s.charAt(0)] = s.substring(1, s.length());
        	}
        } catch (EOFException ignore) {}

        extractedFile.createNewFile();
        //extrakce:
		try (FileOutputHelper fo = new FileOutputHelper(extractedFile)) {
			fo.writeString(operator.extract(compressed, encodingArray));
		}

		System.out.println("Cesta k rozbalenému souboru " + extractedFile.getAbsolutePath());
    }
}
Súbor s inštrukciami readme.txt si musíte napísať sami 🙂
Záver
Asi je to všetko, čo som chcel povedať. Ak máte niečo na srdci ohľadom mojej nekompetentnosti vylepšení v kóde, algoritmoch alebo akýchkoľvek optimalizáciách, neváhajte a napíšte. Ak som niečo nedostatočne vysvetlil, takisto mi dajte vedieť. Rád vás uvidím v komentároch!
P.S.
Áno-áno, stále som tu, veď som nezabudol na koeficient. Pre reťazec s1 obsahuje kódová tabuľka 48 bajtov - oveľa viac ako pôvodný súbor, a ani na pridané nuly sme nezabudli (počet pridaných núl je 7) => koeficient kompresie bude menší ako jedna: 176/(65 + 48*8 + 7)=0.38. Ak ste si to tiež všimli, tak len nech vás to neodradí, ste skvelý. Áno, táto implementácia bude pre malé súbory veľmi neefektívna. Ale čo sa deje s veľkými súbormi? Veľkosti súborov výrazne presahujú veľkosť kódovej tabuľky. Tu algoritmus funguje presne ako má! Napríklad pre archivátor vydáva skutočný (nie idealizovaný) koeficient, ktorý je 1.46 – skoro o polovicu viac! A áno, predpokladalo sa, že súbor bude v angličtine.
Zdroj: habr.com
