

Kanárik je malý vták, ktorý neustále spieva. Tieto vtáky sú citlivé na metán a oxidy uhoľnatého. Dokonca aj z malej koncentrácie nadbytočných plynov v ovzduší strácajú vedomie alebo umierajú. Hľadači zlata a baníci brali vtáčiky do baní: kým kanáriky spievajú, môžeme pracovať, ak stíchli — v bani je plyn a je čas odísť. Baníci obetovali malého vtáka, aby sa dostali z baní živí.
Podobná prax sa uplatňuje aj v IT. Napríklad v štandardnej úlohe nasadenia novej verzie služby alebo aplikácie na produkciu s testovaním predtým. Testovacie prostredie môže byť príliš drahé, automatizované testy nepokrývajú všetko, čo by sme chceli, a netestovanie a obetovanie kvality je riskantné. V takýchto prípadoch pomáha prístup Canary Deployment, keď sa na novú verziu pustí trochu skutočného produkčného prenosu. Tento prístup pomáha bezpečne overiť novú verziu na produkcii, obetujúc malé pre väčší cieľ. Podrobnejšie, ako tento prístup funguje, aké má výhody a ako ho implementovať, povie Andrej Markelov (), na príklade realizácie vo firme Infobip.
Andrej Markelov — vedúci inžinier-programátor v Infobip, už 11 rokov sa zaoberá vývojom aplikácií na Jave v oblasti financií a telekomunikácií. Vyvíja Open Source produkty, aktívne sa zúčastňuje Atlassian Community a píše pluginy pre produkty Atlassian. Evangelista Prometheus, Docker a Redis.
O spoločnosti Infobip
Je to globálna telekomunikačná platforma, ktorá umožňuje bankám, maloobchodníkom, internetovým obchodom a dopravným spoločnostiam posielať správu svojim klientom prostredníctvom SMS, push notifikácií, e-mailov a hlasových správ. V takom biznise je dôležitá stabilita a spoľahlivosť, aby klienti dostávali správy včas.
IT infraštruktúra Infobip v číslach:
- 15 dátových centier po celom svete;
- 500 unikátnych služieb v prevádzke;
- 2500 exemplárov služieb, čo je oveľa viac ako tímov;
- 4,5 TB mesačného prenosu;
- 4,5 miliardy telefónnych čísel;
Biznis rastie a spolu s ním aj počet vydaní. Robíme približne 60 vydaní denne, pretože klienti chcú viac možností a kapacít. Ale je to náročné — služieb je veľa a tímov málo. Musíme rýchlo písať kód, ktorý musí fungovať v produkcii bez chýb.
Vydania
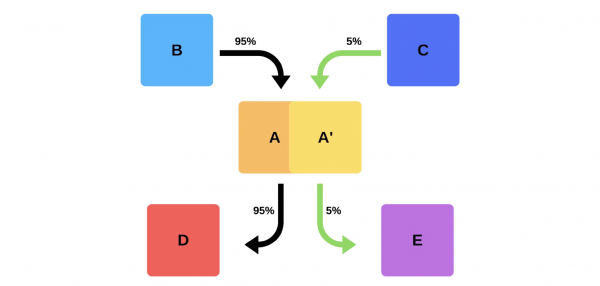
Typický release u nás prebieha takto. Napríklad, existujú služby A, B, C, D a E, pričom každú z nich vyvíja samostatný tím.
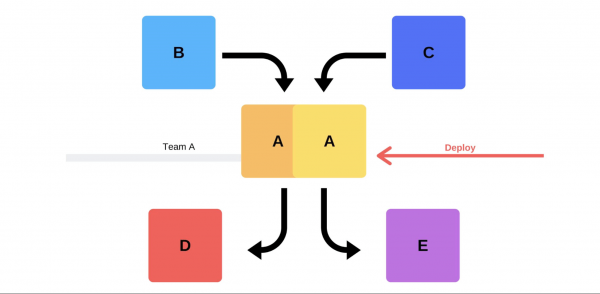
V nejakom momente sa tím služby A rozhodne nasadiť novú verziu, ale tímy služieb B, C, D a E o tom nevedia. Tím služby A má dve možnosti.
Uskutoční inkrementálny release: najprv nahradí jednu verziu a potom druhú.
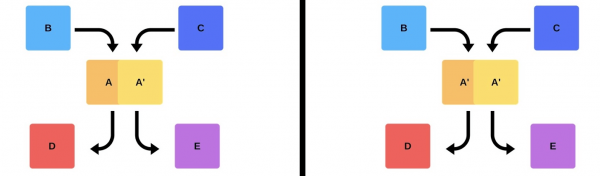
Ale existuje aj druhá možnosť: tím nájde dodatočné zdroje a zariadenia, nasadí novú verziu a potom prepne router, a verzia začne fungovať na produkcii.
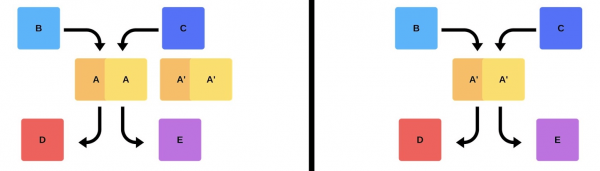
V každom prípade po nasadení takmer vždy nastanú problémy, aj keď bola verzia otestovaná. Testovať sa môže manuálne, automatizovane, alebo sa nemusí testovať vôbec — problémy sa objavia v každom prípade. Najjednoduchší a správny spôsob, ako ich vyriešiť, je vrátiť sa späť k funkčnej verzii. Až potom sa dá zaoberať škodami, príčinami a opravovať ich.
Takže, čo chceme?
Problémy nepotrebujeme. Ak ich zákazníci objavia skôr ako my, zasiahne to našu reputáciu. Preto musíme nájsť problémy rýchlejšie ako klienti.. Pracovaním vo viere minimalizujeme škody.
Zároveň chceme urýchliť nasadenie, aby to prebiehalo rýchlo, jednoducho, prirodzene a bez napätia zo strany tímu. Inžinierov, DevOps inžinierov a programátorov by sme mali chrániť — release novej verzie je stres. Tím nie je spotrebný materiál, usilujeme sa rozumne využiť ľudské zdroje..
Problémy s nasadením
Klientsky traffic je nepredvídateľný. Nie je možné predpovedať, kedy bude klientsky traffic minimálny. Nevieme, kde a kedy začnú klienti svoje kampane — možno dnes v noci v Indii a zajtra v Hongkongu. Zohľadňujúc veľký časový posun, nasadenie aj o 2 hodine ráno nezaručuje, že klienti neutrpia.
Problémy poskytovateľov. Messenger a poskytovatelia sú naši partneri. Niekedy majú poruchy, ktoré spôsobujú chyby počas nasadenia nových verzií.
Rozdelené tímy. Tímy, ktoré vyvíjajú klientskú časť a backend, sa nachádzajú v rôznych časových pásmach. Preto sa často nemôžu dohodnúť medzi sebou.
Dátové centrá nie je možné replikovať na stagingu. V jednom dátovom centre je 200 rackov — replikovať to v pieskovisku ani približne nie je možné.
Výpadkysú neprijateľné! Máme akceptovateľnú úroveň dostupnosti (Error Budget), keď pracujeme 99,99 % času, a zvyšné percentá sú "právo na chybu". Dosiahnuť 100 % spoľahlivosti nie je možné, ale je dôležité neustále monitorovať výpadky a prestoje.
Klasické riešenia
Písať kód bez chýb. Keď som bol mladý vývojár, k mne pristupovali manažéri s požiadavkou na vydanie bez chýb, ale to nie vždy je možné.
Písať testy. Testy fungujú, ale niekedy presne nie tak, ako chce biznis. Zarábať peniaze nie je úloha testov.
Testovať na stage. Počas mojich 3,5 rokov v Infobip som ešte nikdy nevidel, aby sa stav stage aspoň čiastočne zhodoval s produkciou.
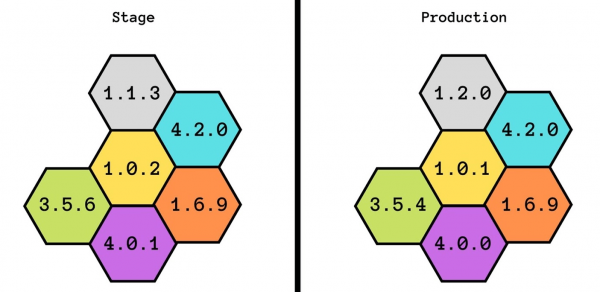
Snažili sme sa túto myšlienku rozvinúť: najprv sme mali stage, potom preprodukciu a nakoniec preprodukciu preprodukcie. Ale ani to nepomohlo — ani výkon sa nezhodoval. So stage môžeme zaručiť základnú funkčnosť, ale nevieme, ako to bude fungovať pri záťaži.
Novú verziu vydáva ten, kto ju vyvíjal. To je dobrá prax: aj keď niekto zmení názov komentára, okamžite to pridáva do produkcie. Pomáha to rozvíjať zodpovednosť a nezabúdať na vykonané zmeny.
Sú aj ďalšie zložitosti. Pre vývojára je to stres — stráviť veľa času, aby všetko skontroloval ručne.
Zladené vydania. Tento prístup zvyčajne navrhuje manažment: "Dozvime sa, že každý deň budete testovať a pridávať nové verzie." To nefunguje: vždy je tím, ktorý čaká na ostatných alebo naopak.
Smoke testy
Ďalší spôsob, ako vyriešiť naše problémy s nasadzovaním. Poďme sa pozrieť, ako fungujú smoke testy na predchádzajúcom príklade, keď tím A chce nasadiť novú verziu.
Najprv tím nasadí jeden inštanc na produkciu. Poslaním správy do inštancu od mockov simuluje reálny trafik, aby sa zhodoval so normálnym denným trafficom. Ak je všetko v poriadku, tím prepnú novú verziu na užívateľský traffic.
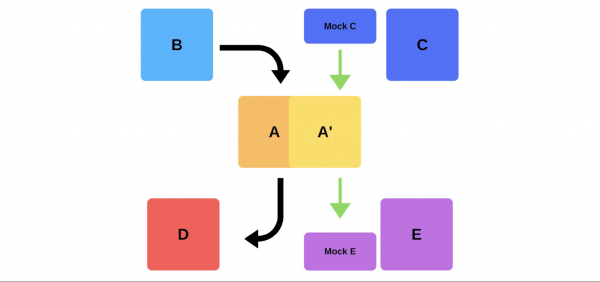
Druhá možnosť — nasadiť s dodatočným hardvérom. Tím to testuje na produkcii, potom prepnú a všetko funguje.
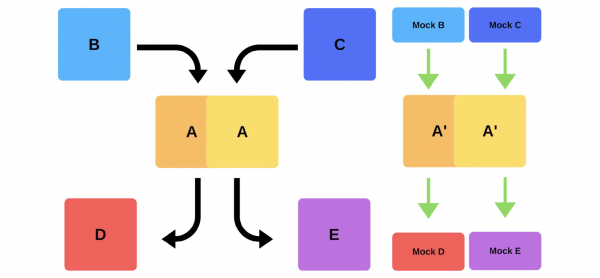
Nevýhody smoke testov:
- Testom sa nedá dôverovať. Kde získať ten istý traffic ako na produkcii? Môžeme použiť včerajší alebo týždňový, ale nie vždy sa zhoduje s aktuálnym.
- Ťažko sa udržuje. Bude potrebné spravovať testovacie účty, stále ich resetovať pred každým nasadením, keď sa do úložiska odosielajú aktívne záznamy. Je to zložitejšie, ako napísať test vo vlastnom pieskovisku.
Jedinou výhodou tu je — možnosť otestovať výkon.
Canary release
Z dôvodu nedostatkov smoke testov sme začali používať canary release.
Praktika podobná tomu, ako baníci používali kanáriky na indikáciu úrovne plynov, našla svojich priaznivcov aj v IT. Pustíme trochu skutočného produkčného trafficu na novú verziu, pričom sa snažíme dodržať Service Level Agreement (SLA). SLA je naše „právo na chybu“, ktoré môžeme využiť raz za rok (alebo za nejaký iný časový úsek). Ak to bude v poriadku, pridáme viac trafficu. Ak nie — vrátime predchádzajúce verzie.
Implementácia a nuansy
Ako sme implementovali canary releases? Napríklad, skupina klientov posiela správy cez našu službu.
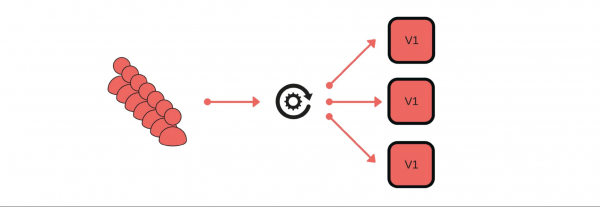
Nasadenie prebieha takto: odstránime jeden uzol z load balancera (1), zmeníme verziu (2) a osobitne pustíme trochu trafficu (3).
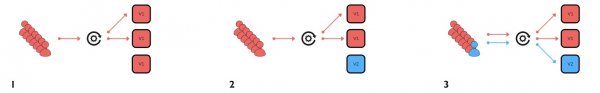
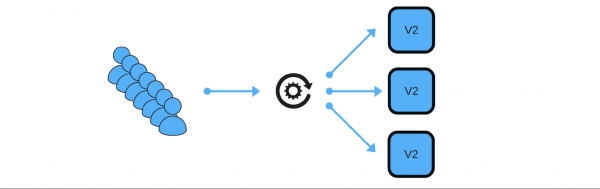
Celkovo, v skupine budú všetci šťastní, aj keď jeden používateľ bude nespokojný. Ak všetko prebehne dobre — zmeníme všetky verzie.
Ukážem schematicky, ako to vyzerá pre mikroslužby vo väčšine prípadov.
Existuje Service Discovery a dva ďalšie služby: S1N1 a S2. Prvá služba (S1N1) oznamuje Service Discovery, keď sa spúšťa, a Service Discovery si ju zapamätá. Druhá služba s dvoma uzlami (S2N1 a S2N2) tiež oznamuje Service Discovery pri štarte.
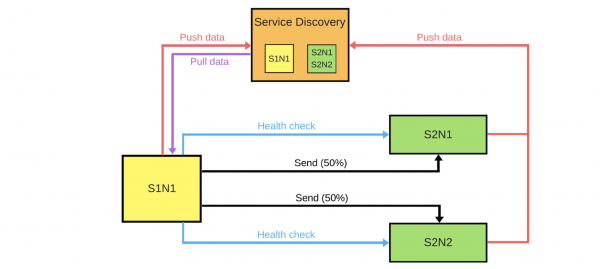
Druhá služba pre prvú funguje ako server. Prvá požaduje od Service Discovery informácie o svojich serveroch, a keď ich obdrží — hľadá a kontroluje ich ("health check"). Keď skontroluje, pošle im správy.
Keď niekto chce nasadiť novú verziu druhej služby, informuje Service Discovery, že druhý uzol bude canary uzlom: na neho bude posielané menej trafficu, pretože sa práve uskutoční nasadenie. Odstránime canary uzol z load balancera a prvá služba mu neposiela traffic.
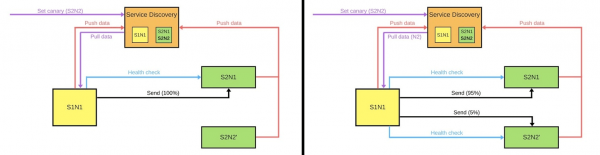
Meníme verziu a Service Discovery vie, že druhá uzol je teraz canary – môžeme jej poskytnúť menej zaťaženia (5 %). Ak je všetko v poriadku, meníme verziu, vraciame zaťaženia a pokračujeme ďalej.
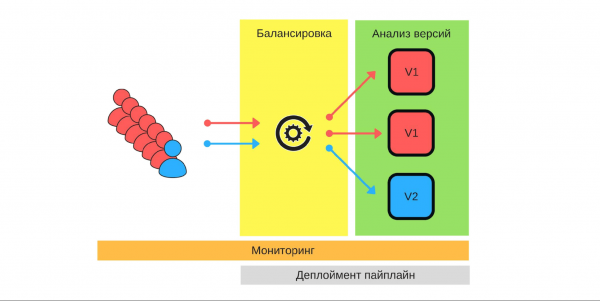
Na to, aby sme to všetko realizovali, potrebujeme:
- vyváženie;
- monitoring, pretože je dôležité vedieť, čo očakáva každý používateľ a ako podrobne fungujú naše služby;
- analýzu verzií, aby sme pochopili, ako dobre bude nová verzia fungovať v produkcii;
- automatizáciu – píšeme sekvenciu nasadenia (deployment pipeline).
Vyváženie
To je prvé, na čo by sme sa mali zamyslieť. Existujú dve stratégie vyváženia.
Najjednoduchšia možnosť je, keď jedna uzol je vždy canary. Tento uzol vždy dostáva menej prevádzky a začíname nasadzovanie s ním. V prípade problémov porovnáme jeho výkon pred nasadením a počas neho. Napríklad, ak sa počet chýb zdvojnásobil, znamená to, že škoda vzrástla dvojnásobne.
Canary uzol je definovaný v priebehu nasadenia. Akonáhle sa nasadenie skončí a zrušíme jeho status canary uzla, vyváženie prevádzky sa obnoví. S menším počtom strojov získame spravodlivé rozdelenie.
Monitorovanie
Kameňom úrazu canary vydania. Musíme presne chápete, prečo to robíme a aké metriky chceme zbierať.
Príklady metrík, ktoré zbierame z našich služieb.
- Počet chýb, ktoré sa zapisujú do logov. To je zrejmý ukazovateľ toho, že všetko funguje, ako má. Vo všeobecnosti je to dobrá metrika.
- Čas spracovania požiadaviek (latencia). Túto metriku monitorujú všetci, pretože všetci chcú pracovať rýchlo.
- Veľkosť fronty (priepustnosť).
- Počet úspešných odpovedí za sekundu.
- Čas spracovania 95 % všetkých požiadaviek.
- Biznisové metriky: koľko peňazí podnik zarába za určitý čas alebo odliv používateľov. Tieto metriky môžu byť pre našu novú verziu dôležitejšie než tie, ktoré pridávajú inžinieri.
Príklady metrík v väčšine populárnych monitorovacích systémov.
Counter. Je to určitá rastúca veličina, napríklad počet chýb. Túto metriku je jednoduché interpolovať a študovať graf: včera boli 2 chyby, dnes 500, znamená to, že niečo sa pokazilo.
Počet chýb za minútu alebo sekundu je kľúčový ukazovateľ, ktorý môžeme vypočítať pomocou Counter. Tieto údaje poskytujú jasnú predstavu o fungovaní systému na diaľku. Pozrime sa na príklad grafu počtu chýb za sekundu pre dve verzie produkčného systému.
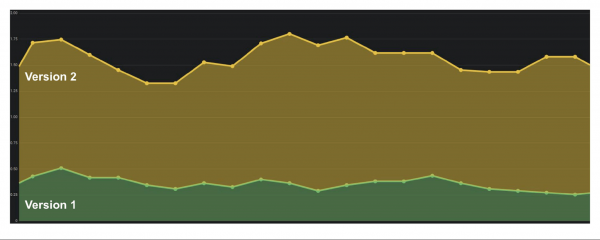
V prvej verzii bolo málo chýb, možno audit nefungoval. V druhej verzii je to oveľa horšie. Môžeme presne povedať, že existujú problémy, preto musíme túto verziu vrátiť späť.
Gauge. Metričky sú podobné Counter, ale zaznamenávame hodnoty, ktoré sa môžu zvyšovať aj znižovať. Napríklad doba vykonávania požiadaviek alebo veľkosť frontu.
Na grafe je príklad doby odozvy (latency). Z grafu je vidno, že verzie sú si podobné, s nimi sa dá pracovať. Ale pri podrobnejšom pohľade je jasné, ako sa veličina mení. Ak sa doba vykonávania požiadaviek zvyšuje s pridaním používateľov, okamžite je jasné, že sú tam problémy — predtým to takto nebolo.
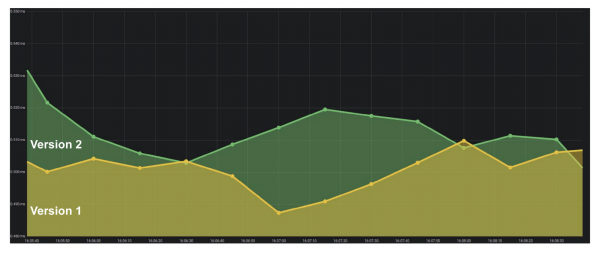
Summary. Jeden z najdôležitejších ukazovateľov pre biznis sú percentily. Metrička ukazuje, že v 95% prípadoch náš systém funguje tak, ako chceme. Môžeme sa zmieriť s tým, ak niekde sú problémy, pretože rozumieme celkovej tendencii, ako to všetko dobre alebo zle ide.
Nástroje
ELK Stack. Implementáciu canary možno vykonať pomocou Elasticsearch — zapisujeme doň chyby, keď sa vyskytujú udalosti. Pomocou najjednoduchšieho API volania môžeme získať počet chýb v akomkoľvek okamihu a porovnať ich s predchádzajúcimi úseky: GET /applg/_cunt?q=level:errr.
Prometheus. Dobre sa osvedčil v Infobip. Umožňuje realizovať multidimenzionálne metriky, pretože sa používajú značky.
Môžeme použiť level, instance, service, kombinovať ich v jednom systéme. Pomocou offset môžeme napríklad získať hodnotu veličiny spred týždňa jedným príkazom GET /api/v1/query?query={query}, kde {query}:
rate(logback_appender_total{
    level="error",
    instance=~"$instance"
}[5m] offset $offset_value)
Analýza verzií
Existuje niekoľko stratégií analýzy verzií.
Sledovať metriky iba canary-nódy. Jeden z najjednoduchších variantov: nasadili sme novú verziu a skúmame iba jej fungovanie. Ale ak inžinier v tom čase začne skúmať logy, neustále nervózne obnovujúc stránky, potom toto riešenie nie je od ostatných nijako odlišné.
Canary-nóda sa porovnáva s akoukoľvek inou nódu.Toto je porovnanie s inými inštanciami, ktoré fungujú na plnom prenosovom objeme. Napríklad, ak si v prípade malého prenosu počínajú horšie alebo aspoň rovnako ako na reálnych inštanciách, niečo nie je v poriadku.
Canary uzol sa porovnáva sám so sebou v minulosti. Uzly vyhradené pre canary sa dajú porovnávať s historickými údajmi. Napríklad, ak všetko vyzeralo minulý týždeň dobre, môžeme sa na tieto údaje orientovať, aby sme pochopili aktuálnu situáciu.
Automatizácia
Chceme zbaviť inžinierov manuálneho porovnávania, preto je dôležité realizovať automatizáciu. Proces nasadenia (deployment pipeline) zvyčajne vyzerá takto:
- začneme;
- odstránime uzol z vyvažovača zaťaženia;
- nasadíme canary uzol;
- aktivujeme vyvažovač s obmedzeným množstvom prenosu;
- porovnáme.
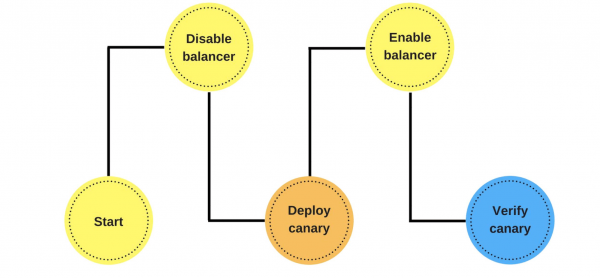
V tomto kroku zavádzame automatické porovnávanie. Ako môže vyzerať a prečo je lepšie ako kontrola po nasadení, predvedieme na príklade z Jenkins.
Toto je pipeline k Groovy.
while (System.currentTimeMillis() < endCanaryTs) {
    def isOk = compare(srv, canary, time, base, offset, metrics)
    if (isOk) {
        sleep DEFAULT SLEEP
    }   else {
        echo "Canary zlyhala, je potrebné vrátiť späť"
        return false
    }
}
Tu v cykle určujeme, že budeme porovnávať nový uzol počas hodiny. Ak canary proces ešte neskončil — voláme funkciu. Tá informuje, či je všetko v poriadku alebo nie: def isOk = compare(srv, canary, time, base, offset, metrics).
Ak je všetko v poriadku — sleep DEFAULT SLEEP, napríklad na sekundu, a pokračujeme. Ak nie, odchádzame — nasadenie zlyhalo.
Popis metriky. Pozrime sa, ako môže vyzerať funkcia compare na príklade DSL.
metric(
    'errorCounts',
    'rate(errorCounts{node=~"$canaryInst"}[5m] offset $offset)',
    {   baseValue, canaryValue ->
        if (canaryValue > baseValue * 1.3) return false
        return true
    }
)
Predpokladajme, že porovnávame počet chýb a chceme zistiť počet chýb za sekundu za posledných 5 minút.
Máme dve hodnoty: základnú a canary uzla. Hodnota canary uzla — aktuálna. Základná je baseValue — to je hodnota akéhokoľvek iného nezákladného uzla. Porovnávame hodnoty navzájom podľa vzorca, ktorý si definujeme na základe svojho skúsenosti a pozorovaní. Ak je hodnota canaryValue zlá, znamená to, že nasadenie zlyhalo a vrátime sa späť.
Prečo je toto všetko potrebné?
Človek nemôže skontrolovať stovky a tisíce metrík., tým skôr to rýchlo zvládneme. Automatické porovnávanie pomáha kontrolovať všetky metriky a rýchlo informovať o problémoch. Čas upozornenia je kritický: ak sa niečo stalo v posledných 2 sekundách, škody budú menšie, ako keby sa to stalo pred 15 minútami. Kým si niekto všimne problém, napíše do podpory, a podpora nám, aby vrátila späť, môžeme stratiť klientov.
Ak proces prebehol a všetko je v poriadku, automaticky nasadíme všetky ostatné uzly. Počas tohto času inžinieri nič nerobia. Až keď spustia canary, rozhodnú, aké metriky vziať, ako dlho robiť porovnávanie, akú stratégiu použiť.
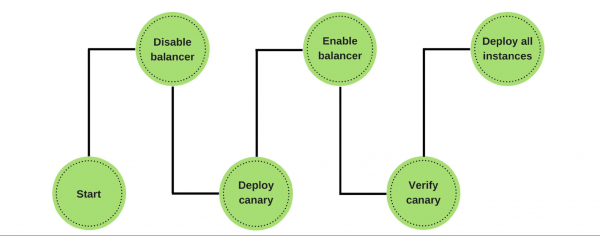
Ak nastanú problémy — automaticky vraciame canary-uzol, pracujeme na predchádzajúcich verziách a opravujeme chyby, ktoré sme našli. Podľa metrík ich je ľahké nájsť a vidieť škody od novej verzie.
Prekážky
Realizácia toho nie je samozrejme jednoduchá. Predovšetkým potrebujeme spoločný systém monitorovania. Inžinieri majú svoje metriky, podpora a analytici iné, a podnikanie tretie. Spoločný systém je spoločný jazyk, na ktorom komunikujú podnikanie a vývoj.
Je potrebné to otestovať v praxi stabilitu metrík. Kontrola pomáha pochopiť, aký minimálny súbor metrik je potrebný na zabezpečenie kvality.
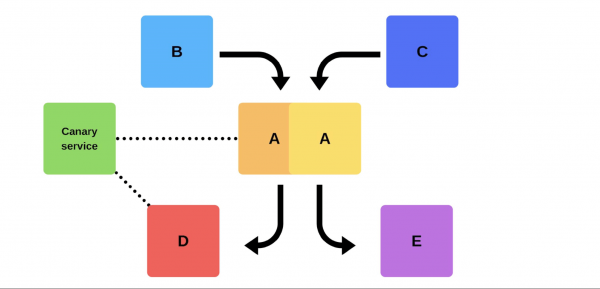
Ako to dosiahnuť? Používať canary-servis nie v čase nasadenia. Pridávame na starú verziu akýsi servis, ktorý kedykoľvek môže vziať akýkoľvek vyhradený uzol, znížiť prevádzku bez nasadenia. Potom porovnávame: študujeme chyby a hľadáme tú hranicu, kedy dosiahneme kvalitu.
Aký prospech sme získali z canary-releases
Minimalizovali sme percento škody od chýb. Väčšina chýb nasadenia vzniká kvôli nezhode nejakých údajov alebo priorít. Takýchto chýb je oveľa menej, pretože môžeme problém vyriešiť v prvých sekundách.
Optimalizovali sme prácu tímov. Nováčikovia majú „právo na chybu“: môžu nasadiť do produkcie bez strachu z omylu, vzniká dodatočná iniciatíva, podnecovanie k práci. Ak niečo pokazia, nebude to kritické, a chybný nebude prepustený.
Automatizovali sme nasadenie. Už to nie je ručný proces, ako predtým, ale skutočne automatizovaný. No trvá to dlhšie.
Vyčlenili sme dôležité metrikyCelá spoločnosť, od vedenia až po inžinierov, chápe, čo je v našom produkte naozaj dôležité, aké metriky, napríklad fluktuácia a toky používateľov. Sledujeme proces: testujeme metriky, zavádzame nové, sledujeme, ako fungujú staré, aby sme vybudovali systém, ktorý bude efektívne zarábať peniaze.
Máme veľa skvelých praktík a systémov, ktoré nám pomáhajú. Napriek tomu sa snažíme byť profesionálmi a odvádzať kvalitnú prácu, bez ohľadu na to, či máme systém, ktorý nám pomôže, alebo nie.
Inžinierske prístupy a praktiky — . Ak ste dosiahli úspechy na ceste k technickej dokonalosti a ste pripravení povedať, čo vám v tom pomohlo — .
Plánujeme usporiadať 8. júna. Chápeme, že je teraz ťažké rozhodnúť sa o účasti na konferencii. Ale zároveň sme presvedčení, že karanténa nie je dôvodom na zastavenie profesijného komunikovania a rozvoja. Preto v každom prípade nájdeme spôsob, ako prediskutovať úlohy technického lídra a prístupy k ich riešeniu — ak bude potrebné, prejdeme do online režimu a rozvineme networking tam!
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish