

Odporúčam prečítať si prepis správy začiatku roka 2016 od Andreja Salnikova "Typické chyby v aplikáciách, ktoré vedú k bloatu v PostgreSQL".
V tejto správe rozoberiem základné chyby v aplikáciách, ktoré vznikajú v štádiu návrhu a písania kódu aplikácie. A vezmem len tie chyby, ktoré vedú k bloatu v PostgreSQL. Zvyčajne je to začiatok konca výkonu vášho systému ako celku, hoci na začiatku neboli žiadne predpoklady na to.
Teší ma, že vás všetkých vítam! Táto správa nie je tak technická ako predchádzajúca správa od môjho kolegu. Je orientovaná hlavne na vývojárov backendových systémov, pretože máme dostatočne veľké množstvo klientov. A všetci robia tie isté chyby. O nich vám poviem. Vysvetlím, k čomu fatálnemu a zlému tieto chyby vedú.
Prečo sa chyby stávajú? Stávajú sa z dvoch dôvodov: na náhodu, môže to vyjsť, a z neznalosti určitých mechanizmov, ktoré sa dejú na úrovni medzi databázou a aplikáciou, ako aj v samotnej databáze.
Prinesiem vám tri príklady s hroznými obrázkami toho, ako to všetko dopadlo zle. V krátkosti vysvetlím mechanizmus, ktorý tam prebieha. A ako s nimi bojovať, keď sa stali, a aké preventívne metódy použiť na predchádzanie chybám. Povedzme si o pomocných nástrojoch a poskytnem užitočné odkazy.
Použil som testovaciu databázu, kde som mal dve tabuľky. Jedna tabuľka so zákazníckymi účtami, druhá s operáciami na týchto účtoch. A s nejakou periódou aktualizujeme zostatky na týchto účtoch.
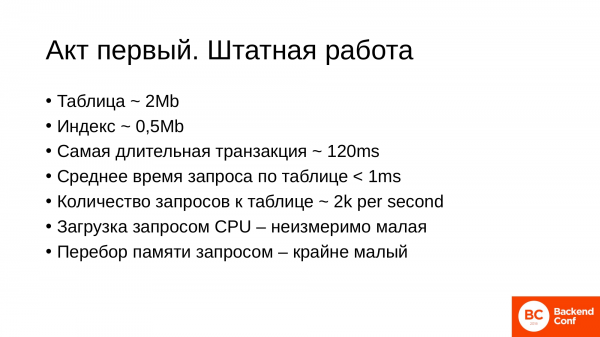
Výstupné dáta tabuľky: je dosť malá, 2 MB. Čas odozvy databázy a konkrétne tabuľky je tiež veľmi dobrý. A dostatočne dobré zaťaženie – 2000 operácií za sekundu na tabuľke.
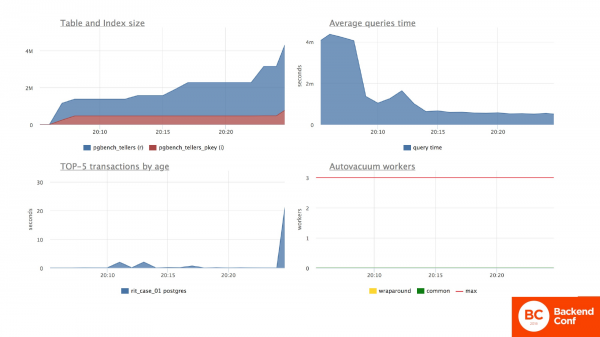
A cez túto správu vám budem ukazovať grafy, aby to bolo jasné, čo sa deje. Vždy budú dve snímky s grafmi. Prvá snímka – to, čo sa deje vo všeobecnosti na serveri.
A v tejto situácii vidíme, že skutočne máme tabuľku malej veľkosti. Index je malý, 2 MB. Toto je prvý graf zľava.
Priemerný čas odozvy na serveri je tiež stabilný, malý. Toto je pravý horný graf.
Ľavý dolný graf zobrazuje najdlhšie transakcie. Vidíme, že transakcie prebiehajú rýchlo. A autovakuum tu ešte nefunguje, pretože to bol testovací štart. Následne začne fungovať a bude nám prospešný.
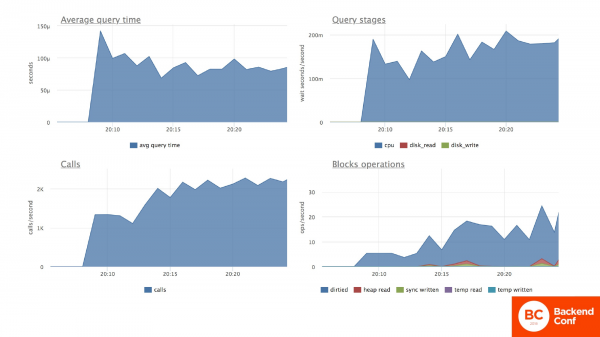
Druhý snímok bude vždy venovaný skúmanej tabuľke. V tejto situácii neustále aktualizujeme zostatky na účtoch klienta. A vidíme, že priemerný čas odpovede na operáciu aktualizácie je dosť dobrý, menej ako milisekundu. Vidíme, že procesorové zdroje (to je pravý horný graf) sú využívané rovnomerne a sú dostatočne nízke.
Pravý dolný graf ukazuje, koľko operačnej a diskovej pamäte prehľadávame pri hľadaní potrebného riadku pred jeho aktualizáciou. A počet operácií na tabuľke - 2 000 za sekundu, ako som spomínal na začiatku.
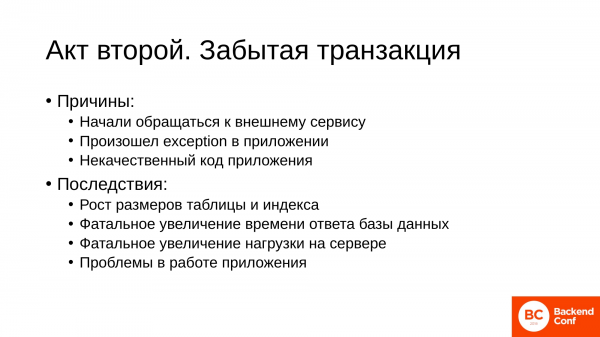
A teraz sa nám stáva tragédia. Z nejakého dôvodu vzniká dlhá zabudnutá transakcia. Príčiny sú zvyčajne dosť banálne:
- Jedna z najbežnejších je, že sme v kóde aplikácie začali komunikovať s externou službou. A táto služba nám neodpovedá. T. j. otvoríme transakciu, vykonáme zmenu v databáze a prejdeme čítať e-maily alebo do inej služby v rámci našej infraštruktúry, a z nejakého dôvodu nám neodpovedá. A máme visiaciu reláciu v stave - nevieme, kedy sa to vyrieši.
- Druhá situácia, keď sa v našom kóde z nejakého dôvodu vyskytla výnimka. A vo výnimke sme neinicializovali uzavretie transakcie. A máme visiaciu reláciu s otvorenou transakciou.
- A posledná - to je tiež dosť častý prípad. Je to nekvalitný kód. Niektoré frameworky otvárajú transakciu. Tá visí a možno ani neviete v aplikácii, že visí.
K čomu vedú takéto veci?
K tomu, že sa nám začnú rýchlo rozrastať tabuľky a indexy. To je práve ten efekt bloat. Pre databázu to bude znamenáť, že sa nám veľmi rýchlo zvýši čas odpovede databázy, zvýši sa záťaž na server databázy. A ako výsledok bude trpieť aplikácia. Pretože ak ste v kóde strávili 10 milisekúnd na dotaz do databázy, 10 milisekúnd na svoju logiku, tak vaša funkcia pracovala 20 milisekúnd. A teraz bude vaša situácia úplne smutná.
Pozrime sa na to, čo sa deje. Ľavý dolný graf ukazuje, že máme dlhú transakciu. A ak sa pozrieme na ľavý horný graf, vidíme, že veľkosť tabuľky zo 2 megabajtov prudko vzrástla na 300 megabajtov. Počet dát v tabuľke sa pritom nezmenil, t. j. tam je dostatočné množstvo nepotrebných údajov.
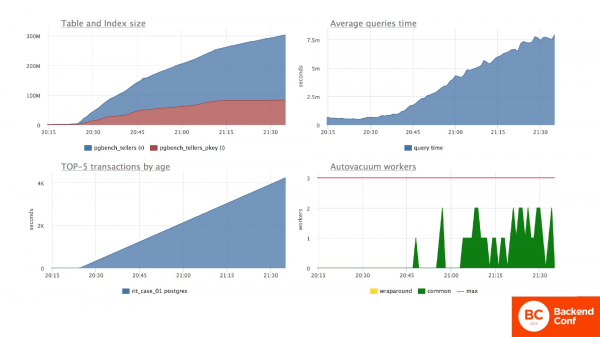
Celková situácia ohľadom priemerného času odpovede servera sa tiež zmenila o niekoľko rádov. T. j. všetky požiadavky na server začali výrazne klesať. A pritom sa aktivovali vnútorné procesy Postgres v podobe autovakuumu, ktoré sa pokúšajú niečo robiť a spotrebúvajú zdroje.
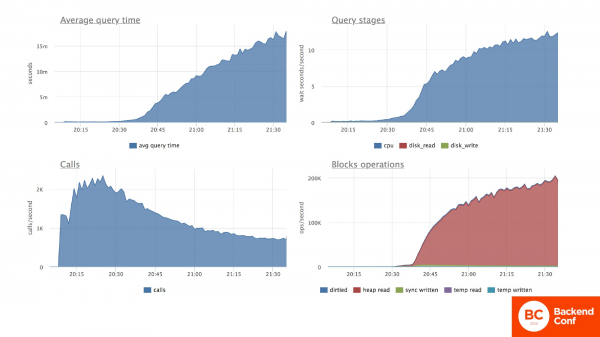
Čo sa teda deje s našou tabuľkou? To isté. Priemerný čas odpovede na tabuľku nám vzrástol o niekoľko rádov. Čo sa týka spotrebovaných zdrojov, vidíme, že sa výrazne zvýšila záťaž na procesor. To je pravý horný graf. A zvýšila sa preto, lebo procesor musí prehľadávať množstvo zbytočných riadkov v hľadaní jedného potrebného. To je pravý dolný graf. A výsledkom je, že počet volaní za sekundu začal veľmi prudko klesať, pretože databáza nestíha spracovávať rovnaké množstvo požiadaviek.
Musíme sa vrátiť k životu. Vyskakujeme na internet a zistíme, že dlhé transakcie vedú k problémom. Nájdeme a zrušíme túto transakciu. A všetko sa vráti do normálu. Všetko funguje ako má.
Uvoľnili sme sa, ale po nejakej dobe začíname pociťovať, že aplikácia nefunguje tak, ako pred haváriou. Požiadavky sa spracovávajú stále pomalšie, pričom podstatne pomalšie. V mojom prípade je to o 1,5 až 2 krát pomalšie. Záťaž na server je tiež vyššia, než bola pred haváriou.
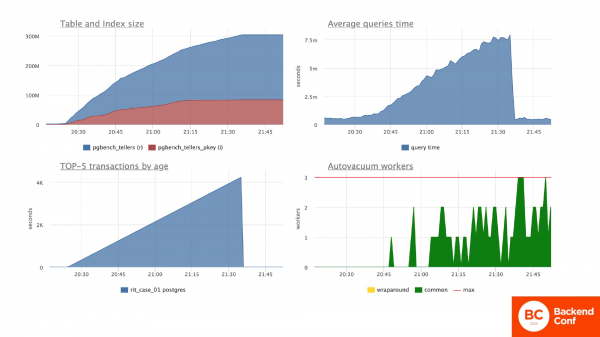
A otázka: „Čo sa v tomto momente deje s databázou?“. A s databázou sa deje nasledovná situácia. Na grafe transakcií vidíte, že sa zastavila a naozaj tam nie sú žiadne dlhé transakcie. Ale veľkosti tabulky sa počas havárie fatálne zvýšili. A od vtedy sa nezmenšili. Priemerný čas na databázu sa stabilizoval. A odpovede akoby boli adekvátne s prijateľnou rýchlosťou pre nás. Autovakuum sa stalo aktívnejším a začalo niečo robiť s tabuľkou, pretože musí prehodnocovať väčšie množstvo dát.
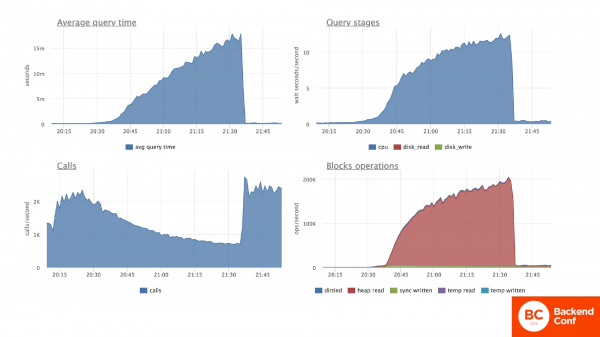
Pokiaľ ide o skúmanú tabuľku s faktúrami, kde meníme zostatky: čas odozvy na požiadavku sa zjavne vrátil do normálu. Ale v skutočnosti je o 50 % vyšší.
A čo sa týka zaťaženia procesora, vidíme, že zaťaženie procesora sa nevrátilo na požadovanú úroveň pred haváriou. Príčiny sú zakorenené práve v pravom dolnom grafe. Je tam vidieť, že dochádza k prelomu nejakého množstva pamäte. T. j. na vyhľadanie potrebného riadka míňame zdroje servera databázy pri prehľadávaní zbytočných dát. Počet transakcií za sekundu sa stabilizoval.
Celkovo je to dobré, ale situácia je horšia, ako bola. Je zjavná degradácia databázy v dôsledku našej aplikácie, ktorá s touto databázou pracuje.
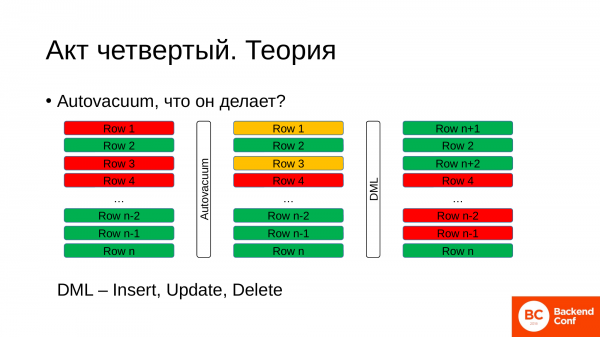
A aby sme sa dostali do toho, čo sa tam deje, ak ste neboli na predchádzajúcej prednáške, tak teraz trošku teórie. Teória o vnútornom procese. Na čo je autovakum a čo robí?
Prakticky stručne pre pochopenie. V nejakom momente máme tabuľku. V tabuľke sú riadky. Tieto riadky môžu byť aktívne, živé, momentálne potrebné. Na obrázku sú označené zelenou farbou. A sú tu aj mŕtve riadky, ktoré už boli spracované, boli aktualizované, boli na ne vytvorené nové záznamy. A sú označené, že už nie sú pre databázu zaujímavé. Ale ležia v tabuľke kvôli osobitosti Postgres.
Načo je autovakum potrebné? Autovakum v nejakom momente príde, obráti sa na databázu a pýta sa jej: „Daj mi, prosím, id najstaršej transakcie, ktorá je momentálne otvorená v databáze.“ Databáza vráti tento id. A autovakum sa opierajúc o neho prechádza riadkami v tabuľke. A ak vidí, že niektoré riadky boli zmenené transakciami, ktoré sú oveľa staršie, má právo ich označiť ako riadky, ktoré môžeme v budúcnosti znovu využiť, keď tam zapíšeme nové údaje. Je to pozadový proces.
V tom čase pokračujeme v práci s databázou, pokračujeme v vykonávaní nejakých zmien v tabuľke. A na tieto riadky, ktoré môžeme znova využiť, zapisujeme nové údaje. A týmto spôsobom máme cyklus, t. j. neustále sa tam objavujú akési mŕtve staré riadky, na ich miesto zapisujeme nové riadky, ktoré potrebujeme. A to je normálny stav pre prácu PostgreSQL.
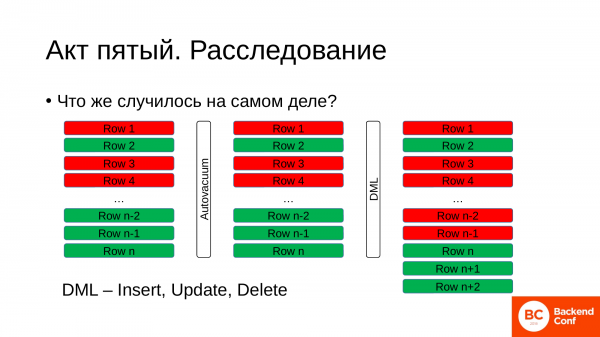
Čo sa stalo počas havárie? Ako prebiehal tento proces?
Mali sme tabuľku v nejakom stave, niektoré riadky boli živé, iné mŕtve. Prišiel autovakuum. Spýtal sa databázy, ktorá je naša najstaršia transakcia, aké má ID. Získal to ID, ktoré môže byť staré niekoľko hodín alebo aj desať minút. To závisí od toho, aké silné zaťaženie máte v databáze. A začal hľadať riadky, ktoré môže označiť ako znovu použiteľné. A nenašiel žiadne takéto riadky v našej tabuľke.
Ale v tomto čase naďalej pracujeme s tabuľkou. Niečo robíme v nej, aktualizujeme, meníme údaje. A čo má databáza v tom čase robiť? Nemá na výber, než pridávať nové riadky na koniec existujúcej tabuľky. A tým sa nám veľkosť tabuľky začína zvyšovať.
Naozaj potrebujeme na prácu zelené riadky. Ale počas takejto problémovej situácie máme za to, že percento zelených riadkov je extrémne nízke v celkovom objeme tabuľky.
A keď vykonávame dotaz, databáze sa musí prebehnúť cez všetky riadky: aj červené, aj zelené, aby našla požadovaný riadok. A efekt zväčšovania tabuľky zbytočnými dátami sa nazýva „bloat“, ktorý taktiež zaberá naše diskové miesto. Pamätáte, bolo 2 MB, stalo sa 300 MB? A teraz si vymeniť megabajty za gigabajty a rýchlo prídete o všetky svoje diskové zdroje.
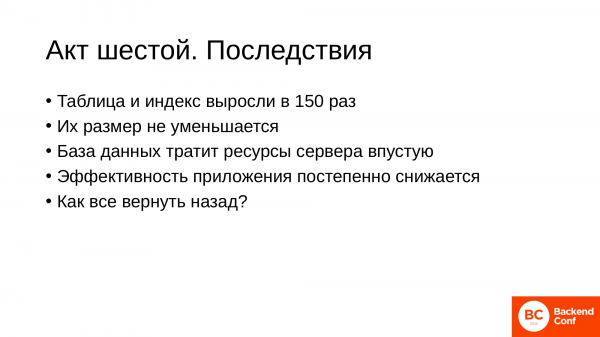
Aké môžu byť následky pre nás?
- V mojom prípade tabuľka a index narástli 150-krát. U niektorých našich klientov sa vyskytli ešte fatálnejšie prípady, kedy jednoducho miesto na disku začalo dochádzať.
- Veľkosť tabuliek sa sama o sebe nikdy nezmenší. Autovakuum v niektorých prípadoch môže odstrániť koniec tabuľky, ak sú tam len mŕtve riadky. Ale keďže dochádza k neustálej rotácii, jeden zelený riadok sa môže na konci zaseknúť a neaktualizovať, zatiaľ čo všetky ostatné budú zapisované niekde na začiatku tabuľky. Ale to je tak málo pravdepodobné, že sa vaše tabuľky samy od seba zmenšia, že sa na to netreba spoliehať.
- Databáze treba prechádzať celým hromadením zbytočných riadkov. A my míňame diskové zdroje, míňame procesorové zdroje a elektrickú energiu.
- A to priamo ovplyvňuje našu aplikáciu, pretože ak na začiatku sme trávili 10 milisekúnd na požiadavku, 10 milisekúnd na náš kód, počas havárie sme začali trávit sekundu na požiadavku a 10 milisekúnd na kód, t. j. výkonnosť aplikácie klesla poriadne. A keď sa havária vyriešila, začali sme tráviť 20 milisekúnd na požiadavku, 10 milisekúnd na kód. To znamená, že sme stále klesli v produktivite o polovicu. A to všetko kvôli jednej transakcii, ktorá sa zablokovala, pravdepodobne kvôli našej chybe.
- A otázka znie: „Ako všetko vrátiť späť?“, aby sme sa mali dobre a požiadavky bežali rovnako rýchlo, ako pred haváriou.
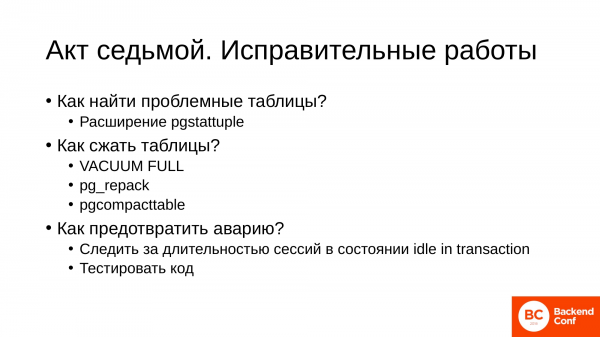
Na to existuje určitý cyklus prác, ktorý sa vykonáva.
Najprv musíme nájsť problémové tabuľky, ktoré sa nadmerne zväčšili. Chápeme, že v niektorých tabuľkách je zápis aktívnejší, v iných menej aktívny. A na to sa používa rozšírenie . Nainštalovaním tohto rozšírenia môžete napísať požiadavky, ktoré vám pomôžu nájsť tabuľky, ktoré sa zväčšili do značnej miery.
Po tom, čo ste našli tieto tabuľky, je potrebné ich zmenšiť. Na to existujú už nástroje. V našej spoločnosti používame tri nástroje. Prvý – zabudovaný VACUUM FULL. Je tvrdý, prísny a krutý, ale niekedy je veľmi užitočný. a – to sú externé nástroje na zmenšovanie tabuliek. A sú šetrnejšie k databáze.
Používajú sa v závislosti od toho, čo vám je pohodlnejšie. Ale o tom sa ešte zmienim na konci. Hlavné je, že existujú tri nástroje. Je z čoho vyberať.
Po tom, čo sme všetko opravili a uistili sa, že je všetko v poriadku, musíme vedieť, ako v budúcnosti predchádzať tejto situácii:
- Predchádzať tomu sa dá dosť ľahko. Treba sledovať dĺžku relácií na Master-serveri. Najnebezpečnejšie relácie sú v stave idle in transaction. To sú tie, ktoré otvorili transakciu, niečo spravili a odišli alebo sa jednoducho zablokovali, stratili sa v kóde.
- A pre vás, ako pre vývojárov, je dôležité testovať kód v okamihu vzniku týchto situácií. Nie je to ťažké. Bude to užitočná kontrola. Vyhnete sa množstvu „detských“ problémov súvisiacich s dlhými transakciami.
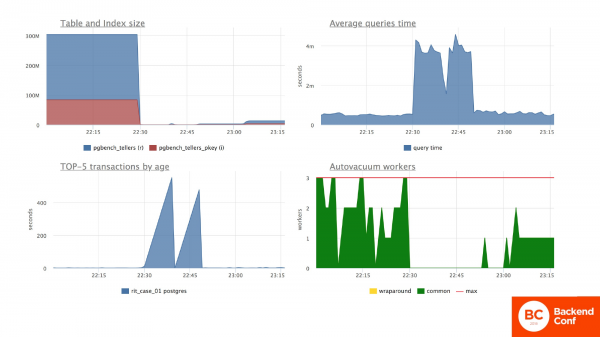
Na týchto grafoch som vám chcel ukázať, ako sa zmenila tabuľka a správanie databázy po tom, ako som v tomto prípade vykonal VACUUM FULL na tabuľke. Toto nie je produkcia.
Veľkosť tabuľky sa okamžite vrátila do normálneho funkčného stavu na pár megabajtov. Na priemerný čas odpovede servera to nemalo veľký vplyv.
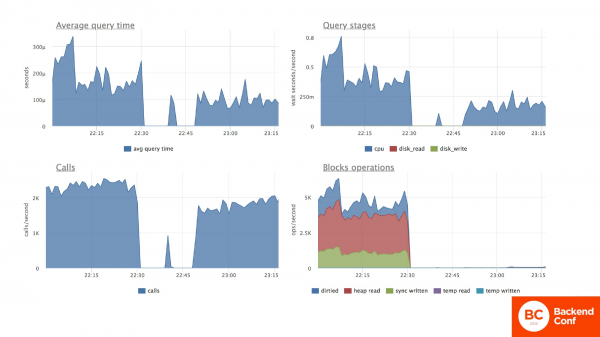
Ale konkrétne pri našej skúmanej tabuľke, kde sme aktualizovali zostatky na účtoch, vidíme, že priemerný čas odpovede na požiadavku na aktualizáciu údajov v tabuľke sa skrátil na predkrízovú úroveň. Prostriedky spotrebované procesorom na vykonanie tohto dotazu tiež klesli na predkrízovú úroveň. A pravý dolný graf ukazuje, že teraz nájdeme presne ten riadok, ktorý potrebujeme, ihneď, bez prehľadávania množstva mŕtvych riadkov, ktoré existovali pred zmrštením tabuľky. A priemerný čas dotazov zostal zhruba na tej istej úrovni. Ale tu mám skôr nepresnosť môjho hardvéru.
Na tomto prvom príbehu to končí. Je to najbežnejšie. A stáva sa to všetkým, bez ohľadu na skúsenosti klienta, akí kvalifikovaní sú programátori. Skôr či neskôr sa to stane.
Druhý príbeh, v ktorom rozdeľujeme záťaž a optimalizujeme serverové zdroje
- Už sme vyrástli a stali sme sa vážnymi hráčmi. A chápeme, že máme replikáciu a bolo by dobré vyvážiť záťaž: písať na Master a čítať z repliky. A táto situácia obvykle nastáva, keď chceme pripraviť nejaké správy alebo ETL. A biznis z toho má veľkú radosť. Veľmi chce rôzne správy s hromadou zložitých analýz.
- Správy trvajú hodiny, pretože zložitú analýzu nevyhodnotíte za milisekundy. My, ako šikovní chlapci, píšeme kód. Robíme v aplikácii vklad, že záznam vedieme na Master, správy vykonávame na replike.
- Rozdeľujeme záťaž.
- Všetko funguje skvele. Sme skvelí.
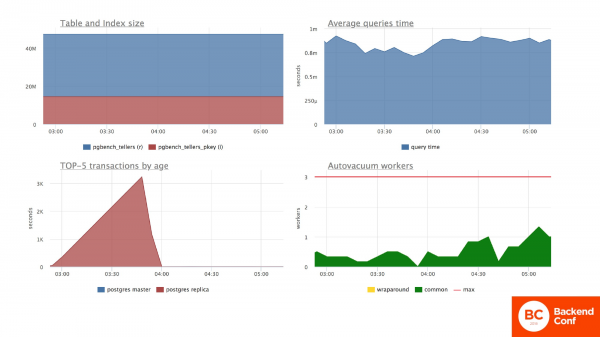
A ako vyzerá táto situácia? Konkrétne na týchto grafoch som ešte pridal trvanie transakcií z repliky. Všetky ostatné grafy sa týkajú iba Master servera.
Tabuľka s prehľadmi sa mi zatiaľ zväčšila. Je ich viac. Vidíme, že priemerný čas odozvy servera je stabilný. Na replike vidíme dlhú transakciu, ktorá prebieha už 2 hodiny. Vidíme pokojný chod autovakus, ktorý spracováva mŕtve riadky. A všetko je v poriadku.
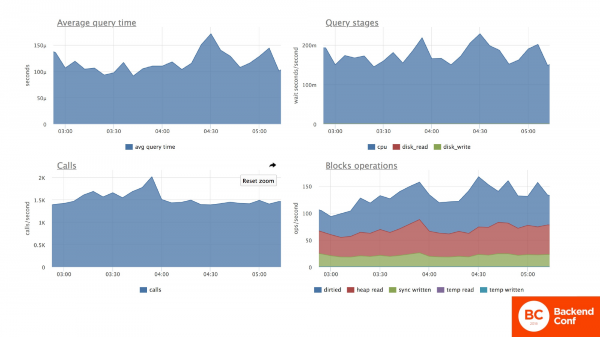
Pokiaľ ide o testovanú tabuľku, naďalej aktualizujeme zostatky na účtoch. A máme tiež stabilný čas odozvy na dopyt, stabilnú spotrebu zdrojov. Všetko je v poriadku.
Všetko je dobré, pokým nezačnú tieto prehľady narážať na problémy s replikáciou. A narážajú na ne s pravidelnou periodicitou.
Pozrieme sa na internet a začíname čítať, prečo sa to deje. A nájdeme riešenie.
Prvé riešenie – zvýšiť oneskorenie replikácie. Vieme, že náš prehľad trvá 3 hodiny. Nastavíme oneskorenie replikácie na 3 hodiny. Spustíme všetko, ale stále máme problémy s tým, že prehľady niekedy narážajú.
Chceme, aby to všetko fungovalo perfektne. Ideme ďalej. A nájdeme na internete skvelé nastavenie – hot_standby_feedback. Zapneme to. Hot_standby_feedback nám umožňuje pozdržať prácu autovakua na hlavnom servery. Týmto sa úplne zbavíme konfliktov replikácie. A všetko nám dobre funguje s prehľadmi.
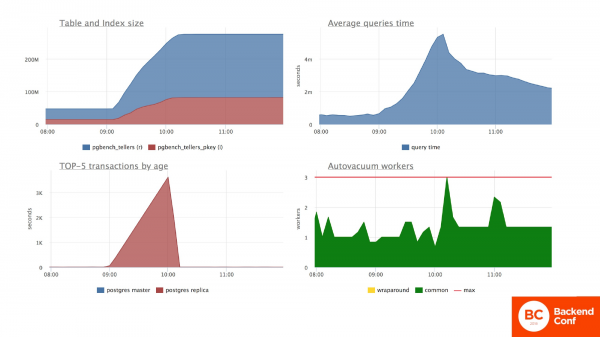
A čo sa v tom čase deje s hlavným serverom? Na hlavnom serveri sa deje totálna katastrofa. Teraz sledujeme grafy, keď som zapol oba tieto parametre. A vidíme, že relácia na replike akýmisi spôsobmi ovplyvnila situáciu na hlavnom serveri. Naozaj ovplyvňuje, pretože zastavila autovacuum, ktoré čistí mŕtve riadky. Naša veľkosť tabuľky opäť vyskočila do nebies. Priemerný čas vykonávania dopytov v celej databáze tiež vyskočil do nebies. Autovakua sa trošku zapotili.
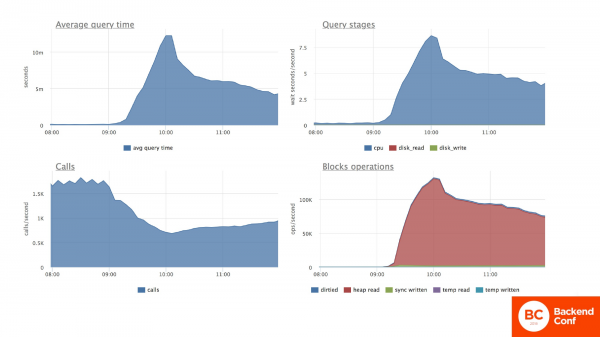
Pokiaľ ide o našu tabuľku, vidíme, že aktualizácia údajov sa tiež vynorila do nebies. Spotreba procesora sa rovnako dramaticky zvýšila. Opäť prechádzame veľké množstvo mŕtvych, nepoužiteľných riadkov. A čas odozvy tejto tabuľky, počet transakcií klesol.
Ako to bude vyzerať, ak nevieme, o čom som hovoril predtým?
- Začíname hľadať problémy. Ak sme sa v prvej časti stretli s problémami, vieme, že to môže byť spôsobené dlhými transakciami a ideme na Master. Problémy máme na Masteri. Nezvláda to. Prehrieva sa, jeho Load Average sa blíži k stovke.
- Žiadosti tam spomaľujú, ale nevidíme tam žiadne dlhé transakcie. A nevieme, čo je zlého. Nevieme, kde hľadať.
- Kontrolujeme serverové vybavenie. Možno máme rozpadnutý RAID. Možno nám zhorila pamäťová karta. Čokoľvek sa môže stať. Ale nie, servery sú nové, všetko funguje skvele.
- Bežia všetci: administrátori, vývojári a riaditeľ. Nič nepomáha.
- A v istom momente sa všetko náhodou začne samé opravovať.
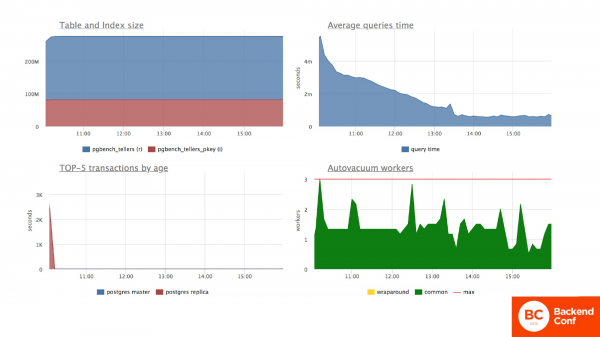
Na replike nám v tom čase požiadavka prebehla a odišla. Dostali sme správu. Biznis je stále spokojný. Ako vidíme, tabuľka nám znova narástla a neplánuje sa zmenšiť. Na grafike so sedením som si nechal kúsok z tejto dlhej transakcie z repliky, aby ste mohli posúdiť, aký dlhý čas prechádza, kým sa situácia stabilizuje.
Sedenie odišlo. A až po nejakom čase sa server dostáva viac-menej do poriadku. A priemerný čas odpovede na požiadavky na Master serveri sa vracia do normy. Pretože konečne, autovakuum dostalo príležitosť vyčistiť, označiť tieto mŕtve riadky. A začalo robiť svoju prácu. A ako rýchlo ju robí, tak rýchlo sa dostaneme do poriadku.
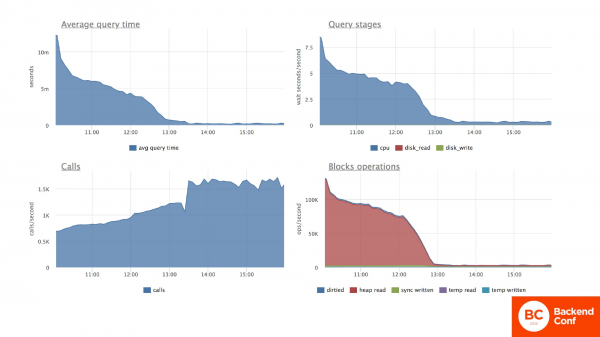
Podľa skúšanej tabuľky, kde aktualizujeme zostatky na účtoch, vidíme presne taký istý obraz. Priemerný čas aktualizácie účtu sa postupne tiež normalizuje. Zdrojové zaťaženie procesora sa tiež znižuje. A počet transakcií za sekundu sa vracia do normy. Ale znova nie do takej normy, ako to bolo pred haváriou.
V každom prípade dostávame pokles výkonnosti ako v prvom prípade, o jeden a pol až dva razy, a niekedy aj viac.
Vyzerá to, že sme všetko urobili správne. Rozdelili sme záťaž. Vybavenie neostáva nečinne. Po rozumne sme rozdelili požiadavky, ale i tak to dopadlo zle.
- Nezahrňovať hot_standby_feedback? Áno, neodporúča sa ho bez závažného dôvodu zapínať. Pretože táto funkcia priamo ovplyvňuje hlavný server a pozastavuje fungovanie autovakuum tam. Ak ho zapnete na nejakej replikácii a zabudnete na to, môžete zabiť hlavný server a naraziť na veľké problémy s aplikáciou.
- Zvýšiť max_standby_streaming_delay? Áno, pre reporty – to áno. Ak máte trojhodinový report a nechcete, aby zlyhal kvôli konfliktom replikácií, proste zvýšte oneskorenie. Dlhodobý report nikdy nevyžaduje dáta, ktoré prišli do databázy práve teraz. Ak je trojhodinový, znamená to, že ho spúšťate za nejaké staré obdobie dát. A pre vás, či to bude tri hodiny oneskorenie alebo šesť hodín, to nebude mať žiadny význam, ale vy budete stabilne dostávať reporty a nebudete mať problémy so zlyhaním.
- Prírodzene, je potrebné kontrolovať dlhé relácie na replikách, najmä ak ste sa rozhodli zapnúť hot_standby_feedback na replikách. Pretože sa môže stať čokoľvek. Dali ste túto replikáciu vývojárovi, aby otestoval dotazy. Napísal bláznivý dotaz. Spustil ho a odišiel na čaj, a my sme dostali zaplnený hlavný server. Alebo sme na to pustili nesprávnu aplikáciu. Situácií je rôznych. Relácie na replikách je potrebné kontrolovať rovnako dôkladne ako na hlavnom serveri.
- A ak máte rýchle a dlhé dotazy na replikách, v tomto prípade je lepšie pre rozloženie zaťaženia rozdeliť ich. Toto je odkaz na streaming_delay. Pre rýchle majte jednu replikáciu s malým oneskorením replikácie. Na dlhé dotazy reportov majte replikáciu, ktorá môže mať oneskorenie až 6 hodín alebo aj 24 hodín. To je úplne normálna situácia.
Odstraňujeme následky tým istým spôsobom:
- Nájdeme nafúknuté tabuľky.
- A komprimujeme ich najvhodnejším nástrojom, ktorý nám vyhovuje.
Druhý príbeh na tomto sa skončil. Prejdeme k tretiemu príbehu.
Tiež dosť bežný pre nás, v ktorom robíme migráciu.
- Každý softvérový produkt rastie. Menia sa požiadavky naň. My sa v každom prípade chceme rozvíjať. A stáva sa, že je potrebné aktualizovať dáta v tabuľke, teda vykonať update v rámci našej migrácie pre novú funkcionalitu, ktorú zavádzame v rámci nášho rozvoja.
- Starý formát dát nevyhovuje. Predpokladajme, že teraz sa obrátime na druhú tabuľku, kde mám operácie s týmito účtami. A predpokladajme, že boli v rubľoch, a rozhodli sme sa zvýšiť presnosť a robiť ich v kopejkách. Na to potrebujeme spraviť aktualizáciu: pole so sumou operácie vynásobiť sto.
- V modernom svete používame automatizované prostriedky na kontrolu verzií databázy. Predpokladajme, . Uvádzame tam našu migráciu. Testujeme ju na našej testovacej databáze. Všetko je skvelé. Aktualizácia prebieha. Blokuje prácu na nejaký čas, ale získavame aktualizované dáta. A môžeme spúšťať nový funkčný prvok na tomto. Všetko sme otestovali, skontrolovali. Všetko potvrdili.
- Prebehli plánované práce, prebehla migrácia.
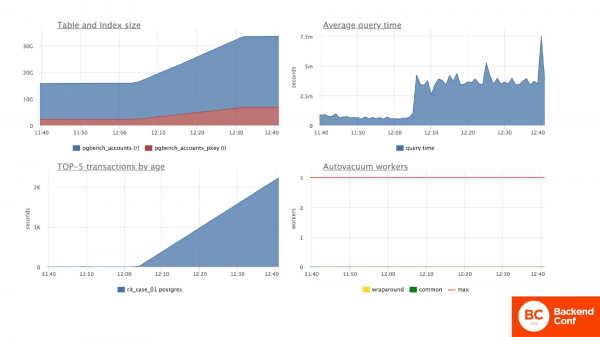
Tu je migrácia s aktualizáciou predstavená pred vami. Keďže ide o operácie na účtoch, tabuľka mala 15 GB. A keďže aktualizujeme každú riadok, aktualizácia zdvojnásobila tabuľku, pretože sme prepísali každú riadok.
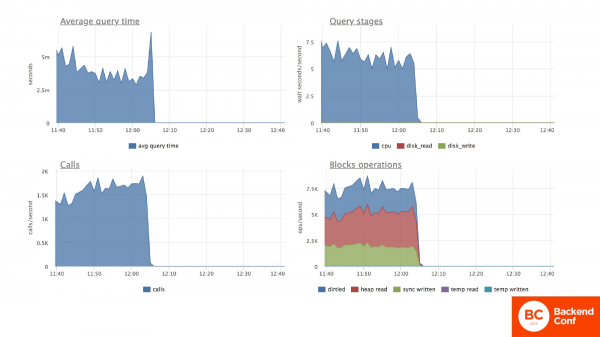
Počas migrácie sme s touto tabuľkou nemohli robiť nič, pretože všetky požiadavky sa čakali v rade a čakali, kým sa táto aktualizácia dokončí. Ale tu chcem upriamiť vašu pozornosť na čísla, ktoré sú na vertikálnej osi. To znamená, že máme priemerný čas požiadavky pred migráciou okolo 5 milisekúnd a zaťaženie procesora, počet blokových operácií pri čítaní pamäte disku je menej ako 7,5.
Prebehla migrácia a opäť sme dostali problémy.
Migrácia prebehla úspešne, ale:
- Starý funkčný prvok začal prebiehať pomalšie.
- Tabuľka opäť nabrala na veľkosti.
- Zaťaženie servera opäť vzrástlo.
- A samozrejme, zatiaľ sa zaoberáme funkčným prvkom, ktorý fungoval dobre, trochu sme ho vylepšili.
A toto je opäť bloat, ktorý nám znovu kazí život.
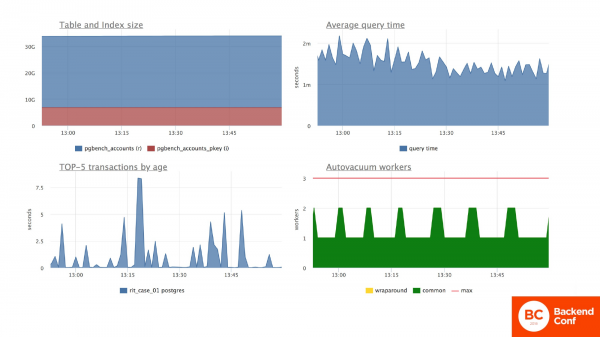
Tu demonštrujem, že tabuľka, ako v predchádzajúcich dvoch prípadoch, nemá v úmysle vrátiť sa k predchádzajúcim rozmerom. Priemerné zaťaženie servera sa zdá byť primerané.
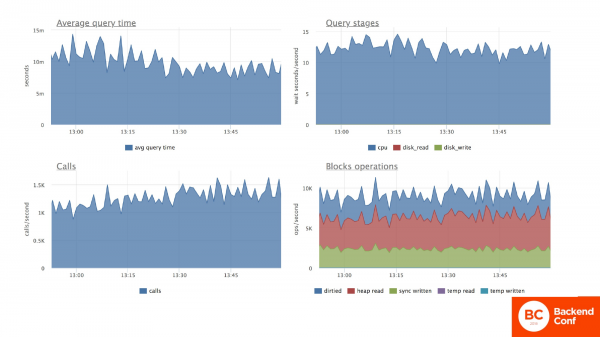
A ak sa pozrieme na tabuľku s účtami, vidíme, že priemerný čas dopytu sa nám zdvojnásobil v tejto tabuľke. Zaťaženie procesora a počet prechádzaných riadkov v pamäti vzrástlo nad 7,5, zatiaľ čo predtým bolo nižšie. A zvýšilo sa to v prípade procesorov dvojnásobne, v prípade blokových operácií 1,5-násobne, teda sme zaznamenali degradáciu výkonnosti servera. A v dôsledku toho aj degradáciu výkonnosti našej aplikácie. Počet volaní pritom zostal na približne rovnakej úrovni.
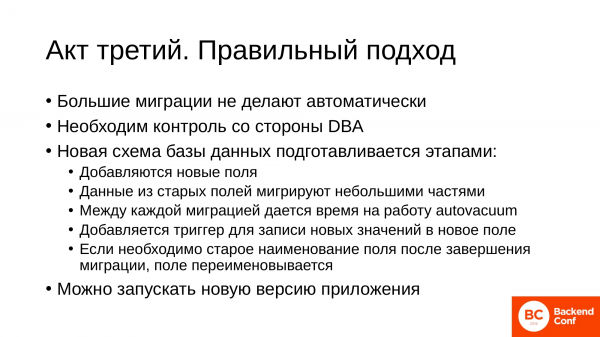
A tu je dôležité pochopiť, ako správne realizovať také migrácie. A tie je potrebné robiť. Tieto migrácie uskutočňujeme pomerne pravidelne.
- Také veľké migrácie nie sú automatické. Vždy by mali byť pod kontrolou.
- Je potrebná kontrola zo strany znalého človeka. Ak máte DBA v tíme, nech to robí DBA. To je jeho práca. Ak nie, nech to robí najskúsenejší človek, ktorý vie, ako pracovať s databázami.
- Nový schéma databázy, aj v prípade, že aktualizujeme jeden stĺpec, je vždy pripravovaná postupne, teda vopred, pred tým, ako sa nasadí nová verzia aplikácie:
- Pridávajú sa nové polia, do ktorých budeme zapisovať práve aktualizované údaje.
- Prenášame údaje zo starého poľa do nového poľa po malých častiach. Prečo to robíme? Predovšetkým, vždy kontrolujeme proces počas tohto procesu. Vieme, že sme preniesli už toľko dávok a zostáva nám toľko.
- A druhý pozitívny efekt spočíva v tom, že medzi každou takouto dávkou uzatvárame transakciu, otvárame novú, a to dáva príležitosť autovakuumu spracovať tabuľku, označiť mŕtve riadky na opätovné použitie.
- Pre riadky, ktoré sa budú objavovať počas práce aplikácie (naša stará aplikácia ešte beží), pridávame spúšťač, ktorý zapisuje nové hodnoty do nových polí. V našom prípade – to je vynásobenie sto starou hodnotou.
- Ak sme naozaj tvrdohlaví a chceme to isté pole, tak po dokončení všetkých migrácií a pred nasadením novej verzie aplikácie jednoducho premenováme polia. Staré na nejaké vymyslené meno, a nové polia premenovávame na staré.
- A až potom spustíme novú verziu aplikácie.
A pritom nezískame bloat a nebudeme mať pokles výkonnosti.
Na tomto sa tretia história skončila.
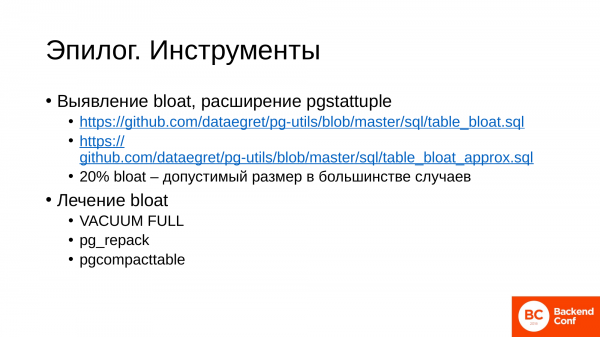
A teraz trochu podrobnejšie o nástrojoch, ktoré som spomenul v prvej histórii.
Pred tým, ako začnete hľadať bloat, je nevyhnutné nainštalovať rozšírenie. .
Aby ste si nemuseli vymýšľať dopyty, my sme už napísali tieto dopyty vo svojej práci. Môžete ich použiť. Tu sú predstavené dva dopyty.
- Prvý trvá dosť dlho, ale ukáže vám presné hodnoty bloat podľa tabuľky.
- Druhý funguje rýchlejšie a je veľmi efektívny, keď treba rýchlo posúdiť – je bloat, alebo nie, podľa tabuľky. A ešte musíte pochopiť, že bloat v tabuľke Postgres je vždy. To je špecifickosť jeho modelu MVCC.
- A 20 % bloat je v mnohých prípadoch normálne pre tabuľky. T. j. nemali by ste sa obávať a zmenšovať túto tabuľku.
Ako identificovať tabuľky, ktoré máme napučané, sme si už vyjasnili, pričom sa to deje, keď napučajú zbytočnými údajmi.
Teraz o tom, ako opraviť bloat:
- Ak máme malú tabuľku a dobré disky, t. j. pre tabuľku do jedného gigabajtu, je celkom možné použiť VACUUM FULL. Vezme si exkluzívnu blokáciu na tabuľku na niekoľko sekúnd a je to v poriadku, zato rýchlo a dôkladne všetko urobí. Čo robí VACUUM FULL? Získa exkluzívnu blokáciu na tabuľku a z pôvodných tabuliek prepíše živé riadky do novej tabuľky. A na konci ich vymení. Staré súbory vymaže, nové nahrádzajú staré. Ale počas svojej práce si získa exkluzívnu blokáciu tabuľky. To znamená, že s touto tabuľkou nebudete môcť nič robiť: ani do nej písať, ani ju čítať, ani ju modifikovať. A VACUUM FULL vyžaduje dodatočné miesto na disku na zápis údajov.
- Ďalší nástroj . Podľa svojho princípu je veľmi podobný VACUUM FULL, pretože aj on prepíše údaje zo starých súborov do nových a nahradí ich v tabuľke. Ale pritom si na začiatku svojej práce neberie exkluzívnu blokáciu na tabuľku, ale len v momente, keď už má pripravené údaje na to, aby nahradil súbory. Požiadavky na disky má podobné ako VACUUM FULL. Potrebujete dodatočné miesto na disku, čo môže byť niekedy kritické, ak máte terabajtové tabuľky. A je celkom náročný na procesor, pretože vedie aktívnu prácu s I/O.
- Tretí nástroj – to je Lieber sa šetrnejším prístupom k zdrojom, pretože funguje na trochu odlišných princípoch. Hlavná podstata pgcompacttable spočíva v tom, že aktualizáciami v tabuľke prenáša všetky živé riadky na začiatok tabuľky. A potom spustí vákuum po tejto tabuľke, pretože vieme, že na začiatku sú živé a na konci mŕtve riadky. A vákuum už samo odstraňuje tento chvost, t. j. nevyžaduje to veľa dodatočného diskového priestoru. A pritom je ešte možné ho z hľadiska zdrojov zmenšiť.
Všetko s nástrojmi.
Ak vás táma bloat zaujme a chcete sa pustiť hlbšie, tu sú niektoré užitočné odkazy:
- – to je prednáška môjho kolegu. Je to všeobecné o tom, kam zmizne miesto v Postgres počas jeho práce a života. Obsahuje veľmi veľký a podrobný technický úsek pre administrátorov databáz o bloat.
- – to je odkaz na náš repozitár, kde máme množstvo užitočných skriptov na kontrolu stavu databázy. Tam nájdete skripty na vyhľadávanie bloat.
- a odkazy na nástroje, ktoré vám pomôžu zmenšiť tabuľky.
- – to je príspevok môjho kolegu. Tam pomerne vážne a podrobne technicky rozoberá bloat, konkrétne na úrovni blízkej k administrátorom.
Tu som sa skôr snažil ukázať hrozný pohľad pre vývojárov, pretože sú našimi bezprostrednými klientmi databáz a mali by rozumieť, aké dôsledky majú ich činnosti. Dúfam, že sa mi to podarilo. Ďakujem za pozornosť!
Otázky
Ďakujem za prednášku! Hovorili ste o tom, ako možno odhaľovať problémy. A ako ich môžeme predchádzať? Mám situáciu, keď sa požiadavky zadrhávali nielen kvôli tomu, že sa obracali na nejaké externé služby. Išlo o podivné joins. Boli tam malé, neškodné požiadavky, ktoré sa zadrhávali celý deň a potom začali robiť nejaké problémy. Veľmi to pripomína to, čo popisujete. Ako to sledovať? Musím neustále sledovať, ktorá požiadavka sa zadrháva? Ako tomu môžeme predchádzať?
V tomto prípade je to úloha pre administrátorov vašej spoločnosti, nie nutne pre DBA.
Som administrátor.
V PostgreSQL existuje pohľad pg_stat_activity, v ktorom sú zobrazené zadrhnuté požiadavky. A môžete vidieť, ako dlho tam visí.
Mám každých 5 minút chodiť kontrolovať?
Nastavte cron a kontrolujte. Ak máte dlhý dotaz, napíšte e-mail a to je všetko. T. j. nemusíte sa na to pozerať očami, dá sa to automatizovať. Dostanete e-mail, na ktorý reagujete. A môžete to aj automaticky posielať preč.
Existujú jasné dôvody, prečo sa to deje?
Niektoré som spomenul. Iné sú zložitejšie príklady. A tam môže byť diskusia dlhá.
Ďakujem za správu! Chcel som sa opýtať na nástroj pg_repack. Ak nerobí exkluzívnu blokáciu, tak…
Robí exkluzívnu blokáciu.
… tak môžem potenciálne prísť o dáta. Môže moja aplikácia nič zapisovať v tom čase?
Nie, tá pracuje bez problémov s tabuľkou, t. j. pg_repack najprv presunie všetky živé riadky, ktoré sú. Samozrejme, tam sa niečo zapisuje do tabuľky. Ten len pridá ten posledný kúsok.
T. j. on nakoniec naozaj robí?
Nakoniec vezme exkluzívnu blokáciu, aby mohol zameniť tieto súbory.
Bude to rýchlejšie ako VACUUM FULL?
VACUUM FULL, hneď ako začne, vezme exkluzívnu blokáciu. A kým to všetko nedokončí, nepustí ju. A pg_repack berie exkluzívnu blokáciu len v momente výmeny súborov. V tom okamihu tam nič nezapíšete, ale dáta sa nestratia, všetko bude v poriadku.
Dobrý deň! Hovorili ste o práci autovaku. Bolo tam schéma s červenými, žltými a zelenými bunkami zaznamenanými. T. j. žlté – označil ich ako odstránené. A následne do nich môžem zapísať nové?
Áno. Postgres neodstráni riadky. Má takú špecifikáciu. Ak sme aktualizovali riadok, starý označíme ako odstránený. Potom sa tam vloží id transakcie, ktorá upravila tento riadok, a zapisujeme nový riadok. A máme relácie, ktoré ich potenciálne môžu čítať. V určitom momente sa už stanú veľmi starými. A podstata práce autovaku spočíva v tom, že prejde cez tieto riadky a označí ich ako nepotrebné. A tam môžeme prepísať dáta.
Pochopil som. Ale otázka nie je úplne o tom. Nedokončil som. Predpokladajme, že máme tabuľku. V nej sú polia s variabilnou veľkosťou. A ak sa pokúsim vložiť niečo nové, môže sa stať, že to do starého poľa jednoducho nevojde.
Nie, v každom prípade sa aktualizuje celý riadok. V Postgres sú dva modely ukladania dát. Ten si vyberá podľa typu dát. Existujú dáta, ktoré sa ukladajú priamo v tabuľke, a sú aj tos-dáta. Toto sú veľké objemy dát: text, json. Ukladajú sa v samostatných tabuľkách. A v týchto tabuľkách sa deje tá istá história s bloat, t. j. úplne to isté. Jednoducho sú oddelené.
Ďakujem za prezentáciu! Ako prijateľné je používať statement timeout na obmedzenie trvania dotazov?
Veľmi prijateľné. Používame to všade. A keďže nemáme vlastné služby, poskytujeme diaľkovú podporu, takže máme pomerne rozmanitých klientov. A všetkých to celkom uspokojuje. T. j. máme úlohy v cron, ktoré to kontrolujú. Jednoducho sa s klientom dohodneme na dĺžke relácií, ktorú nepreťažujeme. Môže to byť minúta, môže to byť 10 minút. Závisí to od záťaže na databáze a jej cieľa. Ale všetci používame pg_stat_activity.
Ďakujem za prezentáciu! Snažím sa prispôsobiť vašu prezentáciu svojim aplikáciám. A zdá sa, že všade začíname transakciu, všade ju jasne končíme. Ak sa vyskytne nejaký exception, aj tak dochádza k rollbacku. A tu som sa zamyslel. Veď transakcia sa môže začať nejasne. To je asi nápoveda pre dievča. Ak len aktualizujem záznam, transakcia sa spustí v PostgreSQL a skončí sa až pri odpojení spojenia?
Ak hovoríte teraz o úrovni aplikácie, tak to závisí od ovládača, ktorý používate, od toho ORM, ktoré sa používa. Tam je veľa nastavení. Ak máte zapnuté auto commit, tak sa tam transakcia začne a hneď aj uzavrie.
T. j. uzavrie sa ihneď po aktualizácii?
Závisí to od nastavení. Jedno nastavenie som nazval. Je to auto commit. Je dosť rozšírené. Ak je zapnuté, tak sa transakcia otvorí a uzavrie. Ak ste jasne nepovedali „start transaction“ a „end transaction“, ale jednoducho ste spustili dotaz v relácii.
Dobrý deň! Ďakujem za prezentáciu! Predstavme si, že máme databázu, ktorá neustále rastie a na serveri sa končí miesto. Existujú nejaké nástroje, ktoré by pomohli túto situáciu vyriešiť?
Miesto na serveri treba správne monitorovať.
Napríklad, DBA šiel piť čaj, bol na dovolenke atď.
Keď sa vytvára súborový systém, vytvorí sa tam minimálne nejaký rezervný priestor, kam sa nepíšu dáta.
A čo ak úplne na nulu?
Tam sa to nazýva rezervovaný priestor, to znamená, že ho môžete oslobodiť a v závislosti od toho, aký veľký ho vytvorili, dostali ste voľné miesto. Predvolene neviem, koľko tam je. Inak treba doručiť disky, aby ste mali miesto na vykonanie obnovovacej operácie. Môžete odstrániť nejakú tabuľku, ktorá vám s určitosťou nie je potrebná.
Nie sú iné nástroje?
Je to vždy ručná práca. A na mieste sa zisťuje, čo tam je lepšie urobiť, pretože sú tam kritické dáta a nekritické. A pre každý databázový systém a aplikáciu, ktorá s ňou pracuje, to závisí od podnikania. Vždy sa to rozhoduje na mieste.
Ďakujem za prednášku! Mám dve otázky. Po prvé, demonštrovali ste snímky, kde sa ukazovalo, že v prípade visiacich transakcií rastie nielen objem tabuľkového priestoru, ale aj veľkosť indexu. A potom v prednáške bolo množstvo utilít, ktoré balia tabuľku. A čo s indexom?
Oni ich tiež balia.
Ale vakuum sa nedotýka indexu?
Niektoré pracujú s indexom. Napríklad pg_rapack, pgcompacttable. Vakuum prekonštruuje indexy, zasahuje do nich. U VACUUM FULL ide o to, aby všetko prepísal, to znamená, že pracuje so všetkým.
A moja druhá otázka. Nechápal som, prečo správy na replikách tak silno závisia od samotnej replikácie. Zdalo sa mi, že správy sú čítanie, a replikácia je zápis.
V čom vzniká konflikt replikácie? Máme Master, na ktorom prebiehajú procesy. Prebieha nám autokvakuum. Autokvakuum, čo vlastne robí? Odstraňuje niektoré staré riadky. Ak v tom čase na replike prebieha dopyt, ktorý číta tieto staré riadky, a na Masteri nastala situácia, že autokvakuum označilo tieto riadky ako možné na prepísanie, potom sme ich prepísali. A dostali sme paket dát, keď musíme prepísať tie riadky, ktoré sú potrebné dopytu na replike, teda proces replikácie počká na ten časový limit, ktorý ste nastavili. Potom PostgreSQL rozhodne, čo je preň dôležitejšie. A replikácia je preň dôležitejšia ako dopyt a on zruší dopyt, aby vykonal tieto zmeny na replike.
Andrej, mám otázku. Tieto úžasné grafy, ktoré ste ukázali počas prezentácie, sú výsledkom vašich prác, nejakej vašej utilitky? Čím ste vytvorili grafy?
Toto je služba .
Je to komerčný produkt?
Áno. Je to komerčný produkt.
Zdroj: habr.com
