

Na úplné zvládnutie Kubernetes je potrebné poznať rôzne spôsoby škálovania klastrových zdrojov: podľa , to je jedna z hlavných úloh Kubernetes. Pripravili sme vysokoúrovňový prehľad mechanizmov horizontálneho a vertikálneho automatického škálovania a zmeny veľkosti klastrov, ako aj odporúčania, ako ich efektívne využiť.
Článok preložil tím, ktorý implementoval automatické škálovanie v .
Prečo je dôležité zamyslieť sa nad škálovaním
— nástroj na správu zdrojov a orchestráciu. Samozrejme, nie je zlé experimentovať s cool funkciami nasadenia, monitorovania a správy podov (modul pod — skupina kontajnerov, ktoré sa spúšťajú na základe požiadavky).
Avšak je potrebné zamyslieť sa aj nad takýmito otázkami:
- Ako škálovať moduly a aplikácie?
- Ako udržiavať kontajnery v prevádzke a efektívnom stave?
- Ako reagovať na neustále zmeny v kóde a pracovných záťažiach od používateľov?
Nastavenie klastrov Kubernetes na vyváženie zdrojov a výkonu môže byť zložitou úlohou, vyžaduje si odborné znalosti o vnútornej práci Kubernetes. Pracovná záťaž na vašu aplikáciu alebo služby sa môže počas dňa alebo aj v priebehu jedinej hodiny meniť, preto sa vyváženie najlepšie chápe ako kontinuálny proces.
Úrovne automatického škálovania Kubernetes
Efektívne automatické škálovanie vyžaduje koordináciu medzi dvoma úrovňami:
- Úroveň podov, vrátane horizontálneho (Horizontal Pod Autoscaler, HPA) a vertikálneho automatického škálovania (Vertical Pod Autoscaler, VPA). Toto je škálovanie existujúcich zdrojov pre vaše kontajnery.
- Úroveň klasteru, ktorú spravuje systém automatického škálovania klasteru (Cluster Autoscaler, CA), ten zvyšuje alebo znižuje počet uzlov v rámci klasteru.
Modul horizontálneho automatického škálovania (HPA)
Ako naznačuje názov, HPA škáluje počet replik podov. Ako spúšťače na zmenu počtu replik, väčšina devopsov používa zaťaženie na procesor a pamäť. Avšak systém je možné škálovať aj na základe , ich alebo aj .
Vysokoúrovňová schéma fungovania HPA:
- HPA neustále kontroluje hodnoty metrík, ktoré sú nastavené pri inštalácii, s predvoleným intervalom 30 sekúnd.
- HPA sa snaží zvýšiť počet modulov, ak je dosiahnutý stanovený prah.
- HPA aktualizuje počet replik v rámci kontroléra nasadenia/replikácie.
- Kontrolér nasadenia/replikácie potom nasadí všetky potrebné ďalšie moduly.
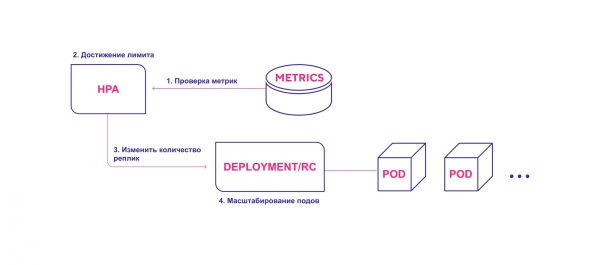
HPA spúšťa proces nasadenia modulov, keď je dosiahnutý prah metrík.
Pri použití HPA berte do úvahy nasledovné:
- Predvolený interval kontroly HPA je 30 sekúnd. Je nastavený pomocou príznaku. horizontal-pod-autoscaler-sync-period v správcovi kontroléra.
- Predpokladaná chyba je predvolene 10%.
- Po poslednom zvýšení počtu modulov HPA čaká na stabilizáciu metrík počas troch minút. Tento interval je nastavený pomocou príznaku. horizontal-pod-autoscaler-upscale-delay.
- Po poslednom znížení počtu modulov HPA čaká na stabilizáciu počas piatich minút. Tento interval je nastavený pomocou príznaku. horizontal-pod-autoscaler-downscale-delay.
- HPA najlepšie funguje s objektmi nasadenia, nie s kontrolérmi replikácie. Horizontálne automatické škálovanie nie je kompatibilné s postupným aktualizovaním (rolling update), ktoré priamo manipuluje s kontrolérmi replikácie. Pri nasadení závisí počet replik priamo od objektov nasadenia.
Vertikálne automatické škálovanie podov.
Vertikálne automatické škálovanie (VPA) prideľuje viac (alebo menej) času CPU alebo pamäte existujúcim podom. Je vhodné pre pody so zachovaním stavu (stateful) alebo bez neho (stateless), ale hlavne je určené pre stateful služby. Môžete však použiť VPA aj pre moduly bez zachovania stavu, ak je potrebné automaticky prispôsobiť objem pôvodne pridelených zdrojov.
VPA tiež reaguje na udalosti OOM (out of memory, nedostatok pamäte). Na zmenu doby procesorového času a objemu pamäte je potrebné reštartovať pody. Pri reštartovaní VPA dodržiava rozpočtovanie distribúcie (), aby zabezpečilo minimálne potrebný počet modulov.
Môžete nastaviť minimálny a maximálny objem zdrojov pre každý modul. Takto môžete obmedziť maximálny objem pridelených pamäťových zdrojov na limit 8 GB. To je užitočné, ak aktuálne uzly nemôžu pridelit viac ako 8 GB pamäte na kontajner. Podrobné špecifikácie a mechanizmus fungovania sú popísané v .
Okrem toho má VPA zaujímavú funkciu odporúčaní (VPA Recommender). Sleduje využívanie zdrojov a OOM udalosti všetkých modulov, aby navrhla nové hodnoty pamäte a procesorového času na základe inteligentného algoritmu s ohľadom na historické metriky. Existuje tiež API, ktoré prijíma deskriptor podu a vracia navrhované hodnoty zdrojov.
Je potrebné poznamenať, že VPA Recommender nesleduje «limit» zdrojov. To môže viesť k tomu, že modul monopolizuje zdroje v rámci uzlov. Je lepšie nastaviť prahovú hodnotu na úrovni priestoru názvov, aby sa predišlo obrovskému spotrebovaniu pamäte alebo procesorového času.
Vysokolevelový schéma fungovania VPA:
- VPA nepretržite kontroluje hodnoty metrík, ktoré sú uvedené pri inštalácii, s predvoleným intervalom 10 sekúnd.
- Ak je dosiahnutý stanovený prah, VPA sa snaží zmeniť pridelené množstvo zdrojov.
- VPA aktualizuje množstvo zdrojov v rámci kontroléru nasadenia/replikácie.
- Pri reštarte modulov, všetky nové zdroje sa aplikujú na vytvorené inštancie.
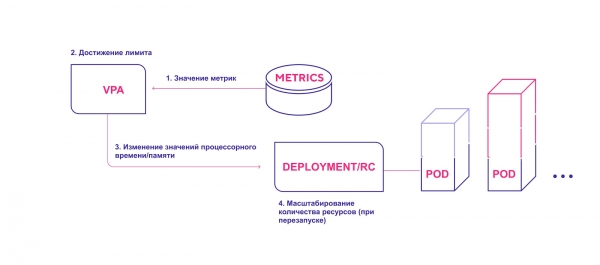
VPA pridáva potrebné množstvo zdrojov
Pamätajte na nasledujúce skutočnosti pri používaní VPA:
- Škálovanie vyžaduje povinné reštartovanie podu. To je potrebné na zabránenie nestabilnej práce po vykonaní zmien. Pre spoľahlivosť sa moduly reštartujú a rozdeľujú po uzloch na základe nových pridelaných zdrojov.
- VPA a HPA sú zatiaľ nekompatibilné navzájom a nemôžu pracovať na rovnakých pody. Ak používate oba mechanizmy škálovania v jednom klastri, uistite sa, že nastavenia im nedovoľujú aktivovať sa na rovnakých objektoch.
- VPA nastavuje požiadavky kontajnerov na zdroje na základe iba minulého a súčasného využitia. Neurčuje limity využitia zdrojov. Môžu nastať problémy s nesprávnou funkciou aplikácií, ktoré začnú zaberať čoraz viac zdrojov, čo povedie k tomu, že Kubernetes vypne tento pod.
- VPA je zatiaľ vo fáze raného vývoja. Buďte pripravení, že v blízkej dobe môže systém prejsť niektorými zmenami. Môžete si prečítať o a . Tak v plánoch je realizovať spoluprácu VPA a HPA, ako aj nasadenie modulov spolu s politikou vertikálneho automatického škálovania pre ne (napríklad špeciálna značka 'requires VPA').
Automatické škálovanie klastru Kubernetes
Automatické škálovanie klastru (Cluster Autoscaler, CA) mení počet uzlov na základe počtu čakajúcich modulov pod. Systém pravidelne kontroluje existenciu čakajúcich modulov — a zvyšuje veľkosť klastru, ak sú potrebné ďalšie zdroje a ak klaster neprekračuje stanovené limity. CA komunikuje s poskytovateľom cloudových služieb, žiada o ďalšie uzly alebo uvoľňuje neaktívne. Prvá verejná verzia CA bola predstavená v Kubernetes 1.8.
Vysokoúrovňový schematický prehľad CA:
- CA kontroluje existenciu modulov v stave čakania s predvolenej periódou 10 sekúnd.
- Ak je jeden alebo viac modulov v stave čakania kvôli nedostatočným dostupným zdrojom v klastri na ich rozdelenie, snaží sa pripraviť jeden alebo viac dodatočných uzlov.
- Keď poskytovateľ cloudových služieb pridelí potrebný uzol, ten sa pripojí ku klastru a je pripravený obsluhovať moduly pod.
- Plánovač Kubernetes rozdeľuje čakajúce moduly na nový uzol. Ak po tomto niektoré moduly stále zostávajú v stave čakania, proces sa opakuje — a do klastru sa pridávajú nové uzly.
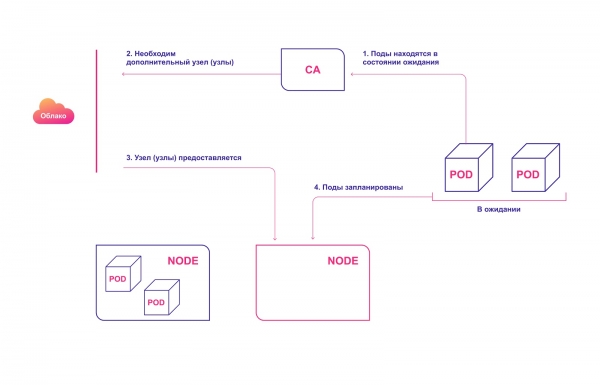
Automatické prideľovanie uzlov klastru v cloude
Zvážte nasledujúce pri používaní CA:
- CA zabezpečuje, že všetky moduly v klastri majú miesto na spustenie, bez ohľadu na úroveň zaťaženia procesora. Okrem toho sa snaží zabezpečiť, že v klastri nie sú zbytočné uzly.
- CA registruje potrebu škálovania približne po 30 sekundách.
- Keď uzol prestane byť potrebný, CA predvolene čaká 10 minút, skôr než začne škálovať systém.
- V systéme automatického škálovania existuje pojem rozšírení (expanders). To sú rôzne stratégie na výber skupiny uzlov, do ktorej budú pridané nové.
- Zodpovedne aplikujte možnosť cluster-autoscaler.kubernetes.io/safe-to-evict (true). Ak umiestnite veľa podov alebo ak sú mnohé z nich rozptýlené po všetkých uzloch, značne stratíte možnosť zmenšiť škálu klasteru.
- Použite , aby ste zabránili odstraňovaniu podov, ktoré by mohlo spôsobiť, že časť vašej aplikácie úplne zlyhá.
Ako systémy automatického škálovania Kubernetes interagujú medzi sebou
Pre ideálnu harmóniu je potrebné aplikovať automatické škálovanie na úrovni podov (HPA/VPA) aj na úrovni klasteru. Relatívne jednoducho spolu interagujú:
- HPA alebo VPA aktualizujú repliky podov alebo zdroje pridelené existujúcim podom.
- Ak pri plánovanom škálovaní chýbajú uzly, CA si všimne, že existujú podi v čakajúcom stave.
- CA prideľuje nové uzly.
- Moduly sú prerozdelené na nové uzly.
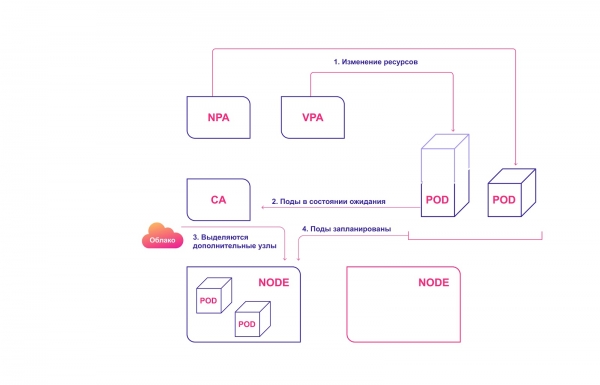
Spoločný systém systémov škálovania Kubernetes
Typické chyby v automatickom škálovaní Kubernetes
Existuje niekoľko typických problémov, s ktorými sa devops profesionáli stretávajú, keď sa snažia použiť automatické škálovanie.
HPA a VPA závisia od metriky a niektorých historických údajov. Ak je pridelených nedostatočne zdrojov, moduly budú znížené a nebudú schopné generovať metriky. V tomto prípade nikdy nedôjde k automatickému škálovaniu.
Samotná operácia škálovania je citlivá na čas. Chceme, aby sa moduly a klaster škálovali rýchlo - skôr, než si používateľia všimnú nejaké problémy a poruchy. Preto je potrebné zohľadniť priemerný čas škálovania podov a klasteru.
Ideálny scenár - 4 minúty:
- 30 sekúnd. Aktualizácia cieľových metrík: 30−60 sekúnd.
- 30 sekúnd. HPA kontroluje hodnoty metrík: 30 sekúnd.
- Menej ako 2 sekundy. Moduly pod sú vytvorené a prechádzajú do čakajúceho stavu: 1 sekunda.
- Menej ako 2 sekundy. CA vidí čakajúce moduly a odosiela požiadavky na prípravu uzlov: 1 sekunda.
- 3 minúty. Cloudový poskytovateľ prideľuje uzly. K8s čaká, kým budú pripravené: až 10 minút (závisí od niekoľkých faktorov).
Najhorší (realistickejší) scenár — 12 minút:
- 30 sekúnd. Aktualizácia cieľových metrik.
- 30 sekúnd. HPA kontroluje hodnoty metrik.
- Menej ako 2 sekundy. Pod moduly sú vytvorené a prechádzajú do stavu čakajúceho.
- Menej ako 2 sekundy. CA vidí čakajúce moduly a posiela požiadavky na prípravu uzlov.
- 10 minút. Cloudový poskytovateľ prideľuje uzly. K8s čaká, kým budú pripravené. Čas čakania závisí od niekoľkých faktorov, ako sú oneskorenie poskytovateľa, oneskorenie OS, prevádzka pomocných nástrojov.
Nemieňte mechanizmy automatického škálovania cloudových poskytovateľov s našou CA. Posledná pracuje v rámci klastra Kubernetes, zatiaľ čo mechanizmus cloudového poskytovateľa funguje na základe distribúcie uzlov. Nevie, čo sa deje s vašimi podmi alebo aplikáciou. Tieto systémy fungujú paralelne.
Ako spravovať škálovanie v Kubernetes
- Kubernetes je nástroj na správu zdrojov a orchestráciu. Operácie so správou podov a zdrojov klastra sú kľúčovým míľnikom pri osvojovaní Kubernetes.
- Osvojte si logiku škálovateľnosti podov s ohľadom na HPA a VPA.
- CA stojí za to použiť len vtedy, ak dobre rozumiete potrebám svojich podov a kontajnerov.
- Pre optimálnu konfiguráciu klastra je potrebné pochopiť, ako rôzne škálovacie systémy fungujú spolu.
- Pri hodnotení času škálovania majte na pamäti najhorší a najlepší scenár.
Zdroj: habr.com
