

Dnes už pravdepodobne nikto nepochybuje o tom, prečo je potrebné zbierať metriky služieb. Ďalším logickým krokom je nastaviť alerting na zbierané metriky, ktorý vás bude informovať o akýchkoľvek odchýlkach v údajoch prostredníctvom vám vyhovujúcich kanálov (e-mail, Slack, Telegram). V online rezervačnej službe hotelov všetky metriky našich služieb sa ukladajú do InfluxDB a zobrazujú v Grafane, kde je tiež nastavený základný alerting. Na úlohy typu „potrebujem niečo vypočítať a porovnať to“ používame Kapacitor.
Kapacitor je súčasťou TICK stacku, ktorý dokáže spracovávať metriky z InfluxDB. Môže spojiť niekoľko meraní (join), z získaných údajov vypočítať niečo užitočné, zapísať výsledok späť do InfluxDB, poslať alert do Slacku/Telegramu/e-mailu.
Celý stack má skvelú a podrobnú , ale vždy sa nájdu užitočné informácie, ktoré nie sú jasne uvedené v príručkách. V tomto článku som sa rozhodol zhromaždiť niekoľko takýchto užitočných a nie úplne zrejmých tipov (základná syntax TICKscript je opísaná ) a ukázať, ako ich možno aplikovať na príklade riešenia jedného z našich úloh.
Ideme na to!
float & int, chyby vo výpočtoch
Absolútne štandardný problém, ktorý sa dá vyriešiť pomocou konverzie:
var alert_float = 5.0
var alert_int = 10
data|eval(lambda: float("value") > alert_float OR float("value") < float("alert_int"))
Používanie default()
Ak nie je vyplnený tag/pole, vzniknú chyby vo výpočtoch:
|default()
        .tag('status', 'empty')
        .field('value', 0)
fill v join (inner vs outer)
Podľa predvoleného nastavenia join odfiltrováva body, kde chýbajú dáta (inner).
Pri fill(‘null’) sa vykoná outer join, po ktorom je potrebné realizovať default() a vyplniť prázdne hodnoty:
var data = res1
    |join(res2)
        .as('res1', 'res2')
        .fill('null')
    |default()
        .field('res1.value', 0.0)
        .field('res2.value', 100.0)
Tu je však jeden detail. Ak bude v príklade vyššie jedna z sérií (res1 alebo res2) prázdna, výsledná séria (data) bude tiež prázdna. Na túto tému sú na GitHub-e niekoľko tiketov (, , ) – čakáme na opravy a trochu trpíme.
Používanie podmienok vo výpočtoch (if v lambda)
|eval(lambda: if("value" > 0, true, false)
Posledných päť minút z pipeline za obdobie
Napríklad potrebujete porovnať hodnoty z posledných piatich minút s predchádzajúcim týždňom. Môžete získať dve dávky dát dvoma samostatnými batchmi alebo vyťažiť časť dát z väčšieho obdobia:
|where(lambda: duration((unixNano(now()) - unixNano("time"))/1000, 1u) < 5m)
Alternatíva pre posledných päť minút môže byť použitie uzla BarrierNode, ktorý odrezáva dáta skôr, ako je určený čas:
|barrier()
        .period(5m)
Príklady použitia Gošských šablón v správe
Šablóny zodpovedajú formátu z balíka , nižšie niekoľko bežne sa vyskytujúcich úloh.
if-else
Usporiadame poriadok, netrigrujeme ľudí textom zbytočne:
|alert()
    ...
    .message(
        '{{ if eq .Level "OK" }}Je to teraz v poriadku{{ else }}Šéf, všetko je rozbité{{end}}'
    )
Dve číslice za desatinnou čiarkou v správe
Zlepšujeme čitateľnosť správy:
|alert()
    ...
    .message(
        'teraz hodnota je {{ index .Fields "value" | printf "%0.2f" }}'
    )
Rozbaľovanie premenných v správe
Zobrazujeme v správe viac informácií na odpoveď na otázku „Prečo to kričí?“
var warnAlert = 10
  |alert()
    ...
    .message(
       'Dnešná hodnota menšia než '+string(warnAlert)+'%'
    )
Jedinečný identifikátor alertu
Potrebná vec, keď sú v dátach viac ako jedna skupina, inak bude generovaný len jeden alert:
|alert()
      ...
      .id('{{ index .Tags "myname" }}\/{{ index .Tags "myfield" }}')
Vlastné handler’i
V veľkom zozname handlerov je exec, ktorý umožňuje vykonať svoj skript s odovzdanými parametrami (stdin) – len kreativita!
Jedným z našich vlastných riešení je malý pythonový skript na odosielanie upozornení do Slacku.
Najskôr sme chceli odoslať do správy obrázok z Grafany, chránený autorizáciou. Potom – písať OK do vlákna predchádzajúceho alertu zo tej istej skupiny, a nie ako samostatnú správu. Ešte o niečo neskôr – dopisovať do správy najčastejšiu chybu za posledných X minút.
Samostatná téma – spojenie s inými službami a akékoľvek akcie iniciované alertom (len ak vaše monitorovanie funguje dostatočne dobre).
Príklad popisu handlera, kde slack_handler.py – náš vlastný skript:
topic: slack_graph
id: slack_graph.alert
match: level() != INFO AND changed() == TRUE
kind: exec
options:
  prog: \/sbin\/slack_handler.py
  args: ["-c", "CHANNELID", "--graph", "--search"]
Ako debagovať?
Varianta s výstupom do logu
|log()
      .level("error")
      .prefix("something")
Pozerať (cli): kapacitor -url :9092 logs lvl=error
Varianta s httpOut
Zobrazuje dáta v aktuálnom pipeline:
|httpOut('niečo')
Pozerať (get): :9092\/kapacitor\/v1\/tasks\/task_name\/niečo
Schéma vykonávania
- Každá úloha vracia strom vykonávania s užitočnými číslami v formáte .
- Bereme blok .
- Vkladáme do prehliadača, .
Kde ešte môžeme získať dáta
timestamp v influxdb pri spätnom zápise
Napríklad nastavujeme alert na počet požiadaviek za hodinu (groupBy(1h)) a chceme zapísať vzniknutý alert do influxdb (aby sme pekne ukázali existenciu problému na grafe v grafana).
influxDBOut() zapíše do timestamp hodnotu time z alertu, takže bod na grafe bude zapísaný skôr/neskôr, než prišiel alert.
Keď je potrebná presnosť: obchádzame tento problém cez volanie vlastného handlera, ktorý zapíše dáta do influxdb s aktuálnym timestampom.
docker, zostavenie a nasadenie
Pri štarte kapacitor môže podávať úlohy, šablóny a handlery z adresára, ktorý je zadaný v konfigurácii v bloku [load].
Pre správne vytvorenie úlohy sú potrebné nasledujúce veci:
- Názov súboru – rozvíja sa na id/názov skriptu
- Typ – stream/batch
- dbrp – kľúčové slovo na označenie, v akej databáze + politike skript pracuje (dbrp «supplier».«autogen»)
Ak v nejakej batch-úlohe nebude riadok s dbrp, celý servis sa odmietne spustiť a poctivo o tom napíše do logu.
V chronografe však táto riadok byť nemá, cez rozhranie nie je akceptovaná a vydáva chybu.
Hack pri zostavovaní kontajnera: Dockerfile vychádza s -1, ak existujú riadky s //.+dbrp, čo umožní hneď zistiť príčinu zlyhania pri zostavení buildu.
join jeden k mnohým
Úloha-príklad: treba zobrať 95. percentil času prevádzky služby za týždeň, porovnať každú minútu z posledných 10 s touto hodnotou.
Nemožno urobiť join jeden k mnohým, last/mean/median podľa skupiny bodov mení uzol na stream, vráti sa chyba «cannot add child mismatched edges: batch -> stream».
Výsledok batchu, ako premenná v lambda-vyjadrení, sa tiež nezapadá.
Je možnosť ukladať potrebné čísla z prvého batchu do súboru cez udf a nahrávať tento súbor cez sideload.
Čo sme týmto riešili?
Máme približne 100 dodávateľov hotelov, ku každému z nich môže byť niekoľko pripojení, nazvime to kanálom. Týchto kanálov je približne 300, každý kanál môže vypadnúť. Z všetkých zapisovaných metrik budeme monitorovať mieru chýb (requests a errors).
Prečo nie grafana?
Alerte o chybách, nastavené v grafane, majú niekoľko nedostatkov. Niektoré súkritické, na niektoré sa dá zavrieť oči, v závislosti od situácie.
Grafana nevie vykonávať výpočty medzi mierami + alerting, a potrebujeme predsa mieru (requests-errors)/requests.
Chyby vyzerajú zlovestne:
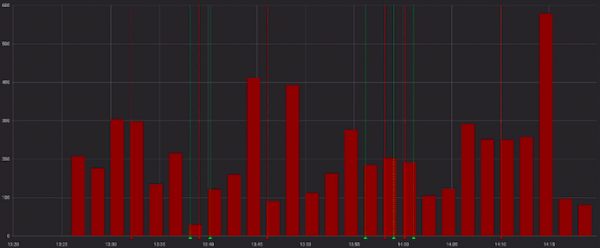
A menej zlovestne, ak sa pozrieme s úspešnými požiadavkami:
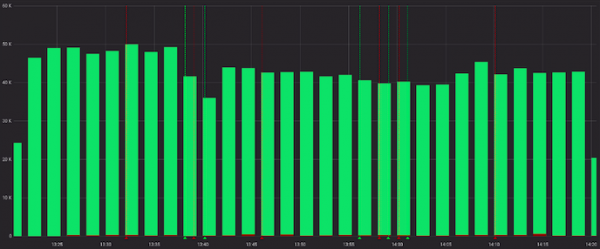
Dobre, môžeme predbežne vypočítať sadzbu v službe pred Grafanou, a v niektorých prípadoch to bude vyhovovať. Ale nie v našom prípade, pretože pre každý kanál sa považuje za „normálne“ iné rozloženie, a alarmy fungujú na statických hodnotách (hľadáme očami, meníme, ak príliš často upozorňuje).
Toto sú príklady „normálne“ pre rôzne kanály:
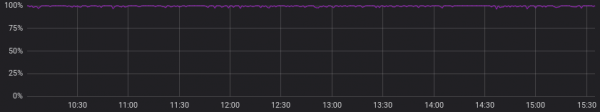
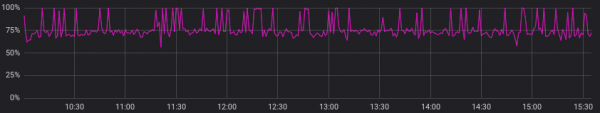
Zanedbávame predchádzajúci bod a predpokladáme, že u všetkých poskytovateľov je „normálny“ obraz podobný. Teraz je všetko v poriadku, a môžeme sa zaobísť bez alarmov v Grafane?
Môžeme, ale veľmi sa nám nechce, pretože musíme vybrať jednu z možností:
a) urobiť množstvo grafov pre každý kanál zvlášť (a mučiť sa s ich údržbou)
b) nechať jeden graf so všetkými kanálmi (a stratiť sa v farebných líniách a nastavených alarmoch)
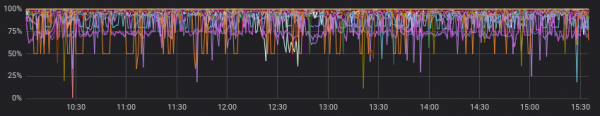
Ako sme to urobili?
Opäť, v dokumentácii je dobrý štartovací príklad () môžeme sa inšpirovať alebo vziať ako základ pre podobné úlohy.
Čo sme nakoniec urobili:
- zlúčenie dvoch sérií počas niekoľkých hodín, skupinovanie podľa kanálov;
- vyplníme série podľa skupín, ak neboli dáta;
- porovnávame medián posledných 10 minút s predchádzajúcimi údajmi;
- kričíme, ak niečo objavíme;
- zapíšeme vypočítané sadzby a zobrazené alarmy do influxdb;
- pošleme užitočnú správu do Slacku.
Podľa môjho názoru sme dosiahli maximum krásy vo všetkom, čo sme chceli získať (a dokonca aj trochu viac s vlastnými obsluhami).
Na github.com si môžete pozrieť a získaného skriptu.
Príklad konečného kódu:
dbrp "supplier"."autogen"
var name = 'requests.rate'
var grafana_dash = 'pczpmYZWU/mydashboard'
var grafana_panel = '26'
var period = 8h
var todayPeriod = 10m
var every = 1m
var warnAlert = 15
var warnReset = 5
var reqQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."requests"'
var errQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."errors"'

var prevErr = batch
 |query(errQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var prevReq = batch
 |query(reqQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var rates = prevReq
 |join(prevErr)
 .as('req', 'err')
 .tolerance(1m)
 .fill('null')
 // vyplniť hodnoty nulami, ak neexistovali
 |default()
 .field('err.value', 0.0)
 .field('req.value', 0.0)
 // ak v lambda: počítame rate, len ak existovali chyby
 |eval(lambda: if("err.value" > 0, 100.0 * (float("req.value") - float("err.value")) / float("req.value"), 100.0))
 .as('rate')

// zapisujeme vypočítané hodnoty do InfluxDB
rates
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('rates')

// vyberáme dáta za posledných 10 minút, počítame medián
var todayRate = rates
 |where(lambda: duration((unixNano(now()) - unixNano("time")) / 1000, 1u)  warnAlert)
 .warnReset(lambda: ("prev.median" - "today.median") < warnReset)
 .flapping(0.25, 0.5)
 .stateChangesOnly()
 // zbierame do správy odkaz na grafiku dashboardu Grafany
 .message(
 '{{ .Level }}: {{ index .Tags "channel" }} err/req ratio ({{ index .Tags "supplier" }})
{{ if eq .Level "OK" }}Je to v poriadku teraz{{ else }}
'+string(todayPeriod)+' medián je {{ index .Fields "today.median" | printf "%0.2f" }}%, za predchádzajúce '+string(period)+' je {{ index .Fields "prev.median" | printf "%0.2f" }}%{{ end }}
http://grafana.ostrovok.in/d/'+string(grafana_dash)+
'?var-supplier={{ index .Tags "supplier" }}&var-channel={{ index .Tags "channel" }}&panelId='+string(grafana_panel)+'&fullscreen&tz=UTC0300'
 )
 .id('{{ index .Tags "name" }}\/{{ index .Tags "channel" }}')
 .levelTag('level')
 .messageField('message')
 .durationField('duration')
 .topic('slack_graph')

// "today.median" duplikujeme ako "value", taktiež zapisujeme do InfluxDB ďalšie polia alertu (keep)
trigger
 |eval(lambda: "today.median")
 .as('value')
 .keep()
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('alerts')
 .tag('alertName', name)
A aký je výsledok?
Kapacitor excelentne zvláda monitoring a alerting s množstvom grupovaní, vykonávať dodatočné výpočty na už zapísaných metrikách, vykonávať vlastné akcie a spúšťať skripty (udf).
Prahová úroveň nie je veľmi vysoká – vyskúšajte to, ak Grafana alebo iné nástroje úplne nevyhovujú vašim požiadavkám.
Zdroj: habr.com
