

Čo by ste cítili, keby v jednom krásnom letnom dni dátové centrum s vaším vybavením vyzeralo takto?
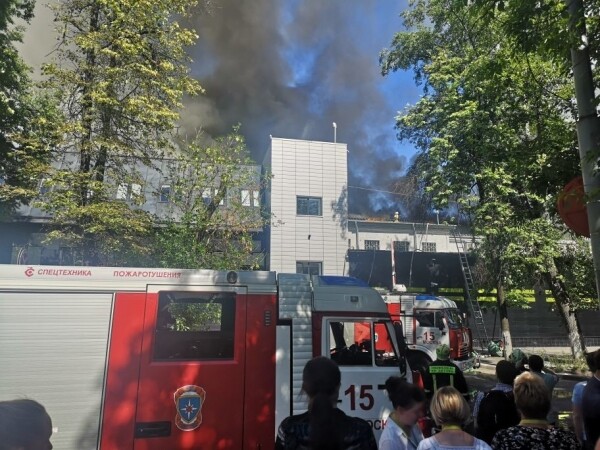
Ahojte všetci! Volám sa Dmitrij Samsonov, pracujem ako hlavný systémový administrátor v "". Na obrázku je jedno zo štyroch dátových centier, kde je nainštalované vybavenie na podporu nášho projektu. Za týmito stenami sa nachádza približne 4000 kusov vybavenia: servery, systém na ukladanie dát, sieťové vybavenie atď. — takmer ⅓ celého nášho vybavenia.
Väčšina serverov beží na Linuxe. Máme aj niekoľko desiatok serverov na Windows (MS SQL) — naše dedičstvo, ktorého sa plánujeme zbaviť už dlhé roky.
Dňa 5. júna 2019 o 14:35 inžinieri jedného z našich dátových centier oznámili požiarne poplach.
Odpor
14:45. Malé incidenty so zadymením v dátových centrách sa stávajú častejšie, než sa zdá. Ukazovatele vo vnútri miestností boli v norme, preto bola naša prvá reakcia relatívne pokojná: zaviedli sme zákaz na práce s produkciou, teda na akékoľvek zmeny konfigurácií, zavádzanie nových verzií atď., s výnimkou prác súvisiacich s opravou niečoho.
Hnev
Skúsili ste niekedy zistiť od hasičov, kde presne na streche došlo k požiaru, alebo sa sami pokúsiť dostať na horiacu strechu, aby ste posúdili situáciu? Aká bude úroveň dôvery k informáciám získaným prostredníctvom piatich ľudí?
14:50. Prišla informácia, že oheň sa blíži k systému chladenia. Dostane sa však k nemu? Prieduchový systémový administrátor presmerováva externý traffic z frontov tohto dátového centra.
V súčasnosti sú fronty všetkých našich služieb duplicitné v troch dátových centrách, používame vyvažovanie na úrovni DNS, čo umožňuje odstrániť adresy jedného dátového centra z DNS, a tým ochrániť používateľov pred potenciálnymi problémami s prístupom k službám. V prípade, že problémy v dátovom centre už nastali, automaticky sa vyraďuje z rotácie. Podrobnejšie si môžete prečítať tu:
Požiar nás zatiaľ nijako neovplyvnil — ani používateľov, ani vybavenie nepostihli. Je to havária? Prvá časť dokumentu „Plán reakcie na haváriu“ definuje pojem „Havária“, a končí takto:
«Ak sú pochybnosti, či ide o haváriu alebo nie, je to havária!»
14:53. Určuje sa koordinátor havárie.
Koordinátor je osoba, ktorá kontroluje komunikáciu medzi všetkými účastníkmi, vyhodnocuje rozsah havárie, využíva "Plán opatrení pri havárii", zapája potrebný personál, riadi dokončenie opráv, a najmä deleguje akékoľvek úlohy. Inými slovami, je to osoba, ktorá riadi celý proces likvidácie havárie.
Tendrové konanie
15:01. Začínáme odpojiť servery, ktoré nie sú pripojené na produkciu.
15:03. Správne vypíname všetky rezervované služby.
Sem patrí nielen fronty (na ktoré k tomuto momentu používatelia už nevstupujú) a ich pomocné služby (biznis logika, cache a pod.), ale aj rôzne databázy s replikáciou 2 a viac (, , , a iné).
15:06. Prišla informácia, že požiar ohrozuje jednu z miestností dátového centra. V tejto miestnosti nemáme žiadne zariadenie, ale to, že oheň môže preskočiť z plachty na miestnosti, vážne mení obrázok situácie.
(Neskôr sa ukázalo, že fyzická hrozba pre miestnosť neexistovala, pretože bola hermeticky izolovaná od strechy. Hrozbou bola iba pre systém chladenia tejto miestnosti.)
15:07. Umožňujeme vykonávanie príkazov na serveroch v urýchlenom režime bez dodatočných kontrol ().
15:08. Teplota v miestnostiach je v normále.
15:12. Zaznamenané zvýšenie teploty v miestnostiach.
15:13. Viac ako polovica serverov v dátovom centre je vypnutá. Pokračujeme.
15:16. Bolo prijaté rozhodnutie o vypnutí všetkého zariadenia.
15:21. Začína sa odpojenie napájania na stateless serveroch bez správneho vypnutia aplikácie a operačného systému.
15:23. Vytvorená skupina zodpovedných za MS SQL (je ich málo, závislosť služieb na nich nie je veľká, ale procedúra obnovenia funkčnosti trvá dlhšie a je zložitejšia ako, napríklad, u Cassandry).
Depresia
15:25. Prišla informácia o vypnutí napájania v štyroch miestnostiach z 16 (č. 6, 7, 8, 9). V 7. a 8. miestnostiach sa nachádza naše vybavenie. O ďalších dvoch našich miestnostiach (č. 1 a 3) zatiaľ nemáme informácie.
Obvykle sa pri požiaroch napájanie okamžite vypína, ale v tomto prípade, vďaka koordinovanej práci hasičov a technického personálu dátového centra, ho nevypínali všade a okamžite, ale podľa potreby.
(Neskôr sa ukázalo, že napájanie v halách 8 a 9 nebolo vypnuté.)
15:28. Začíname rozvíjať databázy MS SQL z backupov v iných dátových centrách.
Koľko času to zaberie? Bude kapacita siete dostatočná na celom trase?
15:37. Boli zaznamenané výpadky niektorých častí siete.
Manažment a produkčná sieť sú fyzicky izolované. Ak je produkčná sieť dostupná, môžete sa prihlásiť na server, zastaviť aplikáciu a vypnúť OS. Ak je nedostupná, môžete sa prihlásiť cez IPMI, zastaviť aplikáciu a vypnúť OS. Ak nie je dostupná ani jedna sieť, nič nemôžete urobiť. "Ďakujem, kapitán!" — pomyslíte si.
"A vôbec, je tu akosi veľa chaosu," — pomyslíte si možno aj vy.
Ide o to, že servery aj bez požiaru vytvárajú obrovské množstvo tepla. Presnejšie, keď je chladenie, vytvárajú teplo, a keď nie je, vytvárajú peklo, ktoré v najlepšom prípade roztopí časť vybavenia a vylúči inú časť, a v najhoršom… spôsobí požiar vo vnútri haly, ktorý takmer zaručene zničí všetko.
15:39. Zaznamenáva problémy s databázou conf.
Databáza conf je backend pre rovnomennú službu, ktorú používajú všetky aplikácie v produkcii na operatívne zmeny nastavení. Bez tejto databázy nemôžeme spravovať chod portálu, ale samotný portál môže fungovať.
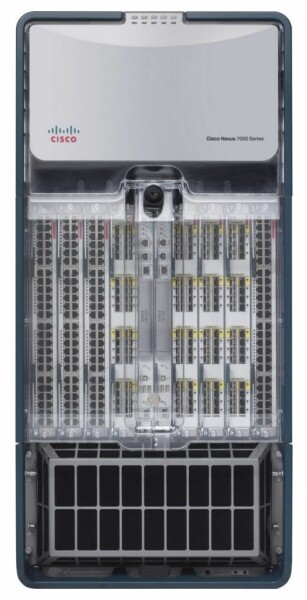
15:41. Teplotné senzory na Core sieťovej technológii zaznamenávajú hodnoty blízke k maximu. Ide o krabicu, ktorá zabera celú skrinku a zabezpečuje chod všetkých sietí v rámci dátového centra.
15:42. Issue tracker a wiki sú nedostupné, prechádzame na standby.
Toto nie je produkcia, ale pri havárii môže byť dostupnosť akejkoľvek knowledge base kritická.
15:50. Vypnula sa jedna zo systémov monitorovania.
Je ich niekoľko a každý z nich zodpovedá za rôzne aspekty fungovania služieb. Časť z nich je nastavená na autonómny chod v rámci každého dátového centra (t.j. monitorujú len svoje dátové centrum), iné sa skladajú z distribuovaných komponentov, ktoré bezproblémovo prežijú stratu akéhokoľvek dátového centra.
V tomto prípade prestala fungovať , ktorý pracuje v režime master-standby. Prepli sme sa na standby.
Prijatie
15:51. Cez IPMI sme vypnuli všetky servery bez správneho ukončenia práce, okrem MS SQL.
Ste pripravení na hromadné riadenie serverov prostredníctvom IPMI v prípade potreby?
To je ten okamih, keď je záchrana zariadenia v dátovom centre v tomto štádiu dokončená. Všetko, čo sa dalo urobiť, bolo urobené. Niektorí kolegovia si môžu oddýchnuť.
16:13. Prijali sme informácie, že na streche praskli potrubia chladiva z klimatizácií – to oddiali spustenie dátového centra po odstránení požiaru.
16:19. Podľa údajov získaných od technického personálu dátového centra sa prestalo zvyšovať teplo v miestnostiach.
17:10. Obnovili sme prácu databázy conf. Teraz môžeme zmeniť nastavenia aplikácií.
Prečo je to také dôležité, ak je všetko odolné voči poruchám a funguje aj bez jedného dátového centra?
Po prvé, nie všetko je odolné voči poruchám. Existujú rôzne sekundárne služby, ktoré zatiaľ dostatočne dobre neprežívajú zlyhanie dátového centra, a sú databázy v režime master-standby. Možnosť spravovať nastavenia umožňuje urobiť všetko potrebné, aby sme aj v náročných podmienkach minimalizovali vplyv následkov havárie na používateľov.
Po druhé, je jasné, že v najbližších hodinách sa práca dátového centra úplne neobnoví, preto bolo potrebné prijať opatrenia, aby dlhodobá nedostupnosť replik neviedla k ďalším nepríjemnostiam ako preplnenie diskov v zostávajúcich dátových centrách.
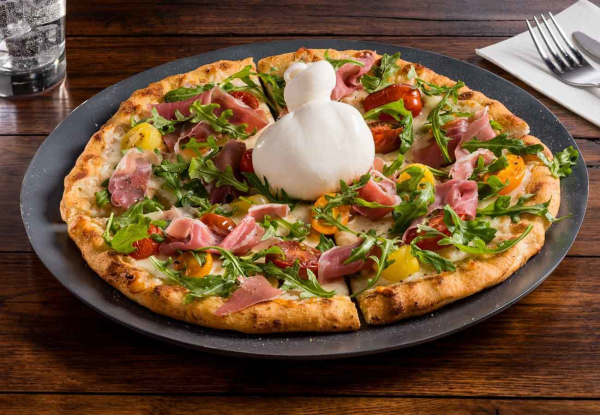
17:29. Čas na pizzu! U nás pracujú ľudia, nie roboti.
Rehabilitácia
18:02. V miestnostiach č. 8 (naša), 9, 10 a 11 sa stabilizovala teplota. V jednej z miestností, ktorá zostáva vypnutá (č. 7), sa nachádza naše vybavenie a teplota tam naďalej stúpa.
18:31. Dali sme súhlas na spustenie vybavenia v miestnostiach č. 1 a 3 – tieto miestnosti nezasiahla пожар.
V súčasnosti prebieha spustenie serverov v miestnostiach č. 1, 3, 8, počnúc tými najkritickejšími. Kontroluje sa správnosť fungovania všetkých spustených služieb. Problémy s miestnosťou č. 7 stále pretrvávajú.
18:44. Technický personál dátového centra zistil, že v miestnosti č. 7 (kde sa nachádza iba naše vybavenie) mnohé servery nie sú vypnuté. Podľa našich údajov zostáva zapnutých 26 serverov. Po opätovnej kontrole zistíme 58 serverov.
20:18. Technický personál dátového centra vhání vzduch do miestnosti bez klimatizácií cez mobilné vzduchovody, ktoré sú privedené cez chodby.
23:08. Prvého administrátora pustili domov. Niekto musí v noci spať, aby zajtra pokračoval v práci. Ďalej uvoľňujeme ďalších niekoľkých administrátorov a vývojárov.
02:56. Spustili sme všetko, čo sa dalo spustiť. Robíme veľkú kontrolu všetkých služieb automatizovanými testami.
03:02. Klimatizácia v poslednej, 7. miestnosti bola obnovená.
03:36. Fronty v dátovom centre boli pridané do DNS. Od tejto chvíle začne prichádzať používateľský trafík.
Uvoľňujeme väčšinu tímu administrátorov domov. Ale niekoľko ľudí zostáva.
Malý FAQ:
Q: Čo sa dialo od 18:31 do 02:56?
A: Podľa „Plánu akcií pri havárii“ spúšťame všetky služby, začínajúc tými najdôležitejšími. Koordinátor v chate priraďuje službu voľnému administrátorovi, ktorý kontroluje, či sa spustili OS a aplikácia, či sú bez chýb, a či sú ukazovatele v poriadku. Po dokončení spustenia informuje chat, že je voľný, a od koordinátora dostáva novú službu.
Proces je dodatočne spomalený zlyhávajúcim hardvérom. Aj keď zastavenie OS a vypnutie serverov prebehlo správne, niektoré servery sa nevracajú kvôli neočakávaným zlyhaniam diskov, pamäte a šasi. Pri strate elektrického napájania sa percento zlyhaní zvyšuje.
Q: Prečo nemôžete jednoducho spustiť všetko naraz a potom opraviť to, čo sa objaví v monitorovaní?
A: Všetko treba robiť postupne, pretože medzi službami existujú závislosti. A všetko by sa malo kontrolovať okamžite, bez čakania na monitorovanie — pretože s problémami je najlepšie sa vysporiadať hneď, aby sa predišlo ich zhoršeniu.
7:40. Posledný administrátor (koordinátor) odišiel spať. Práce prvého dňa sú dokončené.
8:09. Prví vývojári, inžinieri v dátových centrách a administrátori (vrátane nového koordinátora) začali s obnovovacími prácami.
09:37. Začali sme znovu spúšťať miestnosť č. 7 (poslednú).
Paralelne pokračujeme v obnove toho, čo sme nedokončili v iných miestnostiach: výmena diskov/pamätí/serverov, oprava všetkého, čo „horí“ v monitorovaní, spätné prepínanie rolí v schémach master-standby a iné drobnosti, ktorých je však dostatok.
17:08. Dovoľujeme všetky bežné práce na produkcii.
21:45. Práce druhého dňa sú dokončené.
09:45. Dnes je piatok. V monitorovaní je stále dosť drobných problémov. Pred nami sú víkendy, všetci chcú oddychovať. Pokračujeme v masívnom opravovaní všetkého, čo sa dá. Štandardné administratívne úlohy, ktoré bolo možné odložiť, sú odložené. Je tu nový koordinátor.
15:40. Nečakane sa reštartoval polovica staku Core sieťového vybavenia v INOM dátovom centre. Vyviedli sme frončné zariadenia z rotácie, aby sme minimalizovali riziká. Efekt pre používateľov žiadny. Neskôr sme sa dozvedeli, že to bola problémová šasi. Koordinátor pracuje na oprave hneď dvoch havárií.
17:17. Práca siete v inom dátovom centre bola obnovená, všetko skontrolované. Dátové centrum bolo zaradené do rotácie.
18:29. Práce tretieho dňa a celkové obnovenie po havárii bolo dokončené.
Pósledok
04.04.2013, , „Odnoklassniki“ — po dobu troch dní bola stránka úplne alebo čiastočne nedostupná. Počas celej tejto doby viac ako 100 ľudí z rôznych miest a rôznych spoločností (ešte raz veľké ďakujem!), opravovalo tisíce serverov vzdialene aj priamo v dátových centrách, manuálne aj automaticky.
Urobili sme závery. Aby sa podobné problémy neopakovali, uskutočnili sme a naďalej uskutočňujeme rozsiahle práce.
Aké sú hlavné rozdiely súčasnej havárie od 404?
- Máme „Plán akcií pri havárii“. Raz za štvrťrok vykonávame cvičenia - simulujeme havarijnú situáciu, ktorú musí skupina administrátorov (všetci sa striedajú) vyriešiť pomocou „Plánu akcií pri havárii“. Hlavní systémoví administrátori sa striedajú v roli koordinátora.
- Každý štvrťrok v testovacom režime izolujeme dátové centrá (všetky sa striedajú) v sieti LAN a WAN, čo umožňuje včas identifikovať úzke miesta.
- Menej poškodených diskov, pretože sme sprísnili normy: menej pracovných hodín, striknejšie prahové hodnoty pre S.M.A.R.T.
- Úplne sme sa vzdali BerkeleyDB – starej a nestabilnej databázy, ktorá vyžadovala veľa času na obnovu po reštarte servera.
- Znížili sme počet serverov s MS SQL a zmenšili závislosť od zostávajúcich.
- Máme vlastné , kam už dva roky aktívne migrujeme všetky služby. Cloud výrazne zjednodušuje celý cyklus práce s aplikáciou a v prípade havárie poskytuje jedinečné nástroje, ako:
- správne zastavenie všetkých aplikácií jedným kliknutím;
- jednoduchá migrácia aplikácií zo zlyhávajúcich serverov;
- automatické spustenie celého datacentra s priorytizovaným radením služieb.
Nehoda opísaná v tomto článku sa stala najväčšou od doby 404. Samozrejme, všetko nešlo hladko. Napríklad počas nedostupnosti vyhoreného datacentra v inom datacentre zlyhal disk na jednom zo serverov, takže k dispozícii zostala iba jedna z troch replik v Cassandra klastre, čo viedlo k tomu, že 4,2 % používateľov mobilných aplikácií sa nemohli prihlásiť. Pripojení používatelia však naďalej pracovali. Celkovo s výsledkami nehody bolo zistených viac ako 30 problémov — od banálnych chýb až po nedostatky v architektúre služieb.
No najdôležitejší rozdiel medzi touto nehodou a 404. je ten, že zatiaľ čo sme odstraňovali následky požiaru, používatelia stále posielali správy a robili videohovory v , hrali hry, počúvali hudbu, darovali si navzájom darčeky, pozerali videá, seriály a televízne kanály v , a tiež streamovali v .
A ako prebiehajú vaše nehody?
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish