

Malé úvodné slovo
Myslím si, že by sme mohli urobiť oveľa viac, ak by sme mali k dispozícii krok za krokom inštrukcie, ktoré by nám povedali, čo a ako robiť. Sám si spomínam na situácie v mojom živote, keď som nemohol začať nejakú činnosť, pretože bolo jednoducho ťažké zistiť, odkiaľ začať. Možno si pred mnohými rokmi na internete videl slová „Data Science“ a rozhodol si sa, že sa ťa to netýka, a že ľudia, ktorí sa tým zaoberajú, sú niekde tam, v inom svete. No nie, sú tu priamo. A možno vďaka ľuďom z tejto oblasti sa ti dostal do feedu článok. Existuje množstvo kurzov, ktoré ti pomôžu osvojiť si toto remeslo, a tu ti pomôžem urobiť prvý krok.
No čo, si pripravený? Hneď poviem, že budeš potrebovať poznať Python 3, pretože ten budem používať tu. Taktiež odporúčam, aby si si vopred nainštaloval Jupyter Notebook alebo sa pozrel, ako používať Google Colab.
Krok prvý
Kaggle je tvoj významný pomocník v tejto oblasti. V podstate sa bez neho dá aj zaobísť, ale o tom sa porozprávame v inom článku. Je to platforma, na ktorej sa konajú súťaže v oblasti Data Science. Na začiatku každého takého súťaže získaš obrovské množstvo skúseností pri riešení rôznych úloh, pri vývoji a pri práci v tíme, čo je v dnešnej dobe dôležité.
Našu úlohu vezmeme odtiaľ. Nazýva sa: „Titanic“. Úloha je nasledovná: predpovedať, či každý jednotlivý človek prežije. Všeobecne povedané, úlohou človeka zaoberajúceho sa DS je zbierať údaje, spracovávať ich, trénovať model, predpovedať a tak ďalej. Na Kaggle nám umožňujú preskočiť fázu zberu údajov — sú k dispozícii na platforme. Musíme ich nahrať a môžeme začať pracovať!
Môžeme to urobiť nasledujúcim spôsobom:
na záložke Data sú umiestnené súbory, ktoré obsahujú údaje


Nahrali sme údaje, pripravili naše Jupyter poznámky a…
Krok druhý
Ako teraz nahráme tieto údaje?
Predovšetkým importujeme potrebné knižnice:
import pandas as pd
import numpy as np
Pandas nám umožní nahrávať .csv súbory pre ďalšie spracovanie.
Numpy je potrebný na to, aby sme zastupovali našu tabuľku údajov vo forme matice s číslami.
Ideme ďalej. Vezmeme súbor train.csv a nahráme ho k nám:
dataset = pd.read_csv('train.csv')
Na našu výberu dát train.csv budeme odkazovať cez premennú dataset. Pozrime sa, čo tam nájdeme:
dataset.head()
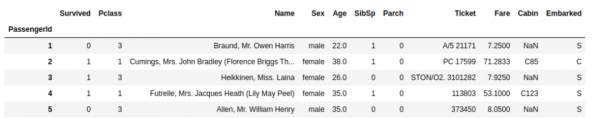
Funkcia head() nám umožňuje prezrieť si prvých niekoľko riadkov dataframe-u.
Stĺpec Survived sú naše výsledky, ktoré sú v tomto dataframe známe. Vzhľadom na úlohu, potrebujeme predpovedať stĺpec Survived pre dáta test.csv. V týchto dátach sú uložené informácie o ďalších pasažieroch Titanicu, pre ktorých, pri riešení úlohy, výsledky nie sú známe.
Rozdelíme našu tabuľku na závislé a nezávislé dáta. Tu je to jednoduché. Závislé dáta sú tie, ktoré závisia od nezávislých, teda to, čo je v výsledkoch. Nezávislé dáta sú tie, ktoré ovplyvňujú výsledok.
Napríklad, máme taký súbor dát:
„Vova sa učil informatiky — nie.
Vova dostal z informatiky 2.“
Trieda z informatiky závisí od odpovede na otázku: učil sa Vova informatiky? Jasné? Ideme ďalej, už sme bližšie k cieľu!
Tradičná premenná pre nezávislé dáta je X. Pre závislé je y.
Robíme nasledovné:
X = dataset.iloc[ : , 2 : ]
y = dataset.iloc[ : , 1 : 2 ]
Čo to je? Funkciou iloc[:, 2: ] hovoríme Pythonu: chcem vidieť v premennej X dáta začínajúce od druhého stĺpca (vrátane a za predpokladu, že počítanie začína od nuly). V druhom riadku hovoríme, že chceme vidieť v y dáta z prvého stĺpca.
[ a:b, c:d ] — to je konštrukcia, ktorú používame v zátvorkách. Ak nešpecifikujeme nejaké premenné, budú sa uchovávať ako predvolené. Teda môžeme špecifikovať [:,: d] a potom dostaneme v dataframe všetky stĺpce, okrem tých, ktoré idú od čísla d a ďalej. Premenné a a b určujú riadky, ale tie potrebujeme všetky, takže ich necháme predvolené.
Pozrime sa, čo sme dostali:
X.head() 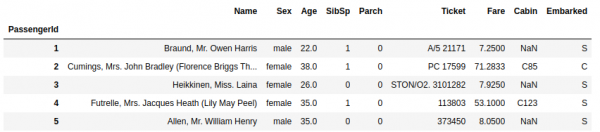
y.head() 
Aby sme zjednodušili túto malú lekciu, odstránime stĺpce, ktoré vyžadujú osobitnú „údržbu“, alebo vôbec neovplyvňujú prežitie. Obsahujú dáta typu str.
count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X.drop(count, inplace=True, axis=1)
Super! Ideme na ďalší krok.
Krok tri
Tu potrebujeme zakódovať naše dáta, aby stroj lepšie rozumel, ako tieto dáta vplývajú na výsledok. Ale kódovať budeme len tie dáta typu str, ktoré sme nechali. Stĺpec „Sex“. Ako chceme zakódovať? Predstavme si dáta o pohlaví človeka ako vektor: 10 — mužské pohlavie, 01 — ženské pohlavie.
Na začiatok preložíme naše tabuľky do matice NumPy:
X = np.array(X)
y = np.array(y)
A teraz sa pozrime:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder

ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X = np.array(ct.fit_transform(X))
Knižnica sklearn je skvelá knižnica, ktorá nám umožňuje vykonávať kompletnú prácu v oblasti Data Science. Obsahuje množstvo zaujímavých modelov strojového učenia a takisto nám umožňuje zaoberať sa prípravou dát.
OneHotEncoder nám umožní zakódovať pohlavie človeka presne tak, ako sme to opísali. Vytvorí sa 2 triedy: mužská, ženská. Ak je osoba muž, do stĺpca „mužský“ sa zapíše 1, a do „ženského“ sa zapíše 0.
Po OneHotEncoder() stojí [1] — to znamená, že chceme zakódovať stĺpec číslo 1 (číslovanie začína od nuly).
Super. Pokračujeme ďalej!
Zvyčajne sa stáva, že niektoré dáta zostanú nezapísané (to znamená NaN — not a number). Napríklad, máme informácie o osobe: jeho meno, pohlavie. Ale údaje o jeho veku chýbajú. V takom prípade použijeme takúto metódu: nájdeme priemernú hodnotu vo všetkých stĺpcoch a ak sú v niektorých stĺpcoch chýbajúce dáta, vyplníme prázdne miesta priemernou hodnotou.
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X)
X = imputer.transform(X)
A teraz berieme do úvahy, že sa stáva, že sú dáta veľmi rozptýlené. Niektoré dáta sú v intervale [0:1], zatiaľ čo niektoré môžu presiahnuť stovky a tisíce. Aby sme vylúčili takéto rozptýlenie a počítač bol presnejší vo výpočtoch, normalizujeme dáta, skaluje ich. Nech sú všetky čísla maximálne tri. Na to využijeme funkciu StandartScaler.
from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X[:, 2:] = sc.fit_transform(X[:, 2:])
Teraz naše dáta vyzerajú takto:

Skvelé. Už sme blízko nášmu cieľu!
Krok štvrtý
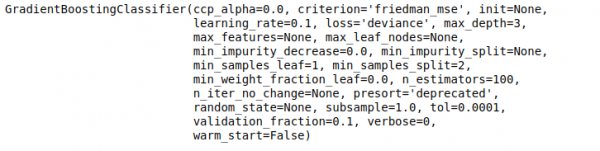
Naučíme našu prvú model! Z knižnice sklearn môžeme nájsť obrovské množstvo zaujímavostí. Na tento úloha som použil model Gradient Boosting Classifier. Používame klasifikátor, pretože našou úlohou je klasifikácia. Musíme predpovedať, či je výsledok 1 (prežil) alebo 0 (neprežil).
from sklearn.ensemble import GradientBoostingClassifier
gbc = GradientBoostingClassifier(learning_rate=0.5, max_depth=5, n_estimators=150)
gbc.fit(X, y)
Funkcia fit hovorí Pythónu: Nech model hľadá závislosti medzi X a y.
Menej ako sekundu a model je pripravený.
Ako ho aplikovať? Teraz to uvidíme!
Krok päť. Záver
Teraz musíme načítať tabuľku s našimi testovacími údajmi, pre ktoré potrebujeme vytvoriť predpoveď. S túto tabuľkou vykonáme všetky rovnaké kroky, ktoré sme robili pre X.
X_test = pd.read_csv('test.csv', index_col=0)

count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X_test.drop(count, inplace=True, axis=1)

X_test = np.array(X_test)

from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder
ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X_test = np.array(ct.fit_transform(X_test))

from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X_test)
X_test = imputer.transform(X_test)

from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X_test[:, 2:] = sc.fit_transform(X_test[:, 2:])
Aplikujme už náš model!
gbc_predict = gbc.predict(X_test)
Hotovo. Vytvorili sme predpoveď. Teraz ju musíme zapísať do csv a poslať na web.
np.savetxt('my_gbc_predict.csv', gbc_predict, delimiter=",", header = 'Survived')
Hotovo. Získali sme súbor obsahujúci predpovede pre každého pasažiera. Ostáva len nahrať tieto rozhodnutia na web a získať hodnotenie predpovede. Toto primitívne riešenie dáva nielen 74% správnych odpovedí na verejnosti, ale tiež určitý impulz v Data Science. Najzvedavejší mi môžu kedykoľvek napísať osobné správy a položiť otázku. Všetkým ďakujem!
Zdroj: habr.com
