

Ahoj, Habr!
V súvislosti s aktuálnymi udalosťami spôsobenými koronavírusom niektoré internetové služby zaznamenali zvýšené zaťaženie. Napríklad, pretože nemali dostatočnú kapacitu. A nie vždy je možné urýchliť server, jednoducho pridaním výkonnejšieho hardvéru, avšak požiadavky zákazníkov je potrebné spracovať (ináč odídu ku konkurencii).
V tomto článku stručne popíšem populárne praktiky, ktoré umožňujú vytvoriť rýchlu a odolnú službu. Z dostupných vývojových schém som vybral iba tie, ktorými sa teraz ľahko dá využiť.Pre každý bod už máte buď hotové knižnice, alebo je tu možnosť vyriešiť úlohu pomocou cloudovej platformy.
Horizontálne škálovanie
Najjednoduchší a všetkým známy bod. Podľa rozdelenia záťaže sa zvyčajne najviac stretáva s dvoma schémami - horizontálnym a vertikálnym škálovaním. umožňujete službám pracovať paralelne, čím rozdeľujete záťaž medzi nimi. objednávate výkonnejšie servery alebo optimalizujete kód.
Pre príklad beriem abstraktné cloudové úložisko súborov, teda niečo ako OwnCloud, OneDrive a tak ďalej.
Štandardný obrázok takejto schémy je nižšie, avšak iba demonštruje zložitosti systému. Veď potrebujeme nejakým spôsobom synchronizovať služby. Čo sa stane, ak používateľ uloží súbor na tablete a potom chce naň pozrieť z telefónu?
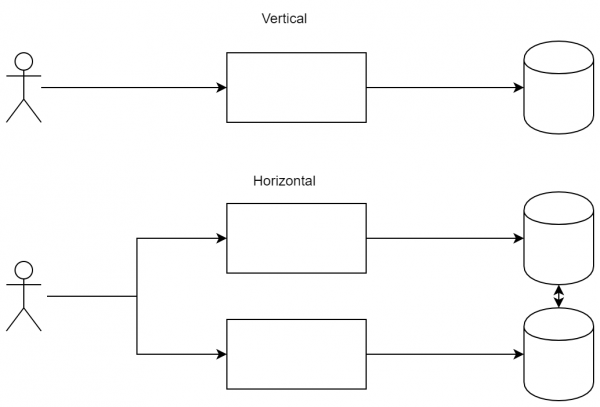
Rozdiel medzi prístupmi: pri vertikálnom škálovaní sme ochotní zvyšovať výkon uzlov, zatiaľ čo pri horizontálnom - pridávať nové uzly, aby sme rozložili záťaž.
CQRS
je dosť dôležitý vzor, pretože umožňuje rôznym klientom nielen sa pripojiť k rôznym službám, ale aj získavať rovnaké toky udalostí. Jeho výhody nie sú také očividné pre jednoduchú aplikáciu, avšak je extrémne dôležitý (a jednoduchý) pre zaťažené služby. Jeho podstata: prichádzajúce a odchádzajúce toky údajov by sa nemali prekrývať. To znamená, že nemôžete poslať požiadavku a čakať na odpoveď, namiesto toho posielate požiadavku do služby A, avšak odpoveď dostanete zo služby B.
Prvá výhoda tohto prístupu — možnosť prerušiť spojenie (v širokom zmysle tohto slova) počas vykonávania dlhého požiadavku. Ako príklad si berieme viac-menej štandardnú sekvenciu:
- Klient odoslal požiadavku na server.
- Server spustil dlhé spracovanie.
- Server odpovedal klientovi výsledkom.
Predstavme si, že v bode 2 došlo k prerušeniu spojenia (alebo sa sieť prerušila, alebo používateľ prešiel na inú stránku, čím prerušil spojenie). V takom prípade bude serveru ťažké poslať odpoveď používateľovi s informáciou, čo presne bolo spracované. Použitím CQRS bude sekvencia trochu iná:
- Klient sa prihlásil na aktualizácie.
- Klient odoslal požiadavku na server.
- Server odpovedal „požiadavka prijatá“.
- Server odpovedal výsledkom cez kanál z bodu „1“.
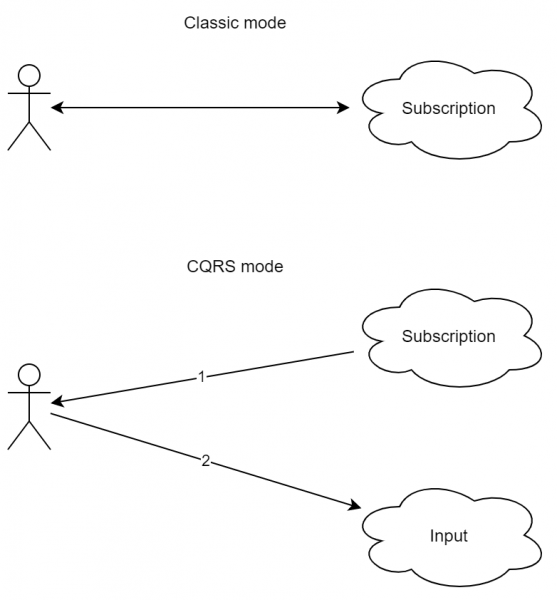
Ako je vidieť, schéma je o niečo zložitejšia. Navyše intuitívny prístup request-response tu chýba. Ako je však vidieť, prerušenie spojenia počas spracovania požiadavky nespôsobí chybu. Navyše, ak je používateľ naozaj pripojený k službe z viacerých zariadení (napríklad z mobilného telefónu a z tabletu), môžeme zabezpečiť, aby odpoveď prišla na obe zariadenia.
Zaujímavé je, že kód spracovania prichádzajúcich správ sa stáva rovnakým (nie na 100%) pre udalosti, na ktoré mal vplyv sám klient, ako aj pre ostatné udalosti, vrátane tých od iných klientov.
V skutočnosti však získavame ďalšie výhody, pretože jednosmerný tok je možné spracovávať vo funkcionálnom štýle (používajúc RX a analógy). A to je už značná výhoda, pretože aplikáciu je možné úplne urobiť reaktívnou, pričom sa používa funkcionálny prístup. Pre rozsiahle programy to môže výrazne ušetriť zdroje pri vývoji a podpore.
Ak spojíme tento prístup s horizontálnym škálovaním, dostávame bonus v podobe schopnosti posielať požiadavky na jeden server a prijímať odpovede od iného. Takýmto spôsobom si klient môže sám vybrať pohodlnú službu, zatiaľ čo systém vo vnútri bude stále schopný správne spracovať udalosti.
Event Sourcing
Ako všetci viete, jednou z hlavných vlastností distribuovaného systému je absencia spoločného času a spoločnej kritickej sekcie. Pre jeden proces môžete urobiť synchronizáciu (na tých istých mutexoch), počas ktorej si môžete byť istí, že nikto iný tento kód nevykonáva. Avšak pre distribuovaný systém je to nebezpečné, pretože to vyžaduje náklady a zničí to všetku krásu škálovania - aj tak všetky komponenty budú čakať na jednu vec.
Odtiaľ dostávame dôležitý fakt - rýchlu distribuovanú systém nie je možné synchronizovať, lebo v opačnom prípade znížime výkon. Na druhej strane, často potrebujeme určitú konzistenciu komponentov. A na to môžeme použiť prístup s , kde sa zaručuje, že pri absencii zmien údajov po určitom časovom intervale od poslednej aktualizácie ("na konci") všetky žiadosti vrátia poslednú aktualizovanú hodnotu.
Je dôležité chápať, že pre klasické databázy sa pomerne často používa , kde každý uzol vlastní rovnaké informácie (to sa často dosahuje, keď sa transakcia považuje za potvrdenú až po odpovedi druhého servera). Tu existujú niektoré úľavy vďaka úrovniam izolácie, avšak celkový princíp zostáva rovnaký - môžete žiť v úplne konzistentnom svete.
Avšak vráťme sa k počiatočnej úlohe. Ak môže byť časť systému postavená s , môžeme postaviť nasledujúcu schému.
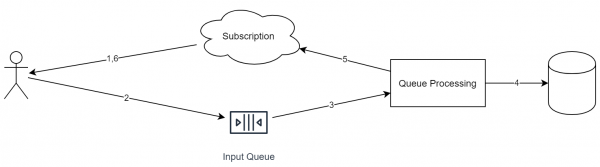
Dôležité vlastnosti tohto prístupu:
- Každá prichádzajúca žiadosť je umiestnená do jednej fronty.
- Počas spracovania žiadosti môže služba tiež umiestniť úlohy do iných front.
- Každá prichádzajúca udalosť má identifikátor (ktorý je potrebný na deduplikáciu).
- Fronta ideologicky funguje na schéme "append only". Z nej nie je možné odstraňovať prvky ani ich presúvať.
- Fronta pracuje na princípe FIFO (ospravedlňujem sa za tautológiu). Ak je potrebné vykonávať paralelne, mali by ste v jednom z krokov presunúť objekty do rôznych front.
Pripomínam, že sa zaoberáme prípadom online úložiska súborov. V tomto prípade systém bude vyzerať približne takto:
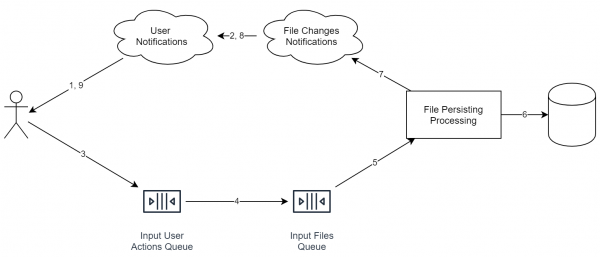
Je dôležité, že služby na diagrame neznamenajú nutne samostatný server. Aj proces môže byť rovnaký. Dôležité je, že ideologicky sú tieto veci rozdelené tak, aby bolo možné jednoducho aplikovať horizontálne škálovanie.
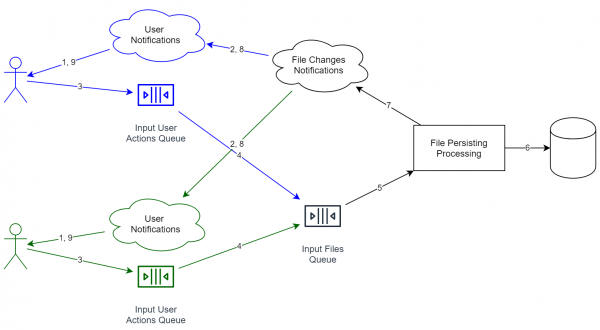
Pre dvoch používateľov bude schéma vyzerať takto (služby určené rôznym používateľom sú označené rôznymi farbami):
Výhody podobnej kombinácie:
- Služby spracovania informácií sú rozdelené. Rovnako sú rozdelené aj fronty. Ak potrebujeme zvýšiť priepustnosť systému, stačí len spustiť viac služieb na väčšom počte serverov.
- Keď dostávame informácie od používateľa, nemusíme čakať na úplné uloženie dát. Naopak, stačí odpovedať „ok“ a potom postupne začať prácu. Fronta taktiež vyhladzuje špičky, pretože pridanie nového objektu prebieha rýchlo a používateľ nemusí čakať na kompletné prechádzanie celým cyklom.
- Pre príklad som pridal službu deduplikácie, ktorá sa snaží spojiť rovnaké súbory. Ak dlho pracuje na 1 % prípadoch, klient to takmer nezbadá (viď vyššie), čo je veľké plus, pretože od nás už nie je potrebná stopercentná rýchlosť a spoľahlivosť.
Avšak okamžite sú viditeľné aj nedostatky:
- Naša sústava stratila prísnu konzistenciu. To znamená, že ak sa napríklad prihlásite na rôzne služby, teoreticky môžete získať rôzny stav (pretože jedna zo služieb môže nestihnúť prijať oznámenie z vnútornej fronty). Ako ďalší dôsledok, systém teraz nemá spoločný čas. To znamená, že napríklad nemožno triediť všetky udalosti jednoducho podľa času príchodu, pretože hodiny medzi servermi môžu byť nesynchronized (viac než to, mať rovnaký čas na dvoch serveroch je utópia).
- Žiadne udalosti nemožno teraz jednoducho vrátiť (ako by sa to dalo urobiť s databázou). Namiesto toho je potrebné pridať novú udalosť — , ktorá zmení posledný stav na požadovaný. Ako príklad z podobnej oblasti: bez prepisovania histórie (čo je zle v niektorých prípadoch) v gite nie je možné vrátiť commit, ale môžete vytvoriť špeciálny , ktorý v podstate len vráti starý stav. Avšak v histórii zostane aj chybný commit a rollback.
- Schéma dát sa môže meniť od vydania k vydaniu, avšak staré udalosti už nebude možné aktualizovať na nový štandard (pretože udalosti sa v zásade nedajú meniť).
Ako je vidieť, Event Sourcing sa skvele kombinuje s CQRS. Navyše, realizácia systému s efektívnymi a pohodlnými frontami, ale bez rozdelenia dátových tokov, je sama osebe náročná, pretože bude potrebné pridať body synchronizácie, ktoré vyrovnajú všetky pozitívne efekty z front. Použitím oboch prístupov naraz je nevyhnutné mierne upraviť kód fungovania programu. V našom prípade, pri odosielaní súboru na server, v odpovedi prichádza len „ok“, čo znamená len to, že „operácia pridania súboru bola uložená“. Formálne to neznamená, že dáta sú už dostupné na iných zariadeniach (napríklad služba deduplikácie môže prestavovať index). Avšak po určitom čase klientovi príde upozornenie v štýle „súbor X bol uložený.“
Ako výsledok:
- Počet stavov odosielania súborov sa zvyšuje: namiesto klasického „súbor bol odoslaný“ získavame dva: „súbor bol pridaný do fronty na serveri“ a „súbor bol uložený v úložisku“. To posledné znamená, že iné zariadenia môžu začať dostávať súbor (s ohľadom na to, že fronty fungujú rôznou rýchlosťou).
- Pretože informácie o odoslaní teraz prichádzajú rôznymi kanálmi, potrebujeme vymyslieť riešenia, aby sme získali stav spracovania súboru. Z toho vyplýva: na rozdiel od klasického request-response môže byť klient reštartovaný počas spracovania súboru, avšak stav tohto spracovania bude správny. Tento bod funguje v podstate z krabice. Ako výsledok: sme teraz tolerantnejší voči zlyhaniam.
Sharding
Ako bolo už vyššie popísané, v systémoch s event sourcingom neexistuje prísna konzistencia. To znamená, že môžeme používať viacero úložísk bez akejkoľvek synchronizácie medzi nimi. Približujúc sa k našej úlohe, môžeme:
- Rozdeľovať súbory podľa typov. Napríklad, obrázky/videa môžeme dekódovať a vybrať efektívnejší formát.
- Rozdeľovanie účtov podľa krajín. Kvôli rôznym zákonom môže byť takáto možnosť potrebná, ale táto architektúra to umožňuje automaticky.
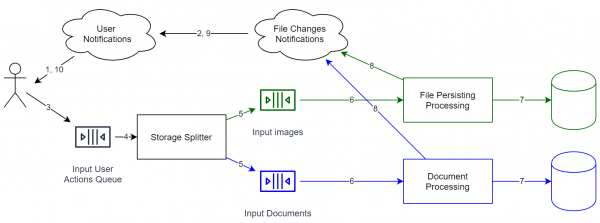
Ak chcete preniesť údaje z jedného úložiska do druhého, už sa neobišlo bez štandardných prostriedkov. Bohužiaľ, v takom prípade je potrebné zastaviť frontu, vykonať migráciu a následne ju spustiť. Vo všeobecnosti nie je možné preniesť údaje 'za behu', avšak, ak je fronta udalostí plne uložená a máte kópie predchádzajúcich stavov úložiska, môžeme udalosti prehráť nasledujúcim spôsobom:
- V Event Source má každá udalosť svoj identifikátor (ideálne - neklesajúci). To znamená, že do úložiska môžeme pridať pole - id posledného spracovaného prvku.
- Duplikujeme frontu, aby všetky udalosti mohli byť spracovávané pre niekoľko nezávislých úložísk (prvé je to, v ktorom sú už teraz uložení údaje, a druhé je nové, avšak zatiaľ prázdne). Druhá fronta sa, samozrejme, zatiaľ nespracováva.
- Spúšťame druhú frontu (t.j. začíname prehrávanie udalostí).
- Keď bude nová fronta relatívne prázdna (t.j. priemerný časový rozdiel medzi pridávaním prvku a jeho vyzdvihnutím bude prijateľný), môžeme začať prepnúť čitateľov na nové úložisko.
Ako vidíme, v našej sústave nikdy nebola, ani nie je prísna konzistentnosť. Existuje len eventual consistency, čo znamená záruku, že udalosti sú spracovávané v rovnakom poradí (avšak, možné s rôznymi oneskoreniami). A využitím tohto môžeme relatívne jednoducho preniesť údaje bez zastavenia systému na druhý koniec sveta.
Takto, pokračujúc v našom príklade online úložiska pre súbory, nám takáto architektúra už poskytuje niekoľko bonusov:
- Môžeme presunúť objekty bližšie k používateľom, a to dynamicky. Takto môžeme zlepšiť kvalitu služby.
- Môžeme uchovávať časť údajov vo vnútri firiem. Napríklad, Enterprise používatelia často požadujú uchovávať svoje údaje v pod kontrolou dátových centier (aby sa predišlo únikom údajov). Vďaka sharding môžeme to ľahko podporiť. A úloha je ešte jednoduchšia, ak má zákazník kompatibilné cloud (napríklad, ).
- A najdôležitejšie je, že to nemusíme robiť. Predsa by nám na začiatok stačila jedna úložisko pre všetky účty (aby sme mohli rýchlo začať pracovať). A kľúčovou vlastnosťou tohto systému je, že aj keď je rozšíriteľný, v počiatočnej fáze je dosť jednoduchý. Stačí, ak na začiatok nenapíšeme kód pracujúci s miliónom samostatných nezávislých frontov a podobne. Ak bude potrebné, môžeme to urobiť v budúcnosti.
Hosting statického obsahu
Tento bod sa môže zdať celkom zrejmý, ale je aj tak nevyhnutný pre viac-menej štandardnú vyťažovanú aplikáciu. Jeho podstata je jednoduchá: celý statický obsah sa neponúka z toho istého servera, kde sa nachádza aplikácia, ale zo špeciálnych, vyhradených na tento účel. V dôsledku toho sú tieto operácie vykonávané rýchlejšie (podmienečný nginx odovzdáva súbory rýchlejšie a menej nákladne ako Java server). Plus architektúra CDN () umožňuje umiestniť naše súbory bližšie k koncovým používateľom, čo pozitívne ovplyvňuje pohodlie pri používaní služby.
Najjednoduchším a štandardným príkladom statického obsahu je súbor skriptov a obrázkov pre web. S nimi je to jednoduché – sú známe vopred, následne sa archív nahráva na servery CDN, odkiaľ sú distribuované koncovým používateľom.
Avšak v praxi možno na statický obsah aplikovať prístup podobný lambda architektúre. Vráťme sa k našej úlohe (online úložisko súborov), v ktorej je našou úlohou distribuovať súbory používateľom. Najjednoduchšie priamočiare riešenie – vytvoriť službu, ktorá pre každý požiadavok používateľa vykoná všetky potrebné kontroly (autorizácia a pod.) a potom stiahne súbor priamo z nášho úložiska. Hlavnou nevýhodou takéhoto prístupu je, že statický obsah (súbor s konkrétnou revíziou je v zásade statický obsah) sa distribuuje z toho istého servera, ktorý obsahuje biznis logiku. Namiesto toho môžeme urobiť nasledujúcu schému:
- Server vydáva URL na stiahnutie. Môže mať formát file_id + key, kde key je mini-digitálny podpis, ktorý dáva právo na prístup k zdroju na najbližší deň.
- Distribúciou súboru sa zaoberá jednoduchý nginx s nasledujúcimi možnosťami:
- Caching of content. Since this service may be on a separate server, we have left ourselves with a margin for the future to store all the latest downloaded files on the disk.
- Key verification at the moment of connection establishment
- Optionally: streaming content processing. For example, if we compress all the files in the service, we can unzip them directly in this module. As a result, IO operations are done where they belong. The Java archiver can easily allocate a lot of unnecessary memory, but rewriting the service with business logic in conditional Rust/C++ can also turn out to be inefficient. In our case, different processes (or even services) are used, allowing us to effectively separate business logic and IO operations.
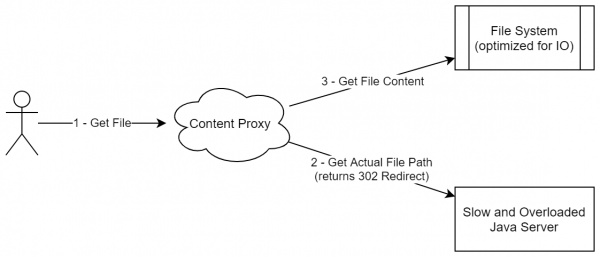
Such a scheme does not resemble serving static content very much (since we are not offloading the entire static package anywhere), but in reality this approach is indeed concerned with distributing immutable data. Moreover, this scheme can be generalized to other cases where content is not just static, but can be represented as a set of immutable and non-removable blocks (though they can be added).
As another example (for reinforcement): if you have worked with Jenkins/TeamCity, you know that both solutions are written in Java. Both represent a Java process that handles both build orchestration and content management. In particular, both have tasks like "transfer file/folder from the server". For instance: delivering artifacts, transferring source code (when the agent does not download the code directly from the repository, but the server does it instead), access to logs. All these tasks differ in their IO load. So, the server handling complex business logic must also efficiently push large data streams through it. Interestingly, such an operation can be delegated to nginx in exactly the same way (only with a data key added to the request).
However, if we return to our system, we get a scheme like this:
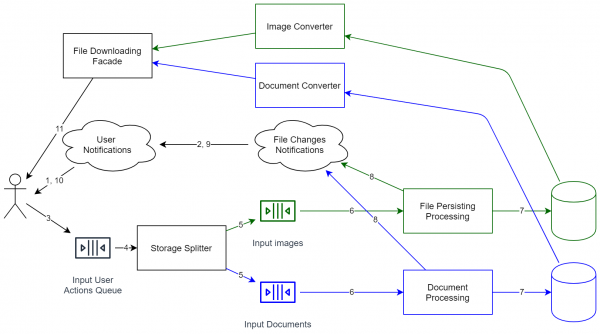
Ako je vidno, systém sa radikálne skomplikoval. Teraz to nie je len mini-proces, ktorý ukladá súbory lokálne. Teraz je potrebná už nie najjednoduchšia podpora, kontrola verzií API atď. Preto po vykreslení všetkých diagramov je najlepšie podrobne zhodnotiť, či stojí za to rozširovanie takýchto nákladov. Ak však chcete mať schopnosť rozširovať systém (vrátane práce s ešte väčším počtom používateľov), budete musieť pristúpiť k takýmto riešeniam. Na druhej strane však, ako výsledok, je systém architektonicky pripravený na zvýšenie zaťaženia (prakticky každý komponent sa dá klonovať na horizontálne škálovanie). Systém môžete aktualizovať bez jeho zastavenia (určité operácie sa jednoducho mierne spomalia).
Ako som už hovoril na začiatku, teraz sa rad online služieb dostáva pod zvýšené zaťaženie. A niektoré z nich jednoducho prestali správne fungovať. V podstate systémy zlyhali práve v okamihu, keď by mal biznis zarábať peniaze. Teda namiesto odloženej dodávky, namiesto ponuky zákazníkom „naplánujte dodávku na najbližšie mesiace“, systém jednoducho povedal „choďte k konkurentom“. To je cena nízkej výkonnosti: straty nastanú práve vtedy, keď by bol zisk najvyšší.
Záver
Všetky tieto prístupy boli známe už predtým. Ten istý VK dávno už využíva myšlienku Static Content Hosting na vydávanie obrázkov. Hromada online hier používa schému Sharding na rozdelenie hráčov podľa regiónov alebo na rozdelenie herných lokalít (ak je svet jednotný). Prístup Event Sourcing sa aktívne používa v elektronickej pošte. Väčšina aplikácií obchodníkov, kde nepretržite prichádzajú dáta, je v skutočnosti postavená na prístupe CQRS, aby mali možnosť filtrovať získané údaje. A horizontálne škálovanie sa už pomerne dlho aplikuje v mnohých službách.
Avšak to najdôležitejšie je, že všetky tieto vzory sa stali veľmi ľahko aplikovateľnými v moderných aplikáciách (ak sú na mieste, samozrejme). Cloud poskytuje sharding a horizontálne škálovanie hneď, čo je oveľa jednoduchšie ako objednávať rôzne dedikované servery v rôznych dátových centrách samostatne. CQRS sa stal oveľa jednoduchším najmä vďaka rozvoju knižníc, ako je RX. Pred 10 rokmi by zriedka webová stránka dokázala podporiť niečo také. Event Sourcing sa dá nastaviť tiež neuveriteľne jednoducho vďaka už hotovým kontajnerom s Apache Kafka. Pred 10 rokmi by to bolo inováciou, teraz je to bežnosť. Podobne je to aj so statickým hostingom obsahu: vďaka pohodlnejším technológiam (vrátane dostupnej podrobnej dokumentácie a veľkej databázy odpovedí) sa stal takýto prístup ešte jednoduchším.
Ako výsledok, implementácia radom pomerne zložitých architektonických vzorov sa teraz stala omnoho jednoduchšou, a preto si na ňu stojí za to vopred posvietiť. Ak sa v desaťročnej aplikácii upustilo od jedného z riešení vyššie kvôli vysokej cene implementácie a prevádzky, teraz, v novej aplikácii, alebo po refaktoringu, je možné vytvoriť službu, ktorá bude architektonicky rozšíriteľná (z hľadiska výkonu) a pripravená na nové požiadavky od klientov (napríklad na lokalizáciu osobných údajov).
A najdôležitejšie: prosím, nepoužívajte tieto prístupy, ak máte jednoduchú aplikáciu. Áno, sú pekné a zaujímavé, avšak pre webovú stránku s vrcholovým počtom návštevníkov 100 sa často dá obísť klasickým monolitom (aspoň navonok, vo vnútri je možné rozbiť sa na moduly a podobne).
Zdroj: habr.com
