

Netflix je lídrom na trhu internetovej televízie, spoločnosť, ktorá vytvorila a aktívne rozvíja tento segment. Netflix je známy nielen rozsiahlym katalógom filmov a seriálov dostupných takmer z akéhokoľvek miesta na svete a z akéhokoľvek zariadenia s displejom, ale aj spoľahlivou infraštruktúrou a jedinečnou kultúrou inžinierstva.
Názorný príklad prístupu Netflixu k vývoju a podpore zložitých systémov na DevOops 2019 predstavil — riaditeľ pre vývoj v Netflixe. Absolvent Fakulty matematických a fyzikálnych vied NNU im. Lobachevského, Sergej je jedným z prvých inžinierov v Open Connect — CDN tímu v Netflixe. Vytvoril systémy monitorovania a analýzy video dát, spustil populárnu službu na hodnotenie rýchlosti internetového pripojenia FAST.com a posledné roky pracuje na optimalizácii internetových požiadaviek, aby aplikácia Netflix fungovala čo najrýchlejšie pre používateľov.
Prednáška získala najlepšie recenzie od účastníkov konferencie a pripravili sme pre vás textovú verziu.
V prednáške Sergej podrobne hovoril
- o tom, čo ovplyvňuje oneskorenie internetových požiadaviek medzi klientom a serverom;
- ako toto oneskorenie znížiť;
- ako navrhovať, udržiavať a monitorovať odolné voči chybám systémy;
- ako dosahovať výsledky v krátkych termínoch a s minimálnym rizikom pre podnikanie;
- ako analyzovať výsledky a učiť sa na chybách.
Odpovede na tieto otázky potrebujú nielen tí, ktorí pracujú vo veľkých korporáciách.
Predložené princípy a techniky by mal poznať a praktikovať každý, kto vyvíja a udržiava internetové produkty.
Ďalej — rozprávanie z pohľadu rečníka.
Dôležitosť rýchlosti internetu
Rýchlosť internetových požiadaviek je priamo spojená s podnikaním. Zvážte oblasť nakupovania: spoločnosť Amazon v roku 2009 , že oneskorenie 100 ms vedie k strate 1% predaja.
Stáva sa čoraz viac mobilných zariadení, a spolu s nimi aj mobilné stránky a aplikácie. Ak sa vaša stránka načíta dlhšie ako 3 sekundy, prichádzate o približne polovicu používateľov. Od Google zohľadňuje rýchlosť načítania vašej stránky vo vyhľadávaní: čím rýchlejšia je stránka, tým vyššia je jej pozícia v Google.
Rýchlosť pripojenia je tiež dôležitá vo finančných inštitúciách, kde sú oneskorenia kritické. V roku 2015 spoločnosť Hibernia Networks kabel medzi New Yorkom a Londýnom v hodnote 400 miliónov dolárov, aby sa znížila oneskorenie medzi mestami o 6 ms. Predstavte si, 66 miliónov dolárov za 1 ms zníženia oneskorenia!
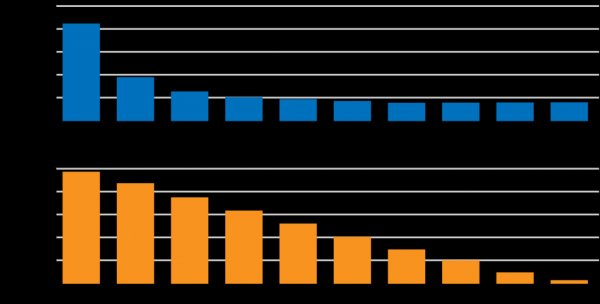
Podľa , rýchlosť pripojenia nad 5 Mbit/s prestáva priamo ovplyvňovať rýchlosť načítania bežnej webovej stránky. Avšak medzi oneskorením pripojenia a rýchlosťou načítania stránky existuje lineárna závislosť:
Netflix však nie je bežný produkt. Vplyv oneskorenia a rýchlosti na používateľa je aktívnou oblasťou analýzy a vývoja. Existuje načítanie aplikácie a výber obsahu, ktoré závisia od oneskorenia, ale načítanie statických prvkov a streamovanie tiež závisí od rýchlosti pripojenia. Analýza a optimalizácia kľúčových faktorov, ktoré ovplyvňujú kvalitu služby pre používateľa, je aktívna oblasť vývoja niekoľkých tímov v Netflixe. Jedným z úloh je zníženie oneskorenia požiadaviek medzi zariadeniami Netflix a cloudovou infraštruktúrou.
V správe sa zameriame práve na zníženie oneskorenia (latency) na príklade infraštruktúry Netflix. Pozrieme sa prakticky, ako pristupovať k procesom navrhovania, vývoja a prevádzkovania zložitých distribuovaných systémov a tráviť čas na inováciách a výsledkoch, nie na diagnostike prevádzkových problémov a porúch.
Vo vnútri Netflixu
Tisícky rôznych zariadení podporujú aplikácie Netflix. Ich vývojom sa zaoberajú štyri rôzne tímy, ktoré vytvárajú samostatné verzie klienta pre Android, iOS, TV a webové prehliadače. A vynakladáme veľa úsilia na vylepšenie a personalizáciu používateľského rozhrania. Na tento účel spúšťame paralelne stovky A/B testov.
Personalizácia je podporovaná vďaka stovkám mikroslužieb v cloude AWS, ktoré poskytujú personalizované údaje pre používateľa, spracovanie požiadaviek, telemetriu, Big Data a Encoding. Vizualizácia prevádzky vyzerá takto:
Naľavo je vstupný bod a následne sa doprava rozdeľuje medzi niekoľko stoviek mikroslužieb, ktoré podporujú rôzne backendové tímy.
Ďalšou dôležitou súčasťou našej infraštruktúry je Open Connect CDN, ktorá dodáva statický obsah - videá, obrázky, kód pre klientov atď. CDN je umiestnená na vlastných serveroch (OCA - Open Connect Appliance). Vo vnútri sa nachádzajú matice SSD a HDD diskov riadené optimalizovaným FreeBSD, s NGINX a súborom služieb. Navrhujeme a optimalizujeme hardvérové a softvérové komponenty tak, aby tento CDN server mohol posielať čo najviac údajov používateľom.
„Stena“ z týchto serverov na bodě výmeny internetového trafiku (Internet eXchange - IX) vyzerá takto:
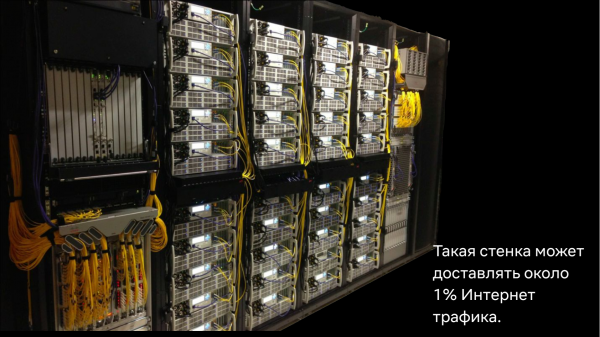
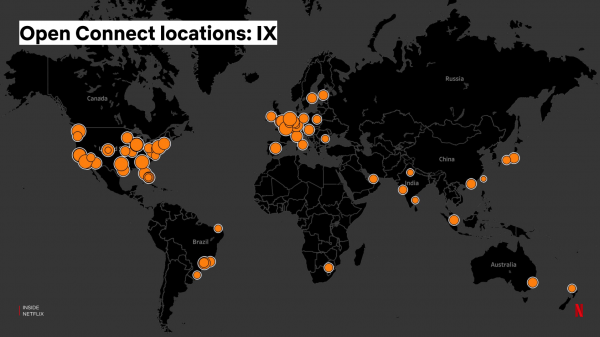
Internet Exchange poskytuje možnosť internetovým poskytovateľom a dodávateľom obsahu „pripojiť“ sa navzájom pre priamu výmenu údajov na internete. Na celom svete je približne 70-80 Internet Exchange bodov, kde sú umiestnené naše servery, a my sa sami zaoberáme ich inštaláciou a údržbou:
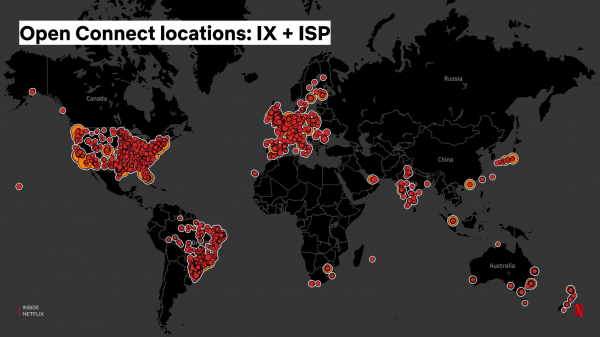
Okrem toho tiež poskytujeme servery priamo internetovým poskytovateľom, ktoré si inštalujú do svojej siete, čím zlepšujeme lokalizáciu Netflix trafficu a kvalitu streamovania pre používateľov:
Súbor služieb AWS zodpovedá za spracovanie video požiadaviek od klientov k CDN serverom, ako aj konfiguráciu samotných serverov - aktualizovanie obsahu, softvérového kódu, nastavení atď. Na to sme tiež vybudovali backbone network, ktorá spája servery v Internet Exchange bodoch s AWS. Backbone network predstavuje globálnu sieť optických káblov a routerov, ktoré môžeme navrhovať a konfigurovať podľa našich potrieb.
V porovnaní , naša CDN infraštruktúra dodáva v špičkách približne ⅛ svetového internetového trafiku a ⅓ trafiku v Severnej Amerike, kde Netflix existuje najdlhšie. Pôsobivé čísla, ale pre mňa jedným z najúžasnejších úspechov je to, že celý systém CDN sa vyvíja a udržiava tímom menej ako 150 ľudí.
Pôvodne bola infraštruktúra CDN navrhnutá na dodávanie video dát. Avšak, s časom sme si uvedomili, že ju môžeme použiť aj na optimalizáciu dynamických požiadaviek od klientov v AWS cloude.
O urýchlení internetu
Dnes má Netflix 3 regióny AWS a latencia požiadaviek na cloud bude závisieť od toho, aká ďaleko sa klient nachádza od najbližšieho regiónu. Máme množstvo CDN serverov, ktoré sa používajú na distribúciu statického obsahu. Môžeme nejako využiť túto infraštruktúru na urýchlenie dynamických požiadaviek? Pri tom nie je možné tieto požiadavky ukladať do cache — API sú personalizované a každý výsledok je unikátny.
Poďme vytvoriť proxy na CDN serveri a začnime cez neho prevádzať dopravu. Bude to rýchlejšie?
Základy
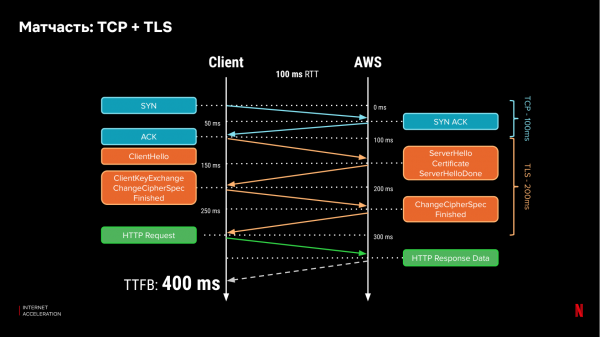
Pripomeňme si, ako fungujú sieťové protokoly. Dnes väčšina premávky na internete používa HTTPs, ktorý závisí od nižších protokolov TCP a TLS. Aby sa klient pripojil k serveru, vykoná handshake, a na vytvorenie zabezpečeného spojenia musí klient vymeniť správy so serverom trikrát a ešte aspoň raz, aby preniesol dáta. Pri latencii na jedno kolo (RTT) 100 ms nám bude trvať 400 ms, aby sme získali prvý bit dát:
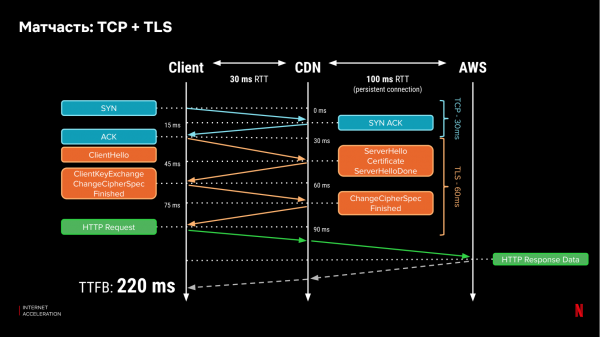
Ak umiestnime certifikáty na CDN server, čas 'rúkou' medzi klientom a serverom môžeme značne skrátiť, ak je CDN bližšie. Predpokladajme, že latencia do CDN servera je 30 ms. Potom na získanie prvého bitu už bude potrebných len 220 ms:
Ale výhody týmto nekončia. Po tom, ako je spojenie už vytvorené, TCP zvyšuje congestion window (počet informácií, ktoré môže prenášať cez toto spojenie paralelne). Ak sa stratí paket dát, klasické implementácie TCP protokolu (ako TCP New Reno) znižujú otvorené 'okno' na polovicu. Rýchlosť rastu congestion window a jeho obnovenia po strate opäť závisí od latencie (RTT) do servera. Ak toto spojenie ide len do CDN servera, táto obnova bude rýchlejšia. Pri tom strata paketov je štandardný jav, najmä pre bezdrôtové siete.
Rýchlosť internetu môže klesať, najmä počas špičkových hodín kvôli používateľskému trafficu, čo môže viesť k "zácpám". V internete neexistuje spôsob, ako dať prioritu jedným požiadavkám pred inými. Napríklad, aby sa prioritizovali malé a citlivé na oneskorenie požiadavky v porovnaní s "ťažkými" tokmi dát, ktoré zaťažujú sieť. V našom prípade však vlastníctvo vlastnej backbone siete umožňuje spraviť to na časti cesty požiadavky — medzi CDN a cloudom, a môžeme ju úplne konfigurovať. Môžeme nastaviť, aby malé a oneskorené pakety mali prioritu a väčšie toky dát išli o niečo neskôr. Čím bližšie je CDN k klientovi, tým je vyššia efektívnosť.
Na oneskorenie majú vplyv aj aplikačné protokoly (úroveň OSI 7). Nové protokoly, ako HTTP/2, umožňujú optimalizovať výkon paralelných požiadaviek. Avšak máme klientov Netflixu so starými zariadeniami, ktoré nepodporujú nové protokoly. Nie všetkých klientov je možné aktualizovať alebo optimálne nastaviť. Medzi CDN proxy a cloudom je však plná kontrola, ako aj možnosť využívať nové, optimálne protokoly a nastavenia. Neefektívna časť so starými protokolmi bude fungovať len medzi klientom a CDN serverom. Navyše, môžeme multiplexovať požiadavky na už vytvorené spojenie medzi CDN a cloudom, čím zlepšíme využitie spojenia na úrovni TCP.
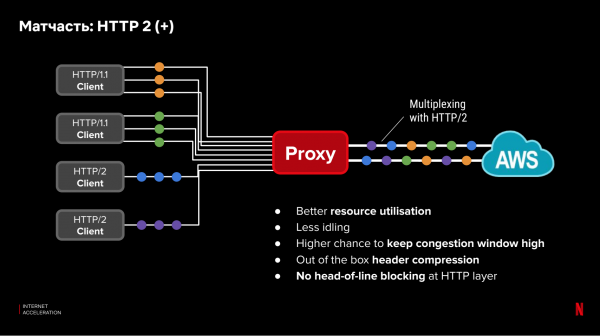
Meranie
Napriek tomu, že teória sľubuje zlepšenia, neponáhľame sa okamžite spustiť systém do produkcie. Namiesto toho musíme najprv dokázať, že nápad bude fungovať v praxi. Na to musíme odpovedať na niekoľko otázok:
- RýchlosťBude proxy rýchlejšia?
- SpoľahlivosťBude sa častejšie rozbíjať?
- ZložitostAko integrovať s aplikáciami?
- CenaKoľko stojí nasadenie dodatočnej infraštruktúry?
Preskúmame podrobne náš prístup k hodnoteniu prvej otázky. Ostatné sa skúmajú podobným spôsobom.
Na analýzu rýchlosti požiadaviek chceme získať údaje pre všetkých používateľov, nezaberať veľa času na vývoj a nezhodiť produkciu. Preto existuje niekoľko prístupov:
- RUM, alebo pasívne meranie požiadaviek. Meriame čas vykonávania aktuálnych požiadaviek od používateľov a zabezpečujeme úplné pokrytie používateľov. Nevýhodou je, že signál nie je veľmi stabilný z dôvodu mnohých faktorov, ako sú rôzne veľkosti požiadaviek, čas spracovania na serveri a kliente. Okrem toho nie je možné otestovať novú konfiguráciu bez vplyvu na produkciu.
- Laboratórne testy. Špeciálne servery a infraštruktúra, ktoré imitujú zákazníkov. S ich pomocou vykonávame potrebné testy. Tak získavame úplnú kontrolu nad výsledkami meraní a jasný signál. Avšak nemáme úplné pokrytie zariadení a polohy používateľov (najmä s službou po celom svete a podporou tisíc modelov zariadení).
Ako je možné spojiť výhody oboch metód?
Náš tím našiel riešenie. Napísali sme malý kúsok kódu — vzorok — ktorý sme integrovali do našej aplikácie. Vzorci nám umožňujú vykonávať plne kontrolované sieťové testy z našich zariadení. Funguje to takto:
- Hneď po načítaní aplikácie a dokončení úvodnej aktivity spúšťame naše vzorci.
- Klient vykonáva požiadavku na server a dostáva "recept" testu. Recept je zoznam URL adries, na ktoré je potrebné vykonať HTTP(s) požiadavku. Okrem toho recept konfiguruje parametre požiadaviek: oneskorenia medzi požiadavkami, objem požadovaných údajov, HTTP(s) hlavičky a pod. Pri tom môžeme paralelne testovať niekoľko rôznych receptov — pri požiadavke na konfiguráciu náhodne určujeme, ktorý recept poskytnúť.
- Čas spustenia vzorky sa vyberá tak, aby nezrážal s aktívnym používaním sieťových zdrojov na klientovi. V podstate sa vyberá čas, keď nie je klient aktívny.
- Po obdržaní receptu klient vykonáva požiadavky na každú z URL adries paralelne. Požiadavka na každú z adries môže byť opakovaná — tzv. „pulzy“. Na prvom pulze meriame, koľko času trvalo na nadviazanie spojenia a stiahnutie údajov. Na druhom pulze meriame čas načítania údajov cez už nadviazané spojenie. Pred tretím môžeme nastaviť oneskorenie a zmerať rýchlosť nadviazania opakovaného spojenia a pod.
Počas testu meráme všetky parametre, ktoré môže zariadenie získať:
- čas DNS dopytu;
- čas na nadviazanie spojenia cez TCP;
- čas na nadviazanie spojenia cez TLS;
- čas na prijatie prvého bajtu dát;
- celkový čas načítania;
- status kód výsledku.
- Po skončení všetkých pulsov vzorka načíta výsledky všetkých meraní na analýzu.
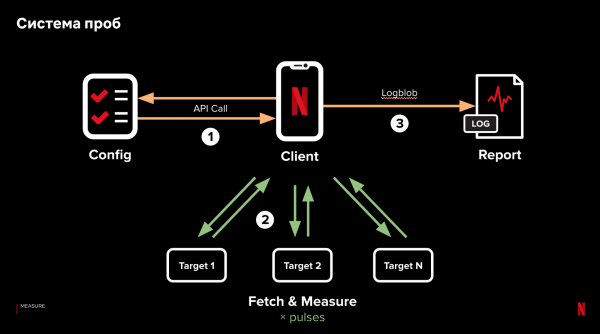
Kľúčovými bodmi sú minimálna závislosť od logiky na klientovi, spracovanie dát na serveri a meranie paralelných dopytov. Takto získavame možnosť izolovať a testovať vplyv rôznych faktorov na výkonnosť dopytov, variabilizovať ich v rámci jedného receptu, a získavať výsledky z reálnych klientov.
Takáto infraštruktúra sa ukázala ako užitočná nielen pre analýzu výkonnosti dopytov. Momentálne máme 14 aktívnych receptov, viac ako 6000 vzoriek za sekundu, ktoré získavajú dáta zo všetkých kútov sveta a s plným pokrytím zariadení. Keby si Netflix kupoval podobnú službu od externých spoločností, stálo by to milióny dolárov ročne, s oveľa horším pokrytím.
Overujeme teóriu v praxi: prototyp
S takouto sústavou sme získali možnosť posúdiť účinnosť CDN proxy na oneskorenie dopytov. Teraz je potrebné:
- vytvoriť prototyp proxy;
- umiestniť prototyp na CDN;
- určiť, ako nasmerovať klientov na proxy na konkrétnom CDN serveri;
- porovnať výkonnosť s dopytmi v AWS bez proxy.
Úlohou je čo najrýchlejšie posúdiť účinnosť navrhnutého riešenia. Na implementáciu prototypu sme vybrali Go, vďaka kvalitným sieťovým knižniciam. Na každom CDN serveri sme nainštalovali prototyp proxy ako statický binárny súbor, aby sme minimalizovali závislosti a zjednodušili integráciu. V počiatočnej implementácii sme maximálne využili štandardné komponenty a malé modifikácie pre HTTP/2 connection pooling a request multiplexing.
Na vyváženie medzi regiónmi AWS sme použili geografickú databázu DNS, tú istú, ktorá sa používa na vyváženie klientov. Na výber CDN servera pre klienta používame TCP Anycast pre servery v Internet Exchange (IX). V tomto variante používame jednu IP adresu pre všetky CDN servery, pričom klient bude smerovaný na CDN server s najmenej IP hops. Na CDN serveroch umiestnených u internetových poskytovateľov (ISP) nemáme kontrolu nad routerom pre nastavenie TCP Anycast, preto využívame , podľa ktorej sú klienti smerovaní k internetovým poskytovateľom pre streamovanie videa.
Takže máme tri typy ciest pre požiadavku: do cloudu cez otvorený internet, cez CDN server v IX alebo cez CDN server umiestnený u internetového poskytovateľa. Naším cieľom je pochopiť, ktorá cesta je najlepšia, a aké výhody prináša proxy, v porovnaní s tým, ako sú požiadavky smerované do produkcie. Na tento účel používame systém testovania nasledujúcim spôsobom:
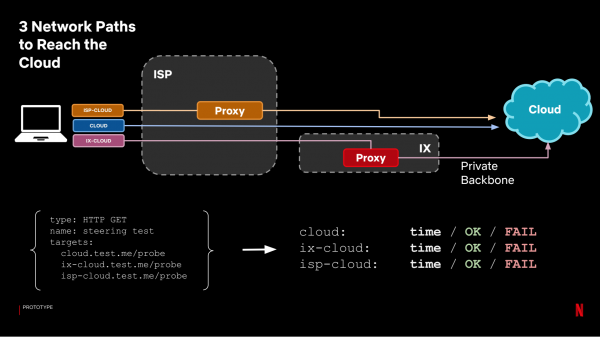
Každá z ciest sa stáva samostatným cieľom a sledujeme čas, ktorý sme dostali. Na analýzu spájame proxy výsledky do jednej skupiny (vyberáme najlepší čas medzi IX a ISP proxy) a porovnávame ho s časom požiadaviek do cloudu bez proxy:
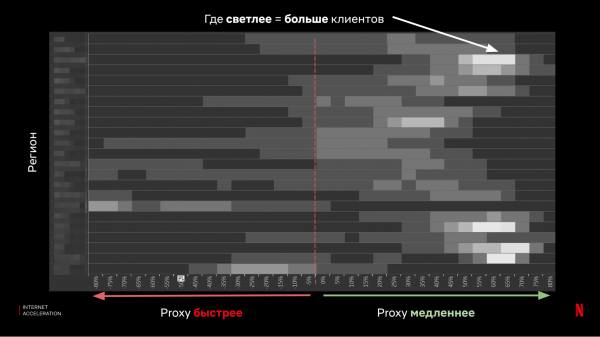
Ako vidno, výsledky boli nejednoznačné — vo väčšine prípadov proxy poskytuje dobré urýchlenie, ale existuje aj dostatočné množstvo klientov, pre ktorých sa situácia výrazne zhorší.
Nakoniec sme urobili niekoľko dôležitých vecí:
- Odhadli sme očakávaný výkon požiadaviek od klientov do cloudu cez CDN proxy.
- Získali sme údaje od skutočných klientov, zo všetkých typov zariadení.
- Pochopili sme, že teória nebola potvrdená na 100 % a počiatočný návrh s CDN proxy pre nás nefunguje.
- Nebráňili sme sa — nemenili sme konfiguračné nastavenia produkcie pre klientov.
- Nič sme nezlomili.
Prototyp 2.0
Tak sa vraciame k kresliacej doske a znova opakujeme proces.
Myšlienka — namiesto 100 % proxy určíme pre každého klienta najrýchlejšiu cestu a budeme tam smerovať požiadavky — teda budeme robiť to, čo sa nazýva client steering.
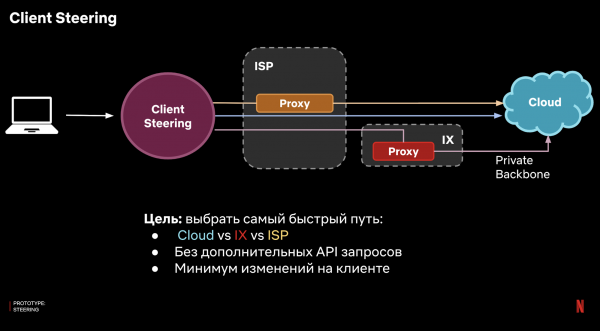
Ako to zrealizovať? Nemôžeme použiť logiku na serverovej strane, pretože cieľom je pripojiť sa k tomuto serveru. Musíme to nejako spraviť na klientskej strane. A ideálne, aby sme to urobili s minimálnym množstvom zložitej logiky, aby sme sa nemuseli zaoberať integráciou s rozsiahlym množstvom klientskej platformy.
Odpoveď — využitie DNS. V našom prípade máme svoju DNS infraštruktúru, a môžeme nastaviť doménovú zónu, pre ktorú budú naše servery autoritatívne. Funguje to takto:
- Klient robí požiadavku na DNS server pomocou hostiteľa, napríklad api.netflix.com.
- Požiadavka sa dostane na náš DNS server.
- DNS server vie, aká cesta je pre tohto klienta najrýchlejšia a vydáva zodpovedajúcu IP adresu.
V riešení je ďalšia zložitosť: autoritatívni DNS poskytovatelia nevidia IP adresu klienta a môžu zohľadniť iba IP adresu rekurzívneho resolvera, ktorým klient používa.
Nakoniec náš autoritatívny resolver musí prijímať rozhodnutie nie pre jednotlivého klienta, ale pre skupinu klientov na základe rekurzívneho resolvera.
Na riešenie používame rovnaké vzorky, agregujeme výsledky meraní od klientov k každému z rekurzívnych resolverov a rozhodujeme, kam túto skupinu nasmerovať — cez proxy cez IX pomocou TCP Anycast, cez ISP proxy alebo priamo do cloudu.
Dostávame takýto systém:
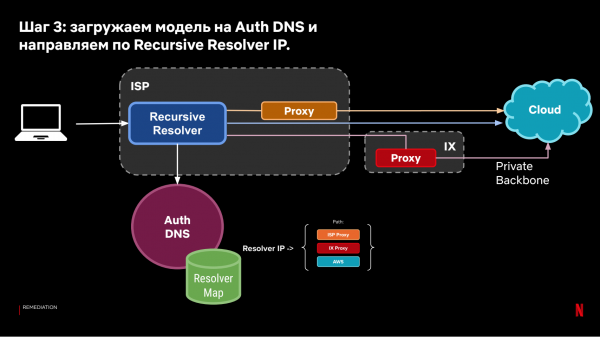
Dostaná model DNS steering umožňuje nasmerovať klientov na základe historických pozorovaní o rýchlosti pripojení od klientov do cloudu.
Opäť sa pýtame — ako efektívne bude tento prístup fungovať? Na odpoveď opäť používame náš systém vzoriek. Preto nastavujeme konfiguráciu nedávnosti, kde jeden z cieľov nasleduje smerovanie od DNS steering, druhý — ide priamo do cloudu (aktuálny produkčný systém).
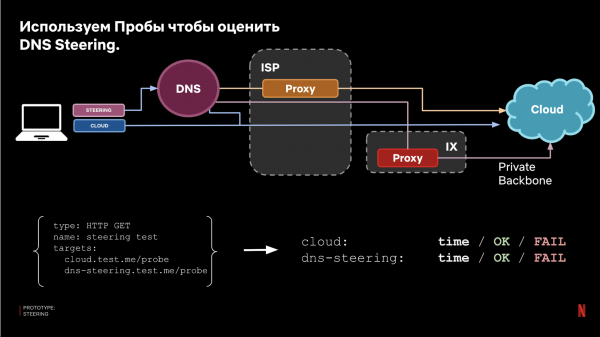
Nakoniec porovnávame výsledky a získavame hodnotenie efektivity:
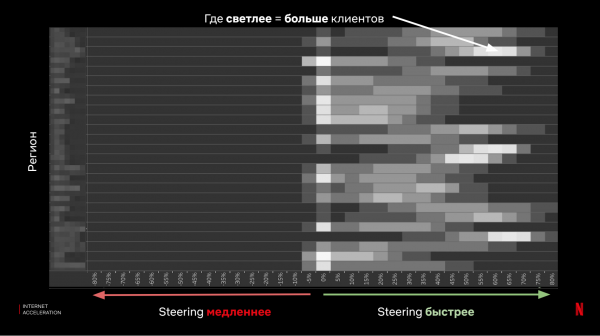
Nakoniec sme sa dozvedeli niekoľko dôležitých vecí:
- Vyhodnotili sme očakávaný výkon požiadaviek od klientov do cloudu s využitím DNS Steering.
- Získali sme údaje od skutočných klientov, zo všetkých typov zariadení.
- Dokázali sme účinnosť navrhnutej myšlienky.
- Nebráňili sme sa — nemenili sme konfiguračné nastavenia produkcie pre klientov.
- Nič sme nezlomili.
Teraz k zložitosti — spúšťame do produkcie.
Najľahšie je teraz za nami – máme funkčný prototyp. Teraz prichádza zložitá časť – spustiť riešenie pre celý Netflix traffic, rozšíriť ho na 150 miliónov používateľov, tisíce zariadení, stovky mikroslužieb a neustále meniaci sa produkt a infraštruktúru. Na servery Netflix prichádzajú milióny požiadaviek za sekundu, a neostré jednanie môže ľahko rozbiť službu. Zároveň chceme dynamicky smerovať traffic cez tisícky serverov CDN v prostredí, kde sa niečo neustále mení a rozbíja v najnevhodnejších momentoch.
A napriek tomu, v tíme sú 3 inžinieri, ktorí sú zodpovední za vývoj, nasadenie a úplnú podporu systému.
Preto sa ďalej budeme zaoberať pokojnym a zdravým spánkom.
Ako pokračovať vo vývoji a stráviť všetok čas na podpore? Našim prístupom sú 3 princípy:
- Zmenšujeme potenciálny rozsah zlyhaní (blast radius).
- Pripravujeme sa na prekvapenia – očakávame, že sa niečo rozbije, bez ohľadu na testovanie a osobné skúsenosti.
- Postupné zhoršovanie (graceful degradation) – ak niečo nefunguje správne, malo by sa automaticky opraviť, aj keď nie najefektívnejším spôsobom.
Ukázalo sa, že v našom prípade, s týmto prístupom k problému, môžeme nájsť jednoduché a efektívne riešenie a značne zjednodušiť podporu systému. Pochopili sme, že môžeme pridať malý kúsok kódu do klienta a sledovať chyby sieťových požiadaviek spôsobených problémami s pripojením. Pri sieťových chybách robíme fallback priamo do cloudu. Toto riešenie nevyžaduje značné úsilie od klientskych tímov, ale výrazne znižuje riziko nečakaných porúch a prekvapení pre nás.
Samozrejme, napriek fallbacku dodržiavame jasnú disciplínu počas vývoja:
- Test na vzorkách.
- A/B testovanie alebo Canaries.
- Postupné vydanie (progressive rollout).
Prístup k testovaniu bol popísaný – zmeny sa najprv testujú pomocou nastaveného receptu.
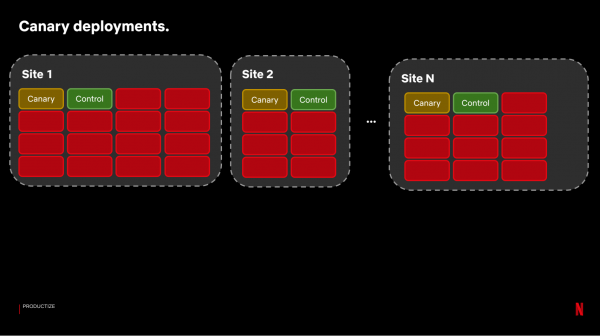
Pre canary testovanie potrebujeme získať porovnateľné páry serverov, na ktorých môžeme porovnať, ako funguje systém pred a po zmenách. Na tento účel z našich početných CDN stránok vytvárame vzorku párov serverov, ktoré dostávajú porovnateľný traffic:
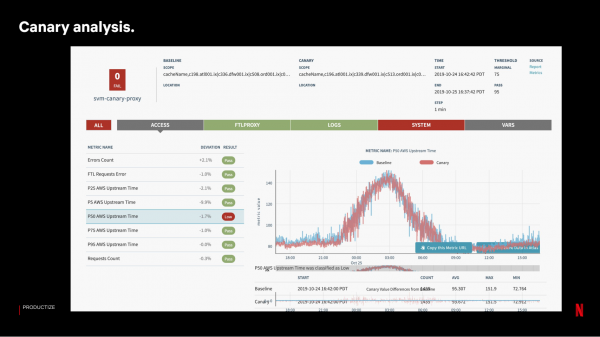
Potom nasadíme zostavenie s úpravami na servery Canary. Na hodnotenie výsledkov spúšťame systém, ktorý porovnáva približne 100-150 metrík s kontrolným vzorkom serverov:
Ak testovanie Canary prebehlo úspešne, robíme vydanie postupne, v vlnách. Na každom z webov neaktualizujeme servery naraz — strata celého webu v prípade problémov má oveľa väčší vplyv na služby pre používateľov, ako strata rovnakého množstva serverov, ale na rôznych miestach.
Celkovo, efektívnosť a bezpečnosť takéhoto prístupu závisí od množstva a kvality zhromaždených metrík. Pre náš systém urýchľovania požiadaviek zhromažďujeme metriky zo všetkých možných komponentov:
- od klientov — počet relácií a požiadaviek, fallback rates;
- proxy — štatistika o počte a čase požiadaviek;
- DNS — počet a výsledky požiadaviek;
- cloud edge — počet a čas na spracovanie požiadaviek v cloude.
Všetko toto sa zhromažďuje do jedného pipeline a v závislosti od potrieb sa rozhodujeme, ktoré metriky posielať na real-time analytiku a ktoré do Elasticsearch alebo Big Data na podrobnejšiu diagnostiku.
Monitorujeme
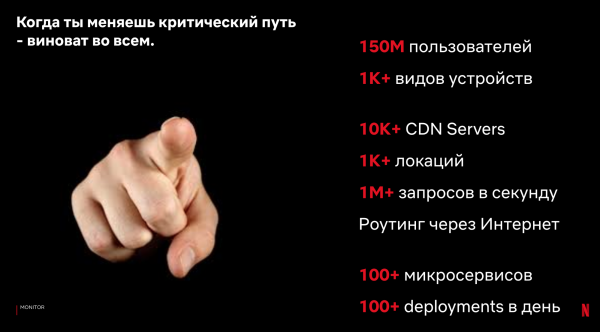
V našom prípade robíme zmeny na kritickej ceste požiadaviek medzi klientom a serverom. Pri tom je množstvo rôznych komponentov na klientovi, na serveri, a na ceste cez internet — obrovské. Zmeny na klientovi a serveri prebiehajú neustále — počas práce desiatok tímov a prirodzených zmien v ekosystéme. Sme uprostred — pri diagnostike problémov je veľká šanca, že sa na tom budeme podieľať. Preto musíme jasne chápať, ako určiť, zhromažďovať a analyzovať metriky na rýchlu lokalizáciu problémov.
Ideálne — plný prístup ku všetkým typom metrík a filtrom v reálnom čase. Ale metrík je veľmi veľa, preto vyvstáva otázka nákladov. V našom prípade rozdeľujeme metriky a vývojové nástroje nasledovne:
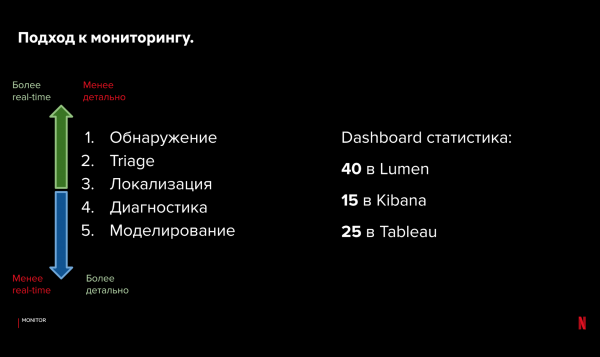
Na objavovanie a triáž problémov používame vlastný real-time systém s otvoreným zdrojovým kódom a — na vizualizáciu. Ukladá agregované metriky do pamäte, je spoľahlivý a integruje sa s alerting systémom. Na lokalizáciu a diagnostiku máme prístup k logom s Elasticsearch a Kibana. Pre štatistickú analýzu a modelovanie využívame big data a vizualizáciu v Tableau.
Zdá sa, že s takýmto prístupom je veľmi ťažké pracovať. Avšak pri hierarchickej organizácii metrík a nástrojov môžeme rýchlo analyzovať problém, určiť jeho typ a následne sa hlbšie zaoberať podrobnými metrikami. Na identifikáciu zdroja poruchy zvyčajne potrebujeme približne 1-2 minúty. Následne už spolupracujeme s konkrétnym tímom na diagnostike — od desiatok minút do niekoľkých hodín.
Aj keď sa diagnostika robí rýchlo, nechceme, aby sa to deje často. V ideálnom prípade dostaneme kritické upozornenie iba v prípade, že má významný dopad na službu. Pre náš systém zrýchlených požiadaviek máme iba 2 upozornenia, ktoré nás budú informovať:
- percento Client Fallback — hodnotenie správania zákazníkov;
- percento Probe errors — údaje o stabilite sieťových komponentov.
Tieto kritické upozornenia sledujú, či systém funguje pre väčšinu používateľov. Sledujeme, koľko zákazníkov využilo fallback, ak sa im nepodarilo získať zrýchlenie požiadaviek. Priemerne máme menej ako 1 kritické upozornenie za týždeň, hoci v systéme prebieha obrovské množstvo zmien. Prečo nám to stačí?
- Existuje client fallback v prípade, že naša proxy nefunguje.
- Existuje automatický systém správy, ktorý reaguje na problémy.
O poslednom viac podrobne. Náš systém prob, a systém automatického určenia optimálnej cesty požiadaviek od klienta do cloudu, umožňujú automaticky zvládať niektoré problémy.
Vráťme sa k našej konfigurácii prob a 3 kategóriám ciest. Okrem času načítania môžeme sledovať aj samotný fakt doručenia. Ak sa údaje nepodarí načítať, môžete sa pozrieť na výsledky z rôznych ciest a určiť, kde a čo sa pokazilo a či to môžeme automaticky opraviť zmenou cesty požiadavky.
Príklady:
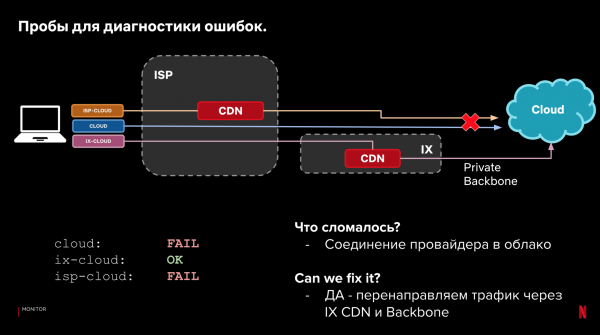
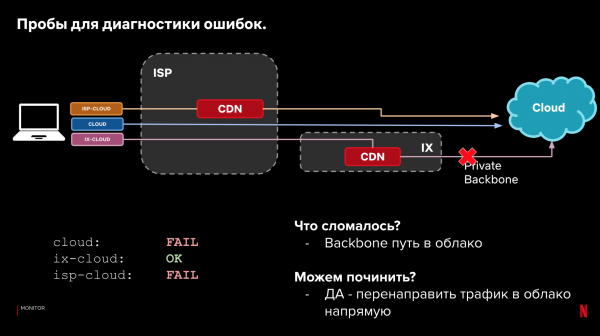
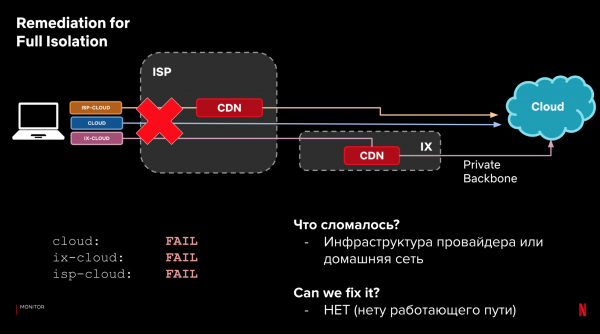
Tento proces je možné automatizovať. Zapracovať ho do systému správy. A naučiť ho reagovať na problémy s výkonom a spoľahlivosťou. Ak sa niečo začne pokaziť — reagovať, ak existuje lepšia možnosť. Pri tom okamžitá reakcia nie je kritická, vďaka fallbacku na klientoch.
Takže, zásady podpory systému môžeme formulovať takto:
- zmenšujeme rozsah porúch;
- zhromažďujeme metriky;
- automaticky opravujeme poruchy, ak môžeme;
- ak nemôžeme — upozorníme;
- Pracujeme na dashboards a triage toolset pre rýchlu reakciu.
Získané ponaučenia
Na vytvorenie prototypu netreba veľa času. V našom prípade bol hotový už za 4 mesiace. S ním sme získali nové metriky a po 10 mesiacoch od začiatku vývoja sme dostali prvý produkčný prúd. Potom nasledovala zdĺhavá a veľmi zložitá práca: postupne produktizovať a škálovať systém, migrovať hlavný prúd a učiť sa na chybách. Tento efektívny proces však nebude lineárny — napriek všetkým snahám sa nedá všetko predvídať. Mnoho efektívnejšie je rýchla iterácia a reakcia na nové dáta.
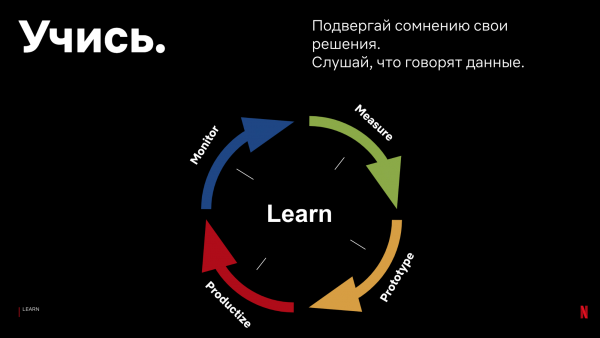
Na základe našich skúseností môžeme odporučiť nasledujúce:
- Neverte intuícii.
Naša intuícia nás neustále sklamala, napriek obrovskému skúsenostnému zázemiu členu tímu. Napríklad, nesprávne sme predpovedali očakávané urýchlenie pri použití CDN proxy, alebo správanie TCP Anycast.
- Získajte dáta z produkcie.
Je dôležité čo najskôr získať prístup aspoň k malému množstvu produkčných dát. Počet unikátnych prípadov, konfigurácií, nastavení v laboratórnych podmienkach je prakticky nemožné získať. Rýchly prístup k výsledkom umožní rýchlejšie zistiť potenciálne problémy a zohľadniť ich v architektúre systému.
- Nenasledujte rady a výsledky iných — zbierajte svoje dáta.
Dbajte na princípy zbierania a analyzovania dát, ale neberte slepo výsledky a tvrdenia iných. Iba vy môžete presne vedieť, čo funguje pre vašich používateľov. Vaše systémy a vaši klienti sa môžu výrazne líšiť od iných firiem. Našťastie sú nástroje na analýzu teraz dostupné a ľahko použiteľné. Vaše získané výsledky sa môžu líšiť od toho, čo tvrdí Netflix, Facebook, Akamai a iné spoločnosti. V našom prípade sa výkonnosť TLS, HTTP2 alebo štatistika DNS dotazov líši od výsledkov Facebooku, Uberu, Akamai — pretože máme iné zariadenia, klientov a toky dát.
- Nesnažte sa bezdôvodne sledovať módne trendy a hodnotiť ich efektívnosť.
Začnite s jednoduchým. Lepšie je vytvoriť jednoduchý funkčný systém za krátky čas, než stráviť obrovské množstvo času vývojom nepotrebných komponentov. Riešte úlohy a problémy, ktoré sú dôležité na základe vašich meraní a výsledkov.
- Buďte pripravení na nové aplikácie.
Rovnako ako je ťažké predvídať všetky problémy, je ťažké aj vopred predpovedať výhody a aplikácie. Berte si príklad zo startupov — ich schopnosť prispôsobiť sa potrebám zákazníkov. Vo vašom prípade môžete objaviť nové problémy a ich riešenia. V našom projekte sme si dali za cieľ znížiť latenciu požiadaviek. Avšak počas analýzy a diskusií sme si uvedomili, že proxy servery môžeme využívať aj:
- na vyváženie prevádzky medzi regiónmi AWS a znižovanie nákladov;
- na modelovanie stability CDN;
- na konfiguráciu DNS;
- na konfiguráciu TLS/TCP.
Záver
V správe som opísal, ako Netflix rieši problém zrýchlenia internetových požiadaviek medzi klientmi a cloudom. Ako zbierame dáta pomocou systémov s výberom na klientoch a využívame zhromaždené historické dáta na smerovanie produkčných požiadaviek od klientov najrýchlejšou cestou na internete. Ako využívame princípy siete, našu CDN infraštruktúru, backbone sieť a DNS servery na dosiahnutie tohto cieľa.
Avšak naše riešenie je len príkladom toho, ako sme v Netflixe implementovali takýto systém. Čo fungovalo pre nás. Aplikačná časť mojej správy pre vás — princípy vývoja a údržby, ktorými sa riadime a dosahujeme dobré výsledky.
Naše riešenie problému vám nemusí vyhovovať. Avšak teória a princípy vývoja zostávajú, aj keď nemáte svoju vlastnú CDN infraštruktúru, alebo ak sa tá vaša výrazne líši od našej.
Naďalej zostáva dôležitosť rýchlosti požiadaviek pre podnikanie. A dokonca aj pre jednoduchú službu treba urobiť voľbu: medzi „cloudovými“ poskytovateľmi, polohou serverov, CDN a DNS poskytovateľmi. Váš výber bude mať vplyv na efektivitu internetových požiadaviek pre vašich zákazníkov. A pre vás je dôležité tento vplyv merať a chápať.
Začnite s jednoduchými riešeniami, dávajte si pozor na to, ako meníte produkt. Učte sa v procese a vylepšujte systém na základe dát od vašich klientov, vašej infraštruktúry a vášho podnikania. Myslite na možnosť neočakávaných porúch v priebehu návrhu. A potom budete môcť urýchliť váš proces vývoja, zlepšiť efektivitu riešenia, vyhnúť sa nadmernému zaťaženiu na podporu a pokojne spať.
V tomto roku online formáte. Môžete položiť otázky jednému z otcov DevOps, samotnému Johnovi Willisovi!
Zdroj: habr.com
