

Napísať tento článok ma podnietilo množstvo materiálov o statickej analýze, ktoré sa čoraz častejšie dostávali do očí. Po prvé, je to , ktorý sa aktívne propaguje na Habr pri pomoci prehľadov chýb, ktoré našiel ich nástroj v projektoch s otvoreným kódom. Nedávno PVS-studio implementovali , a samozrejme, vývojári IntelliJ IDEA, ktorého vstavaný analyzátor je dnes pravdepodobne najpokročilejší pre Javu, .
Pri čítaní takých prehľadov vzniká pocit, že hovoríme o magickom elixíre: stlačte tlačidlo a tu je — zoznam defektov pred očami. Zdá sa, že s pokrokom analyzátorov sa čoraz viac chýb automaticky nájde a produkty skenované týmito robotmi sa stanú čoraz lepšími, bez akýchkoľvek snáh z našej strany.
Ale magické elixíry neexistujú. Chcel by som hovoriť o tom, o čom sa zvyčajne nehovorí v príspevkoch ako „toto sú veci, ktoré môže náš robot nájsť“: čo analyzátory nikdy nemôžu, aká je ich skutočná úloha a miesto v procese dodávky softvéru a ako ich správne implementovať.
Hráček (zdroj: ).
Čo statické analyzátory nikdy nebudú schopné
Čo je, z praktického hľadiska, analýza zdrojového kódu? Predkladáme niektoré zdrojové kódy a na výstupe za krátky čas (oveľa kratší čas ako pri spúšťaní testov) získavame určité informácie o našom systéme. Zásadné a matematicky prekonateľné obmedzenie spočíva v tom, že môžeme týmto spôsobom získať len pomerne úzky rozsah informácií.
Najznámejším príkladom úlohy, ktorá sa nedá vyriešiť pomocou statickej analýzy — : je to veta, ktorá dokazuje, že nemožno vyvinúť všeobecný algoritmus, ktorý by na základe zdrojového kódu programu určil, či sa dostane do nekonečnej slučky alebo ukončí za konečný čas. Rozšírením tejto vety je , ktorá tvrdí, že pre akékoľvek netriviálne vlastnosti výpočtových funkcií je definícia toho, či náhodný program počíta funkciu s takou vlastnosťou, algoritmicky neodborná úloha. Napríklad, nie je možné napísať analyzátor, ktorý na základe akéhokoľvek zdrojového kódu určí, či analyzovaný program implementuje algoritmus, ktorý počíta, povedzme, umocnenie celého čísla na druhú.
Takže funkčnosť statických analyzátorov má neprekonateľné obmedzenia. Statický analyzátor nikdy nebude schopný vo všetkých prípadoch určiť také veci, ako je napríklad vznik 'null pointer exception' v jazykoch, ktoré umožňujú hodnotu null, alebo vo všetkých prípadoch určiť vznik 'attribute not found' v jazykoch s dynamickým typovaním. Všetko, čo môže najdokonalejší statický analyzátor, je vybrať špecifické prípady, ktorých počet medzi všetkými možnými problémami vo vašom zdrojovom kóde je, bez preháňania, kvapkou v mori.
Statická analýza nie je hľadanie chýb.
Z vyššie uvedeného možno vyvodiť záver: statická analýza nie je nástroj na zníženie počtu defektov v programe. Riskol by som povedať: keď sa po prvý raz použije vo vašom projekte, nájde v kóde 'zaujímavé' miesta, ale pravdepodobne nenájde žiadne defekty, ktoré by ovplyvnili kvalitu práce vašej aplikácie.
Príklady defektov automaticky nájdených analyzátormi sú impozantné, ale netreba zabúdať, že tieto príklady boli nájdené pomocou skenovania veľkého súboru veľkých kódových základní. Na rovnakom princípe, hackers, ktorí majú možnosť vyskúšať niekoľko jednoduchých hesiel na veľkom počte účtov, nakoniec nájdu tie účty, ktoré majú jednoduché heslo.
Znamená to, že statickú analýzu netreba aplikovať? Samozrejme, že nie! A to z rovnakého dôvodu, pre ktorý je dobré kontrolovať každé nové heslo, aby nebolo na zozname 'jednoduchých' hesiel.
Statická analýza je viac než hľadanie chýb.
V skutočnosti sú úlohy, ktoré analyzátory zvládajú, oveľa širšie. Veď vo všeobecnosti je statická analýza akákoľvek kontrola zdrojových kódov vykonaná pred ich spustením. Tu je niekoľko vecí, ktoré je možné robiť:
- Kontrola štýlu kódovania v širokom zmysle tohto slova. Zahŕňa to ako kontrolu formátovania, tak aj hľadanie použitia prázdnych/či nadbytočných zátvoriek, nastavenie prahových hodnôt na metriky, ako počet riadkov/cyklomatická zložitosť metódy atď. — teda všetko, čo potenciálne zťažuje čitateľnosť a udržiavateľnosť kódu. V Jave je takýmto nástrojom Checkstyle, v Pythone — flake8. Programy tohto druhu sa zvyčajne nazývajú „lintery“.
- Analýze môže podliehať nielen vykonateľný kód. Súbory s prostriedkami, ako sú JSON, YAML, XML, .properties, môžu (a mali by!) byť automaticky kontrolované na platnosť. Veď je lepšie dozvedieť sa o tom, že kvôli nejakým nepárovým úvodzovkám je štruktúra JSON narušená v rannom štádiu automatickej kontroly Pull Requestu, ako pri vykonávaní testov alebo za behu aplikácie? Zodpovedajúce nástroje sú k dispozícii: napríklad, , .
- Kompilácia (alebo parsenie pre dynamické programovacie jazyky) je tiež druh statickej analýzy. Spravidla sú kompilátory schopné vydávať varovania, ktoré signalizujú problémy s kvalitou zdrojového kódu, a tieto by sa nemali ignorovať.
- Niekedy kompilácia nie je len kompilácia vykonateľného kódu. Napríklad, ak máte dokumentáciu vo formáte , v momente jej premeny na HTML/PDF spracovateľ AsciiDoctor () môže vydávať varovania, napríklad o porušených vnútorných odkazoch. A to je dôvod, prečo neprijať Pull Request s zmenami dokumentácie.
- Kontrola pravopisu je tiež druh statickej analýzy. Nástroj je schopný kontrolovať pravopis nielen v dokumentácii, ale aj v zdrojových kódoch programov (v komentároch a literáloch) v rôznych programovacích jazykoch, vrátane C/C++, Java a Python. Chyba pri písaní v používateľskom rozhraní alebo dokumentácii je tiež defect!
- Konfiguračné testy (o tom, čo to je — pozri a prednášky), hoci sa vykonávajú v prostredí modulárnych testov typu pytest, sú v skutočnosti tiež druhom statickej analýzy, pretože nevykonávajú zdrojové kódy počas svojho vykonávania.
Ako vidíme, hľadanie chýb v tomto zozname zaujíma najmenej dôležitú úlohu, zatiaľ čo všetko ostatné je dostupné použitím bezplatných open source nástrojov.
Ktoré z týchto typov statickej analýzy by ste mali aplikovať vo svojom projekte? Samozrejme, všetky — čím viac, tým lepšie! Podstatné je, implementovať to správne, o čom budeme hovoriť ďalej.
Dodávkový kanál ako viacstupňový filter a statická analýza ako jeho prvý stupeň
Klasickou metaforou nepretržitej integrácie je potrubie (pipeline), ktorým prechádzajú zmeny — od zmeny zdrojového kódu po dodanie do produkcie. Štandardná sekvencia krokov tohto kanála vyzerá takto:
- statická analýza
- kompilácia
- modulové testy
- integračné testy
- UI testy
- ručné overenie
Zmeny, ktoré sú zamietnuté v N-tom stupni kanála, sa neprevádzajú na stupeň N+1.
Prečo práve takto, a nie inak? V tej časti kanála, ktorá sa týka testovania, testeri poznajú široko známe testovacie pyramídové pravidlo.
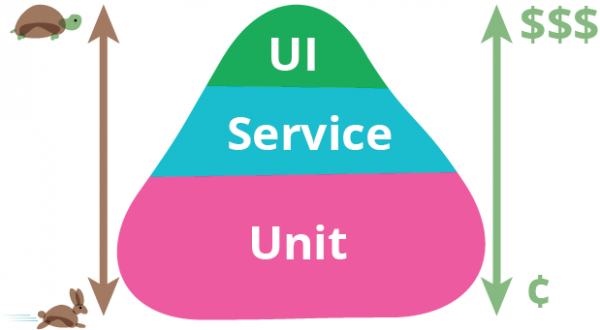
Testovacia pyramída. Zdroj: Martin Fowler.
Na spodnej časti tejto pyramídy sa nachádzajú testy, ktoré sa ľahšie píšu, rýchlejšie sa vykonávajú a nemajú tendenciu k falošným spusteniam. Preto ich musí byť viac, mali by pokrývať viac kódu a vykonávať sa prvé. Na vrchnej časti pyramídy je to naopak, preto by sa množstvo integračných a UI testov malo zredukovať na nevyhnutné minimum. Človek v tomto reťazci je najdrahším, najpomalším a najnedôveryhodnejším zdrojom, a preto sa nachádza na konci a vykonáva prácu iba v prípade, ak predchádzajúce kroky neodhalili žiadne defekty. Avšak podľa tých istých princípov je konštruovaný kanál aj v častiach, ktoré nie sú priamo spojené s testovaním!
Chcel by som navrhnúť analógiu v podobe viacstupňového systému filtrácie vody. Na vstup prichádza špinavá voda (zmene s defektmi), na výstupe musíme získať čistú vodu, všetky neželané nečistoty v ktorej sú odstránené.
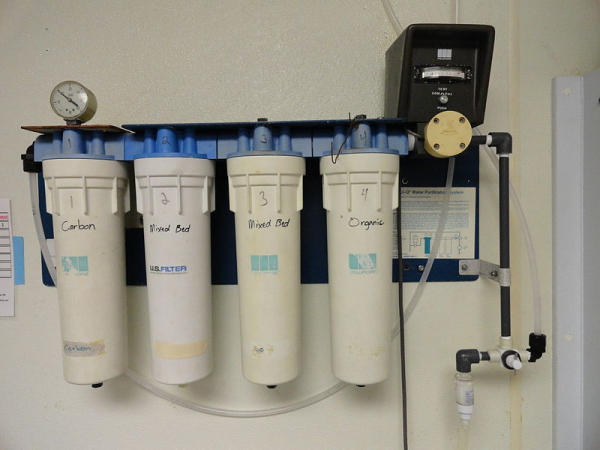
Viacstupňový filter. Zdroj:
Ako je známe, čistiace filtre sú navrhnuté tak, aby každý nasledujúci kaskádový systém dokázal zachytiť stále menšie častice znečistenia. Kaskády s hrubším čistením majú pritom väčšiu priepustnosť a nižšie náklady. V našej analógii to znamená, že vstupné quality gates majú vyšší výkon, vyžadujú menej úsilia na spustenie a sú samy o sebe menej náročné na prevádzku — a práve v takom poradí sú usporiadané. Úloha statickej analýzy, ktorá, ako teraz chápeme, dokáže odhaliť iba tie najhrubšie defekty — to je úloha sitka-„zachytávača nečistôt“ na začiatku kaskády filtrov.
Statická analýza sama o sebe nezlepší kvalitu konečného produktu, ako „zachytávač nečistôt“ neurobí vodu pitnou. Napriek tomu je v kontexte iných prvkov výrobného procesu jej význam očividný. Hoci vo viacstupňovom filtri výstupné kaskády potenciálne dokážu zachytiť to isté, čo aj vstupné — je jasné, aké dôsledky prinesie pokus spoliehať sa iba na kaskády jemného čistenia, bez vstupných kaskád.
Cieľom „zachytávača nečistôt“ je uvoľniť nasledujúce kaskády od zachytávania naozaj hrubých defektov. Napríklad aspoň osoba vykonávajúca code review by sa nemala rozptyľovať nesprávne naformátovaným kódom a porušením stanovených noriem kódovania (napríklad nadbytočnými zátvorkami alebo príliš hlbokým zanořením vetvenia). Chyby typu NPE by mali byť zachytené modulovými testami, ale ak nám analyzátor ešte pred testom naznačí, že chyba sa nevyhnutne vyskytne — to výrazne urýchli jej opravu.
Domnievam sa, že teraz je jasné, prečo statická analýza nezlepšuje kvalitu produktu, ak sa používa epizodicky, a mala by sa aplikovať neustále na odstraňovanie zmien s hrubými defektmi. Otázka, či použitie statického analyzátora zlepší kvalitu vášho produktu, je zhruba ekvivalentná otázke „zlepšia sa pitné vlastnosti vody odobranej z znečisteného vodného zdroja, ak ju preleješ cez cedník?“
Zavedenie do legacy-projektu
Dôležitá praktická otázka: ako implementovať statickú analýzu do procesu kontinuálnej integrácie ako „quality gate“? V prípade automatických testov je to jasné: existuje množstvo testov, zlyhanie ktoréhokoľvek z nich je dostatočným základom považovať, že zostava neprešla quality gate. Pokus o nastavenie gate na základe výsledkov statickej analýzy zlyháva: na legacy kóde je varovaní z analýzy príliš veľa, úplne ich ignorovať nechceme, ale ani zastavovať dodávku produktu iba preto, že obsahuje varovania analyzátora, nie je možné.
Keď sa prvýkrát použije, na akomkoľvek projekte analyzátor vydáva obrovské množstvo varovaní, pričom drvivá väčšina z nich nemá nič spoločné s funkčnosťou produktu. Opraviť všetky tieto pripomienky naraz nie je možné a mnohé — ani potrebné. Napokon, predsa vieme, že náš produkt celkovo funguje a to pred uvedením statickej analýzy!
Nakoniec sa mnohí obmedzujú na epizodické používanie statickej analýzy, alebo ju používajú iba v režime informovania, keď sa pri zostavení jednoducho vydáva správa analyzátora. To je ekvivalentné absencii akejkoľvek analýzy, pretože ak už máme množstvo varovaní, vznik ďalšieho (hneď čiastočne vážneho) pri zmene kódu zostáva nepovšimnutý.
Sú známe nasledujúce spôsoby zavedenia quality gates:
- Nastavenie limitu celkového počtu varovaní alebo počtu varovaní deleného počtom riadkov kódu. Funguje to zle, pretože taký gate voľne prepúšťa zmeny s novými defektmi, pokiaľ nie je prekročený ich limit.
- Zaznamenanie všetkých starých varovaní v kóde ako ignorovaných v určitých momentoch a odmietnutie zostavenia pri vzniku nových varovaní. Túto funkcionalitu poskytuje PVS-studio a niektoré online zdroje, napríklad Codacy. Nemal som skúsenosti s PVS-studio, čo sa týka môjho skúsenosti s Codacy, ich hlavný problém spočíva v tom, že určovanie, čo je „stará“, a čo „nová“ chyba, je pomerne zložitý a nie vždy správne fungujúci algoritmus, najmä ak sa súbory výrazne menia alebo premenúvajú. Podľa mojej pamäte Codacy mohol preskočiť nové varovania v pull requeste, a zároveň neumožniť pull request kvôli varovaniam, ktoré sa netýkajú zmien v kóde tohto PR.
- Podľa môjho názoru je najúčinnejším riešením to, ktoré je opísané v knihe „metóda hračky“ („ratcheting“). Hlavná myšlienka spočíva v tom, že vlastnosť každého vydania je počet varovaní statickej analýzy, a sú povolené len také zmeny, ktoré celkový počet varovaní nezvyšujú.
Hračka
Funguje to nasledovne:
- V počiatočnej fáze sa zaznamenáva do metadát o vydaní počet varovaní v kóde, ktoré našli analyzátory. Týmto spôsobom sa pri zostavení hlavnej vetvy do vášho správcu repozitárov zapisuje nie len „vydanie 7.0.2“, ale „vydanie 7.0.2, obsahujúce 100500 varovaní Checkstyle“. Ak používate pokročilého správcu repozitárov (takého ako Artifactory), uchovať takéto metadáta o vašom vydaní je jednoduché.
- Teraz každý pull request pri zostavení porovnáva počet získaných varovaní s tým, aké množstvo je v aktuálnom vydaní. Ak PR vedie k zvýšeniu tohto čísla, kód neprejde kvalitatívnou bránou pri statickej analýze. Ak sa počet varovaní znižuje alebo nemení — prejde.
- Pri ďalšom vydaní bude znovu zapísané prepočítané množstvo varovaní do metadát vydania.
Takto pomaly, ale neochvejne (ako pri práci s ratchetom), počet varovaní sa bude snažiť o nulu. Samozrejme, systém je možné oklamať pridaním nového varovania, ale opravou cudzieho. Je to v poriadku, pretože v dlhodobom horizonte to prináša výsledky: varovania sa opravujú, ako pravidlo, nie jedno po druhom, ale hromadne v určitej skupine a všetky ľahko odstrániteľné varovania sa pomerne rýchlo odstránia.
Na tomto grafe je zobrazený celkový počet varovaní Checkstyle za pol roka fungovania takého „ratchetu“ na . Počet varovaní sa znížil o poriadok, pričom sa to udialo prirodzene, súbežne s vývojom produktu!
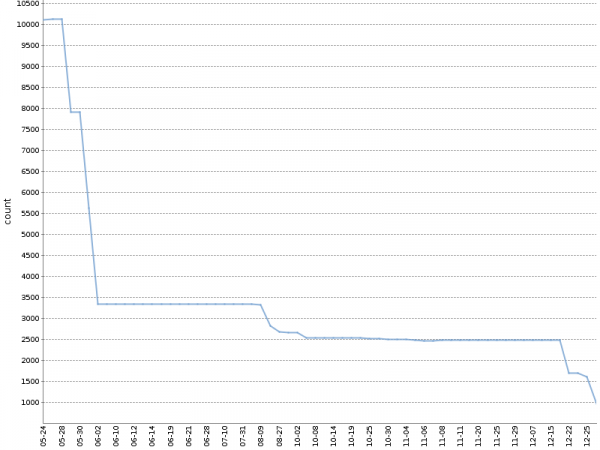
Používam modifikovanú verziu tejto metódy, pričom samostatne počítam varovania s rozdelením podľa modulov projektu a analyzačných nástrojov, pričom vytvorený YAML súbor s metadátami o zostavení vyzerá približne takto:
celesta-sql:
  checkstyle: 434
  spotbugs: 45
celesta-core:
  checkstyle: 206
  spotbugs: 13
celesta-maven-plugin:
  checkstyle: 19
  spotbugs: 0
celesta-unit:
  checkstyle: 0
  spotbugs: 0
V akejkoľvek pokročilej CI-systéme môžeme realizovať „ratchet“ pre akékoľvek nástroje statickej analýzy, bez spolíhania na pluginy a externé nástroje. Každý z analyzátorov vydáva svoju správu v jednoduchom textovom alebo XML formáte, ktorý je ľahko analyzovateľný. Ostáva len zapísať potrebnú logiku do CI skriptu. Inšpirovať sa, ako to je realizované v našich open source projektoch založených na Jenkins a Artifactory, je možné alebo . Obe príklady sú závislé od knižnice : metóda countWarnings() bežne počíta xml značky v súboroch vytvorených Checkstyle a Spotbugs, a compareWarningMaps() realizuje ten skutočný ratchet, vyhadzujúc chybu v prípade, že počet varovaní v ktorejkoľvek zo skupín sa zvyšuje.
Zaujímavou implementáciou „reťazovej prevodovky“ je analýza pravopisu komentárov, textových literálov a dokumentácie pomocou aspell. Ako je známe, pri kontrole pravopisu nie všetky slová, ktoré nie sú známe štandardnému slovníku, sú nesprávne; môžu byť pridané do používateľského slovníka. Ak urobíte používateľský slovník súčasťou zdrojového kódu projektu, kvalitatívna brána pre pravopis môže byť formulovaná takto: vykonanie aspell so štandardným a používateľským slovníkom. nájsť žiadne pravopisné chyby.
O dôležitosti fixácie verzie analyzátora
Na záver je potrebné poznamenať nasledovné: akýmkoľvek spôsobom by ste nechceli implementovať analýzu do vášho dodávacieho procesu, verzia analyzátora by mala byť fixovaná. Ak by došlo k samovoľnej aktualizácii analyzátora, pri zostavovaní ďalšieho pull request-u sa môžu objaviť nové defekty, ktoré nie sú spojené so zmenou kódu, ale súvisia s tým, že nový analyzátor dokáže nájsť viac defektov — a to vám rozbije proces schvaľovania pull request-ov. Aktualizácia analyzátora by mala byť vedomým krokom. Napriek tomu je prísna fixácia verzie každej zostavovacej komponenty vo všeobecnosti nevyhnutným požiadavkom a témou na osobitnú diskusiu.
Zhrnutie
- Statická analýza vám nenájde bugy a nezlepšuje kvalitu vášho produktu v dôsledku jednorazového použitia. Pozitívny efekt na kvalitu prináša len jej trvalé uplatňovanie počas dodávky.
- Hľadanie bugov nie je vôbec hlavnou úlohou analýzy; prevládajúca väčšina užitočných funkcií je dostupná v opensource nástrojoch.
- Implementujte kvalitatívne brány na základe výsledkov statickej analýzy už v prvom štádiu dodávacieho procesu, používajúc „reťazovú prevodovku“ pre legacy kód.
Odkazy
- prednáška o rôznych metódach analýzy kódu (nielen statickej!)
Zdroj: habr.com
