

Pozadie
Stalo sa, že server bol napadnutý ransomwarom, ktorý "šťastnou náhodou" čiastočne ponechal nedotknuté súbory .ibd (súbory surových údajov tabuliek InnoDB), ale pritom úplne zašifroval súbory .fpm (súbory štruktúr). Soubory .idb je možné rozdeliť na:
- obnoviteľné prostredníctvom štandardných prostriedkov a príručiek. Pre takéto prípady existuje výborná ;
- čiastočne zašifrované tabuľky. Prevaha sú veľké tabuľky, na ktoré (ako som pochopil) útočníci nemali dostatok operačnej pamäte na úplné zašifrovanie;
- a úplne zašifrované tabuľky, ktoré nie sú obnoviteľné.
Určiť, ktorému z variantov tabuľky patrí, sa podarilo prostým otvorením v akomkoľvek textovom editore pod správnym kódovaním (v mojom prípade UTF8) a jednoduchým prezeraním súboru na prítomnosť textových polí, napríklad:
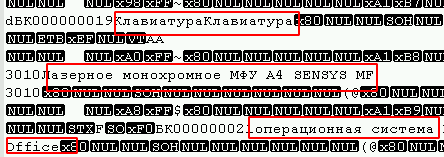
Tiež, na začiatku súboru je možné pozorovať značné množstvo nulových bajtov, a vírusy využívajúce blokovú šifrovaciu metódu (najpoužívanejšia), zvyčajne zasahujú aj do nich.

V mojom prípade útočníci na konci každého zašifrovaného súboru zanechali reťazec 4 bajtov (1, 0, 0, 0), čo výrazne uľahčilo úlohu. Na vyhľadávanie neinfikovaných súborov stačil aj skript:
def opened(path):
    files = os.listdir(path)
    for f in files:
        if os.path.isfile(path + f):
            yield path + f

for full_path in opened("C:somepath"):
    file = open(full_path, "rb")
    last_string = ""
    for line in file:
        last_string = line
        file.close()
    if (last_string[len(last_string) -4:len(last_string)]) != (1, 0, 0, 0):
        print(full_path)
Týmto spôsobom sa podarilo nájsť súbory patríce k prvému typu. Druhý typ predpokladá dlhú ručnú prácu, ale nájdeného už bolo dosť. Všetko by bolo dobré, ale je potrebné vedieť absolútne presnú štruktúru a (samozrejme) nastal taký prípad, keď bolo potrebné pracovať s často sa meniacou tabuľkou. Nikto si už ani nepamätal, či sa menil typ poľa, alebo sa pridával nový stĺpec.
Debri city, bohužiaľ, nemohli pomôcť s takýmto prípadom, a preto je napísaný tento článok.
K veci
Existuje štruktúra tabuľky z pred troch mesiacov, ktorá sa nezhoduje s aktuálnou (možno podľa jedného poľa, alebo možno aj viacerých). Štruktúra tabuľky:
CREATE TABLE `table_1` (
    `id` INT (11),
    `date` DATETIME ,
    `description` TEXT ,
    `id_point` INT (11),
    `id_user` INT (11),
    `date_start` DATETIME ,
    `date_finish` DATETIME ,
    `photo` INT (1),
    `id_client` INT (11),
    `status` INT (1),
    `lead__time` TIME ,
    `sendstatus` TINYINT (4)
);
v tomto prípade je potrebné extrahovať:
id_pointINT (11);id_userINT (11);date_startDATETIME ;date_finishDATETIME .
Na obnovu sa používa byte-by-byte analýza .ibd súboru, s následným prevedením do čitateľnejšej podoby. Keďže na nájdenie požadovanej informácie stačí analyzovať také typy údajov ako int a datetime, článok sa bude zaoberať iba nimi, ale občas sa budem odvolávať aj na iné typy údajov, čo môže pomôcť v iných podobných prípadoch.
Problém 1: v poliach s typmi DATETIME a TEXT boli NULL hodnoty, a v súbore sa jednoducho preskočili, z tohto dôvodu nebolo možné určiť štruktúru na obnovu v mojom prípade. V nových stĺpcoch bola predvolená hodnota null a časť transakcií mohla byť stratená kvôli nastaveniu innodb_flush_log_at_trx_commit = 0, preto by na určenie štruktúry bolo potrebné tráviť dodatočný čas.
Problém 2: treba zohľadniť, že riadky odstránené cez DELETE sa predsa len nachádzajú v .ibd súbore, ale pri ALTER TABLE sa ich štruktúra neaktualizuje. Nakoniec sa štruktúra údajov môže líšiť od začiatku súboru po jeho koniec. Ak často používate OPTIMIZE TABLE, s takým problémom sa pravdepodobne nestretnete.
Všimnite si, verzia DBMS ovplyvňuje spôsob ukladania údajov, a tento príklad nemusí fungovať pre iné major verzie. V mojom prípade sa používala Windows verzia mariadb 10.1.24. Rovnako, aj keď v mariadb pracujete s tabuľkami InnoDB, vlastne sú to , čo vylučuje použiteľnosť metódy s InnoDB mysql.
Analýza súboru
V pythone, typ údajov zobrazuje údaje v Unicode namiesto bežnej číselnej sady. Hoci je možné súbor zobraziť aj takto, pre pohodlie sa môžu bajty previesť na číselný formát prevodom bajtového poľa na bežné pole (list(example_byte_array)). V každom prípade sa na analýzu hodia obidva spôsoby.
Prezerajúc niekoľko ibd súborov, môžete stretnúť nasledujúce:
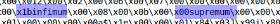
Pričom, ak súbor rozdelíte podľa týchto kľúčových slov, dostanete prevažne rovné bloky údajov. Budeme používať infimum ako deliteľ.
table = table.split("infimum".encode())Zaujímavá pozorovanie, pre tabuľky s malým množstvom údajov, medzi infimum a supremum existuje ukazovateľ na počet riadkov v bloku.
 — testovacia tabuľka s 1 riadkom
 — testovacia tabuľka s 2 riadkami
Pole reťazca table[0] možno preskočiť. Pri jeho prezeraní som sa nedokázal dopátrať k surovým údajom v tabuľkách. Pravdepodobne tento blok slúži na uchovanie indexov a kľúčov.
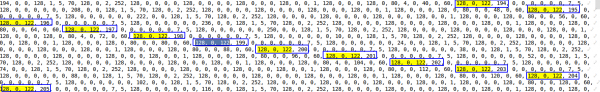
Začínajúc od table[1] a prevodom na číselné pole, už môžeme spozorovať niektoré vzory, a to:
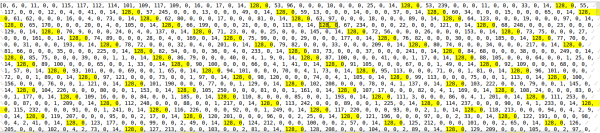
Sú to int hodnoty uložené v reťazci. Prvý bajt ukazuje, či je číslo kladné, alebo záporné. V mojom prípade sú všetky čísla kladné. Z ďalších 3 bajtov môžeme určiť číslo pomocou nasledujúcej funkcie. Skript:
def find_int(val: str):  # príklad '128, 1, 2, 3'
    val = [int(v) for v in  val.split(", ")]
    result_int = val[1]*256**2 + val[2]*256*1 + val[3]
    return result_int
Napríklad, 128, 0, 0, 1 = 1, alebo 128, 0, 75, 108 = 19308.
V tabuľke bol primárny kľúč s autoinkrementáciou, a tu ho môžeme tiež objaviť.
Porovnaním údajov z testovacích tabuliek bolo zistené, že objekt DATETIME pozostáva z 5 bajtov, začína na 153 (pravdepodobne ukazuje na ročné intervaly). Keďže rozsah DATETIME je '1000-01-01' do '9999-12-31', myslím, že počet bajtov môže variť, ale v mojom prípade údaje spadajú do obdobia od 2016 do 2019, takže budeme predpokladať, že 5 bajtov je dostatočné.
Na určenie času bez sekúnd boli napísané nasledujúce funkcie. Skript:
day_ = lambda x: x % 64 // 2  # {x,x,X,x,x }

def hour_(x1, x2):  # {x,x,X1,X2,x}
    if x1 % 2 == 0:
        return x2 // 16
    elif x1 % 2 == 1:
        return x2 // 16 + 16
    else:
        raise ValueError

min_ = lambda x1, x2: (x1 % 16) * 4 + (x2 // 64)  # {x,x,x,X1,X2}
Na rok a mesiac sa mi nepodarilo napísať funkciu, ktorá by správne fungovala, takže som to musel naprogramovať staticky. Skript:
ym_list = {'2016, 1': '153, 152, 64', '2016, 2': '153, 152, 128',
           '2016, 3': '153, 152, 192', '2016, 4': '153, 153, 0',
           '2016, 5': '153, 153, 64', '2016, 6': '153, 153, 128',
           '2016, 7': '153, 153, 192', '2016, 8': '153, 154, 0',
           '2016, 9': '153, 154, 64', '2016, 10': '153, 154, 128',
           '2016, 11': '153, 154, 192', '2016, 12': '153, 155, 0',
           '2017, 1': '153, 155, 128', '2017, 2': '153, 155, 192',
           '2017, 3': '153, 156, 0', '2017, 4': '153, 156, 64',
           '2017, 5': '153, 156, 128', '2017, 6': '153, 156, 192',
           '2017, 7': '153, 157, 0', '2017, 8': '153, 157, 64',
           '2017, 9': '153, 157, 128', '2017, 10': '153, 157, 192',
           '2017, 11': '153, 158, 0', '2017, 12': '153, 158, 64',
           '2018, 1': '153, 158, 192', '2018, 2': '153, 159, 0',
           '2018, 3': '153, 159, 64', '2018, 4': '153, 159, 128',
           '2018, 5': '153, 159, 192', '2018, 6': '153, 160, 0',
           '2018, 7': '153, 160, 64', '2018, 8': '153, 160, 128',
           '2018, 9': '153, 160, 192', '2018, 10': '153, 161, 0',
           '2018, 11': '153, 161, 64', '2018, 12': '153, 161, 128',
           '2019, 1': '153, 162, 0', '2019, 2': '153, 162, 64',
           '2019, 3': '153, 162, 128', '2019, 4': '153, 162, 192',
           '2019, 5': '153, 163, 0', '2019, 6': '153, 163, 64',
           '2019, 7': '153, 163, 128', '2019, 8': '153, 163, 192',
           '2019, 9': '153, 164, 0', '2019, 10': '153, 164, 64',
           '2019, 11': '153, 164, 128', '2019, 12': '153, 164, 192',
           '2020, 1': '153, 165, 64', '2020, 2': '153, 165, 128',
           '2020, 3': '153, 165, 192','2020, 4': '153, 166, 0',
           '2020, 5': '153, 166, 64', '2020, 6': '153, 1, 128',
           '2020, 7': '153, 166, 192', '2020, 8': '153, 167, 0',
           '2020, 9': '153, 167, 64','2020, 10': '153, 167, 128',
           '2020, 11': '153, 167, 192', '2020, 12': '153, 168, 0'}

def year_month(x1, x2):  # {x,X,X,x,x }

    for key, value in ym_list.items():
        key = [int(k) for k in key.replace("'", "").split(", ")]
        value = [int(v) for v in value.split(", ")]
        if x1 == value[1] and x2 // 64 == value[2] // 64:
            return key
    return 0, 0
Som si istý, ak strávite n počet času, aj tento problém sa dá vyriešiť.
Ďalej, funkcia vracajúca objekt datetime zo stringu. Skript:
def find_data_time(val:str):
    val = [int(v) for v in val.split(", ")]
    day = day_(val[2])
    hour = hour_(val[2], val[3])
    minutes = min_(val[3], val[4])
    year, month = year_month(val[1], val[2])
    return datetime(year, month, day, hour, minutes)
Podarilo sa zistiť často sa opakujúce hodnoty z int, int, datetime, datetime 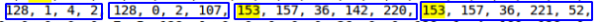 , zdá sa, že toto je to, čo potrebujeme. Navyše, takáto sekvencia sa v riadku dvakrát neopakuje.
Používajúc regulárny výraz, nachádzame potrebné dáta:
fined = re.findall(r'128, d*, d*, d*, 128, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*', int_array)Všimnite si, že pri vyhľadávaní pomocou tohto výrazu sa nedá určiť NULL hodnoty v požadovaných poliach, ale v mojom prípade to nie je kritické. Následne v cykle prechádzame nájdené. Skript:
result = []
for val in fined:
    pre_result = []
    bd_int  = re.findall(r"128, d*, d*, d*", val)
    bd_date= re.findall(r"(153, 1[6,5,4,3]d, d*, d*, d*)", val)
    for it in bd_int:
        pre_result.append(find_int(bd_int[it]))
    for bd in bd_date:
        pre_result.append(find_data_time(bd))
    result.append(pre_result)
V podstate, všetky údaje z poľa result sú tým, čo potrebujeme.
Chápem, že takýto spôsob nebude vyhovovať každému, ale hlavným cieľom článku je skôr podnietiť k činnosti, než riešiť všetky vaše problémy. Myslím, že najlepšie riešenie by bolo začať študovať zdrojový kód samotného , ale vzhľadom na obmedzený čas sa tento spôsob javí ako najrýchlejší.
V niektorých prípadoch, analyzovaním súboru môžete určiť približnú štruktúru a obnoviť pomocou niektorého zo štandardných spôsobov uvedených vyššie. To bude oveľa správnejšie a spôsobí menej problémov.
Zdroj: habr.com
