

Ahoj všetkým. Nižšie je prepis .
– systém monitorovania rôznych systémov a služieb, pomocou ktorého systémoví administrátori môžu zhromažďovať informácie o aktuálnych parametroch systémov a nastavovať upozornenia na získavanie notifikácií o odchýlkach v ich fungovaní.
V prednáške bude porovnanie a – projektov pre dlhodobé uchovávanie metriky Prometheus.
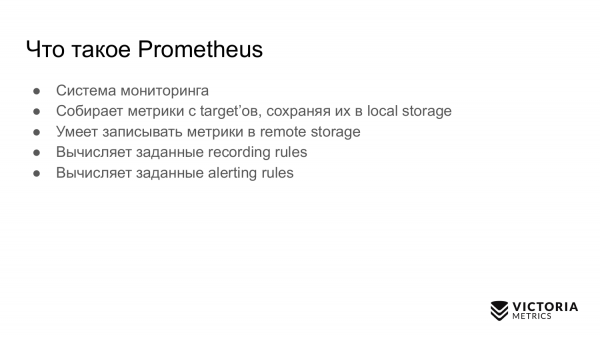
Najprv sa porozprávam o Prometheus. Je to monitorovací systém, ktorý zhromažďuje metriky z určených cieľov a ukladá ich do lokálneho úložiska. Prometheus vie zapisovať metriky do vzdialeného úložiska, vie generovať alerty a pravidlá nahrávania.
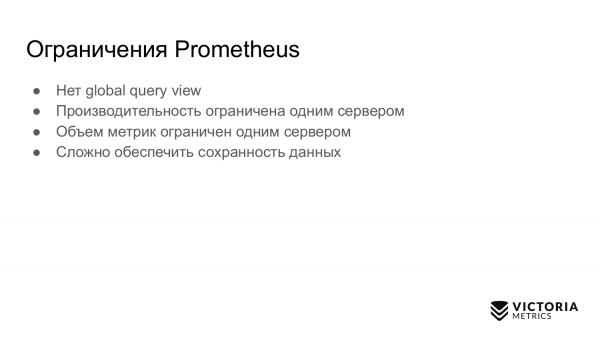
Obmedzenia Prometheus:
- Nemá globálny výhľad na dopyty. To nastáva, keď máte niekoľko nezávislých inštancií Prometheus. Zhromažďujú metriky a vy chcete urobiť dopyt nad všetkými týmito metrikami zhromaždenými z rôznych inštancií Prometheus. Prometheus to neumožňuje.
- Výkon Prometheus je obmedzený iba jedným serverom. Prometheus sa automaticky nemôže rozširovať na niekoľko serverov. Môžete len ručne rozdeliť vaše ciele medzi niekoľko Prometheus.
- Objem metriky v Prometheus je obmedzený iba jedným serverom z rovnakého dôvodu, pre ktorý sa automaticky nemôže rozširovať na viacero serverov.
- V Prometheus nie je také jednoduché zorganizovať ochránenie dát.
Riešenia týchto problémov/úloh?
Riešenia sú takéto:
Všetky tieto riešenia pre vzdialené uchovávanie dát, ktoré zhromaždil Prometheus. Riešia problém vzdialeného úložiska z predchádzajúceho snímku rôznymi spôsobmi. V tejto prezentácii budem hovoriť len o prvých dvoch riešeniach: a .
Prvýkrát sa informácie o objavili . Tam je opísaná architektúra a ako funguje.
Thanos berie údaje, ktoré uložil Prometheus na lokálny disk a prenáša ich do S3, do alebo do iného objektového úložiska.
Takto Thanos zabezpečuje globálny výhľad na dopyty. Môžete žiadať údaje, ktoré sú uložené v objektovom úložisku z niekoľkých inštancií Prometheus.
Thanos podporuje PromQL a .
Thanos používa kód Prometheus na ukladanie údajov.
Thanos vyvíjajú tí istí vývojári, ktorí vyvinuli aj Prometheus.
O . Tu je , kde sme prvýkrát hovorili o .
VictoriaMetrics získava dáta z viacerých prometheus cez protokol, ktorý podporuje Prometheus.
VictoriaMetrics poskytuje globálny pohľad na dotazy, pretože niekoľko inštancií Prometheus môže zapisovať dáta do jednej VictoriaMetrics. Môžete teda vykonávať dotazy nad všetkými týmito údajmi.

VictoriaMetrics tiež podporuje, rovnako ako Thanos — PromQL a Prometheus querying API.
Na rozdiel od Thanos, zdrojový kód VictoriaMetrics bol napísaný od nuly a optimalizovaný pre rýchlosť a spotrebu zdrojov.
VictoriaMetrics sa, na rozdiel od Thanos, škáluje vertikálne aj horizontálne. Existuje , ktorá sa škáluje vertikálne. Môžete začať s jedným procesorom a 1 GB pamäte a postupne rásť až po stovky procesorov a 1 TB pamäte. VictoriaMetrics dokáže využiť všetky tieto zdroje. Jej výkon vzrastie približne 100-krát v porovnaní s jednojadrovým systémom.
História Thanos sa začala v novembri 2017, keď sa objavil prvý verejný commit. Predtým, Thanos sa vyvíjal vo vnútri spoločnosti .
V júni 2019 došlo k významnému vydaniu 0.5.0, v ktorom protokol. Bol odstránený z Thanos, pretože sa ukázal v nie najlepšom svetle. Často klaster Thanos nesprávne fungoval, uzly sa k nemu nesprávne pripájali kvôli gossip protokolu. Preto sa rozhodli tento protokol odstrániť. Považujem to za správne rozhodnutie.
V tom istom júni 2019 poslali žiadosť číslo v .
A o pár mesiacov Thanos prijali do , do ktorého patrí Prometheus, Kubernetes a ďalšie populárne projekty.
V januári 2018 sa začal vývoj VictoriaMetrics.
V septembri 2018 som prvýkrát verejne spomenul VictoriaMetrics.
V decembri 2018 bola zverejnená verzia pre jediného uzla.
V máji 2019 zdrojové kódy pre verziu pre jediného uzla ako aj pre klastrovú verziu.
V júni 2019, rovnako ako Thanos, sme podali žiadosť do CNCF foundation pod číslom . Žiadosť sme podali deň pred tým, ako podal žiadosť Thanos.
Ale, bohužiaľ, zatiaľ nás tam neprijali. Potrebujeme pomoc komunity.
Pozrime sa na najdôležitejšie snímky, ktoré ukazujú architektúru Thanos a VictoriaMetrics.
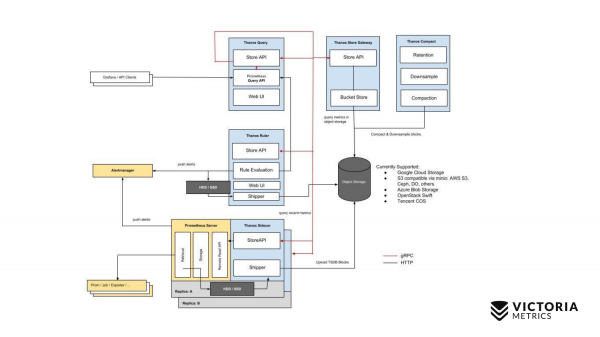
Začneme s Thanos. Žlté komponenty sú komponenty Prometheus. Všetko ostatné sú komponenty Thanos. Začneme s hlavným komponentom. Thanos Sidecar je komponent, ktorý je nainštalovaný vedľa každého Prometheus. Zabezpečuje načítanie údajov Prometheus z lokálneho úložiska do S3 alebo iného objektného úložiska.
Existuje aj taká súčasť ako Thanos Store Gateway, ktorá dokáže čítať tieto dáta z Object Storage pri prichádzajúcich požiadavkách od Thanos Query. Thanos Query implementuje PromQL a Prometheus API. To znamená, že z vonku vyzerá ako Prometheus. Prijíma požiadavky PromQL, posiela ich do Thanos Store Gateway, Thanos Store Gateway získava potrebné dáta z Object Storage a posiela ich späť.
Ale v našom Object Storage sú uložené dáta bez posledných dvoch hodín kvôli špecifikám implementácie Thanos Sidecar, ktorý nemôže nahrať posledné dve hodiny do Object Storage S3, pretože pre tieto dve hodiny ešte Prometheus nevytvoril súbory v lokálnom úložisku.
Ako sa to podarilo obísť? Thanos Query okrem požiadaviek na Thanos Store Gateway, paralelne posiela požiadavky aj na každý Thanos Sidecar, ktorý sa nachádza blízko Prometheus.
A Thanos Sidecar, na druhej strane, proxyje požiadavky ďalej do Prometheus a získava dáta za posledné dve hodiny.
Okrem týchto komponentov existuje aj voliteľná súčasť, bez ktorej sa Thanos nebude cítiť dobre. Je to Thanos Compact, ktorý sa zaoberá zlúčením malých súborov na Object Storage do väčších súborov, ktoré boli nahodené sem Thanos Sidecarmi. Thanos Sidecar nahráva tam súbory s dátami za dve hodiny. Tieto súbory, ak ich nezlúčiť do väčších súborov, môžu výrazne narastať. Čím viac takýchto súborov, tým viac pamäte potrebuje Thanos Store Gateway, tým viac zdrojov je potrebných na prenos dát cez sieť, metadát. Práca Thanos Store Gateway sa stáva neefektívnou. Preto je potrebné určite spustiť Thanos Compact, ktorý zlúči malé súbory do väčších, aby sa znížil počet súborov a znížil overhead na Thanos Store Gateway.
Existuje aj taká komponenta ako Thanos Ruler. Ten vykonáva pravidlá upozornenia Prometheus a môže vypočítavať pravidlá nahrávania Prometheus, aby opäť uložil dáta do Object Storage. Ale tento komponent sa neodporúča používať, pretože je .
Takáto jednoduchá schéma je u Thanos.
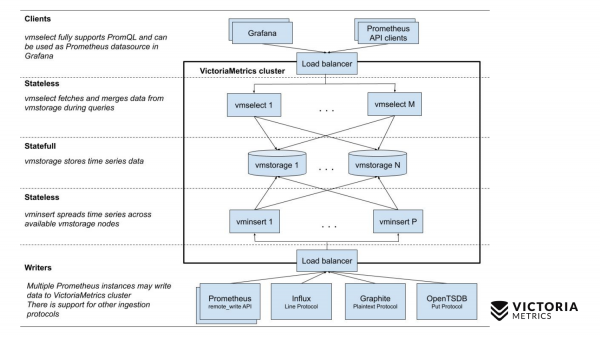
Teraz porovnajme so schémou VictoriaMetrics.
VictoriaMetrics má 2 verzie: Single-node a klustrová verzia. Single-node funguje na jednom počítači. V Single-node nie sú tieto komponenty, jednoducho len jeden binárny súbor. Tento binárny súbor na snímke vyzerá ako tento štvorec. Všetko, čo sa nachádza vo vnútri štvorca — to je obsah binárneho súboru pre Single-node verziu. Nemusíte o ňom vedieť. Jednoducho spustíte binárny súbor — a všetko funguje.
Clusterová verzia je zložitejšia. Vnútri sa nachádzajú tri rôzne komponenty: vmselect, vminsert a vmstorage. Z ich názvov by malo byť jasné, čím sa každá z nich zaoberá. Komponent Insert prijíma údaje v rôznych formátoch: z Prometheus remote write API, Influx line protokolu, Graphite protokolu a z OpenTSDB protokolu. Komponent Insert ich prijíma, parsuje a rozdeľuje medzi existujúce komponenty storage, kde sa údaje ukladajú. , ako aj Prometheus querying API, a môže byť použitý ako náhrada Prometheus v Grafana alebo iných klientoch Prometheus API. Select prijíma promql dopyty, parsuje ich, číta potrebné údaje na vykonanie tohto dopytu zo storage uzlov, spracováva tieto údaje a vracia odpoveď.
Porovnajme zložitosti inštalácie Thanos a VictoriaMetrics.
Začneme s Thanos. Predtým, ako začnete pracovať s Thanos, je potrebné vytvoriť bucket v Object Storage, ako S3 alebo GCS, aby Thanos Sidecar mohol zapisovať údaje.
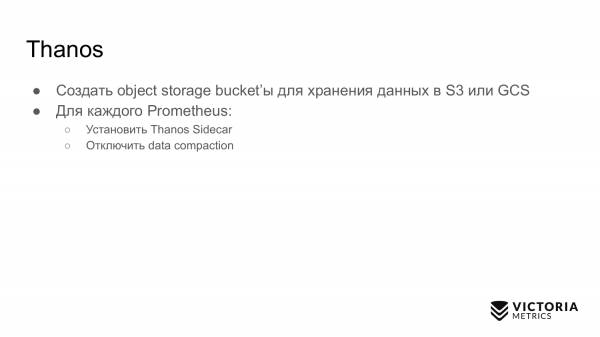
Potom je potrebné pre každý Prometheus nainštalovať Thanos Sidecar. Predtým nezabudnite vypnúť zhutnenie údajov (data compaction) v Prometheus. Zhutnenie údajov pravidelne komprimuje údaje v miestnom úložisku Prometheus, aby sa znížila spotreba zdrojov.
Keď nainštalujete Thanos Sidecar do vašich Prometheov, musíte vypnúť zhutnenie údajov, pretože Thanos Sidecar nedokáže správne fungovať pri zapnutom zhutnení údajov. To znamená, že váš Prometheus začína ukladať údaje po blokoch po dve hodiny a prestáva zlúčiť tieto bloky do väčších. Ak teda robíte dopyty, ktoré presahujú trvanie za posledné dve hodiny, nebudú fungovať tak efektívne, ako by mohli, keby bolo zhutnenie údajov zapnuté.
Preto Thanos odporúča skrátiť čas uchovávania údajov (data retention) v miestnom storage na 6-8 hodín, aby sa znížil tento overhead veľkého množstva malých blokov.
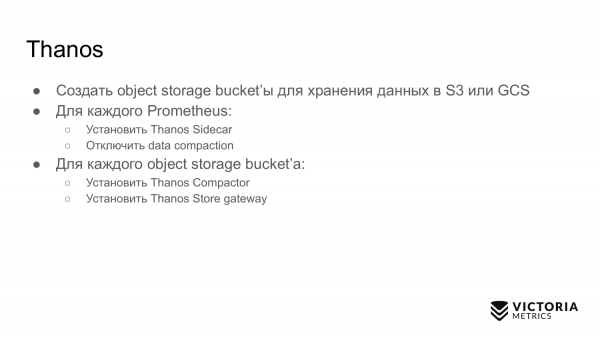
Potom, čo ste nainštalovali Thanos Sidecar, musíte pre každý Object Storage Bucket nainštalovať dve komponenty. Tými sú Thanos Compactor a Thanos Store Gateway.
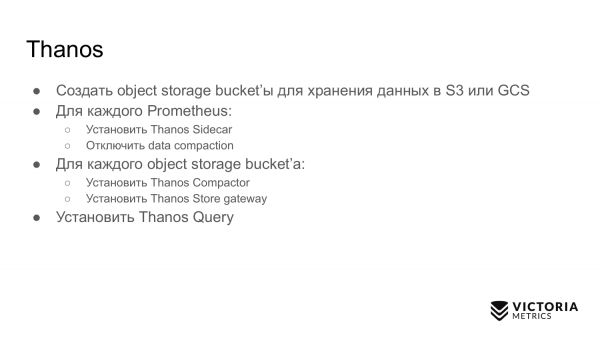
Potom je potrebné nainštalovať Thanos Query a nastaviť ho tak, aby sa mohol pripájať ku všetkým Thanos Store Gateway, ktoré máte, a aby sa mohol pripájať ku všetkým Thanos Sidecar.
Tu môže nastať malý problém.
Musíte nastaviť spoľahlivé a zabezpečené pripojenie Thanos Query k týmto komponentom. A ak máte Prometheusa v rôznych dátových centrách alebo v rôznych VPC, pripojenia zvonku sú zakázané. Ale na fungovanie Thanos Query musíte nejako nastaviť pripojenie tam a musíte prísť na spôsob.
Ak máte veľa takých dátových centier, spoľahlivosť celého systému sa znižuje. Thanos Query musí neustále udržiavať pripojenia ku všetkým Thanos Sidecar, ktoré sú umiestnené v rôznych dátových centrách. Pri každom prichádzajúcom požiadavku bude odosielať požiadavky na všetky Thanos Sidecar. Ak sa pripojenie prerušia, dostanete buď neúplný súbor dát, alebo odpoveď „klaster nefunguje“.
V VictoriaMetrics je to všetko trochu jednoduchšie. Pre verziu s jedným uzlom stačí spustiť jeden binárny súbor a všetko funguje.
V klastrové verzii stačí spustiť všetky vyššie uvedené tri typy komponentov v akomkoľvek požadovanom počte alebo použiť pre automatizáciu spúšťania komponentov v Kubernetes. Ešte plánujeme vytvoriť operátor Kubernetes. Helm chart nezahŕňa niektoré prípady a umožňuje vám vystreliť si do nohy. Napríklad môže znížiť počet storage node, čo povedie k strate dát.
Akonáhle spustíte jeden binárny súbor alebo klastrovú verziu, stačí pridať do konfigurácie Prometheus , aby začal zapisovať údaje súčasne do lokálneho úložiska a do vzdialeného úložiska. Ako ste si všimli, táto konfigurácia by mala fungovať oveľa spoľahlivejšie v porovnaní s konfiguráciou Thanos. Nemusíme udržiavať pripojenie medzi VictoriaMetrics a všetkými Prometheusa, pretože Prometheus sa pripojujú k VictoriaMetrics a prenášajú údaje.
Zvážme údržbu Thanos a VictoriaMetrics.
Thanos musí sledovať Sidecar, aby neprestal načítavať dáta do Object Storage. Môže sa stať, že táto synchronizácia sa preruší v dôsledku chýb pri nahrávaní, napríklad ak sa vám dočasne preruší sieťové pripojenie k Object Storage, alebo ak Object Storage dočasne nie je dostupný. Thanos Sidecar si toho v tú chvíľu všimne, nahlási chybu, môže zlyhať a potom prestane fungovať. Ak ho nebudete monitorovať, prestanú vám prenášať dáta do Object Storage. Ak uplynie doba udržania (odporučené 6-8 hodín), stratíte dáta, ktoré sa nedostali do Object Storage.
Thanos compactor-y môžu prestať fungovať z dôvodu . Compactory berú dáta z Object Storage a zlúčia ich do väčších blokov dát. Keďže compactory nie sú synchronizované so Sidecar-mi, môže sa stať, že: Sidecar ešte dokončil písanie bloku, Compactor sa rozhodne, že tento blok je plne zapísaný. Compactor začne blok čítať. Číta blok, ktorý nie je v úplnom znení, a prestáva fungovať. Viac informácií nájdete .
Store Gateway môže poskytovať nekonzistentné dáta z dôvodu pretekov medzi Compactorom a Sidecar-mi. Situácia je rovnaká, pretože Store Gateway nie je nijako synchronizovaný s compactory a Sidecar-mi. V súlade s tým môžu vzniknúť preteky, kedy Store Gateway nevidí časť dát, alebo vidí nadbytočné dáta.
Komponent Query v Thanos neštandardne vracia čiastočný výsledok, ak niektoré Sidecar-y alebo Store Gateway nie sú v danom momente dostupné. Získate časť dát, a ani nebudete vedieť, že ste nezískali všetky dáta. Takto to funguje štandardne. V podobnej situácii VictoriaMetrics vráti označené dáta ako čiastočné.
Na rozdiel od Thanos, VictoriaMetrics zriedka stráca dáta. Aj keď sa preruší pripojenie z Prometheus na VictoriaMetrics, nie je problém, pretože Prometheus pokračuje v zapisovaní nových prichádzajúcich dát do Write Ahead Log, ktorého veľkosť je 2 hodiny. Ak sa v priebehu dvoch hodín pripojíte späť k VictoriaMetrics, dáta sa nestratia. Prometheus .
Na rozdiel od Thanos, ktorý zapisuje dáta do object storage až po dvoch hodinách, Prometheus automaticky replikovuje dáta prostredníctvom remote write protokolu do remote storage, ako je VictoriaMetrics. Nemusíte sa báť straty local storage v Prometheus. Ak náhodou stratí local storage, v najhoršom prípade stratíte posledné sekundy dát, ktoré sa nestihli zapísať do remote storage.
Kubernetes automaticky spravuje klaster na rozdiel od Thanos. Všetky komponenty Thanos sa ťažko zmestia do jedného Kubernetes klastra, na rozdiel od klastra komponentov VictoriaMetrics.
U VictoriaMetrics je veľmi jednoduché aktualizovať na novú verziu. Stačí zastaviť VictoriaMetrics, aktualizovať binárne súbory a znovu spustiť. Pri zastavení cez signál SIGINT všetky binárne súbory VictoriaMetrics robia graceful shutdown. Správne ukladajú potrebné dáta, správne zatvárajú prichádzajúce spojenia, aby sa nič nestratilo. Preto pri aktualizácii nič nestratíte.
U VictoriaMetrics je veľmi jednoduché rozšíriť klaster. Stačí pridať potrebné komponenty a pokračovať v práci.
O skrytých problémoch v Thanos a VictoriaMetrics.
Thanos má nasledujúce skryté problémy. Prometheus musí uchovávať dáta za posledné dve hodiny. Ak sa stratia, úplne o ne prídete, pretože sa ešte nestihli zapísať do Object Storage, ako je S3.
Store Gateway komponent a compactor komponent môžu vyžadovať veľa pamäte na prácu s veľkým Object Storage, ak tam uchovávate veľa drobných súborov. Čím väčší počet a objem súborov, tým viac operačnej pamäte Store Gateway a compactor potrebuje na uchovávanie meta-informácií. Thanos má veľa problémov s tým, že .
Thanos je reklamovaný ako schopný nekonečne škálovať počet vašich Prometheus. V skutočnosti to nie je pravda. Pretože všetky dopyty prechádzajú cez Query komponent, ktorý musí paralelne opýtať všetky Store Gateway komponenty a všetky Sidecar komponenty, vyťahovať odtiaľ dáta a potom ich pre-processovať. Je zrejmé, že rýchlosť dopytov je obmedzená najpomalším slabým článkom, najpomalšou Store Gateway alebo najpomalším Sidecar.
Tieto komponenty môžu byť pracovne zaťažené nerovnomerne. Napríklad máte Prometheus, ktorý zbiera milióny metrik za sekundu, a je tu aj Prometheus, ktorý zbiera tisíce metrik za sekundu. Prometheus, ktorý zbiera milióny metrik, výrazne zaťažuje server, na ktorom beží. Preto tam Sidecar pracuje pomalšie. A vlastne všetko tam funguje pomalšie. Komponent Query bude veľmi pomaly ťahať dáta odtiaľ. Tým pádom bude výkonnosť celého vášho klastrového systému obmedzená týmto pomalým Sidecarom.
Predvolene Thanos poskytuje čiastočné dáta, ak sú niektoré Sidecar-y alebo Store Gateway nedostupné. Napríklad, ak sú vaše Sidecar-y roztrúsené po celom svete v rôznych dátových centrách, pravdepodobnosť prerušenia spojenia a nedostupnosti komponentov sa výrazne zvyšuje. Preto v mnohých prípadoch obdržíte čiastočné dáta, ani nevediac o tom.
VictoriaMetrics má tiež svoje úskalia. Prvé úskalie je možnosť, ktorá obmedzuje objem operačnej pamäte využívanej na cache VictoriaMetrics. Predvolene je nastavená na 60% operačnej pamäte na stroji, na ktorom je VictoriaMetrics spustená, alebo 60% RAM podu VictoriaMetrics v Kubernetes.
Ak nesprávne zmeníte túto hodnotu, môžete ohroziť výkonnosť VictoriaMetrics. Napríklad, ak nastavíte príliš nízku hodnotu, dáta sa nemusia zmestiť do cache VictoriaMetrics. Kvôli tomu bude musieť vykonávať zbytočnú prácu a zaťažovať procesor s diskom. Ak túto voľbu nastavíte príliš vysoko, zvyšuje sa, po prvé, pravdepodobnosť, že VictoriaMetrics spadne s chybou 'out of memory', a po druhé, to povedie k tomu, že v operačnom systéme zostane veľmi málo operačnej pamäte na súborový cache. A VictoriaMetrics sa spolieha na súborový cache pre svoju výkonnosť. Ak je ho nedostatok, môže sa výrazne zvýšiť záťaž na disk. Preto odporúčanie: nemeniť parameter bez naliehavej potreby.
Druhá možnosť. Je to retentionPeriod — obdobie, ktoré je predvolene nastavené na 1 mesiac. Je to čas, počas ktorého VictoriaMetrics uchováva dáta. Po uplynutí tejto doby VictoriaMetrics dáta odstráni.
Mnohí spúšťajú VictoriaMetrics bez tohto parametra a zapisujú dáta počas mesiaca. A potom sa pýtajú: prečo dáta zmizli za predchádzajúci mesiac? Pretože retentionPeriod je predvolene nastavený na 1 mesiac. Preto je dôležité poznať a nastaviť správny retentionPeriod.
Prejdeme si unikátne možnosti.
Thanos má vlastnosť, ako je downsampling: 5-minútové a hodinové intervaly, ktoré často . Ak si to vyhľadáte a pozriete sa na ich problémy na github, nájdete tam veľa problémov súvisiacich s týmto downsamplingom, že niekedy nefunguje správne alebo funguje inak, než očakávajú používatelia.
Thanos má deduplikáciu dát pre Prometheus HA páry. Keď dva Prometheus zbierajú rovnaké metriky z rovnakých cieľov a Thanos ich ukladá do Object Storage. Thanos dokáže správne deduplikovať tieto dáta, na rozdiel od VictoriaMetrics.
Thanos má alert komponent, ktorý bol na schéme Thanos. Ale jeho .
Thanos má výhodu v tom, že kód Thanos a Prometheus je spoločný. Thanos a Prometheus boli vyvinuté tými istými vývojármi. Pri vylepšeniach v Thanos alebo Prometheus vyhráva druhá strana.
Hlavná vlastnosť VictoriaMetrics je — MetricsQL. Toto je rozšírenie VictoriaMetrics pre PromQL, o ktorom som hovoril na minulom veľkom monitoring meetupe.
VictoriaMetrics podporuje nahrávanie dát prostredníctvom rôznych protokolov. VictoriaMetrics môže nielen prijímať dáta od Prometheus, ale aj prostredníctvom protokolov Influx, OpenTSDB a Graphite.
Dáta VictoriaMetrics zaberajú zvyčajne oveľa menej miesta v porovnaní s Thanos a Prometheus.
Ak je nahrávať skutočné dáta, používatelia hovoria o 2-5 násobnom znížení veľkosti dát na disku v porovnaní s Prometheus a Thanos.
Ďalšou výhodou VictoriaMetrics je, že je optimalizovaná na rýchlosť.
Prejdeme si náklady na infraštruktúru.
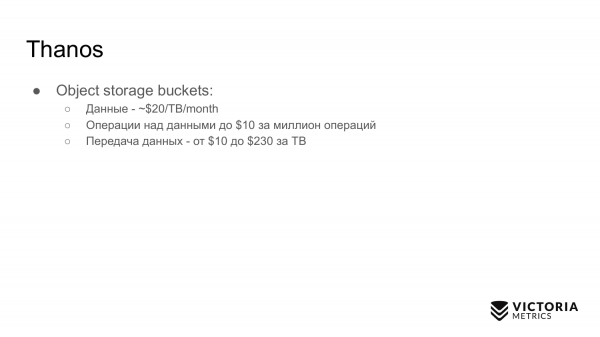
Jednou z výhod Thanos je, že uchováva dáta v object storage, ktorý je relatívne lacný.
Pri uchovávaní dát v object storage musíte platiť za operácie zápisu a čítania dát (10 dolárov za milión operácií). Keď zapisujete dáta do object storage, platíte náklady za hosting na upload dát na internet, ak váš klaster nie je v AWS — tam je to zadarmo. Pri čítaní dát platíte od 10 do 230 dolárov za 1 TB. To môže byť podstatné, ak často požadujete historické dáta z Thanos klasteru.
Pre Thanos klaster je potrebné financovať servery pre komponenty Compact, Store Gateway a Query, ktoré vyžadujú veľa pamäte a CPU pre spracovanie veľkých objemov dát.
Náklady na VictoriaMetrics sú takéto. Ak uchovávate dáta na diskoch GCE HDD, vyjde to na 40 dolárov za 1TB. Pre VictoriaMetrics stačia bežné HDD disky, nie sú potrebné žiadne SSD, ktoré stoja päťkrát viac. VictoriaMetrics je optimalizovaná pre HDD.
Pre VictoriaMetrics sú potrebné servery pre komponenty: buď single-node alebo pre klustrové komponenty, ktoré na rozdiel od Thanos komponentov vyžadujú oveľa menej CPU a RAM – teda budú lacnejšie.
Príklady nasadenia.
Príklad nasadenia Thanos je Gitlab. Gitlab kompletné funguje na Thanos. Ale nie je to tam všetko bez problémov. Ak sa pozriete na ich , môžete vidieť, že stále sa im vyskytujú nejaké : chýba im pamäť pre Store Gateway alebo Query komponenty. Neustále musia zvyšovať objem pamäte.
Kvôli tomu sa zvyšujú náklady na riešenie týchto problémov.
Druhé nasadenie, ktoré môže byť úspešnejšie - to je spoločnosť Improbable, ktorá začala vývoj Thanos. Uverejnili zdrojový kód Thanos. Improbable je spoločnosť, ktorá sa zaoberá vývojom herných enginov.
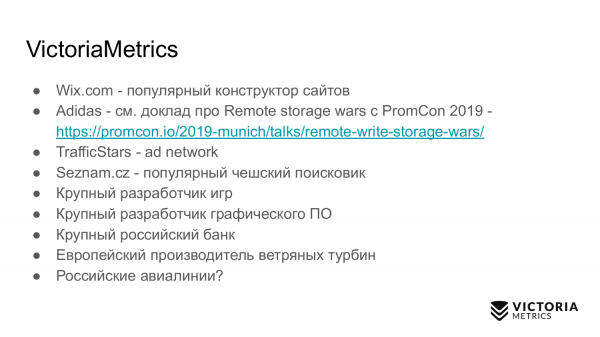
Priame príklady nasadenia VictoriaMetrics sú:
- wix.com - nástroj na tvorbu webových stránok
- Adidas nasadzuje VictoriaMetrics a dokonca predložil správu na poslednom PromCon 2019
- TrafficStars - reklamná sieť
- Seznam.cz - populárny český vyhľadávač.
A potom tu sú no-name spoločnosti, ktoré momentálne nemôžem pomenovať. Nedali súhlas.
- Jeden veľký vývojár hier. Väčší ako Improbable.
- Veľký vývojár grafického softvéru.
- Veľká ruská banka.
- Európsky výrobca veterných turbín, ktorý úspešne otestoval VictoriaMetrics. Tento výrobca nasadzuje VictoriaMetrics na monitorovanie dát získaných z veterných turbín pri rýchlosti 50 vzoriek za sekundu na každý senzor. V každej veterné turbíne je niekoľko stoviek senzorov. Majú niekoľko stoviek veterných turbín.
- Ruské aerolínie, ktoré chcú nasadiť VictoriaMetrics, ale stále nemôžu. S nimi sme vo fáze zmluvy.
 Záver.
VictoriaMetrics a Thanos riešia podobné úlohy, ale rôznymi spôsobmi:
- Globálny pohľad na dopyt
- horizontálne škálovanie
- ľubovoľné uchovávanie dát
Ďakujem.
Čakáme na vás na našom .
Len registrovaní používatelia sa môžu zúčastniť prieskumu. , prosím.
Čo používate ako dlhodobé úložisko pre Prometheus?
35,3%Thanos6
0,0%Cortex0
0,0%M3DB0
41,2%VictoriaMetrics7
23,5%iná4
Hlasovalo 17 používateľov. Zdržalo sa 16 používateľov.
Zdroj: habr.com
