

Drahí čitatelia, prajem vám pekný deň. Dnes si povieme niečo o Apache Spark a jeho perspektívach rozvoja.
V súčasnom svete Big Data je Apache Spark de facto štandardom pri vývoji úloh dávkového spracovania dát. Okrem toho sa tiež používa na vytváranie streamovacích aplikácií, ktoré fungujú na koncepcii micro batch, spracovávajúc a dodávajúc dáta v malých dávkach (Spark Structured Streaming). A tradične bol súčasťou celkového zásobníka Hadoop, pričom ako manažér zdrojov využíval YARN (alebo v niektorých prípadoch Apache Mesos). K roku 2020 sa jeho použitie v tradičnej podobe pre väčšinu spoločností stáva veľmi otáznym kvôli nedostatku solídnych distribúcií Hadoop – rozvoj HDP a CDH sa zastavil, CDH je nedostatočne vyvinutý a má vysoké náklady, zatiaľ čo ostatní dodávatelia Hadoop buď prestali existovať, alebo majú nejasnú budúcnosť. Preto čoraz väčší záujem v komunite a medzi veľkými spoločnosťami spôsobuje spustenie Apache Spark pomocou Kubernetes - ktoré sa stalo štandardom v orchestrácii kontajnerov a správe zdrojov v súkromných aj verejných cloudoch, pretože rieši problém s nekomfortným plánovaním zdrojov úloh Spark na YARN a poskytuje stabilne sa rozvíjajúcu platformu s množstvom komerčných a otvorených distribúcií pre spoločnosti všetkých veľkostí a odborov. Navyše, na vlne popularity si väčšina spoločností už stihla zaobstarať niekoľko svojich inštalácií a nazhromaždiť odborné znalosti v jeho používaní, čo zjednodušuje migráciu.
Od verzie 2.3.0 získal Apache Spark oficiálnu podporu pre spúšťanie úloh v klastri Kubernetes a dnes sa budeme rozprávať o aktuálnej zrelosti tohto prístupu, rôznych možnostiach jeho použitia a úskaliach, s ktorými sa budete musieť stretnúť pri implementácii.
Najprv si priblížime proces vývoja úloh a aplikácií založených na Apache Spark a vyzdvihneme typické prípady, kedy je potrebné spustiť úlohu v klastri Kubernetes. Pri príprave tohto príspevku sa ako distribúcia používa OpenShift a budú uvedené príkazy, ktoré sú aktuálne pre jeho príkazový riadok (oc). Pre iné distribúcie Kubernetes môžu byť použité príslušné príkazy štandardného príkazového riadku Kubernetes (kubectl) alebo ich alternatívy (napríklad pre oc adm policy).
Prvá možnosť použitia — spark-submit
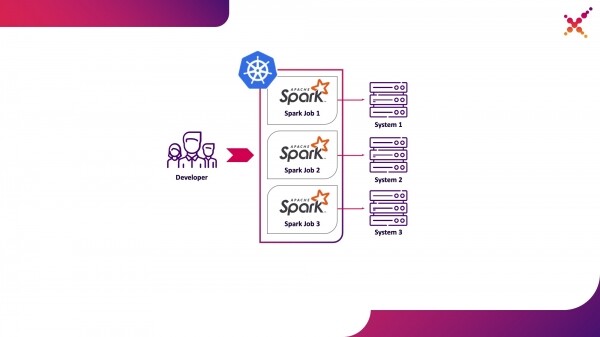
V procese vývoja úloh a aplikácií je potrebné, aby vývojár spúšťal úlohy na ladenie transformácie dát. Teoreticky by sa na tento účel mohli používať záplaty, ale vývoj s účasťou reálnych (aj keď testovacích) inštancií konečných systémov sa ukázal v tejto triede úloh ako rýchlejší a kvalitnejší. V prípade, že ladíme na reálnych inštanciách konečných systémov, sú možné dva scénáre práce:
- vývojár spúšťa úlohu Spark lokálne v režime standalone;

- vývojár spúšťa úlohu Spark na klasteri Kubernetes v testovom prostredí.
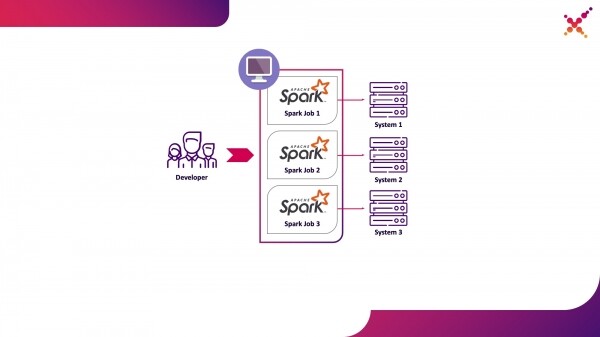
Prvá možnosť má právo na existenciu, ale má niekoľko nevýhod:
- pre každého vývojára je potrebné zabezpečiť prístup z pracovného miesta k všetkým potrebným inštanciám konečných systémov;
- na pracovnej stanici je potrebné mať dostatočné množstvo zdrojov na spustenie vyvíjanej úlohy.
Druhá možnosť je zbavená týchto nedostatkov, pretože používanie klastera Kubernetes umožňuje pridelovať potrebný súbor zdrojov na spustenie úloh a zabezpečiť preň potrebný prístup k inštanciám konečných systémov, flexibilne poskytujúc prístup pomocou modelu rolí Kubernetes pre všetkých členov vývojového tímu. Vyčleňujeme ju ako prvú možnosť použitia — spustenie úloh Spark z lokálneho počítača vývojára na klasteri Kubernetes v testovom prostredí.
Podrobnejšie si povieme o procese nastavenia Spark pre lokálne spustenie. Aby ste mohli začať používať Spark, je potrebné ho nainštalovať:
mkdir /opt/spark
cd /opt/spark
wget http://mirror.linux-ia64.org/apache/spark/spark-2.4.5/spark-2.4.5.tgz
tar zxvf spark-2.4.5.tgz
rm -f spark-2.4.5.tgz
Zbierame potrebné balíky na prácu s Kubernetes:
cd spark-2.4.5/
./build/mvn -Pkubernetes -DskipTests clean package
Úplná kompilácia trvá dlhšie, a na vytvorenie obrazov Docker a ich spustenie na klasteri Kubernetes v skutočnosti potrebujeme iba jar súbory z adresára „assembly/“, takže môžeme skompilovať iba tento subprojekt:
./build/mvn -f ./assembly/pom.xml -Pkubernetes -DskipTests clean package
Na spustenie úloh Spark v Kubernetes je potrebné vytvoriť obraz Docker, ktorý bude použitý ako základný. Tu sú možné 2 prístupy:
- Vytvorený obraz Docker obsahuje vykonateľný kód úlohy Spark;
- Vytvorený obraz zahŕňa iba Spark a potrebné závislosti, vykonávací kód sa umiestňuje na diaľku (napríklad v HDFS).
Najprv vytvoríme Docker obraz, ktorý obsahuje testovací príklad úlohy Spark. Na vytváranie Docker obrazov má Spark príslušný nástroj s názvom „docker-image-tool“. Pozrime sa na jeho nápovedu:
./bin/docker-image-tool.sh --help
S jeho pomocou môžeme vytvárať Docker obrazy a vykonávať ich nahrávanie do vzdialených registratúrov, ale štandardne má niekoľko nevýhod:
- povinne vytvára ihneď 3 Docker obrazy — pre Spark, PySpark a R;
- neumožňuje nastaviť meno obrazu.
Preto budeme používať modifikovanú verziu tohto nástroja, uvedenú nižšie:
vi bin/docker-image-tool-upd.sh
#!/usr/bin/env bash

function error {
  echo "$@" 1>&2
  exit 1
}

if [ -z "${SPARK_HOME}" ]; then
  SPARK_HOME="$(cd "`dirname "$0"`"/..; pwd)"
fi
. "${SPARK_HOME}/bin/load-spark-env.sh"

function image_ref {
  local image="$1"
  local add_repo="${2:-1}"
  if [ $add_repo = 1 ] && [ -n "$REPO" ]; then
    image="$REPO/$image"
  fi
  if [ -n "$TAG" ]; then
    image="$image:$TAG"
  fi
  echo "$image"
}

function build {
  local BUILD_ARGS
  local IMG_PATH

  if [ ! -f "$SPARK_HOME/RELEASE" ]; then
    IMG_PATH=$BASEDOCKERFILE
    BUILD_ARGS=(
      ${BUILD_PARAMS}
      --build-arg
      img_path=$IMG_PATH
      --build-arg
      datagram_jars=datagram/runtimelibs
      --build-arg
      spark_jars=assembly/target/scala-$SPARK_SCALA_VERSION/jars
    )
  else
    IMG_PATH="kubernetes/dockerfiles"
    BUILD_ARGS=(${BUILD_PARAMS})
  fi

  if [ -z "$IMG_PATH" ]; then
    error "Cannot find docker image. This script must be run from a runnable distribution of Apache Spark."
  fi

  if [ -z "$IMAGE_REF" ]; then
    error "Cannot find docker image reference. Please add -i arg."
  fi

  local BINDING_BUILD_ARGS=(
    ${BUILD_PARAMS}
    --build-arg
    base_img=$(image_ref $IMAGE_REF)
  )
  local BASEDOCKERFILE=${BASEDOCKERFILE:-"$IMG_PATH/spark/docker/Dockerfile"}

  docker build $NOCACHEARG "${BUILD_ARGS[@]}"
    -t $(image_ref $IMAGE_REF)
    -f "$BASEDOCKERFILE" .
}

function push {
  docker push "$(image_ref $IMAGE_REF)"
}

function usage {
  cat <<EOF
Usage: $0 [options] [command]
Builds or pushes the built-in Spark Docker image.

Commands:
  build       Build image. Requires a repository address to be provided if the image will be
              pushed to a different registry.
  push        Push a pre-built image to a registry. Requires a repository address to be provided.

Options:
  -f file               Dockerfile to build for JVM based Jobs. By default builds the Dockerfile shipped with Spark.
  -p file               Dockerfile to build for PySpark Jobs. Builds Python dependencies and ships with Spark.
  -R file               Dockerfile to build for SparkR Jobs. Builds R dependencies and ships with Spark.
  -r repo               Repository address.
  -i name               Image name to apply to the built image, or to identify the image to be pushed.
  -t tag                Tag to apply to the built image, or to identify the image to be pushed.
  -m                    Use minikube's Docker daemon.
  -n                    Build docker image with --no-cache
  -b arg      Build arg to build or push the image. For multiple build args, this option needs to
              be used separately for each build arg.

Using minikube when building images will do so directly into minikube's Docker daemon.
There is no need to push the images into minikube in that case, they'll be automatically
available when running applications inside the minikube cluster.

Check the following documentation for more information on using the minikube Docker daemon:

  https://kubernetes.io/docs/getting-started-guides/minikube/#reusing-the-docker-daemon

Examples:
  - Build image in minikube with tag "testing"
    $0 -m -t testing build

  - Build and push image with tag "v2.3.0" to docker.io/myrepo
    $0 -r docker.io/myrepo -t v2.3.0 build
    $0 -r docker.io/myrepo -t v2.3.0 push
EOF
}

if [[ "$@" = *--help ]] || [[ "$@" = *-h ]]; then
  usage
  exit 0
fi

REPO=
TAG=
BASEDOCKERFILE=
NOCACHEARG=
BUILD_PARAMS=
IMAGE_REF=
while getopts f:mr:t:nb:i: option
do
 case "${option}"
 in
 f) BASEDOCKERFILE=${OPTARG};;
 r) REPO=${OPTARG};;
 t) TAG=${OPTARG};;
 n) NOCACHEARG="--no-cache";;
 i) IMAGE_REF=${OPTARG};;
 b) BUILD_PARAMS=${BUILD_PARAMS}" --build-arg "${OPTARG};;
 esac
done

case "${@: -1}" in
  build)
    build
    ;;
  push)
    if [ -z "$REPO" ]; then
      usage
      exit 1
    fi
    push
    ;;
  *)
    usage
    exit 1
    ;;
esac
S jej pomocou vytvárame základný obraz Spark, ktorý obsahuje testovú úlohu na výpočet čísla Pi pomocou Spark (tu {docker-registry-url} — URL vášho registrátora Docker obrazov, {repo} — názov repozitára v registri, ktorý zodpovedá projektu v OpenShift, {image-name} — názov obrazu (ak sa používa trojvrstvové delenie obrazov, napríklad ako v integrovanom registri obrazov Red Hat OpenShift), {tag} — tag tejto verzie obrazu):
./bin/docker-image-tool-upd.sh -f resource-managers/kubernetes/docker/src/main/dockerfiles/spark/Dockerfile -r {docker-registry-url}/{repo} -i {image-name} -t {tag} build
Prihlásime sa do klastera OKD pomocou konzolového nástroja (tu {OKD-API-URL} — URL API klastera OKD):
oc login {OKD-API-URL}
Získame token aktuálneho používateľa na autorizáciu v Docker Registry:
oc whoami -t
Prihlásime sa do vnútorného Docker Registry klastera OKD (ako heslo použijeme token získaný pomocou predchádzajúcej príkazu):
docker login {docker-registry-url}
Nahrajeme vytvorený obraz Docker do Docker Registry OKD:
./bin/docker-image-tool-upd.sh -r {docker-registry-url}/{repo} -i {image-name} -t {tag} push
Skontrolujeme, či je vytvorený obraz dostupný v OKD. Na to otvoríme v prehliadači URL so zoznamom obrazov príslušného projektu (tu {project} — názov projektu v klastri OpenShift, {OKD-WEBUI-URL} — URL webovej konzoly OpenShift) — https://{OKD-WEBUI-URL}/console/project/{project}/browse/images/{image-name}.
Na spustenie úloh musí byť vytvorený servisný účet s právomocami na spúšťanie podov pod rootom (tento moment neskôr prediskutujeme):
oc create sa spark -n {project}
oc adm policy add-scc-to-user anyuid -z spark -n {project}
Vykonáme príkaz spark-submit na publikáciu úlohy Spark v klasteri OKD, pričom uvedieme vytvorený servisný účet a obraz Docker:
/opt/spark/bin/spark-submit --name spark-test --class org.apache.spark.examples.SparkPi --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} local:///opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar
Tu:
—name — názov úlohy, ktorý sa zúčastní na tvorbe názvov podov Kubernetes;
—class — trieda vykonávacieho súboru používaná pri spustení úlohy;
—conf — konfiguračné parametre Spark;
spark.executor.instances — počet spúšťaných executorov Spark;
spark.kubernetes.authenticate.driver.serviceAccountName — názov služobného účtu Kubernetes používaného pri spustení podov (na určenie kontextu zabezpečenia a oprávnení pri interakcii s API Kubernetes);
spark.kubernetes.namespace — názov priestoru Kubernetes, v ktorom sa spustia podi ovládača a executorov;
spark.submit.deployMode — spôsob spustenia Spark (pre štandardný spark-submit sa používa „cluster“, pre Spark Operator a novšie verzie Spark „client“);
spark.kubernetes.container.image — Docker obraz používaný na spustenie podov;
spark.master — URL API Kubernetes (uvádza sa externé, aby sa zabezpečil prístup z lokálneho počítača);
local:// — cesta k vykonávaciemu súboru Spark vo vnútri Docker obraz;
Prejdeme do príslušného projektu OKD a preskúmame vytvorené podí — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods.
Na zjednodušenie procesu vývoja môže byť použitá ďalšia možnosť, pri ktorej sa vytvorí spoločný základný obraz Spark, ktorý používajú všetky úlohy na spustenie, a snímky vykonávacích súborov sa publikujú vo vonkajšom úložisku (napríklad Hadoop) a uvádzajú sa pri volaní spark-submit ako odkaz. V tomto prípade je možné spúšťať rôzne verzie úloh Spark bez opätovného zostavovania Docker obrazov, pričom sa na publikovanie obrazov použije napríklad WebHDFS. Odošleme žiadosť o vytvorenie súboru (tu {host} — hostiteľ služby WebHDFS, {port} — port služby WebHDFS, {path-to-file-on-hdfs} — požadovaná cesta k súboru na HDFS):
curl -i -X PUT "http://{host}:{port}/webhdfs/v1/{path-to-file-on-hdfs}?op=CREATE
Pri tom dostaneme odpoveď typu (tu {location} — to je URL, ktoré je potrebné použiť na nahratie súboru):
HTTP/1.1 307 TEMPORARY_REDIRECT
Location: {location}
Content-Length: 0
Nahrávame vykonávací súbor Spark do HDFS (tu {path-to-local-file} — cesta k vykonávaciemu súboru Spark na aktuálnom hoste):
curl -i -X PUT -T {path-to-local-file} "{location}"
Po tomto môžeme vykonať spark-submit s použitím súboru Spark nahraného na HDFS (tu {class-name} — názov triedy, ktorú je potrebné spustiť na vykonanie úlohy):
/opt/spark/bin/spark-submit --name spark-test --class {class-name} --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} hdfs://{host}:{port}/{path-to-file-on-hdfs}
Treba poznamenať, že pre prístup k HDFS a zabezpečenie fungovania úlohy môže byť potrebné zmeniť Dockerfile a skript entrypoint.sh — pridať do Dockerfile príkaz na skopírovanie závislých knižníc do adresára /opt/spark/jars a zahrnúť konfiguračný súbor HDFS do SPARK_CLASSPATH v entrypoint.sh.
Druhý variant využitia — Apache Livy
Následne, keď je úloha vyvinutá a je potrebné otestovať získaný výsledok, vzniká otázka jej spustenia v rámci procesu CI/CD a sledovania stavov jej vykonávania. Samozrejme, je možné ju spustiť aj pomocou lokálneho volania spark-submit, ale to komplikuje infraštruktúru CI/CD, pretože vyžaduje inštaláciu a konfiguráciu Spark na agentoch/runneroch CI servera a nastavenie prístupu k API Kubernetes. Pre tento prípad bola zvolená cielená realizácia využitia Apache Livy ako REST API na spúšťanie úloh Spark, umiestneného v klastre Kubernetes. S jeho pomocou je možné spúšťať úlohy Spark na klastre Kubernetes pomocou bežných cURL požiadaviek, čo je ľahko realizovateľné na základe akéhokoľvek CI riešenia, a jeho umiestnenie v klastre Kubernetes rieši otázku autentifikácie pri interakcii s API Kubernetes.
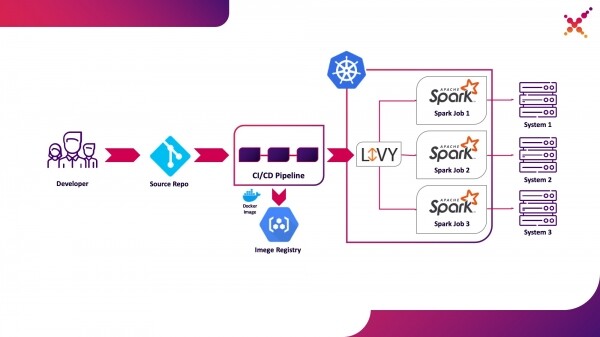
Vyčleníme ho ako druhý variant využitia — spúšťanie úloh Spark v rámci procesu CI/CD na klastre Kubernetes v testovacom obvode.
Trochu o Apache Livy — funguje ako HTTP server, poskytujúci webové rozhranie a RESTful API, ktoré umožňuje vzdialene spustiť spark-submit, pričom predá potrebné parametre. Tradične bol dodávaný súčasťou distribúcie HDP, ale môže byť tiež nasadený v OKD alebo akomkoľvek inom nasadení Kubernetes pomocou príslušného manifestu a súboru Docker obrazov, napríklad tohoto — . Pre náš prípad bol zostavený podobný Docker obraz, ktorý zahŕňa Spark verzie 2.4.5 z nasledujúceho Dockerfile:
FROM java:8-alpine

ENV SPARK_HOME=/opt/spark
ENV LIVY_HOME=/opt/livy
ENV HADOOP_CONF_DIR=/etc/hadoop/conf
ENV SPARK_USER=spark

WORKDIR /opt

RUN apk add --update openssl wget bash &&
    wget -P /opt https://downloads.apache.org/spark/spark-2.4.5/spark-2.4.5-bin-hadoop2.7.tgz &&
    tar xvzf spark-2.4.5-bin-hadoop2.7.tgz &&
    rm spark-2.4.5-bin-hadoop2.7.tgz &&
    ln -s /opt/spark-2.4.5-bin-hadoop2.7 /opt/spark

RUN wget http://mirror.its.dal.ca/apache/incubator/livy/0.7.0-incubating/apache-livy-0.7.0-incubating-bin.zip &&
    unzip apache-livy-0.7.0-incubating-bin.zip &&
    rm apache-livy-0.7.0-incubating-bin.zip &&
    ln -s /opt/apache-livy-0.7.0-incubating-bin /opt/livy &&
    mkdir /var/log/livy &&
    ln -s /var/log/livy /opt/livy/logs &&
    cp /opt/livy/conf/log4j.properties.template /opt/livy/conf/log4j.properties

ADD livy.conf /opt/livy/conf
ADD spark-defaults.conf /opt/spark/conf/spark-defaults.conf
ADD entrypoint.sh /entrypoint.sh

ENV PATH="/opt/livy/bin:${PATH}"

EXPOSE 8998

ENTRYPOINT ["/entrypoint.sh"]
CMD ["livy-server"]
Vytvorený obraz môže byť zostavený a nahraný do existujúceho repozitára Docker, napríklad do interného repozitára OKD. Na jeho nasadenie sa používa nasledujúci manifest ({registry-url} — URL repozitára obrazov Docker, {image-name} — názov obrazu Docker, {tag} — tag obrazu Docker, {livy-url} — požadovaná URL, na ktorej bude server Livy dostupný; manifest „Route“ sa aplikuje v prípade, že ako distribúcia Kubernetes sa používa Red Hat OpenShift, inak sa používa zodpovedajúci manifest Ingress alebo Service typu NodePort):
---
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    component: livy
  name: livy
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      component: livy
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        component: livy
    spec:
      containers:
        - command:
            - livy-server
          env:
            - name: K8S_API_HOST
              value: localhost
            - name: SPARK_KUBERNETES_IMAGE
              value: 'gnut3ll4/spark:v1.0.14'
          image: '{registry-url}/{image-name}:{tag}'
          imagePullPolicy: Always
          name: livy
          ports:
            - containerPort: 8998
              name: livy-rest
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
          volumeMounts:
            - mountPath: /var/log/livy
              name: livy-log
            - mountPath: /opt/.livy-sessions/
              name: livy-sessions
            - mountPath: /opt/livy/conf/livy.conf
              name: livy-config
              subPath: livy.conf
            - mountPath: /opt/spark/conf/spark-defaults.conf
              name: spark-config
              subPath: spark-defaults.conf
        - command:
            - /usr/local/bin/kubectl
            - proxy
            - '--port'
            - '8443'
          image: 'gnut3ll4/kubectl-sidecar:latest'
          imagePullPolicy: Always
          name: kubectl
          ports:
            - containerPort: 8443
              name: k8s-api
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      serviceAccount: spark
      serviceAccountName: spark
      terminationGracePeriodSeconds: 30
      volumes:
        - emptyDir: {}
          name: livy-log
        - emptyDir: {}
          name: livy-sessions
        - configMap:
            defaultMode: 420
            items:
              - key: livy.conf
                path: livy.conf
            name: livy-config
          name: livy-config
        - configMap:
            defaultMode: 420
            items:
              - key: spark-defaults.conf
                path: spark-defaults.conf
            name: livy-config
          name: spark-config
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: livy-config
data:
  livy.conf: |-
    livy.spark.deploy-mode=cluster
    livy.file.local-dir-whitelist=/opt/.livy-sessions/
    livy.spark.master=k8s://http://localhost:8443
    livy.server.session.state-retain.sec = 8h
  spark-defaults.conf: 'spark.kubernetes.container.image        "gnut3ll4/spark:v1.0.14"'
---
apiVersion: v1
kind: Service
metadata:
  labels:
    app: livy
  name: livy
spec:
  ports:
    - name: livy-rest
      port: 8998
      protocol: TCP
      targetPort: 8998
  selector:
    component: livy
  sessionAffinity: None
  type: ClusterIP
---
apiVersion: route.openshift.io/v1
kind: Route
metadata:
  labels:
    app: livy
  name: livy
spec:
  host: {livy-url}
  port:
    targetPort: livy-rest
  to:
    kind: Service
    name: livy
    weight: 100
  wildcardPolicy: None
Po jeho použití a úspešnom spustení podu je grafické rozhranie Livy dostupné na odkaze: http://{livy-url}/ui. S pomocou Livy môžeme publikovať našu úlohu Spark pomocou REST požiadavky, napríklad z Postmanu. Príklad kolekcie s požiadavkami je uvedený nižšie (v poli „args“ môžu byť odovzdané konfiguračné argumenty s premennými potrebnými na vykonanie spustenej úlohy):
{
    "info": {
        "_postman_id": "be135198-d2ff-47b6-a33e-0d27b9dba4c8",
        "name": "Spark Livy",
        "schema": "https://schema.getpostman.com/json/collection/v2.1.0/collection.json"
    },
    "item": [
        {
            "name": "1 Odoslať úlohu s jarom",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"local://opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar\", nt\"className\": \"org.apache.spark.examples.SparkPi\",nt\"numExecutors\":1,nt\"name\": \"spark-test-1\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt}n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        },
        {
            "name": "2 Odoslať úlohu bez jaru",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"hdfs://{host}:{port}/{path-to-file-on-hdfs}\", nt\"className\": \"{class-name}\",nt\"numExecutors\":1,nt\"name\": \"spark-test-2\",nt\"proxyUser\": \"0\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt},nt\"args\": [ntt\"HADOOP_CONF_DIR=/opt/spark/hadoop-conf\",ntt\"MASTER=k8s://https://kubernetes.default.svc:8443\"nt]n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        }
    ],
    "event": [
        {
            "listen": "prerequest",
            "script": {
                "id": "41bea1d0-278c-40c9-ad42-bf2e6268897d",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        },
        {
            "listen": "test",
            "script": {
                "id": "3cdd7736-a885-4a2d-9668-bd75798f4560",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        }
    ],
    "protocolProfileBehavior": {}
}
Vykonajte prvý požiadavok z kolekcie, prejdite do rozhrania OKD a skontrolujte, či bola úloha úspešne spustená — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods. V rozhraní Livy (http://{livy-url}/ui) sa objaví relácia, v rámci ktorej pomocou API Livy alebo grafického rozhrania môžete sledovať priebeh vykonávania úlohy a študovať protokoly relácie.
Teraz ukážeme mechanismus fungování Livy. K tomu se podíváme na logy kontejneru Livy uvnitř podu se serverem Livy — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods/{livy-pod-name}?tab=logs. Z těchto logů je vidět, že při vyvolání REST API Livy se v kontejneru s názvem „livy“ provádí spark-submit, podobně jako jsme již dříve použili (zde {livy-pod-name} je název vytvořeného podu se serverem Livy). V kolekci je také druhý dotaz, který umožňuje spouštět úlohy s dálkovým umístěním spustitelného souboru Spark pomocí serveru Livy.
Třetí možností použití je Spark Operator.
Nyní, když byla úloha otestována, se nabízí otázka jejího pravidelného spouštění. Nativním způsobem pro pravidelné spouštění úloh v clusteru Kubernetes je entita CronJob a lze ji použít, ale v současné době má výraznou popularitu použití operátorů pro správu aplikací v Kubernetes a pro Spark existuje dostatečně vyzrálý operátor, který se přímo využívá v řešeních podnikové úrovně (např. Lightbend FastData Platform). Doporučujeme jeho použití — aktuální stabilní verze Spark (2.4.5) má dost omezené možnosti pro konfiguraci spouštění úloh Spark v Kubernetes, přičemž v následující hlavní verzi (3.0.0) je avizována plná podpora Kubernetes, ale datum jejího vydání zůstává neznámé. Spark Operator tuto nevýhodu kompenzuje přidáním důležitých parametrů konfigurace (např. montáž ConfigMap s konfigurací přístupu k Hadoop v podech Spark) a možností pravidelného spouštění úlohy podle plánu.
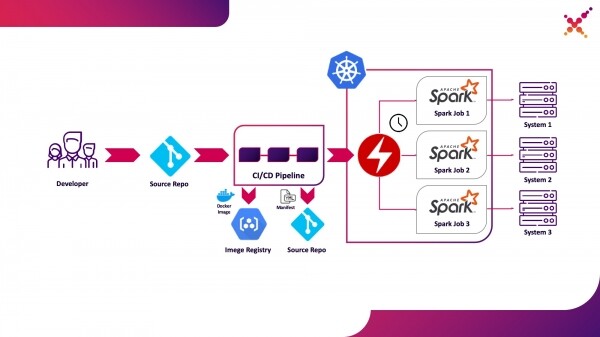
Vyčleňme ho jako třetí možnost použití — pravidelné spouštění úloh Spark v clusteru Kubernetes v produkčním prostředí.
Spark Operator má otevřený zdrojový kód a vyvíjí se v rámci Google Cloud Platform — . Jeho instalace může být provedena třemi způsoby:
- V rámci instalace Lightbend FastData Platform/Cloudflow;
- Pomocí Helm:
helm repo add incubator http://storage.googleapis.com/kubernetes-charts-incubator helm install incubator/sparkoperator --namespace spark-operator - Použitím manifestů z oficiálního repozitáře (https://github.com/GoogleCloudPlatform/spark-on-k8s-operator/tree/master/manifest). Je třeba poznamenat, že Cloudflow zahrnuje operátor s verzí API v1beta1. Pokud se používá tento typ instalace, popisy manifestů aplikací Spark by měly být založeny na příkladech z tagů v Gitu s příslušnou verzí API, například „v1beta1-0.9.0-2.4.0“. Verzi operátora lze zjistit v popisu CRD, která je součástí operátora ve slovníku „versions“:
oc get crd sparkapplications.sparkoperator.k8s.io -o yaml
Pokud je operátor správně nainstalován, v příslušném projektu se objeví aktivní pod s operátorem Spark (například cloudflow-fdp-sparkoperator ve jmenném prostoru Cloudflow pro instalaci Cloudflow) a objeví se odpovídající typ zdrojů Kubernetes s názvem „sparkapplications“. Stávající aplikace Spark lze prozkoumat následujícím příkazem:
oc get sparkapplications -n {project}
Pro spuštění úloh pomocí Spark Operátora je třeba učinit 3 věci:
- vytvořit obraz Docker, který obsahuje všechny potřebné knihovny, jakož i konfigurační a spouštěcí soubory. V cílovém scénáři je to obraz vytvořený během fáze CI/CD a otestovaný na testovacím klastru;
- publikovat obraz Docker do registru, který je dostupný z klastru Kubernetes;
- vytvořit manifest typu „SparkApplication“ a popis spuštěné úlohy. Příklady manifestů jsou k dispozici v oficiálním repozitáři (například, ). Je třeba poznamenat důležité body týkající se manifestu:
- ve slovníku „apiVersion“ musí být uvedena verze API, která odpovídá verzi operátora;
- ve slovníku „metadata.namespace“ musí být uveden jmenný prostor, ve kterém bude aplikace spuštěna;
- ve slovníku „spec.image“ musí být uvedena adresa vytvořeného obrazu Docker v dostupném registru;
- ve slovníku „spec.mainClass“ musí být uvedena třída úlohy Spark, která se má spustit při spuštění procesu;
- ve slovníku „spec.mainApplicationFile“ musí být uvedena cesta k spustitelnému jar souboru;
- ve slovníku „spec.sparkVersion“ musí být uvedena používaná verze Spark;
- ve slovníku „spec.driver.serviceAccount“ musí být uveden servisní účet v příslušném jmenném prostoru Kubernetes, který bude použit k spuštění aplikace;
- ve slovníku „spec.executor“ musí být uvedeno množství zdrojů vyčleněných aplikaci;
- V slovníku „spec.volumeMounts“ musí být specifikována místní složka, ve které budou vytvářeny místní soubory úlohy Spark.
Příklad vytvoření manifestu (zde {spark-service-account} je servisní účet uvnitř Kubernetes clusteru pro spuštění úloh Spark):
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 0.1
    coreLimit: "200m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: {spark-service-account}
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
V tomto manifestu je uveden servisní účet, pro který je nutné před zveřejněním manifestu vytvořit potřebné vazby rolí, které poskytují nezbytná oprávnění pro interakci aplikace Spark s API Kubernetes (pokud je to potřeba). V našem případě potřebuje aplikace práva pro vytváření Podů. Vytvoříme potřebnou vazbu role:
oc adm policy add-role-to-user edit system:serviceaccount:{project}:{spark-service-account} -n {project}
Také stojí za zmínku, že ve specifikaci tohoto manifestu může být uveden parametr „hadoopConfigMap“, který umožňuje specifikovat ConfigMap s konfigurací Hadoop bez potřeby předchozího vložení odpovídajícího souboru do obrazu Docker. Také je vhodný pro pravidelné spouštění úloh — pomocí parametru „schedule“ může být uveden harmonogram spuštění této úlohy.
Poté uložíme náš manifest do souboru spark-pi.yaml a aplikujeme ho na náš Kubernetes cluster:
oc apply -f spark-pi.yaml
Tím se vytvoří objekt typu „sparkapplications“:
oc get sparkapplications -n {project}
> NAME       AGE
> spark-pi   22h
Přitom bude vytvořen pod s aplikací, jehož stav se bude zobrazovat ve vytvořeném „sparkapplications“. Můžeme ho zobrazit následujícím příkazem:
oc get sparkapplications spark-pi -o yaml -n {project}
Po dokončení úlohy POD přejde do stavu „Completed“, který se také aktualizuje v „sparkapplications“. Logy aplikace můžeme zobrazit v prohlížeči nebo pomocí následujícího příkazu (zde {sparkapplications-pod-name} je název podu spuštěné úlohy):
oc logs {sparkapplications-pod-name} -n {project}
Správa úloh Spark sa dá tiež vykonať pomocou špecializovanej utilitky sparkctl. Na jej inštaláciu skloníme repozitár s jej zdrojovým kódom, nainštalujeme Go a zostavíme túto utilitku:
git clone https://github.com/GoogleCloudPlatform/spark-on-k8s-operator.git
cd spark-on-k8s-operator/
wget https://dl.google.com/go/go1.13.3.linux-amd64.tar.gz
tar -xzf go1.13.3.linux-amd64.tar.gz
sudo mv go /usr/local
mkdir $HOME/Projects
export GOROOT=/usr/local/go
export GOPATH=$HOME/Projects
export PATH=$GOPATH/bin:$GOROOT/bin:$PATH
go -version
cd sparkctl
go build -o sparkctl
sudo mv sparkctl /usr/local/bin
Preskúmame zoznam spustených úloh Spark:
sparkctl list -n {project}
Vytvoríme opis pre úlohu Spark:
vi spark-app.yaml
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 1
    coreLimit: "1000m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: spark
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
Spustíme opísanú úlohu pomocou sparkctl:
sparkctl create spark-app.yaml -n {project}
Preskúmame zoznam spustených úloh Spark:
sparkctl list -n {project}
Preskúmame zoznam udalostí spustenej úlohy Spark:
sparkctl event spark-pi -n {project} -f
Preskúmame stav spustenej úlohy Spark:
sparkctl status spark-pi -n {project}
Na záver sa chceme pozrieť na zistené nevýhody prevádzky aktuálnej stabilnej verzie Spark (2.4.5) v Kubernetes:
- Prvý a, pravdepodobne, hlavný nedostatok je absencia lokalizácie dát. Napriek všetkým nedostatkom YARN mali aj svoje výhody, napríklad princíp dodávania kódu k dátam (nie dát kódu). Vďaka nemu sa úlohy Spark vykonávali na uzloch, kde sa nachádzali malé dáta zapojené do výpočtov, čím sa významne znížil čas na prenos dát po sieti. Pri používaní Kubernetes sa stretávame s potrebou prenášať dáta zapojené do úloh cez sieť. V prípade, že sú dostatočne veľké, čas vykonávania úlohy sa môže podstatne predĺžiť a môže byť potrebný tiež značný objem diskového priestoru prideleného inštanciám úlohy Spark na ich dočasné uloženie. Tento nedostatok môže byť zmiernený použitím špecializovaných programových prostriedkov zabezpečujúcich lokalizáciu dát v Kubernetes (napríklad Alluxio), no to prakticky znamená potrebu uchovávania kompletných kópií dát na uzloch Kubernetes klastru.
- Druhý dôležitý nedostatok je bezpečnosť. Predvolene sú funkcie súvisiace s zabezpečením spúšťania úloh Spark vypnuté, využitie Kerberos v oficiálnej dokumentácii nie je pokryté (hoci príslušné parametre sa objavili vo verzii 3.0.0, čo bude vyžadovať ďalšie spracovanie), a v dokumentácii o zabezpečení pri používaní Sparku (https://spark.apache.org/docs/2.4.5/security.html) sú ako úložiská kľúčov uvedené len YARN, Mesos a Standalone Cluster. Pri tom používateľ, pod ktorým sa spúšťajú úlohy Spark, nemôže byť určený priamo — iba definujeme servisný účet, pod ktorým bude služba pracovať, a používateľ sa vyberá na základe nastavených bezpečnostných politík. V dôsledku toho sa buď používa účet root, čo nie je bezpečné v produkčnom prostredí, alebo používateľ s náhodným UID, čo je nepraktické pri prerozdelení práv prístupu k dátam (riešiteľné vytvorením PodSecurityPolicies a ich priradením k príslušným servisným účtom). V súčasnosti sa to rieši buď umiestnením všetkých potrebných súborov priamo do obrazu Docker, alebo modifikáciou spúšťacieho skriptu Sparku na použitie mechanizmu ukladania a získavania tajomstiev, aký je prijatý vo vašej organizácii.
- Spustenie úloh Spark pomocou Kubernetes je oficiálne stále v experimentálnom režime a v budúcnosti sú možné výrazné zmeny v používaných artefaktoch (konfiguračných súboroch, základných Docker imáži a spúšťacích skriptoch). A skutočne — pri príprave materiálu boli testované verzie 2.3.0 a 2.4.5, správanie sa podstatne líšilo.
Budeme čakať na aktualizácie — nedávno bola vydaná nová verzia Spark (3.0.0), ktorá priniesla výrazné zmeny vo fungovaní Spark na Kubernetes, no zachovala experimentálny status podpory tohto správcu zdrojov. Možno, že nasledujúce aktualizácie naozaj umožnia plne odporučiť prechod od YARN a spustiť úlohy Spark na Kubernetes bez obáv o bezpečnosť vášho systému a bez potreby samostatne vyvíjať funkčné komponenty.
Fin.
Zdroj: habr.com
