

Ahoj, Habr.
Volám sa Miša Butrimov a chcel by som vám trochu rozprávať o Cassandre. Môj príbeh bude užitočný pre tých, ktorí sa nikdy nestretli s NoSQL databázami, pretože má mnoho implementačných zvláštností a nástrah, o ktorých treba vedieť. A ak ste okrem Oracle alebo inej relačnej databázy nič iné nevideli, tieto veci vám zachránia život.
Čím je Cassandra dobrá? Je to NoSQL databáza, navrhnutá bez jedinej bodu zlyhania, ktorá sa dobre škáluje. Ak potrebujete pridať niekoľko terabajtov do databázy, jednoducho pridáte uzly do prstenca. Rozšíriť ju na ďalšie dátové centrum? Pridajte uzly do klasteru. Zvýšiť spracovávané RPS? Pridajte uzly do klasteru. V opačnom smere to funguje tiež.
V čom je ešte dobrá? V tom, že dokáže spracovávať množstvo dopytov. Ale koľko je veľa? 10, 20, 30, 40 tisíc dopytov za sekundu — to je málo. 100 tisíc dopytov za sekundu pre zápis — tiež málo. Sú spoločnosti, ktoré tvrdia, že zvládajú 2 milióny dopytov za sekundu. Tým asi budeme musieť veriť.
A v zásade má Cassandra jedno veľké odlišovanie od relačných dát — vôbec sa na ne nepodobá. A je dôležité si to zapamätať.
Nie všetko, čo vyzerá rovnako, funguje rovnako.
Nedávno ku mne prišiel kolega a spýtal sa: „Tu je SQL Cassandra query language, a má select statement, má where, má and. Píšem písmená a nefunguje to. Prečo?“. Ak sa k Cassandre pristupuje ako k relačnej databáze, je to dokonalý spôsob, ako skončiť život brutálnym samovražedným gestom. A nepropagujem to, v Rusku je to zakázané. Jednoducho navrhnete niečo zle.
Napríklad k nám príde zákazník a povie: „Poďme postaviť databázu pre seriály, alebo databázu pre recepty. Budeme mať jedlá s ingredienciami alebo zoznam seriálov a hercov v ňom“. Radostne hovoríme: „Poďme!“. To sú dva bajty na prenesie, pár tabuliek a všetko je hotové, všetko bude fungovať veľmi rýchlo, spoľahlivo. A všetko je skvelé, pokiaľ zákazníci neprídu a nepovedia, že gazdinky chcú vyriešiť aj opačný problém: majú zoznam ingrediencií a chcú vedieť, ktoré jedlo chcú pripraviť. Ste mŕtvi.
Všetko preto, lebo Cassandra je hybridná databáza: je zároveň key value a ukladá dáta v širokých stĺpcoch. Ak hovoríme jazykmi Java alebo Kotlin, mohli by sme to opísať takto:
Map<RowKey, SortedMap>
Teda mapa, v ktorej je ešte aj usporiadaná mapa. Prvým kľúčom do tejto mapy je Row key alebo Partition key — kľúč rozdelenia. Druhý kľúč, ktorý je kľúčom k už usporiadanej mape, je Clustering key.
Na ilustráciu rozdelenosti databázy nakreslíme tri uzly. Teraz je potrebné pochopiť, ako rozložiť dáta na uzly. Lebo ak všetko natlačíme do jedného (môže ich byť napríklad tisíc, dve tisíce, päť — koľko len chceme), to nie je veľmi o rozdelení. Preto potrebujeme matematickú funkciu, ktorá bude vracať číslo. Prosto číslo, dlhý int, ktoré sa bude pohybovať v nejakom rozsahu. A jedna uzol bude zodpovedať za jeden rozsah, druhá — za druhý, n-tá — za n-tý.
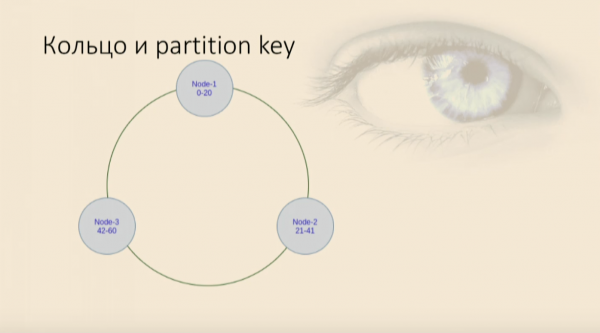
Toto číslo sa získava pomocou hash-funkcie, ktorá sa aplikuje presne na to, čo nazývame Partition key. Je to ten stĺpec, ktorý sa uvádza v direktíve Primary key, a je to ten stĺpec, ktorý bude prvým a najdôležitejším kľúčom mapy. Určuje, na ktorý uzol aké dáta pôjdu. Tabuľka sa vytvára v Cassandre takmer s rovnakou syntaxou ako v SQL:
CREATE TABLE users (
	user_id uu id,
	name text,
	year int,
	salary float,
	PRIMARY KEY(user_id)

)
Primary key v tomto prípade pozostáva z jedného stĺpca, a ten je tiež kľúčom rozdelenia.
Ako budú umiestnení používatelia? Časť skončí na jednom uzle, časť — na druhom a časť — na treťom. Vznikne obyčajná hash tabuľka, ona mapa, v Pythone — slovník, ona jednoduchá Key value štruktúra, z ktorej môžeme čítať všetky hodnoty, čítať a zapisovať podľa kľúča.
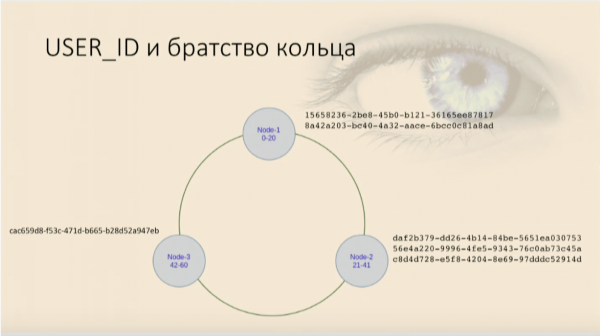
Select: keď allow filtering sa zmení na full scan, alebo ako to nerobiť
Napíšme nejaké select statement: select * from users where userid = . Vyzerá to ako v Oracle: píšeme select, uvádzame podmienky a všetko funguje, používatelia sa načítajú. Ale ak vyberieme napríklad používateľa s určitém rokom narodenia, Cassandra sa ozve, že nedokáže vykonať dopyt. Pretože ona vôbec nevie, ako sú u nás rozložené údaje o roku narodenia — má v úlohe len jeden stĺpec ako kľúč. Potom povie: „Dobre, môžem tento dopyt stále vykonať. Pridajte allow filtering.“ Pridáme direktívu a všetko funguje. A v tomto momente sa deje niečo desivé.
Keď testujeme na testovacích údajoch, je to skvelé. Ale keď vykonáte dopyt v produkcii, kde máme napríklad 4 milióny záznamov, veci nie sú veľmi dobré. Pretože allow filtering — to je direktíva, ktorá umožňuje Cassandre zhromaždiť všetky údaje z tejto tabuľky zo všetkých nód, všetkých dátových centier (ak ich je v tomto clustri veľa) a až potom ich filtrovať. To je analogické plnému skenu a pravdepodobne z toho nikto nie je nadšený.
Keby sme potrebovali používateľov len podľa identifikátorov, stačilo by nám to. Ale niekedy musíme písať iné dopyty a uplatniť iné obmedzenia na výber. Preto si pripomíname: je to všetko o mape, ktorá má partition key, ale v jejnú trombózu — triedenú mapu.
A táto mapa má tiež kľúč, ktorý nazývame Clustering Key. Tento kľúč pozostáva zo stĺpcov, ktoré vyberieme, pomocou ktorého Cassandra chápe, ako budú údaje fyzicky usporiadané a uložené na každej nód. To znamená, že pre nejaký Partition key Clustering key povie, ako presne uložiť údaje do tohto stromu, aký priestor tam zaberú.
Je to naozaj strom, jednoducho sa tam zavolá comparator, do ktorého sa odovzdá určitá množina stĺpcov v podobe objektu a ten sa tiež zadáva formou výčtu stĺpcov.
CREATE TABLE users_by_year_salary_id (
	user_id uuid,
	name text,
	year int,
	salary float,
	PRIMARY KEY((year), salary, user_id)
Všimnite si direktívu Primary key, jej prvý argument (v našom prípade rok) vždy ide ako Partition key. Môže sa skladať z jednej alebo viacerých stĺpcov, to nie je dôležité. Ak je stĺpcov viac, treba ich ešte raz dať do zátvoriek, aby preprocesor jazyka pochopil, že ide o Primary key, a za ním sú všetky ostatné stĺpce — Clustering key. Tieto budú pridané do komparátora v poradí, v akom sú uvedené. Teda prvý stĺpec je významnejší, druhý — menej významný a tak ďalej. Ako píšeme pre data classes, napríklad, polia equals: uvedieme polia a pre ne definujeme, ktoré sú významnejšie a ktoré menej. V Cassandre sú to, povedzme, polia data class, ku ktorým sa bude aplikovať napísaný pre nich equals.
Definujeme triedenie, ukladáme obmedzenia
Treba pamätať, že poradie triedenia (zostupné, vzostupné, na tom nezáleží) sa nastavuje v tom istom momente, keď sa vytvára kľúč, a neskôr ho nebude možné zmeniť. Fyzicky určuje, ako budú dáta zoradené a ako budú ležať. Ak bude potrebné zmeniť Clustering key alebo poradie triedenia, bude potrebné vytvoriť novú tabuľku a preniesť do nej dáta. S už existujúcou to takto nepôjde.
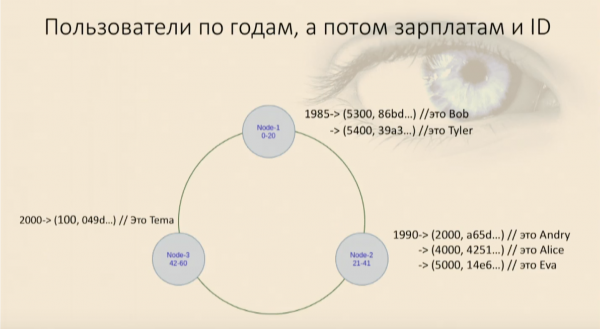
Naplnili sme našu tabuľku užívateľmi a videli sme, že sa zoradili najskôr podľa roku narodenia a potom v rámci každej nody podľa mzdy a user ID. Teraz môžeme vykonávať selekciu s obmedzeniami.
Opäť sa objavuje náš funkčný where, a, a užívatelia sa nám poskytujú, a všetko je opäť dobré. Ale ak sa pokúsime použiť iba časť Clustering key, a to menej významnú, Cassandra sa okamžite ozve, že nedokáže v našej mape nájsť miesto, kde je tento objekt, ktorého polia pre komparátor sú null, a tento, ktorý sme práve zadali, — kde leží. Budem musieť opäť získať všetky dáta z tejto nody a filtrovať ich. A to je analogické Full Scan v rámci nody, čo nie je dobré.
V každej nejasnej situácii vytvor novú tabuľku
Ak chceme mať možnosť získať používateľov podľa ID, veku alebo platu, čo robiť? Nič. Stačí použiť dve tabuľky. Ak bude potrebné získať používateľov tromi rôznymi spôsobmi, nebude mať tabuľiek tri. Prešli tie časy, keď sme šetrili miesto na disku. To je najlacnejší zdroj. Stojí oveľa menej ako čas odpovede, ktorý môže byť pre používateľa deštruktívny. Používateľovi je oveľa príjemnejšie dostať niečo za sekundu, než za 10 minút.
Vymieňame nadbytočne obsadené miesto, denormalizované dáta za možnosť dobre sa škálovať, spoľahlivo fungovať. Veď naozaj, klaster pozostávajúci z troch dátových centier, v každom z nich po päť uzlov, pri akceptovateľnej úrovni uchovávania dát (keď je presne nič nestratené), je schopný prežiť zánik jedného dátového centra úplne. A ešte po dva uzly v každých z dvoch zostávajúcich. A len po tom nastanú problémy. To je celkom dobré zálohovanie, stojí pár-trojicu navyše SSD úložísk a procesorov. Preto, aby sme mohli používať Cassandru, ktorá nie je SQL, v ktorej nie sú vzťahy, vonkajšie kľúče, musíme poznať jednoduché pravidlá.
Navrhujeme všetko od dotazu. Hlavné nie sú dáta, ale to, ako sa aplikácia s nimi bude zaobchádzať. Ak potrebuje získať rôzne dáta rôznymi spôsobmi alebo tie isté dáta rôznymi spôsobmi, musíme ich uložiť tak, ako to bude vhodné pre aplikáciu. Inak sa dostaneme do Full Scanu a žiadna výhoda Cassandry nám nepomôže.
Denormalizovať dáta je norma. Zabudneme na normálne formy, už nemáme relačné databázy. Uložíme niečo 100-krát, bude ležať 100-krát. To je stále lacnejšie, než spomaliť.
Vyberáme kľúče pre partitioning tak, aby sa normálne rozdeľovali. Nepotrebujeme, aby hash našich kľúčov padal do jedného úzkeho rozmedzia. To znamená, rok narodenia v uvedenom príklade — zlý príklad. Presnejšie, je to dobré, ak máme používateľov podľa roku narodenia normálne rozdelených, a zlé, ak sa to týka žiakov 5. triedy — tam sa to nebude dobre partitionovať.
Súbor sa vyberá raz pri vytváraní kľúča Clustering. Ak ho bude potrebné zmeniť, budeme musieť preliat našu tabuľku s iným kľúčom.
A najdôležitejšie: ak potrebujeme na 100 rôznych spôsobov získať rovnaké údaje, budeme mať 100 rôznych tabuliek.
Zdroj: habr.com
