

Ahoj, Habr!
Po novoročných oslavách sme znovu spustili katastrofálne odolné cloudové služby na dvoch lokalitách. Dnes vám povieme, ako to funguje a ukážeme, čo sa deje s virtuálnymi strojmi klientov pri zlyhaní jednotlivých prvkov klastre a páde celej lokality (spojler – je s nimi všetko v poriadku).
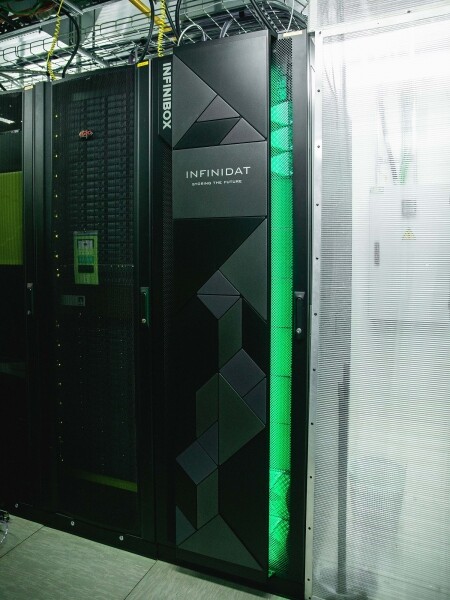
Úložisko katastrofálne odolného cloudu na lokalite OST.
Čo je vo vnútri
Pod kapotou klastre sú servery Cisco UCS s hypervízorom VMware ESXi, dve úložné jednotky INFINIDAT InfiniBox F2240, sieťové zariadenia Cisco Nexus a SAN prepínače Brocade. Klastre sú rozložené na dve lokalitách – OST a NORD, teda v každom dátovom centre identická súprava zariadení. To vlastne robí tento systém katastrofálne odolným.
V rámci jednej lokality sú aj hlavné prvky zdvojené (hostitelia, SAN prepínače, sieť).
Obe lokality sú prepojené vyhradenými optickými trasami, ktoré sú tiež rezervované.
Pár slov o úložných jednotkách. Prvú verziu katastrofálne odolného cloudu sme budovali na NetApp. Tu sme si zvolili INFINIDAT a toto sú dôvody:
- Možnosť aktívneho-duálneho replikovania. Umožňuje virtuálnemu stroju zostať funkčným aj pri úplnom zlyhaní jednej z úložných jednotiek. O replikácii poviem podrobnejšie neskôr.
- Tri diskové kontroléry na zvýšenie odolnosti systému. Zvyčajne ich bývajú dva.
- Hotové riešenie. K nám prišla už zmontovaná skrinka, ktorú stačí pripojiť do siete a nastaviť.
- Pozorná technická podpora. Inžinieri INFINIDAT neustále analyzujú logy a udalosti úložných jednotiek, inštalujú nové verzie firmvéru, pomáhajú s nastavením.
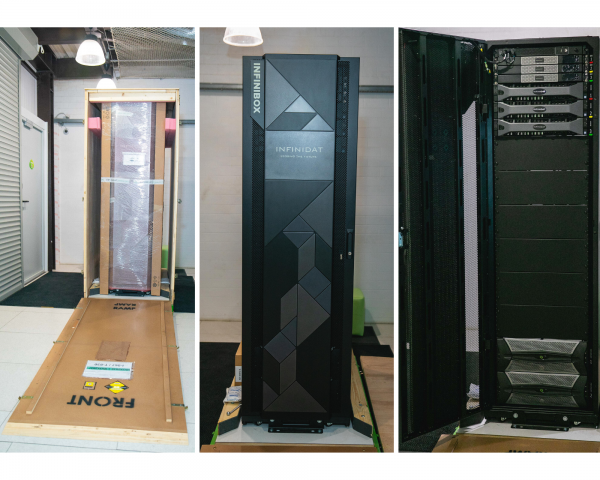
Tu je pár fotiek z unpacking'u:
Ako to funguje
Cloud už je odolný voči zlyhaniam. Chráni klienta pred jednotlivými hardvérovými a softvérovými zlyhaniami. Katastrofálne odolný systém pomôže chrániť pred masívnymi výpadkami na jednej lokalite: napríklad zlyhaním úložnej jednotky (alebo klastre SDS, čo sa stáva celkom často 🙂 ), masovými chybami v úložnej sieti a podobne. A najdôležitejšie: tento cloud zachráni, keď celá lokalita prestane byť dostupná kvôli požiaru, blackout-u, prevzatiu rukojemníkmi, invázii mimozemšťanov.
V všetkých týchto prípadoch virtuálne stroje klientov pokračujú v činnosti a tu je dôvod.
Architektúra clustera je navrhnutá tak, aby každý ESXi host s klientskými virtuálnymi strojmi mohol pristupovať k ľubovoľnému z dvoch SAN. Ak SAN na lokalite OST vypadne, virtuálne stroje budú pokračovať v práci: hostitelia, na ktorých bežia, sa budú obracať na SAN na NORD pri získavaní dát.
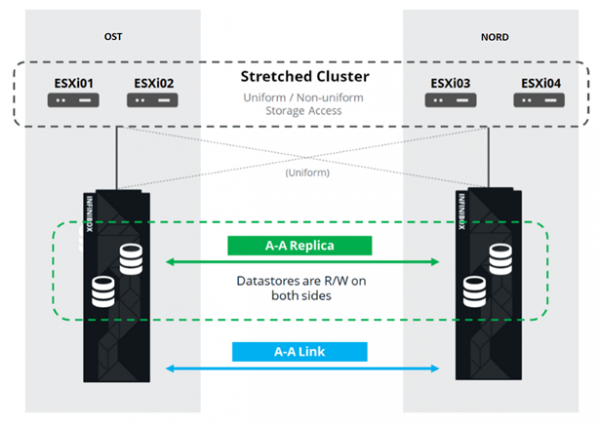
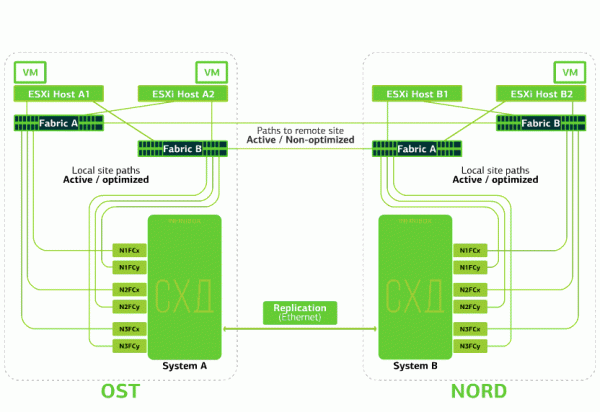
Takto vyzerá schéma pripojenia v clustri.
To je možné vďaka tomu, že medzi SAN switchmi dvoch lokalít je nastavené prepojenie Inter-Switch Link: SAN switch Fabric A OST je pripojený ku SAN switchu Fabric A NORD, rovnako aj pre SAN switche Fabric B.
Aby však všetky tieto zložitosti SAN switchov dávali zmysel, je medzi dvoma SAN nastavená aktívna-aktívna replikácia: informácie sú prakticky súčasne zapisované na lokálny a vzdialený SAN, RPO=0. To znamená, že na jednom SAN je uložený originál dát, na druhom – ich replikácia. Dátové replikácie sú spravované na úrovni zväzkov SAN, a na nich sa už ukladajú dáta VM (jej disky, konfiguračný súbor, swap súbor a pod.).
ESXi host vidí hlavnú zväzok a jeho replikáciu ako jedno diskové zariadenie (Storage Device). Od ESXi hosta vedie k každému diskovému zariadeniu 24 ciest:
12 ciest spája ho s lokálnym SAN (optimálne cesty), zatiaľ čo ostatných 12 – s vzdialeným (neoptimálne cesty). V štandardnej situácii sa ESXi obracia na dáta na lokálnom SAN, pričom používa „optimálne“ cesty. Po zlyhaní tohto SAN ESXi stratí optimálne cesty a prepnú sa na „neoptimálne“. Takto to vyzerá na schéme.
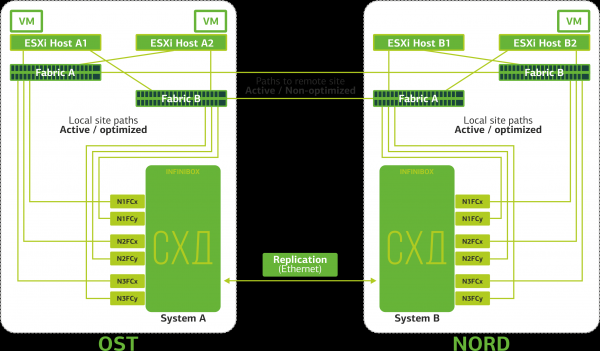
Schéma odolného clustera voči katastrofám.
Všetky klientské siete sú pripojené na obe lokality cez spoločný sieťový switch. Na každej lokalite funguje Provider Edge (PE), na ktorom sa terminujú siete klienta. PE sú spojené do spoločného clustera. Pri zlyhaní PE na jednej lokalite sa celý prenos presmeruje na druhú lokalitu. Vďaka tomu zostávajú virtuálne stroje z lokality, ktorá zostala bez PE, dostupné v sieti pre klienta.
Poďme sa teraz pozrieť, čo sa stane s virtuálnymi strojmi klienta pri rôznych zlyhaniach. Začneme s tými najľahšími variantmi a skončíme tým najzávažnejším – zlyhaním celej lokality. V príkladoch bude hlavná lokalita OST a záložná s replikami dát – NORD.
Čo sa stane s virtuálnym strojom klienta, ak…
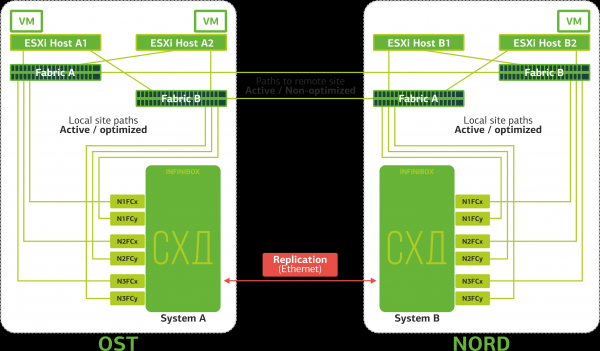
Zlyhá Replikačný Link. Replikácia medzi SAN dvoch lokalít sa zastavuje.
ESXi budú fungovať len s lokálnymi diskovými zariadeniami (po optimálnych cestách).
Virtuálne stroje pokračujú v prevádzke.
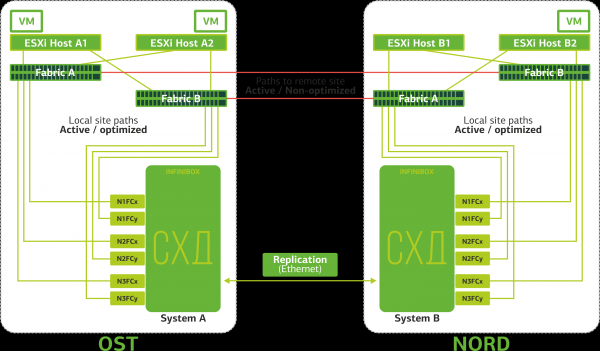
Nastáva prerušenie ISL (Inter-Switch Link). Prípad je málo pravdepodobný. Snáď len nejaký šialený bagger vykopá niekoľko optických trás, ktoré prechádzajú nezávislými trasami a sú privedené na miesta cez rôzne vstupy. Ale aj tak. V tomto prípade ESXi hostitelia stratia polovicu ciest a môžu sa prihlasovať iba k svojim lokálnym SAN. Repliky sú zhromaždené, ale hostitelia sa k nim nebudú môcť pripojiť.
Virtuálne stroje fungujú normálne.
Zlyháva SAN prepínač na jednom z miest. ESXi hostitelia strácajú časť ciest k SAN. V tomto prípade hostitelia na mieste, kde zlyhal prepínač, budú fungovať iba cez jeden svoj HBA.
Virtuálne stroje zatiaľ pokračujú v prevádzke normálne.
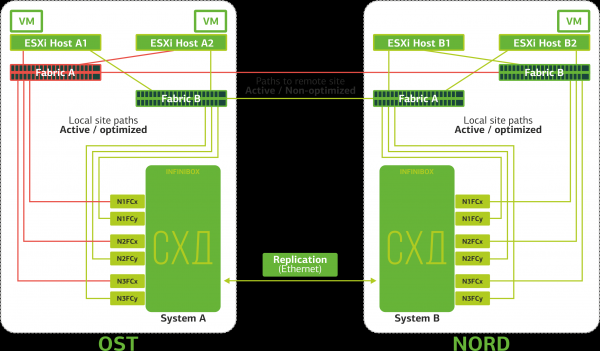
Zlyhávajú všetky SAN prepínače na jednom z miest. Predpokladajme, že takáto nehoda sa stala na mieste OST. V tomto prípade ESXi hostitelia na tomto mieste stratia všetky cesty k svojim diskovým zariadeniam. Do akcie vstupuje štandardný mechanizmus VMware vSphere HA: reštartuje všetky virtuálne stroje na mieste OST v NORDe maximálne do 140 sekúnd.
Virtuálne stroje pracujúce na hostiteľoch miesta NORD fungujú normálne.
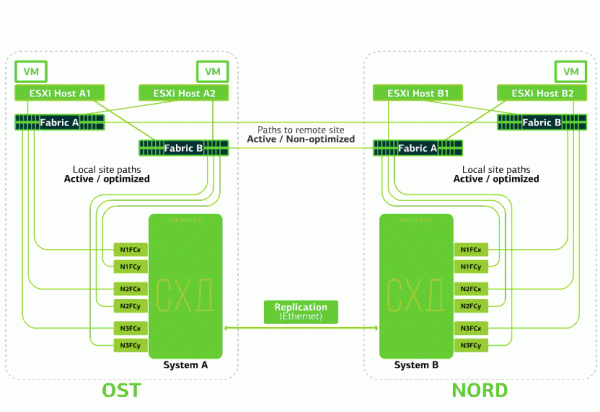
Zlyháva ESXi hostiteľ na jednom mieste. Tu opäť funguje mechanizmus vSphere HA: virtuálne stroje zo zlyhajúceho hostiteľa sa reštartujú na iných hostiteľoch - na tom istom alebo vzdialenom mieste. Čas reštartu virtuálneho stroja je až 1 minúta.
Ak zlyhajú všetci ESXi hostitelia miesta OST, už niet alternatívy: VM sa reštartujú na inej. Čas reštartu zostáva rovnaký.
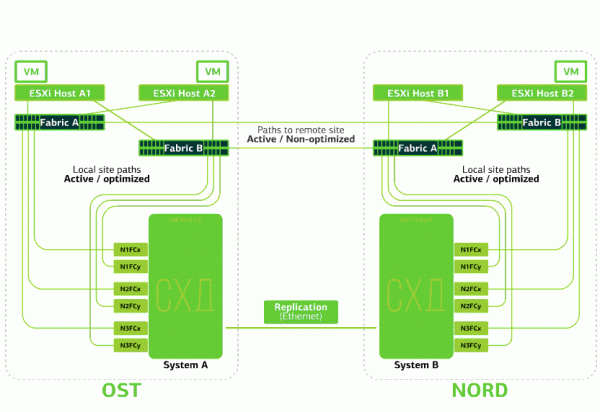
Zlyháva SAN na jednom mieste. Predpokladajme, že zlyhal SAN na mieste OST. Potom ESXi hostitelia miesta OST prechádzajú na prácu s replikami SAN v NORDe. Po opätovnom uvedení zlyhávajúceho SAN do prevádzky sa uskutoční núdzová replikácia, ESXi hostitelia OST opäť začnú pristupovať k lokálnemu SAN.
Virtuálne stroje po celý ten čas fungujú normálne.
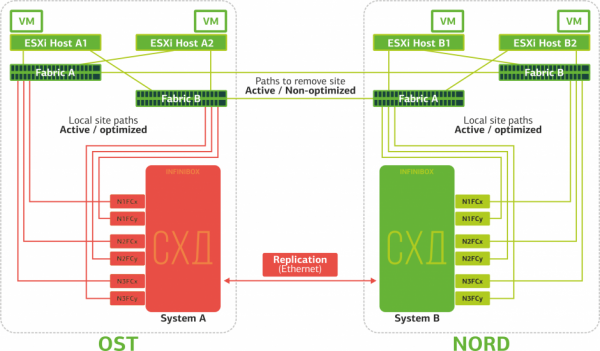
Zlyháva jedno z miest. V takom prípade sa všetky virtuálne stroje reštartujú na záložnom mieste cez mechanizmus vSphere HA. Čas reštartu VM je 140 sekúnd. Pri tom zostanú všetky sieťové nastavenia virtuálneho stroja zachované a ostáva dostupný pre klienta cez sieť.
Aby sa reštartovanie strojov na záložnej lokalite uskutočnilo bez problémov, každá lokalita je zaplnená iba z polovice. Druhá polovička je rezerva pre prípad presunu všetkých virtuálnych strojov z druhej, postihnutej, lokality.
Toto sú odmietnutia, proti ktorým chráni katastroficky odolné cloudové riešenie založené na dvoch dátových centrách.
Toto potešenie nie je lacné, keďže okrem hlavných zdrojov je potrebná rezerva na druhej lokalite. Preto sú v takýchto cloudoch umiestnené podnikovo kritické služby, ktorých dlhá prestoj môže spôsobiť veľké finančné a reputačné straty, alebo ak sú na informačný systém kladené požiadavky na katastrofickú odolnosť zo strany regulátorov alebo interných predpisov firmy.
Zdroje:
Zdroj: habr.com
