

Data Science pre začiatočníkov
1. Analýza sentimentu (Analýza nálad z textu)
Pozrite si úplnú implementáciu projektu Data Science s použitím zdrojového kódu — .
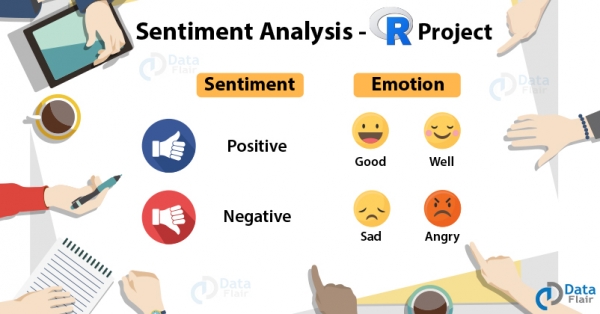
Analýza sentimentu je analýza slov na určenie nálad a názorov, ktoré môžu byť pozitívne alebo negatívne. Ide o typ klasifikácie, kde môžu byť triedy binárne (pozitívne a negatívne) alebo viacnásobné (šťastné, nahnevané, smutné, nepríjemné …). Tento projekt Data Science realizujeme v jazyku R a použijeme dátový súbor z balíka „janeaustenR“. Využijeme všeobecne použiteľné slovníky ako AFINN, bing a loughran, vykonáme vnútorné spojenie a nakoniec vytvoríme oblak slov, aby sme zobrazili výsledok.
Jazyk: R
Dátový súbor/Pakete: janeaustenR
Článok bol preložený s podporou spoločnosti EDISON Software, ktorá , ako aj .
2. Detekcia falošných správ (Objevení falošných správ)
Posuňte svoje zručnosti na novú úroveň prácou na projekte Data Science pre začiatočníkov — .
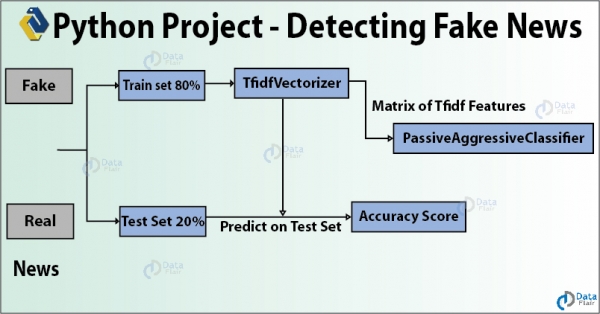
Falošné správy sú falošné informácie šírené prostredníctvom sociálnych sietí a iných online médií na dosiahnutie politických cieľov. V tejto myšlienke projektu Data Science budeme používať Python na vytvorenie modelu, ktorý dokáže presne určiť, či je správa skutočná alebo falošná. Vytvoríme TfidfVectorizer a použijeme PassiveAggressiveClassifier na klasifikáciu správ na „skutočné“ a „falošné“. Použijeme dátový súbor s rozmermi 7796 × 4 a všetko vykonáme v Jupyter Lab.
Jazyk: Python
Dátový súbor/Pakete: news.csv
3. Detekcia Parkinsonovej choroby (Detekcia Parkinsonovej choroby)
Posuňte sa vpred prácou na myšlienke projektu Data Science Project Idea — .
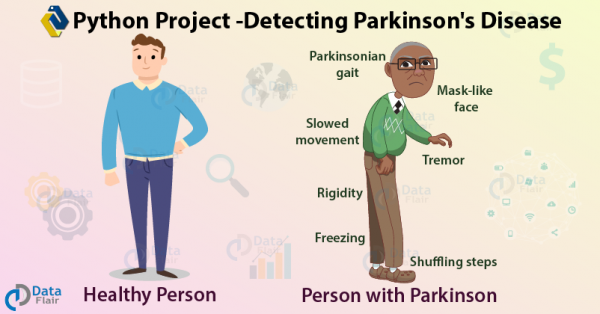
Začali sme používať Data Science na zlepšenie zdravotnej starostlivosti a služieb — ak dokážeme predpovedať ochorenie v ranom štádiu, prinesie nám to mnoho výhod. Takže v tejto myšlienke projektu Data Science sa naučíme detekovať Parkinsonovu chorobu pomocou Pythonu. Ide o neurodegeneratívne, progresívne ochorenie centrálneho nervového systému, ktoré ovplyvňuje pohyb a spôsobuje trasenie a stuhnutosť. Ovplyvňuje neuróny produkujúce dopamín v mozgu a každý rok sa to dotýka viac ako 1 milióna ľudí v Indii.
Jazyk: Python
Dátový súbor/Pakete: UCI ML Parkinsons dataset
Projekty Data Science strednej zložitosti
4. Rozpoznávanie emocí z reči
Prečítajte si úplné zrealizovanie príkladu projektu Data Science — .
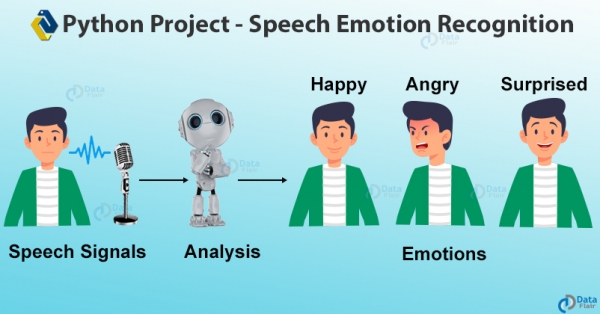
Teraz sa naučme používať rôzne knižnice. Tento projekt Data Science využíva librosa na rozpoznávanie reči. SER je proces určovania ľudských emócií a afektívnych stavov na základe reči. Keďže používame tón a výšku tónu na vyjadrenie emócií hlasom, SER je relevantný. Ale pretože sú emócie subjektívne, anotácia zvuku je náročná úloha. Použijeme funkcie mfcc, chroma a mel a využijeme dataset RAVDESS na rozpoznávanie emócií. Vytvoríme MLPC klasifikátor pre tento model.
Jazyk: Python
Dátový súbor/Pakete: dataset RAVDESS
5. Detekcia pohlavia a veku
Ohromte zamestnávateľov najnovším projektom Data Science — .
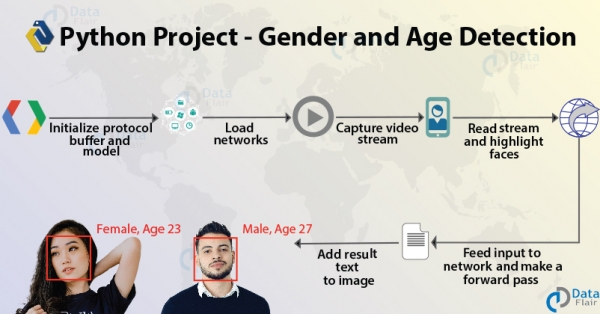
Toto je zaujímavý projekt Data Science s Python. Pomocou iba jedného obrázka sa naučíte predpovedať pohlavie a vek človeka. V rámci tohto projektu vás zoznámime s počítačovým videním a jeho princípmi. Vytvoríme a použijeme modely vytrénované Talom Hassnerom a Gilom Levym pre dataset Adience. Po ceste použijeme niektoré súbory .pb, .pbtxt, .prototxt a .caffemodel.
Jazyk: Python
Dátový súbor/Pakete: Adience
6. Analýza dát Uber
Pozrite si úplnú realizáciu projektu Data Science so zdrojovým kódom — .
Toto je projekt vizualizácie dát s ggplot2, v ktorom budeme používať R a jeho knižnice a analyzovať rôzne parametre. Použijeme dataset Uber Pickups v New Yorku a vytvoríme vizualizácie pre rôzne časové rámce roka. To nám ukazuje, ako čas ovplyvňuje cesty zákazníkov.
Jazyk: R
Dátový súbor/Pakete: dataset Uber Pickups v New Yorku
7. Detekcia ospalosti vodiča
Zlepšíte svoje zručnosti pracovaním na Top Data Science projekte — .
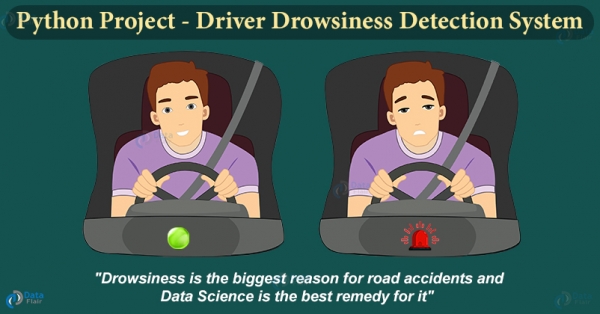
Ospalé riadenie je extrémne nebezpečné a každý rok sa stane približne tisíc nehôd spôsobených tým, že vodiči zaspávajú počas riadenia. V tomto projekte na Pythone vytvoríme systém, ktorý dokáže odhaliť ospalých vodičov a tiež ich upozorniť zvukovým signálom.
Tento projekt je realizovaný pomocou Keras a OpenCV. Použijeme OpenCV na rozpoznávanie tváre a očí, a pomocou Keras budeme klasifikovať stav oka (Otvorené alebo Zatvorené) pomocou metód hlbokých neurónových sietí.
8. Chatbot
Vytvorte chatbota pomocou Pythonu a vykročte v kariére — .
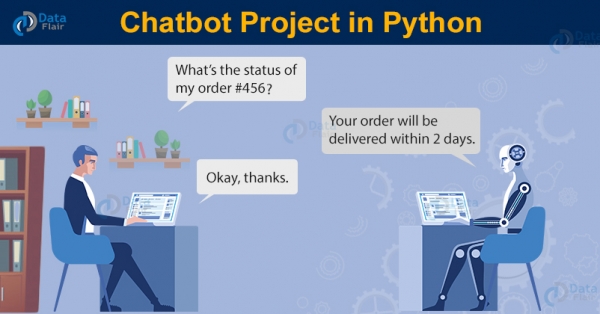
Chatboti sú neoddeliteľnou súčasťou biznisu. Mnohé firmy musia poskytovať služby svojim klientom, a na ich obsluhu je potrebné veľa pracovnej sily, času a úsilia. Chatboti môžu automatizovať veľkú časť interakcie s klientmi, odpovedajúc na niektoré časté otázky, ktoré kladú zákazníci. Existujú v podstate dva typy chatbots: Špecifické pre doménu a Otevrené domény. Špecifické pre doménu chatboti sú často používané na riešenie konkrétneho problému. Takže je potrebné ich nastaviť na efektívnu prácu vo vašej oblasti. Otevreným doménovým chatbota môžete klásť akékoľvek otázky, a preto je potrebné na ich vytrénovanie obrovské množstvo údajov.
Datasety: Intents json súbor
Jazyk: Python
Pokročilé projekty Data Science
9. Generátor popisu obrázkov
Skontrolujte úplnú implementáciu projektu so zdrojovým kódom — .
Opis toho, čo je na obrázku, je pre ľudí jednoduchou úlohou, ale pre počítače je obrázok len súbor čísiel, ktoré predstavujú hodnotu farby každého pixelu. Pre počítače je to náročná úloha. Pochopiť, čo sa nachádza na obrázku, a potom vytvoriť opis v prirodzenom jazyku (napríklad v angličtine) je ďalšou náročnou úlohou. Tento projekt používa metódy hlbokého učenia, pri ktorých implementujeme Konvolučnú neurónovú sieť (CNN) s rekurentnou neurónovou sieťou (LSTM) na vytvorenie generátora popisu obrázkov.
Datasety: Flickr 8K
Jazyk: Python
Framework: Keras
10. Detekcia podvodov s kreditnými kartami
Urobte to najlepšie, čo môžete, nad prácou na projekte Data Science — .
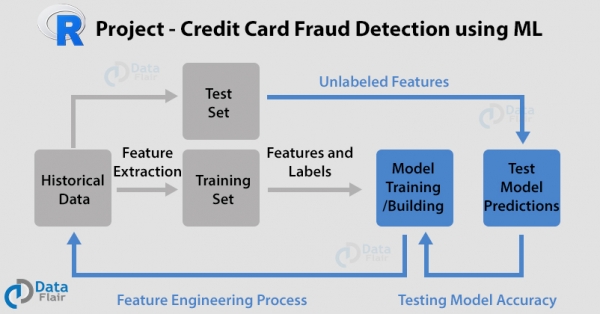
Doteraz ste začali chápať metódy a koncepty. Prejdime k niektorým pokročilým projektom v oblasti vedy o údajoch. V tomto projekte použijeme jazyk R s algoritmami ako sú , logistická regresia, umelé neurónové siete a klasifikátor gradientného boostingu. Použijeme súbor dát transakcií s kartami na klasifikáciu transakcií kreditných kariet ako podvodných a pravých. Prispôsobíme im rôzne modely a postavíme výkonové krivky.
Jazyk: R
Dátový súbor/Pakete: Súbor dát transakcií s kartami
11. Systém odporúčaní filmov
Preskúmajte realizáciu najlepšieho projektu Data Science so zdrojovým kódom —
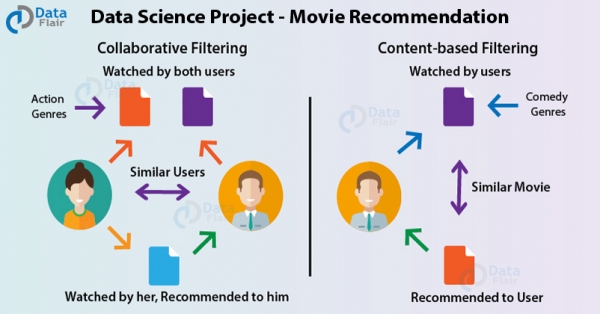
V tomto projekte Data Science použijeme R na odporúčanie filmov prostredníctvom strojového učenia. Systém odporúčaní posiela návrhy používateľom na základe procesu filtrovania, ktorý vychádza z preferencií iných používateľov a histórie prezerania. Ak A a B majú radi Sám doma a B má rád Dievčatá z Orlandu, môžeme A navrhnúť — môže sa mu to tiež páčiť. To umožňuje zákazníkom interagovať s platformou.
Jazyk: R
Dátový súbor/Pakete: Súbor dát MovieLens
12. Segmentácia zákazníkov
Zanechajte dojem na zamestnávateľov s projektom Data Science (vrátane zdrojového kódu) — .
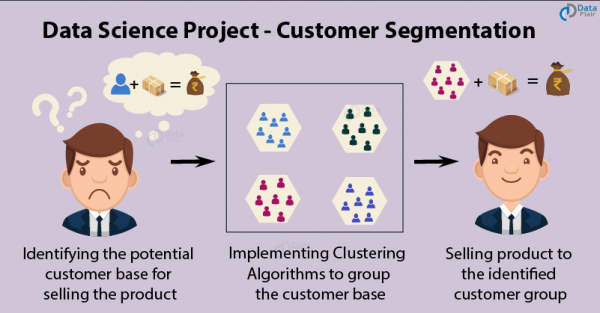
Segmentácia zákazníkov je populárna aplikácia . Pomocou klastrovania firmy identifikujú segmenty zákazníkov na prácu s potenciálnou základňou používateľov. Rozdelia zákazníkov do skupín podľa ich spoločných charakteristík, ako sú pohlavie, vek, záujmy a návyky vynakladania peňazí, aby mohli efektívne predávať svoje produkty každej skupine. Použijeme , ako aj vizualizovať rozloženie podľa pohlavia a veku. Následne analyzujeme ich ročné príjmy a úroveň výdavkov.
Jazyk: R
Dátový súbor/Pakete: Súbor dát Mall_Customers
13. Klasifikácia rakoviny prsníka
Pozrite si úplnú implementáciu projektu Data Science v Pythone — .
Pri návrate k lekárskemu prínosu dátovej vedy sa naučme identifikovať rakovinu prsníka pomocou Pythonu. Použijeme súbor údajov IDC_regular na detekciu invazívneho karcinómu mlečného kanála, najbežnejšej formy rakoviny prsníka. Táto forma sa vyvíja v mlečných kanáloch, prenikajúc do vláknitej alebo tukovej tkanive prsníka. V tejto myšlienke vedeckého projektu zameraného na zber údajov využijeme a knižnicu Keras na klasifikáciu.
Jazyk: Python
Dátový súbor/Pakete: IDC_regular
14. Rozpoznávanie dopravných značiek
Dosiahnutie presnosti v technológii autonómneho riadenia automobilov prostredníctvom projektu Data Science na s otvoreným kódom.
Dopravné značky a pravidlá cestnej premávky sú veľmi dôležité pre každého vodiča, aby sa vyhli nehodám. Aby ste mohli dodržiavať pravidlá, musíte si najprv uvedomiť, ako dopravná značka vyzerá. Človek sa musí naučiť všetky dopravné značky predtým, než dostane vodičský preukaz na riadenie akéhokoľvek vozidla. Avšak v súčasnosti sa zvyšuje počet autonómnych vozidiel a čoskoro už nebude človek riadiť auto sám. V projekte "Rozpoznávanie dopravných značiek" sa naučíte, ako program dokáže rozpoznať typ dopravných značiek na základe snímky ako vstupného signálu. Na vytvorenie hlbokej neurónovej siete na rozpoznávanie triedy dopravnej značky využívame súbor údajov GTSRB (Nemecký benchmark pre rozpoznávanie dopravných značiek). Taktiež vytvárame jednoduché grafické rozhranie na interakciu s aplikáciou.
Jazyk: Python
Datasety: GTSRB (Nemecký benchmark pre rozpoznávanie dopravných značiek)
Čítať viac
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish